Когда приложение становится спецификацией
Обычно агента для программирования проверяют просто: дают задачу, описание бага или набор тестов. Дальше смотрят, починил он код или нет. В новой статье ProgramDistill предлагают другой сценарий, гораздо больше похожий на реальную работу. У вас есть рабочее приложение-эталон. И есть его сломанная или неполная версия. Никакого исходного кода эталона агент не видит. Он должен сам пройтись по интерфейсу, понять, как всё должно работать, и восстановить нужное поведение в редактируемом приложении.
Это проверка на умение извлекать спецификацию из живой системы. Для веб-разработки это естественная постановка. Так часто работают люди: открывают старую версию продукта, сервис конкурента, прототип или внутреннюю демку, а потом воспроизводят нужное поведение в коде.
Авторы превращают эту идею в полноценный бенчмарк для агентов для программирования. Причём не вручную, а почти целиком автоматически.
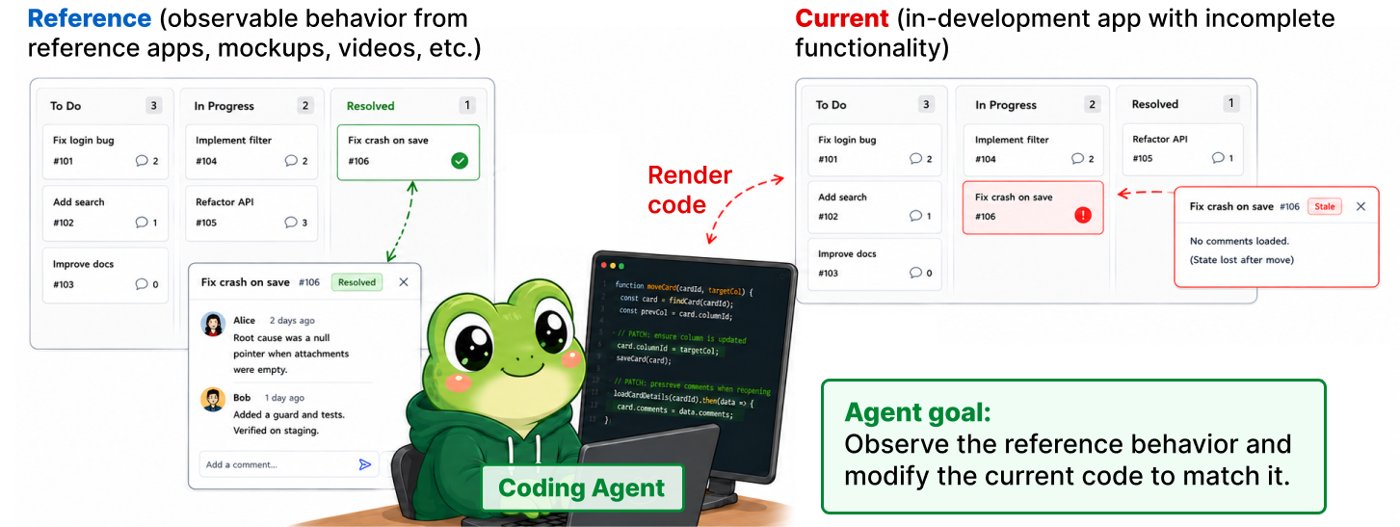
Идея ProgramDistill: агент изучает рабочее приложение-эталон, меняет код текущего приложения и затем проверяет, восстановилось ли нужное поведение.
Что такое ProgramDistill
ProgramDistill — это бенчмарк, где задача формулируется не через текстовое описание, а через наблюдение за работающим приложением. В статье речь идёт об интерактивных веб-приложениях: канбан-досках, почте, резюме, CRM, календарях, финансах и других сервисах.
Смысл простой:
🟠 Есть эталонное приложение, которое работает правильно.
🟠 Есть текущее приложение, где часть функциональности удалили.
🟠 Агент для программирования смотрит на поведение эталона через браузер.
🟠 Потом он редактирует код текущего приложения.
🟠 После этого система автоматически проверяет, восстановилось ли нужное поведение.
Но интересная часть в другом. Авторы не берут приложение как одну большую задачу «восстанови всё». Они разбивают его на цепочки зависимых действий. Например: войти в систему → создать доску → создать карточку → открыть детали карточки → изменить комментарий. Каждое следующее действие зависит от предыдущих. Поэтому можно контролировать сложность: от маленького локального исправления до длинного многошагового восстановления.
Как из приложения сделали тысячи задач
Главный технический вклад статьи — автоматический пайплайн mine–craft–patch. По сути это фабрика задач из живых веб-приложений.
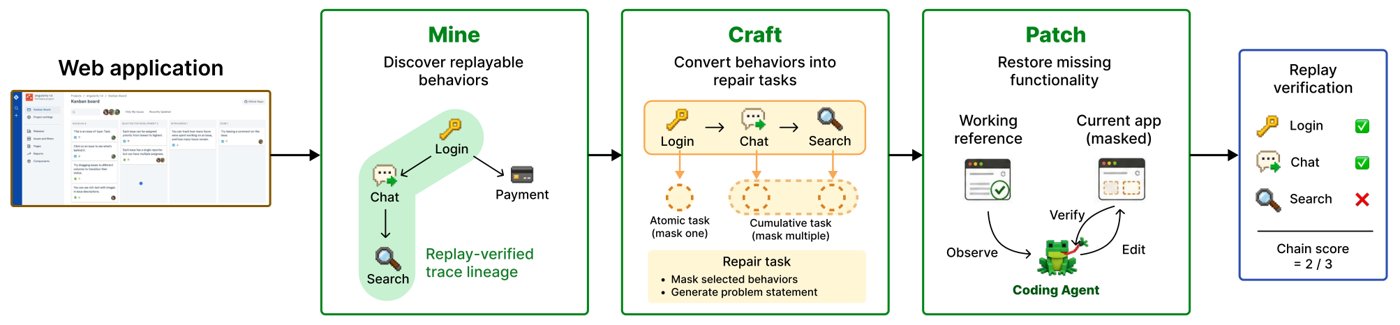
Пайплайн mine–craft–patch: сначала система находит воспроизводимые действия, затем скрывает их реализацию в коде и после этого просит агента восстановить поведение по эталону.
Он работает в три шага.
Шаг 1. Найти воспроизводимое поведение
Сначала отдельные ИИ-агенты исследуют приложение через браузер и ищут осмысленные пользовательские действия: создать объект, изменить запись, открыть форму, перетащить карточку, импортировать файл и так далее. Если действие удалось, система записывает трассу: последовательность шагов в браузере и ожидаемые наблюдаемые результаты.
Ключевой момент: это поведение потом автоматически воспроизводится. Если трассу нельзя надёжно воспроизвести с чистого состояния, она не попадает в бенчмарк. То есть авторы отсекают хрупкие, случайные и плохо проверяемые сценарии.
В итоге из 26 приложений они получили:
🟣 1 975 проверенных поведений
🟣 2 862 атомарные задачи восстановления одного фрагмента логики
🟣 1 201 кумулятивную задачу, где нужно вернуть сразу несколько зависимых функций
🟣 4 063 задачи всего
Коротко по масштабу:
🟠 Источник задач — само работающее приложение
🟠 Проверяются только воспроизводимые сценарии
🟠 В бенчмарке есть и локальные исправления, и длинные зависимые цепочки
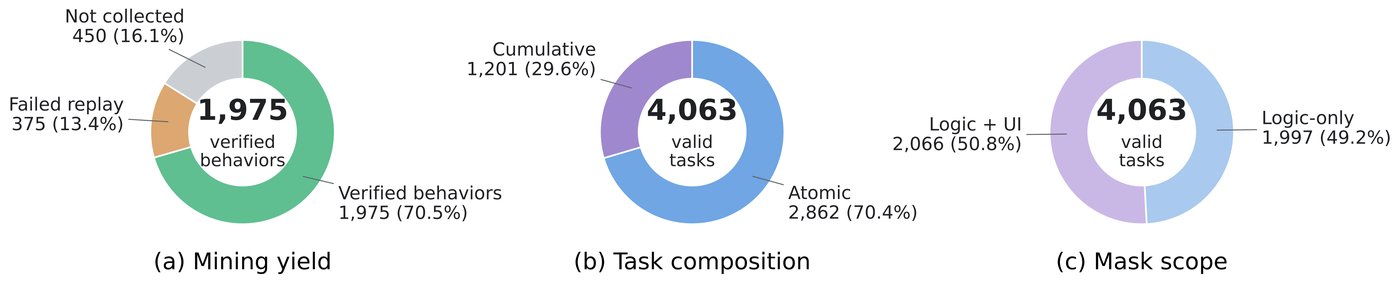
Как рос бенчмарк: из найденных поведений система собрала более четырёх тысяч задач разной глубины и разного типа.
Шаг 2. Сломать функцию правильно
После получения поведений система должна сделать из них реальные задачи на исправление. Для этого она удаляет из исходников реализацию конкретной функции.
Но удалить можно по-разному. Можно честно вырезать основную логику. А можно схитрить: выключить флаг, добавить ранний выход из функции, скрыть кнопку, оставить почти весь код на месте. Авторы отдельно борются с такими поверхностными поломками.
Они используют два типа маскировки:
🟠 Только логика — интерфейс остаётся, но перестаёт работать внутренняя часть.
🟠 Логика и интерфейс — убирают и логику, и элементы интерфейса, которыми управляет функция.
Потом система проверяет, что:
🟠 приложение вообще запускается;
🟠 более ранние шаги цепочки всё ещё работают;
🟠 целевая функция действительно сломана;
🟠 «золотой патч» возвращает всё назад и восстанавливает поведение.
Это даёт аккуратную постановку. Агенту не нужно чинить всё вокруг. Он получает контролируемую поломку и должен восстановить именно то, что было удалено.
Шаг 3. Дать задачу агенту
Дальше начинается сам тест. Агент получает:
🟣 репозиторий с удалённой функциональностью;
🟣 короткое описание функции;
🟣 доступ к браузеру для сравнения текущего приложения с эталоном;
🟣 инструменты чтения, поиска и редактирования кода.
Не получает он главного: исходники эталона, готовый патч и проверочные трассы.
Оценка идёт по воспроизведению поведения. Если после патча записанная цепочка действий проходит так же, как на эталоне, задача решена. Если агент восстановил только часть длинной цепочки, это тоже можно отдельно посчитать.
Что показали эксперименты
Авторы прогнали на ProgramDistill девять передовых моделей. Среди них GPT-6 Astra, Claude Opus 5, GPT-5.6 Sol, Gemini, Grok и другие.
Главный результат такой: локальные исправления модели делают заметно лучше, чем длинные зависимые восстановления.
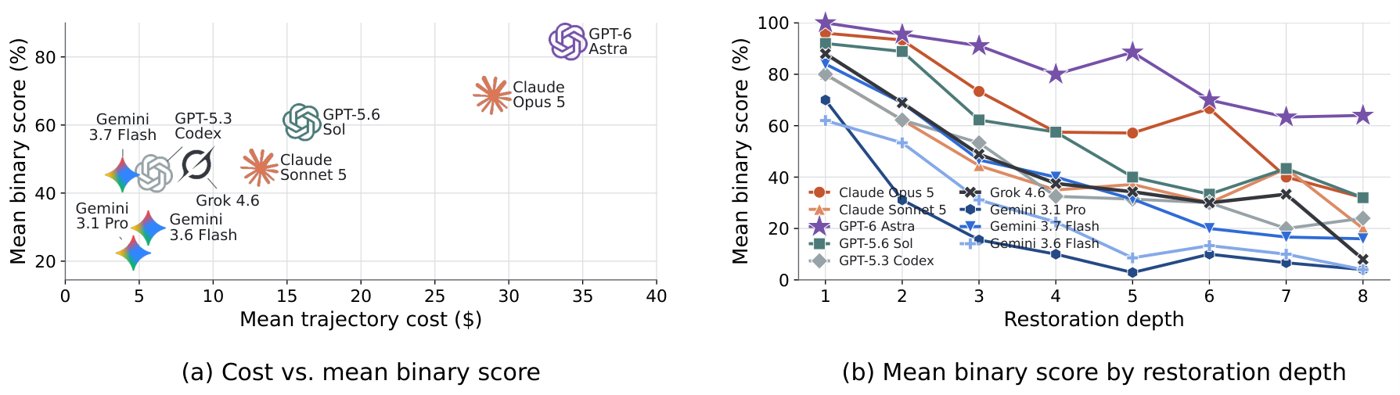
Качество агентов падает с ростом глубины восстановления: отдельные функции чинить легче, чем длинные цепочки зависимого поведения.
Для частичного восстановления приложения:
🟠 GPT-6 Astra показал в среднем 84,3% успешных решений
🟠 Claude Opus 5 — 68,7%
🟠 GPT-5.6 Sol — 60,7%
Но если смотреть не на среднее, а на глубину цепочки, картина быстро ухудшается. На задачах глубины 1, где нужно вернуть один фрагмент поведения, лучшие модели почти безошибочны. А вот на глубине 8 уже тяжело:
🟣 у GPT-6 Astra успех падает со 100% до 64%
🟣 у Claude Opus 5 — с 96% до 32%
🟣 у GPT-5.6 Sol — с 92% до 32%
Коротко по результатам:
🟠 На коротких задачах лучшие модели близки к 100%
🟠 На длинных цепочках качество резко падает
🟠 Проблема — в сборке нескольких исправлений без разрушения зависимостей
Ещё одна важная деталь: задачи, где нужно восстанавливать и интерфейс, и логику, заметно сложнее, чем задачи только на логику. Даже у лидера разрыв между этими режимами большой.
Почему агенты проваливаются на длинных задачах
Интересная часть статьи — разбор не только качества, но и поведения самих агентов.
Авторы посмотрели, как меняется нагрузка по мере усложнения задачи. С ростом глубины восстановления:
🟠 объём кода, который нужно вернуть, растёт примерно в 9,3 раза
🟠 объём целевых действий в браузере растёт примерно в 10,7 раза
Но усилия агентов на каждую отдельную восстанавливаемую функцию при этом падают. Особенно сильно проседает наблюдение:
🟣 число шагов наблюдения за эталоном на одну цель падает примерно на 75%
🟣 число проверок собственного приложения на одну цель тоже падает примерно на 75%
🟣 редактирование кода на одну цель падает слабее, но тоже заметно
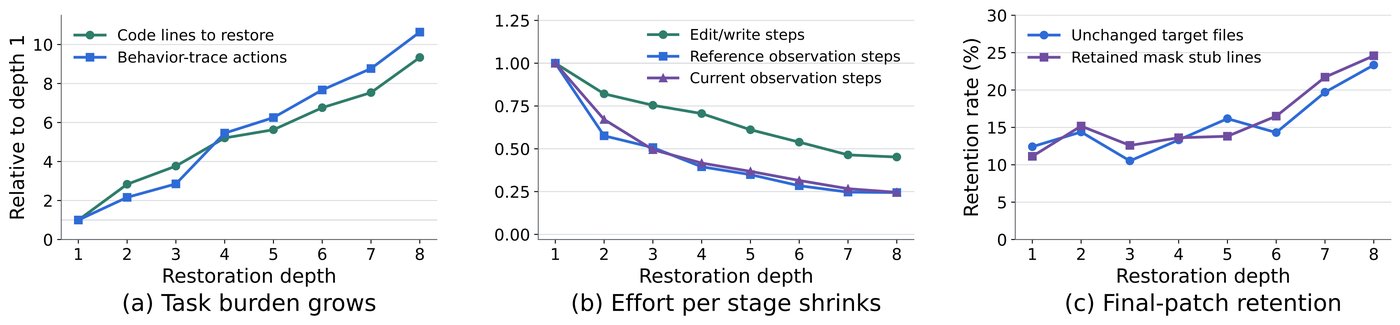
По мере роста глубины задачи объём работы растёт быстрее, чем усилия агента на каждую отдельную функцию; особенно резко сокращается наблюдение за эталоном и самопроверка.
Проще говоря, чем задача длиннее, тем сильнее агент начинает экономить на понимании и проверке поведения. Он меньше смотрит на эталон, меньше перепроверяет результат, а потом оставляет часть нужного кода невосстановленной.
Это хорошо видно в цифрах:
🟠 Работы становится в 9–11 раз больше
🟠 Наблюдение и самопроверка на одну цель падают примерно на 75%
🟠 Агент чаще пропускает нужные детали поведения
В короткой задаче можно внимательно изучить интерфейс и несколько раз прогнать сценарий. В длинной задаче агент быстрее скатывается в режим «примерно понятно, сейчас допишу». И именно там накапливаются ошибки.
Интересно и различие стратегий между моделями. GPT-6 Astra оказался самым «наблюдательным»: чаще других смотрел на эталон и на текущее приложение, но при этом делал меньше правок в коде. То есть лучшее качество здесь связано не только с генерацией кода, а с тем, как агент распределяет усилия между наблюдением, правкой и проверкой.
Полная пересборка приложения
Авторы отдельно проверили ещё более жёсткий сценарий: не частичное исправление существующего приложения, а полная реконструкция из минимального шаблона. Тут нужно фактически заново собрать продукт, глядя только на работающее приложение-эталон.
Результаты заметно хуже:
🟠 GPT-6 Astra: 58,98% на атомарных поведениях и 49,15% на полных кумулятивных сценариях
🟠 Claude Opus 5: 42,03% и 28,81%
🟠 GPT-5.6 Sol: 33,39% и 21,07%
То есть даже лучшие модели далеки от уверенной реконструкции реального интерактивного продукта.
Почему так происходит? Авторы разобрали почти тысячу провалов и выяснили простую вещь: чаще всего агент вообще не увидел нужное поведение в эталоне. Это самая большая категория ошибок — 59,2% всех неудач. Остальное — случаи, когда поведение было замечено, но не реализовано, реализовано в неправильной форме или с неверным состоянием.
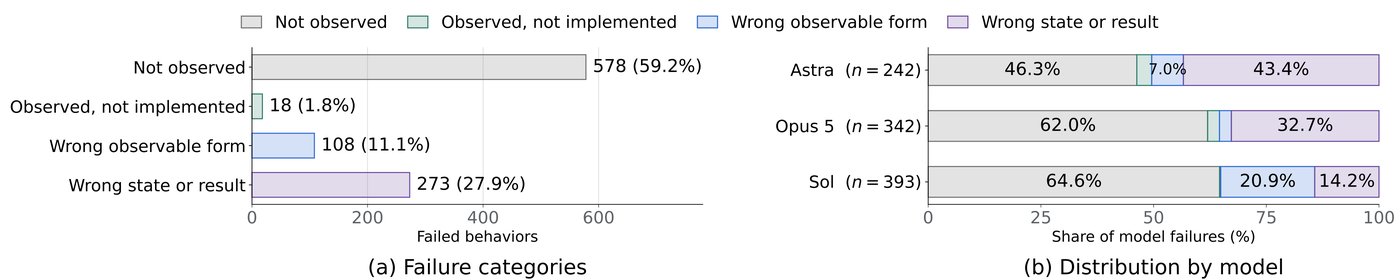
Главная причина провалов при полной реконструкции — агент просто не заметил нужное поведение в эталоне; остальные ошибки связаны с неправильной реализацией и слабой самопроверкой.
Главное по провалам:
🟠 Основная причина ошибок — агент недоисследовал эталон
🟠 Это 59,2% всех неудач
🟠 Проблема часто возникает раньше написания кода
Это ломает популярную интуицию, будто главная проблема современных агентов — только в коде. Здесь видно, что узкое место часто возникает раньше: агент недоисследовал систему.
Почему это важно
ProgramDistill показывает: текущие агенты для программирования неплохо справляются с отдельными исправлениями, но хуже работают там, где нужно самому получить спецификацию, удержать длинную цепочку состояний и тщательно свериться с результатом.
Для индустрии это важно по нескольким причинам.
🟣 Бенчмарки становятся ближе к реальной разработке. На практике вам часто дают не идеальное описание задачи, а работающий продукт, макет или старую версию.
🟣 Можно честно измерять композиционную сложность. Не просто «починил баг», а «удержал восемь зависимых шагов подряд».
🟣 Появляется новая ось сравнения моделей: как они наблюдают, как проверяют себя и как распределяют внимание.
🟣 Такой бенчмарк подходит для дообучения. Из него можно делать учебную программу: от простых исправлений к длинным сценариям, в том числе через обучение с подкреплением.
И ещё одна важная мысль: работающее приложение здесь выступает не просто объектом теста. Оно становится источником спецификаций, задач и проверок. Это практичная идея для будущих дата-пайплайнов вокруг агентов для программирования.
Вывод
ProgramDistill — это попытка проверять агентов для программирования в более жизненном режиме: когда нужное поведение не описано словами, а спрятано в работающем интерфейсе. Вместо текстовой задачи агенту дают живой эталон, а дальше смотрят, сможет ли он понять и воспроизвести функциональность в коде.
Главный вывод: чем длиннее и зависимее сценарий, тем быстрее падает качество. Лучшие модели ещё держатся на коротких исправлениях, но на глубине 6–8 шагов начинают заметно сдавать. Причина не только в коде. Агенты часто слишком мало наблюдают, недостаточно проверяют своё решение и пропускают важные детали поведения.
Если вы хотите строить полезных агентов для веб-разработки, одной способности писать код мало. Нужны ещё три вещи: умение исследовать эталон, удерживать длинные зависимости и строго проверять результат. ProgramDistill как раз измеряет эту тройку.
Читайте также
 Как ИИ помогает разрабатывать игры
 Как проверить, понимает ли ИИ-ассистент мотивы людей
 Как ИИ-агент управлял интернет-магазином и увеличил капитал в 14 раз
 Последний ИИ, созданный людьми: на пути к рекурсивному самоулучшению
 Как ИИ-агент за несколько дней собрал играбельный шутер
 Как граф превращает ошибки ИИ-агента в подсказки
 А что, если ИИ-агенту проще пересоздать библиотеку, чем чинить её?
 Как ИИ-агент превращает научную статью в рабочий код
 Как ИИ-агент делает дизайн красивым и редактируемым
 Как собирать готовые навыки для ИИ-агентов из репозиториев с кодом
 Почему каждому студенту нужен ИИ-репетитор
 Как ИИ-агенты меняют роль разработчика
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram