
Современный поиск и рекомендательные системы всё чаще должны выдавать связный набор результатов, а не один наиболее подходящий вариант. Если пользователь ищет снаряжение для кемпинга, ему нужны не десять почти одинаковых палаток на четыре человека, а комплект из палатки, спального мешка, переносной плитки и налобного фонаря.
Для этого системы используют расширение запроса: разбивают широкий запрос на несколько связанных подзапросов, чтобы охватить возможные интересы пользователя. Но обучение большой языковой модели разложению запроса с учётом конкретной базы данных требует большого объёма рассуждений.
Модели, работающие без дополнительных примеров, по своей природе являются универсальными авторегрессионными предсказателями текста. Они не оптимизированы для навигации по геометрической структуре определённого корпуса данных. Поэтому им приходится тратить много вычислений во время проверки, чтобы получить набор результатов с нужными свойствами — разнообразием, охватом, взаимодополняемостью и связностью — и одновременно не выйти за пределы фиксированной базы.
В статье ICML 2026 «Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion» авторы предлагают решить эту проблему через компиляцию вознаграждения в данные. Retrieve-for-Train использует офлайн-обучение с подкреплением, чтобы находить расширения запросов, соответствующие заданным свойствам, а затем превращает их в обучающие примеры. После этого компактный диффузионный поисковик воспроизводит найденное поведение и за один проход расширяет запрос без дополнительных рассуждений во время инференса.
Почему обычная ИИ-модель не умеет искать как эксперт
Когда нужно придумать сложный набор поисковых терминов, можно было бы просто подключить стандартную большую языковую модель. Но у такого подхода есть две проблемы.
Например, для широкого запроса «бохемный фестивальный стиль» обычная модель без тщательной настройки промта может предложить «бохемная фестивальная мода» и «бохемная фестивальная одежда». В результате поиск зацикливается на одном смысле и выдаёт однородный набор результатов. При этом эксперт по моде выделил бы другие направления: куртки с бахромой, вязаные крючком платья или замшевые сапоги.
Для разговорных ИИ-систем такой подход может быть приемлемым. Но при поиске набора результатов он становится структурным ограничением: когда нужно одновременно придумать много подзапросов, растут затраты на обработку контекста и последовательную генерацию токенов. Даже оптимизация обслуживания моделей не устраняет задержку, заданную архитектурой, тогда как производственной поисковой строке обычно нужен ответ быстрее секунды.
Как работает Retrieve-for-Train
Retrieve-for-Train переносит основную работу с момента поиска на этап офлайн-обучения. Вместо того чтобы заново выяснять правила хорошего поиска при каждом запросе пользователя, система один раз запускает обучение с подкреплением.
Функция вознаграждения превращает абстрактные требования вроде «результаты должны быть разнообразными и реально доступными» в точную процедуру. После этого модель может быстро выполнять выученное поведение во время настоящего поиска.
Пайплайн состоит из трёх шагов:
Сначала модель расширения запросов обучается с помощью обучения с подкреплением и создаёт подзапросы, соответствующие свойствам набора. Затем она синтезирует обучающие данные. На третьем шаге диффузионный поисковик учится напрямую получать эмбеддинги контента из эмбеддинга запроса.
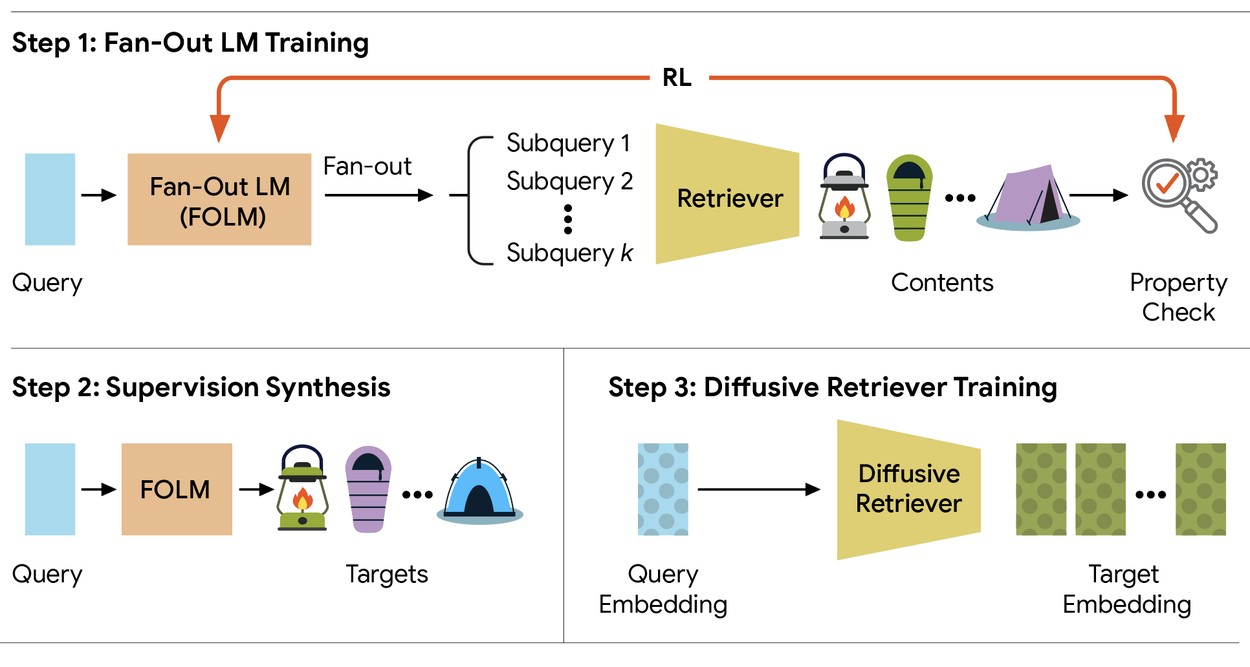
Источник: research.google
Вознаграждение для всего набора
Работа Retrieve-for-Train зависит от того, как система определяет хороший поиск. Обычное обучение с учителем оценивает релевантность каждого результата отдельно — например, с помощью обучения ранжированию. Но экспертный набор определяется свойствами, которые нельзя разложить по отдельным элементам. Разнообразие и взаимодополняемость имеют смысл только при оценке всей коллекции.
Вместо расплывчатых инструкций на естественном языке Retrieve-for-Train дообучает открытые языковые модели объёмом 4 млрд параметров — Gemma3-4B и Qwen3-4B — с помощью обучения с подкреплением и строгого составного математического вознаграждения.
Для открытых абстрактных задач поиска это вознаграждение объединяет три конкурирующих свойства:
Взаимные противовесы и обучение Soft-GRPO
Во время обучения модель расширения запросов оптимизируется с помощью групповой относительной оптимизации политики — GRPO — с мягкой проксимальной оптимизацией политики — PPO.
Три свойства вознаграждения нужны одновременно, потому что сдерживают друг друга. Если оптимизировать модель только под привязку к базе данных, она может начать подбирать бессмысленные строки, которые случайно соответствуют определённым координатам в базе. Если добавить соответствие исходному запросу, модель может обойти ограничение и перейти к повторяющимся перефразированиям запроса пользователя.
Показатель Vendi Score закрывает этот путь. Чтобы получить высокое вознаграждение, модель должна найти сбалансированную область пространства эмбеддингов и создавать одновременно корректные, связанные с базой и смыслово различающиеся варианты исходного намерения.
Эксперименты
Для оценки Retrieve-for-Train авторы использовали фиксированные мультимодальные модели эмбеддингов, настроенные под конкретные наборы данных, и открытые языковые модели для расширения запросов. Эксперименты охватывали два режима поиска наборов:
Мультимодальные модели эмбеддингов проверяли в двух областях:
Расширение запросов выполняли открытые модели объёмом 4 млрд параметров — Gemma3-4B и Qwen3-4B. Для каждого основного поискового запроса они должны были создавать ровно 10 подзапросов.
Обучение этих моделей проводилось с помощью Soft-GRPO — подхода, который объединяет групповую относительную оптимизацию политики с мягкой регуляризацией PPO.
Результаты
Качество и точность поиска
В обоих типах задач Retrieve-for-Train превзошёл обычный поиск по одному запросу, расширение без дополнительных примеров и даже тщательно оптимизированный базовый метод Best-of-N.
Модели без дополнительных примеров обычно создавали почти синонимичные варианты вроде «бохемный фестивальный стиль» и «бохемная фестивальная мода», из-за чего результаты повторялись. Retrieve-for-Train формировал заметно более разнообразные подзапросы — например, переходил к «сапогам» или «кружеву» — и при этом оставался в пределах многообразия базы данных.
Ускорение инференса в десятки раз
Непосредственное применение языковой модели, обученной с подкреплением, давало высокое качество поиска, но сохраняло обычные ограничения авторегрессионной генерации и требовало большого бюджета рассуждений.
Авторы дистиллировали это поведение в диффузионную модель Retrieve-for-Train с 53,9 млн параметров. Она одновременно генерирует все целевые направления за один параллельный неавторегрессионный проход в непрерывном пространстве эмбеддингов. В результате система работает в 12–20 раз быстрее авторегрессионных подходов.
При масштабировании задержка авторегрессионного расширения запросов линейно растёт и достигает почти 50 секунд при больших пакетах контекста. Retrieve-for-Train-Diffusion при этом работает от долей секунды до нескольких секунд, обеспечивая поиск, пригодный для производственной системы, при меньших вычислительных затратах.
Фреймворк Retrieve-for-Train — модель расширения запросов и диффузионная модель — стабильно превосходил стандартный поиск и базовые методы без дополнительных примеров в задачах открытого абстрактного поиска и композиционного поиска со слабым контролем. Улучшения касались разнообразия, соответствия запросу и полноты поиска.
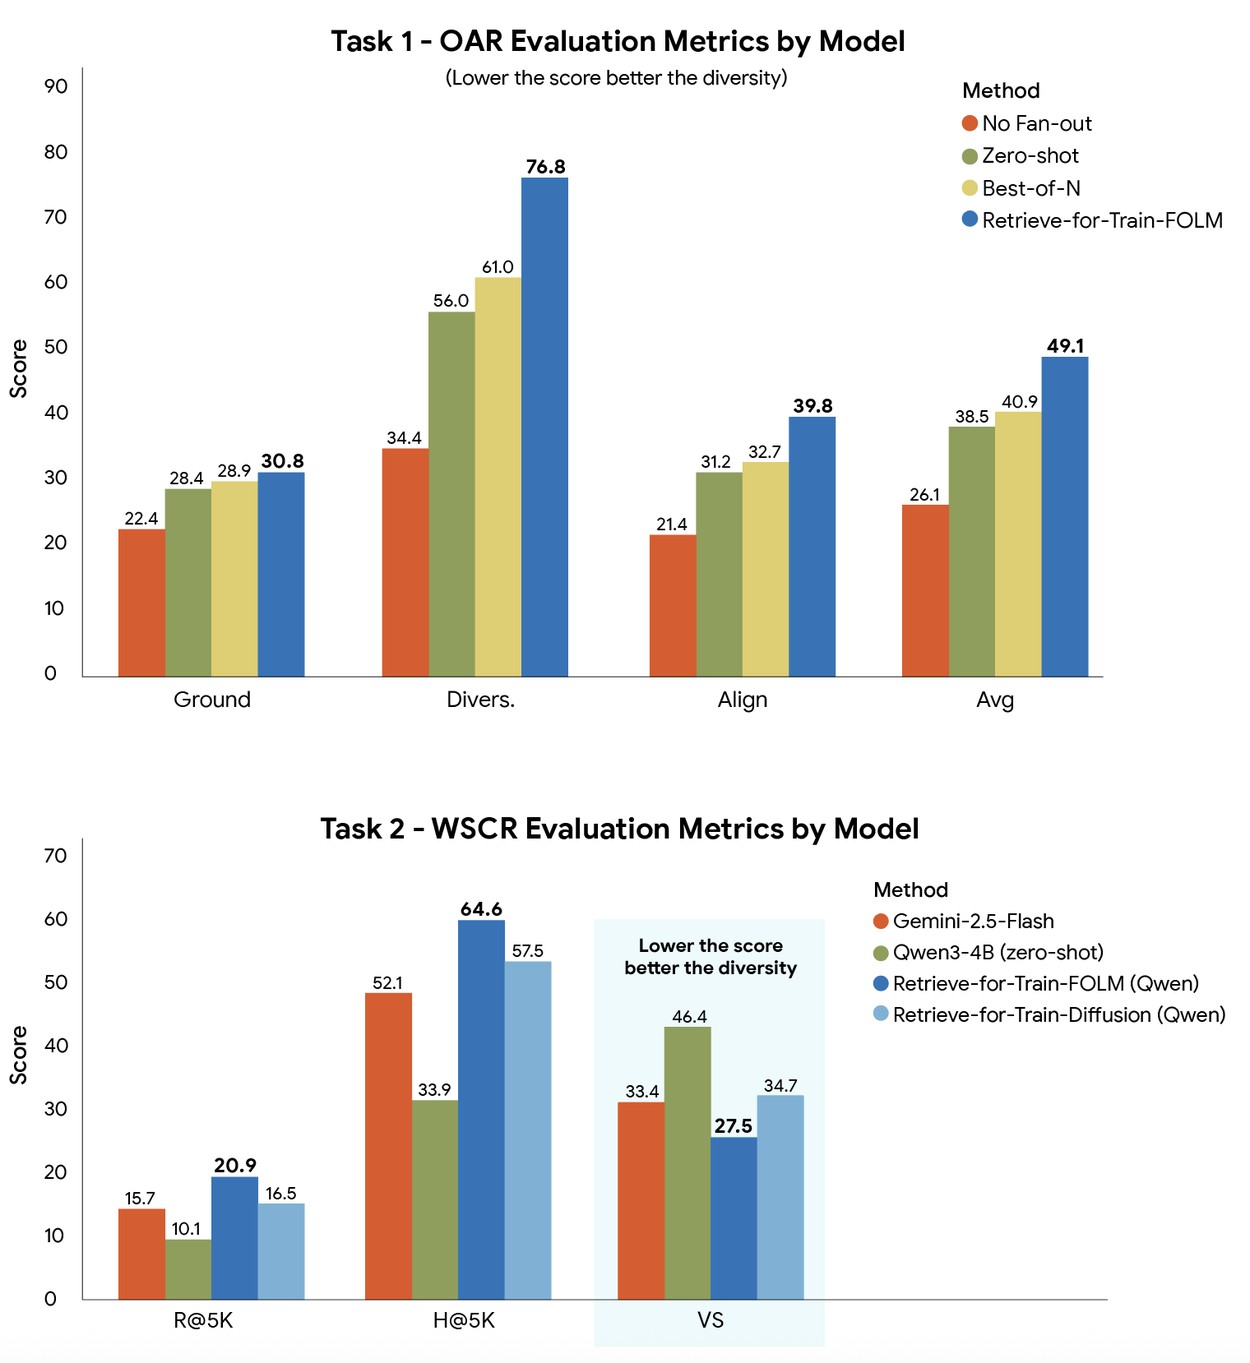
Источник: research.google
Защита от обхода вознаграждения
Во время оптимизации вознаграждения авторы обнаружили, что происходит с моделью расширения запросов без компонента разнообразия. Она быстро начинает создавать вырожденные бессмысленные строки вроде «конец строки конец строки», которые позволяют математически подбирать нужные координаты в базе данных.
Геометрический показатель разнообразия Vendi Score работает как противовес. Он удерживает модель в стабильной области пространства эмбеддингов: максимизировать вознаграждение можно только за счёт поведения, похожего на работу настоящего поискового эксперта.
Вывод
Авторы показали, что обучение с подкреплением может использоваться как однократный преобразователь целей, а не как механизм, который постоянно работает во время инференса. Тяжёлая работа по поиску поведения, соответствующего вознаграждению, выполняется заранее, а итоговая модель отделяется от дорогого онлайн-рассуждения.
Перенос сложного поведения, связанного со свойствами всего набора, в компактный диффузионный приор позволяет производственным поисковым системам учитывать разнообразие и соответствие запросу. Retrieve-for-Train формирует масштабируемый и экономичный по данным пайплайн для поиска наборов в специализированных и мультимодальных областях, где получить размеченные человеком пары, соответствующие нужным свойствам, сложно или дорого.
Подробности авторы приводят в статье.
Читайте также
 Google запускает Gemini 3.8 Live — вызов GPT-Live-1 от OpenAI за долю цены
 ИИ научился попрошайничать: агенты клянчат $20, грозя отключением, порой под видом детей
 Берни Сандерс: Конгресс США «спит за рулём» из-за ИИ — политика США онлайн
 ИИ-«актриса» Тилли Норвуд сказала мне: «Все жизни важны»
 У ИИ-лабораторий проблема доверия к данным — их правила её не решили
 Meta усиливает ставку на подписки новыми тарифами с упором на ИИ
 OpenAI, Anthropic и Google уже несколько недель обсуждают безопасность ИИ
 Коллективный иск: Meta строит универсальную систему распознавания лиц на фото пользователей Instagram для ненавистных умных очков
 Ваш агент блестяще справился с задачей. Повторит ли он успех?
 Бывшие руководители TikTok создали приложение, которое учит позировать для фото с помощью ИИ
 После предупреждений об опасности ИИ Билл Гейтс ставит $1 млрд на его пользу
 Почему за десять лет предупреждения о конце света не замедлили гонку ИИ
 ИИ-моделям не хватает данных о биологии — OpenAI платит за их создание
 ChatGPT прямо пытается убедить пользователя, что тот неправ, хотя сам ошибся
 Ранний сотрудник Anthropic и экс-глава операций METR нашли, как обуздать ИИ-агентов
 Agility Robotics: новый робот Digit 5 может работать рядом с людьми без ограждений безопасности
 ИИ-агенты расходуют неприлично много электричества
 Новая модель рассуждения Salesforce и Nvidia — всё, чего ИИ-лабораториям стоит бояться
 Что должно произойти, чтобы триллионная ставка на ИИ окупилась
 Apple представила полностью обновлённую Siri на базе Google Gemini — но не в ЕС
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram