Когда каждый файл получает помощника
В большом проекте исправить одну ошибку — значит разобраться не только в коде, где она возникла. Нужно понять, какие настройки на неё влияют, какие части программы вызывают этот код и какие тесты проверяют результат. Чем дольше ИИ-агент работает над задачей, тем больше информации ему приходится собирать и удерживать в контексте. В итоге он может упустить связь между файлами или запутаться в собственных шагах.
Авторы статьи предлагают изменить подход к работе с репозиторием. Вместо одного агента, который снова и снова перечитывает нужные материалы, они создают Dev-Primitives: программные компоненты, каждый из которых связан с одним файлом и отдельной языковой моделью. Эти помощники изучают свой файл, меняют его и сообщают другим компонентам, какие изменения нужны от них.
На этой идее построен HERMES — обвязка, которая выбирает нужные компоненты, запускает их, проверяет результат и направляет следующую попытку туда, где обнаружилась проблема. На четырёх бенчмарках HERMES в среднем улучшил результаты сопоставимых систем на 12,4 процентного пункта.
От пассивных файлов к работающим участникам
Обычный агент воспринимает файлы как материалы для работы: читает их, держит часть содержимого в контексте и сам решает, что менять. В долгой задаче ему приходится заново восстанавливать устройство проекта после каждого изменения. Контекст растёт, а детали требований и связей между файлами могут теряться.
В HERMES каждый компонент проекта становится Dev-Primitive — помощником, связанным с конкретным файлом. Это может быть исходный код, настройка, сценарий сборки или тест. Компонент получает локальную задачу, изучает собственный файл и при необходимости меняет его.
Если изменение затрагивает соседние файлы, помощник отправляет им сообщение на обычном языке. Например: «изменился формат данных, обновите обработку на своей стороне» или «проверьте новый вариант поведения в тестах». Сообщения идут только тем компонентам, которых касается изменение. Файлу не нужно переписывать весь план проекта: он передаёт именно те требования, которые знает лучше всего.
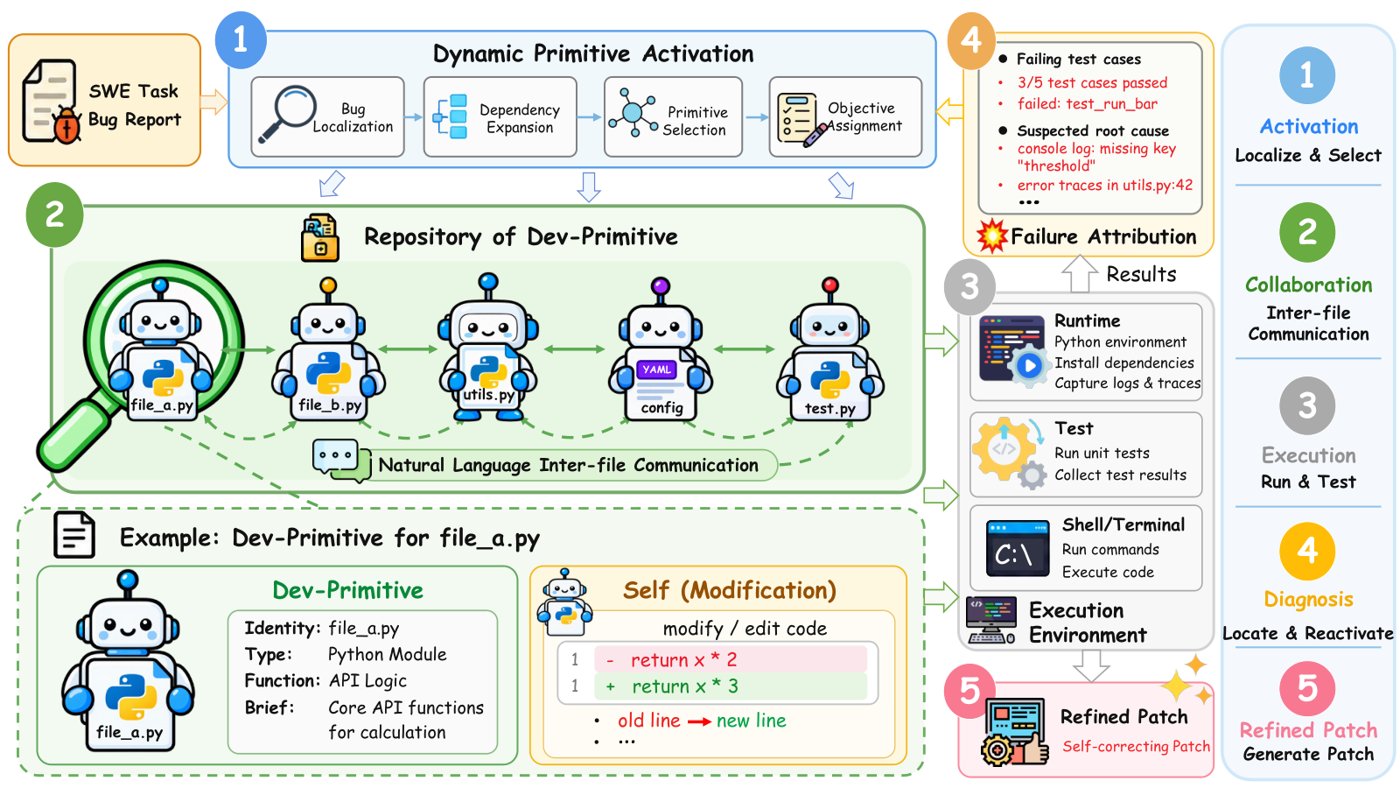
Схема HERMES: система выбирает связанные с задачей файлы, поручает им локальные изменения, запускает проект и направляет новые попытки по результатам проверки.
Все файлы не получают помощников одновременно. Сначала HERMES анализирует задачу и определяет, какие компоненты, вероятно, участвуют в нужном поведении. Затем прослеживает связи: к вызывающему коду, настройкам и тестам. Помощники запускаются только для выбранных компонентов.
После изменений система запускает проект и собирает доступные результаты: ошибки команд, итоги тестов, журналы и трассировки. Отдельный модуль диагностики выясняет, какие компоненты могли вызвать оставшуюся проблему. На следующем круге HERMES возвращается к ним и при необходимости подключает новые файлы. По умолчанию система может провести три таких круга после первой попытки.
Что показали испытания
Исследователи проверили HERMES на четырёх бенчмарках. Они охватывают исправление ошибок в реальных проектах, перенос всей кодовой базы на новую версию интерфейса, задачи в командной строке и рабочие процессы для сборки и эксплуатации программ.
Главное сравнение устроено так: у базовой системы и HERMES один и тот же ИИ. Меняется только обвязка. Поэтому разницу в результатах авторы связывают с организацией работы, а не с переходом на более мощную модель.
На бенчмарке SWE-bench Verified, где нужно исправлять ошибки в реальных проектах, HERMES повысил долю решённых задач в 19 из 20 проверенных конфигураций моделей и сравнялся с базовой системой в оставшейся. Для GPT-5 Mini прирост составил 19,4 процентного пункта. С GPT-5.6 Sol результат вырос с 96,2% до 97%.
На переносе всей кодовой базы эффект оказался заметнее. В одном сравнении с GPT-5.6 Sol доля задач с ненулевым результатом выросла с 6,5% до 31%. Такая работа особенно зависит от согласованности изменений в разных файлах: если обновить основной код, но пропустить настройки, вызовы или тесты, проект может не заработать.
В задачах командной строки GPT-5.6 Sol с HERMES решил 51,8% заданий против 33% у базовой обвязки. В рабочих процессах для сборки и эксплуатации средний результат этой модели вырос с 49,89% до 55,41%.
За прирост приходится платить. HERMES чаще вызывает модель и тратит больше токенов: ему нужно активировать несколько помощников, запускать проект и разбирать ошибки. Поэтому высокая точность не означает снижения стоимости во всех случаях. Однако система позволяет выбирать, где использовать крупную модель, а где — небольшую.
Где выгоднее использовать большую модель
Авторы отдельно проверили сочетание моделей разного размера. Небольшая Qwen3-8B могла работать внутри Dev-Primitives, а более крупные модели — выбирать файлы для задачи и разбирать результаты проверки. Это разделение оказалось полезным: судя по опытам, качество диагностики сильнее влияет на результат, чем усиление модуля выбора файлов.
В испытании на бенчмарке Terminal-Bench сочетание GPT-5.6 Sol для выбора компонентов, Qwen3-8B для работы с файлами и GPT-5.5 для диагностики решило 49,7% задач. Однородная конфигурация с GPT-5.6 Sol на всех ролях достигла 51,8%. Разница — 2,1 процентного пункта, а стоимость инференса оказалась на 37,4% ниже. Это показывает, что в такой системе сильную модель можно оставить для решений, от которых больше всего зависит успех, а локальные изменения поручить более лёгкой.
Опыты с отключением отдельных частей объясняют, что именно помогает HERMES. Качество сильнее всего снижалось, когда система переставала разбирать результаты выполнения и выдавать адресные рекомендации для следующей попытки. На бенчмарке переноса кодовой базы удаление диагностики уменьшило результат с 31% до 20%. Когда помощникам запретили обмениваться сообщениями, показатель упал до 23,5%.
В HERMES выбор файлов, локальные изменения, выполнение кода и диагностика образуют повторяющийся цикл работы.
Активация нужных компонентов тоже важна для расходов. Когда выбранные помощники оставались активными на всех кругах, среднее число их вызовов на одну задачу росло в 1,6–1,9 раза. При этом качество снижалось. Повторный выбор компонентов по мере появления новых свидетельств помогал не тратить ресурсы на файлы, которые больше не нужны.
Что пока остаётся сложным
HERMES зависит от двух решений: какие файлы подключить и как истолковать результаты запуска. Если модуль выбора пропустит важную часть проекта, помощники могут исправить только часть проблемы. Если вывод тестов и журналов ничего не объясняет, системе будет трудно понять, где продолжать работу.
Есть и ограничения самих испытаний. Авторы используют файлы как основные единицы работы, хотя в некоторых задачах полезнее было бы делить проект на более мелкие части. А бенчмарки, даже разнообразные, не охватывают все виды работы с программами. Результаты с Qwen3-8B также зависят от конкретной конфигурации запуска модели.
Качество агента зависит не только от того, какая модель пишет код, но и от того, как система распределяет работу, связывает изменения между файлами и использует результаты проверки. HERMES переносит часть ответственности за состояние проекта с одного общего агента на компоненты, которые лучше знают собственные файлы. Такой подход особенно полезен для длинных задач, где ошибка часто возникает не в одном месте, а между несколькими связанными частями программы.
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram