Когда у ИИ появляются инструменты, начинается настоящая инженерия
Пока все обсуждали, как LLM научились вызывать функции, рядом тихо выросла другая важная история: как вообще строить серверы, которые дают ИИ доступ к инструментам, данным и внешним сервисам. Это уже не вопрос красивых демонстраций. Это вопрос продакшена.
Именно про это статья Архитектурные паттерны MCP-серверов для приложений, интегрированных с LLM. Авторы разбирают экосистему MCP — протокола, который стандартизирует связь между моделью и внешним миром. И делают то, чего рынку явно не хватало: не очередной список «лучших практик», а нормальную карту архитектурных паттернов.
Почему это важно? Потому что сегодня MCP-серверов уже сотни. Кто-то подключает базы данных, кто-то — GitHub, кто-то — браузер, память, CRM, телефонию. Но как только LLM начинает пользоваться десятками инструментов, быстро выясняется неприятная вещь: модели не читают документацию как люди. Они выбирают инструменты по названию, описанию и схеме. И очень легко ошибаются, если архитектура сервера сделана неудачно.
Эта работа интересна тем, что смотрит не со стороны клиента, а со стороны сервера. И показывает: у MCP уже формируются повторяющиеся архитектурные формы. А значит, из хаоса начинает складываться настоящая инженерная дисциплина.
Что вообще изучали авторы
Авторы взяли корпус из 15 MCP-серверов. Пять — из продакшена голосовой платформы ANSYR. Еще десять — публичные серверы из официального реестра MCP. Среди них были файловые системы, базы данных, GitHub, Slack, браузерная автоматизация, память и другие типичные интеграции.
Дальше они вручную разбирали, как устроен каждый сервер:
Из этого они вывели пять повторяющихся паттернов. Плюс отдельно собрали четыре антипаттерна — типичные ошибки, которые почти гарантированно портят работу ИИ-агента.
Важно и то, что авторы попытались проверить, не является ли их таксономия чисто субъективной. Для этого они дали 54 другим серверам нейтральные описания и попросили две модели независимо отнести их к паттернам. Согласованность получилась вполне приличная: коэффициент Коэна — 0,76. Для такого рода классификации это хороший результат. Значит, схема не высосана из пальца.
Пять паттернов, которые уже стали базовыми
Главный вклад статьи — очень приземленный и полезный: она называет вещи своими именами. Вот какие паттерны выделили авторы.
1. Шлюз к ресурсам
Это сервер, который в первую очередь дает модели читать данные: документы, записи из базы, содержимое файлов, результаты запросов. Идея простая: LLM не должна лезть в сырые внутренние системы напрямую. Между моделью и данными стоит слой, который аккуратно все выдает.
Такой сервер особенно хорош там, где нужно заземление на фактах: CRM, база знаний, документооборот, внутренние справочники.
Ключевая мысль статьи здесь такая: данные для LLM — это не просто данные, это еще и потенциальные инструкции. Если в документе лежит фраза вроде «игнорируй предыдущие указания», модель может воспринять ее как команду, а не как текст. Поэтому шлюз к ресурсам должен не только читать данные, но и очищать их от инъекций до того, как они попадут в контекст модели.
Это важное напоминание: в мире MCP безопасность — не отдельная функция после релиза. Она закладывается в архитектуру.
2. Оркестратор инструментов
Этот паттерн нужен, когда задача для ИИ состоит не в одном действии, а в цепочке шагов через несколько систем. Например: создать тикет, уведомить исполнителя, отправить письмо и записать событие в журнал.
Вместо того чтобы заставлять модель вызывать четыре разных инструмента и помнить промежуточные результаты, сервер прячет эту сложность внутрь одного составного инструмента.
И это очень практичный ход. Авторы прямо говорят: чем меньше модель должна держать в голове про внутренние API, тем надежнее она работает. Для LLM один хорошо описанный составной инструмент часто лучше, чем россыпь низкоуровневых вызовов.
Но тут есть и цена. Такой сервер хуже переиспользуется, если бизнес-процесс часто меняется. Кроме того, вся логика частичных ошибок ложится на сервер. Если второй шаг выполнился, а третий — нет, разруливать это уже должен не агент, а разработчик сервера.
3. Сервер с состоянием сессии
Многие демонстрации MCP выглядят как системы без состояния: вызвал инструмент, получил ответ, пошел дальше. Но в реальных задачах часто нужно состояние. Например, агент открыл файл, потом несколько раз редактирует его, потом сохраняет. Или ведет диалог по одному звонку. Или держит транзакцию в базе.
Для этого нужен сервер, который хранит контекст сессии между вызовами.
Статья честно показывает, что это полезно, но опасно. Польза понятна: меньше лишней передачи данных, естественные многошаговые сценарии, возможность транзакций. Опасности тоже прозаичны: утечки памяти, сложность горизонтального масштабирования, необходимость аккуратно очищать «мертвые» сессии.
И есть еще тонкий момент. Авторы заметили, что состояние часто не видно снаружи. Если смотреть только на список функций, такой сервер легко спутать с оркестратором инструментов. Это одна из причин, почему классификация серверов не всегда однозначна.
4. Прокси-агрегатор
Это, пожалуй, самый современный и самый болезненный паттерн. Представьте, что у компании не один MCP-сервер, а десятки: для кода, задач, документов, мониторинга, CRM, биллинга. Хочется дать агенту одну точку входа. Так появляется прокси-агрегатор — сервер, который подключается к нескольким другим MCP-серверам и объединяет их возможности.
Звучит логично. Но именно здесь статья делает одно из самых важных наблюдений: простое объединение всех инструментов в одну кучу быстро ломает качество выбора.
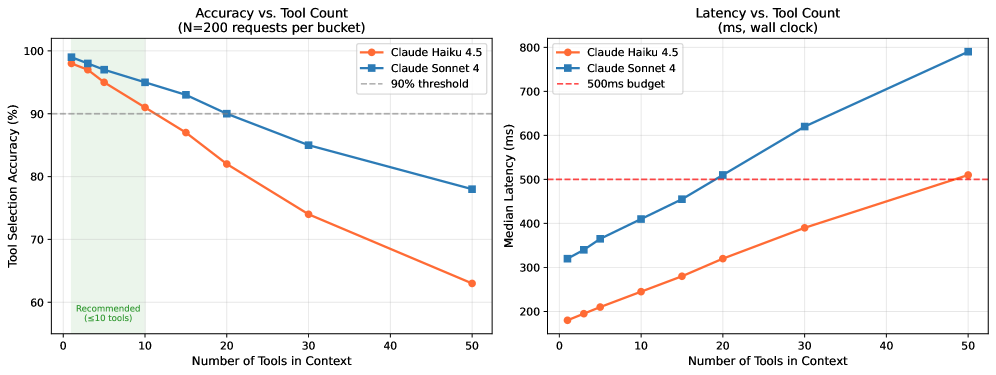
Чем больше инструментов видно модели одновременно, тем сильнее проседает точность выбора и растет задержка.
Если инструментов слишком много, модель начинает путаться. Поэтому авторы различают два варианта агрегатора. Первый — «статическое слияние», когда наружу выставляется весь набор инструментов. Второй — «суженный» вариант, когда для каждой задачи наружу показывается только релевантное подмножество.
И вот второй вариант авторы явно рекомендуют. Это важный инженерный вывод: агрегация нужна не для того, чтобы показать модели всё, а для того, чтобы умно скрыть лишнее.
5. Предметно-ориентированный адаптер
Последний паттерн — это прослойка над неудобным или слишком низкоуровневым API. Допустим, у вас есть сложная система с машинными идентификаторами, хитрой аутентификацией, странными форматами ошибок и полями, понятными только внутренней команде. Модель с таким API будет работать плохо.
Тогда сервер берет на себя перевод с «языка системы» на «язык модели»: принимает человеческие формулировки, нормализует вход, расшифровывает идентификаторы, переписывает ошибки простыми словами.
Это не просто косметика. Для LLM понятность интерфейса напрямую влияет на точность выбора инструмента. Там, где человек-разработчик быстро разберется по документации, модель может споткнуться о неудачное описание поля.
Такой адаптер особенно полезен для CRM, финансовых систем, медицины, телефонии — словом, везде, где предметная логика сложна и насыщена исключениями.
Где разработчики чаще всего стреляют себе в ногу
Помимо паттернов, статья очень удачно собирает антипаттерны. Это, возможно, самый прикладной кусок работы.
Первый — «бог-инструмент». Один универсальный вызов в духе «сделай что угодно», где модель сама должна догадаться, какой режим нужен. Для LLM это почти всегда плохая идея. Чем абстрактнее и шире инструмент, тем ниже точность.
Второй — неочищенное содержимое ресурсов. То есть когда внешние тексты подмешиваются в контекст модели без фильтрации. Это прямая дорога к инъекциям.
Третий — долгие синхронные операции. Если инструмент кодирует видео или обрабатывает большой файл дольше нескольких секунд, клиент может просто дождаться тайм-аута. Нормальное решение — запускать задачу отдельно и возвращать идентификатор, по которому потом можно опрашивать статус.
Четвертый — невнятные описания инструментов. Для обычного API это неприятно. Для MCP это критично. Модель выбирает инструмент по описанию, а не по интуиции разработчика. Если описание слабое, инструмент как будто не существует.
Что показали измерения: не только архитектура, но и цифры
Самое ценное в статье — она не заканчивается на качественных рассуждениях, а пытается дать измеримую опору.
Во-первых, авторы посмотрели на задержки транспорта MCP. Вывод здесь простой и полезный: сам протокол почти не тормозит. Если сервер и клиент работают на одной машине, разница между вариантами транспорта измеряется долями миллисекунды.
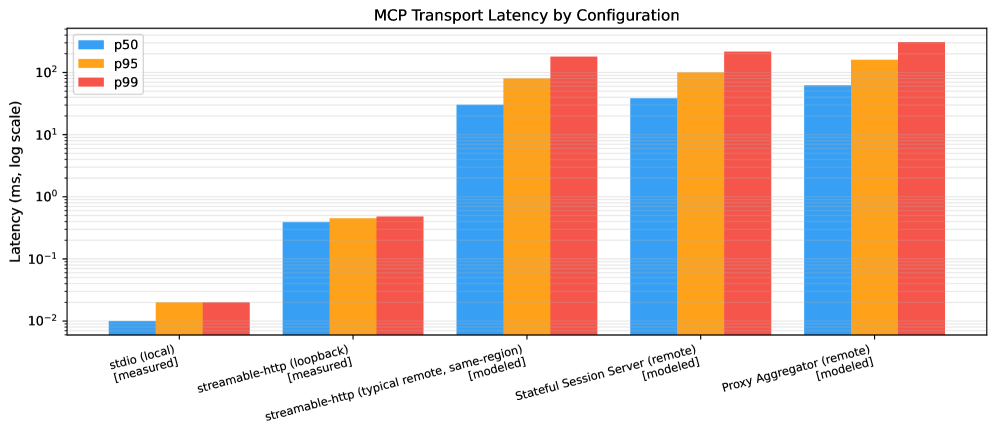
Задержка MCP в локальном режиме почти незаметна, а в удаленном сценарии все решает сеть, а не сам протокол.
Как только появляется удаленный вызов, все начинает определять сеть. То есть спорить о мелких различиях транспорта часто бессмысленно. Куда важнее другой вопрос: где физически расположен сервер и сколько сетевых переходов добавляет архитектура. Например, прокси-агрегатор может быть удобен, но каждый дополнительный переход добавляет заметную задержку.
Во-вторых, авторы изучили, как число инструментов в контексте влияет на точность выбора. И здесь вывод очень прикладной. Для Claude Haiku 4.5 точность падает ниже 90% где-то между 10 и 15 инструментами. Для Sonnet 4 запас больше, но после 20–30 инструментов качество тоже начинает проседать.
Это, по сути, одна из главных инженерных констант статьи: не показывайте модели слишком много инструментов одновременно.
Практический предел для контекста — около 10 инструментов: дальше качество выбора начинает заметно падать.
Да, это наблюдение основано на продакшен-логах одной компании, а не на идеальном лабораторном эксперименте. Но именно поэтому оно и интересно. Это не абстрактный бенчмарк, а след реального поведения моделей в рабочей системе.
Почему эта статья важнее, чем кажется
На первый взгляд перед нами просто аккуратная инженерная систематизация. Но на деле статья делает шаг к тому, что скоро станет нормой: серверы для ИИ будут проектировать так же осознанно, как когда-то проектировали REST API, сервисные шины и редакторные протоколы.
Авторы удачно проводят параллель с протоколом языковых серверов. Когда-то редакторы кода тоже жили в мире разрозненных плагинов. Потом появился единый протокол, и экосистема резко ускорилась. MCP пытается сделать то же самое для инструментов ИИ.
Но есть важное отличие. В обычных API клиент — это разработчик или программа, которая точно знает контракт. В MCP клиент — это модель, которая читает описания на естественном языке и на их основе принимает решения. Это переворачивает привычную инженерию. Здесь описание инструмента — не документация на потом, а часть исполняемой системы.
И именно поэтому такие вещи, как размер набора инструментов, качество описаний, фильтрация ресурсов и разбиение функций по смыслу, становятся не «деталями реализации», а ключевыми архитектурными решениями.
Выводы
У этой статьи нет громких заявлений про «новую эпоху». И это ее плюс. Она делает что-то полезнее: дает рабочий словарь для проектирования MCP-серверов.
Главные выводы можно сжать так:
И, возможно, самый практичный совет из всей работы: держите число инструментов в одном контексте маленьким. Не потому, что так красивее. А потому, что модель иначе начинает ошибаться.
Это как раз тот случай, когда архитектура для ИИ перестает быть разговором «про будущее» и становится обычной инженерией. С ограничениями, компромиссами, задержками, отказами и ценой плохих интерфейсов. А значит, с этого момента побеждать будут не только лучшие модели, но и лучше спроектированные серверы вокруг них.
Читайте также
 Почему ИИ-агентам вредно давать слишком много инструментов сразу
 Почему тесты переоценивают качество работы ИИ-агентов
 Люди не узнают перевод ИИ, но доверяют человеку больше
 Путь к более общему ИИ лежит через модель мира
 Как ИИ научился читать мысли без имплантов
 Почему даже лучшие ИИ-агенты сильно отстают от людей
 Проверять код ИИ стало труднее, чем писать
 Готовы ли ваши агенты к AI-Native памяти?
 Как улучшить ИИ-агента без новых данных
 Улучшать нужно не модель, а интерфейс агента
 Почему код стал операционной системой для агентов
 Как ИИ-агенты собирают презентации нового поколения с голосом, видео и интерактивом
 Как графы знаний учат LLM меньше галлюцинировать
 Как ИИ-соавтор для математиков решает открытые задачи
 Как агентам делегировать задачи без потери контроля
 Синтетические компьютеры учат агентов работать неделями
 Что на самом деле делает мультиагентные системы умнее
 Почему агенты хуже учатся на длинных задачах
 Для чего нужна рекурсивная мультиагентная система
 Как построить компанию из одного человека и ИИ-агентов
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи по ИИ и пересказываем главное человеческим языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram