
Самоулучшающиеся ИИ-агенты должны со временем самостоятельно находить новые алгоритмы, решения математических задач или более быстрый код. Обычно они предлагают решение, оценивают результат, учатся на нём и повторяют цикл. После тысяч попыток агент постепенно приближается к хорошему результату.
В сложных задачах пространство поиска может быть огромным. Агенту постоянно приходится выбирать, какие перспективные подходы продолжать, какие запускать параллельно, а от каких отказываться. Этот процесс исследования определяет, завершится ли поиск успехом или вычислительные ресурсы уйдут на бесперспективные идеи.
Исследовательская команда Google и Deepmind представила Dream-RSI, чтобы улучшить такие решения. Метод меняет стратегию поиска агента, но не саму модель ИИ.
Существующие подходы обычно используют один из двух вариантов. Фиксированная стратегия не учится на опыте, поэтому агент может снова и снова попадать в одни и те же тупики. Адаптация стратегии во время поиска устраняет эту проблему, но требует затрат: нужно много попыток, чтобы понять, работает ли новый подход, а проверка множества альтернатив заставляет повторять долгие и дорогие запуски.
Прошлые поиски помогают дешевле проверять стратегии
Исследователи предлагают использовать данные уже завершённого поиска для проверки альтернативных стратегий в том пространстве, которое агент успел исследовать. Во время работы агент сохраняет свои попытки и результаты — позже эти данные можно воспроизвести и заново проверить принятые решения.
Исследователи сравнивают такой подход с поиском дороги в незнакомом районе. Во время первого прохода человек натыкается на тупики, возвращается назад и с трудом прокладывает маршрут. Но после появления мысленной карты можно спланировать другой путь, не посещая заново каждое место.
Dream-RSI применяет этот принцип к сохранённым историям поиска. Вместо проверки новой стратегии в живом запуске агент прогоняет её по уже записанным результатам. Так он оценивает, что произошло бы, если бы сначала выбрал другие направления или раньше отказался от некоторых подходов. Во время воспроизведения система не создаёт полностью новые решения — она проверяет другие варианты решений внутри уже записанного дерева поиска.
Поскольку результаты уже существуют, агенту не нужно заново генерировать и оценивать решения. Это устраняет дорогие вычисления, необходимые при живом запуске, и делает проверку новых стратегий гораздо дешевле. Исследователи называют такой процесс «сновидением»: агент проигрывает тысячи вариантов и выбирает лучший, прежде чем применить его в новом живом поиске.
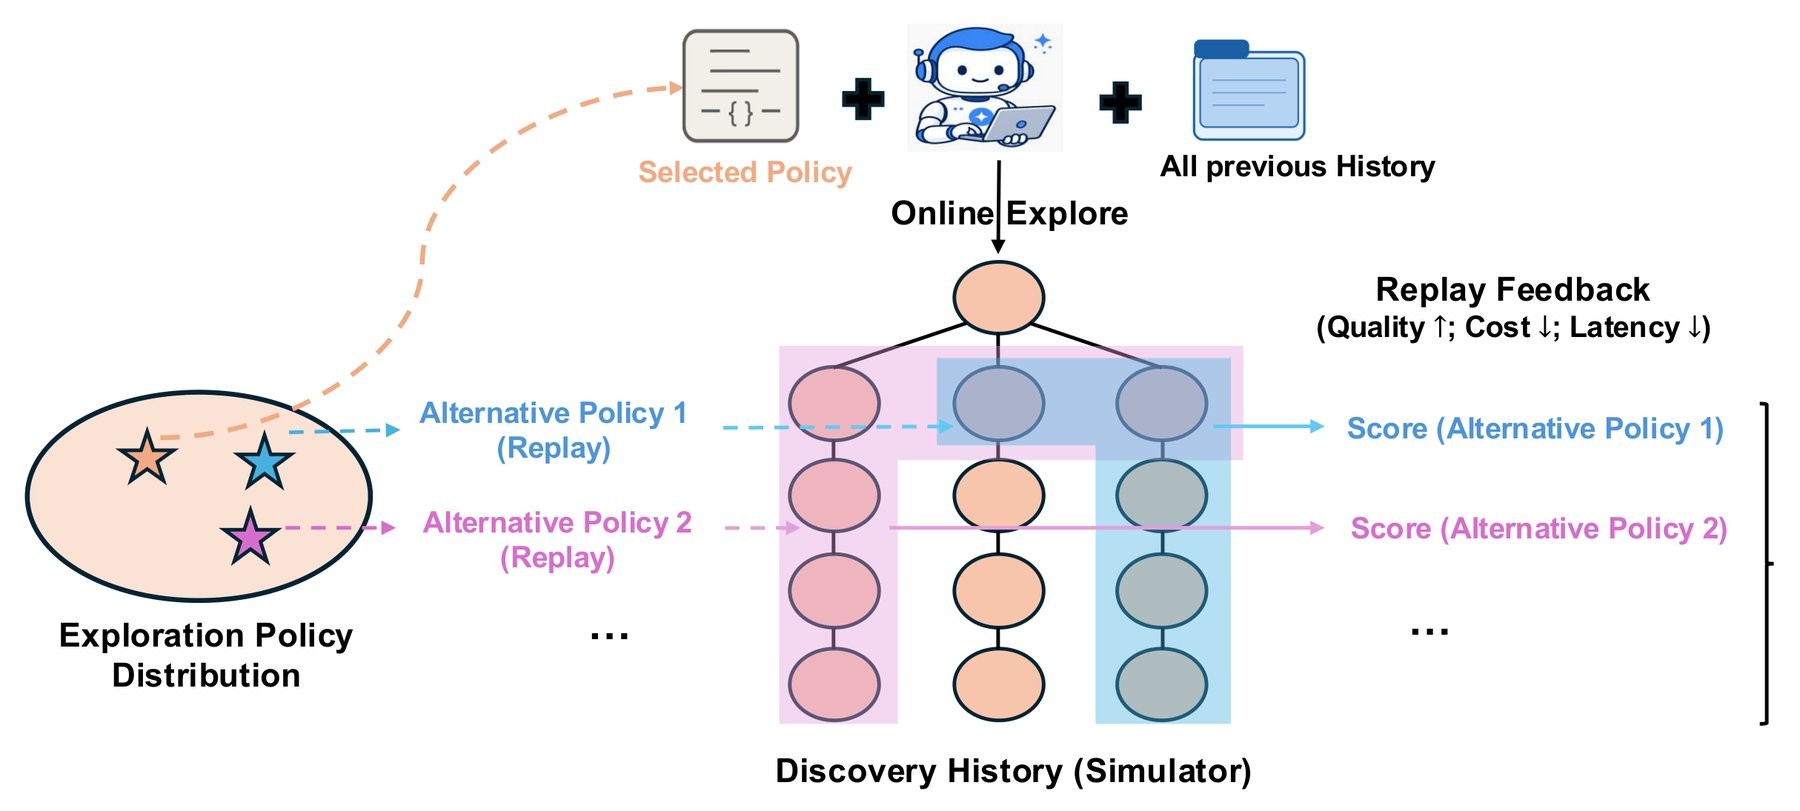
Поскольку все результаты сохраняются в дереве поиска, можно протестировать тысячи альтернативных стратегий, не обращаясь повторно к модели или оценщику
Источник: the-decoder.com
Цикл повторяется после каждого поиска. Агент использует записанные результаты для проверки улучшенных стратегий, а затем применяет выбранную версию в следующем живом запуске. При этом меняется только стратегия поиска, а модель, которая создаёт решения, остаётся прежней.
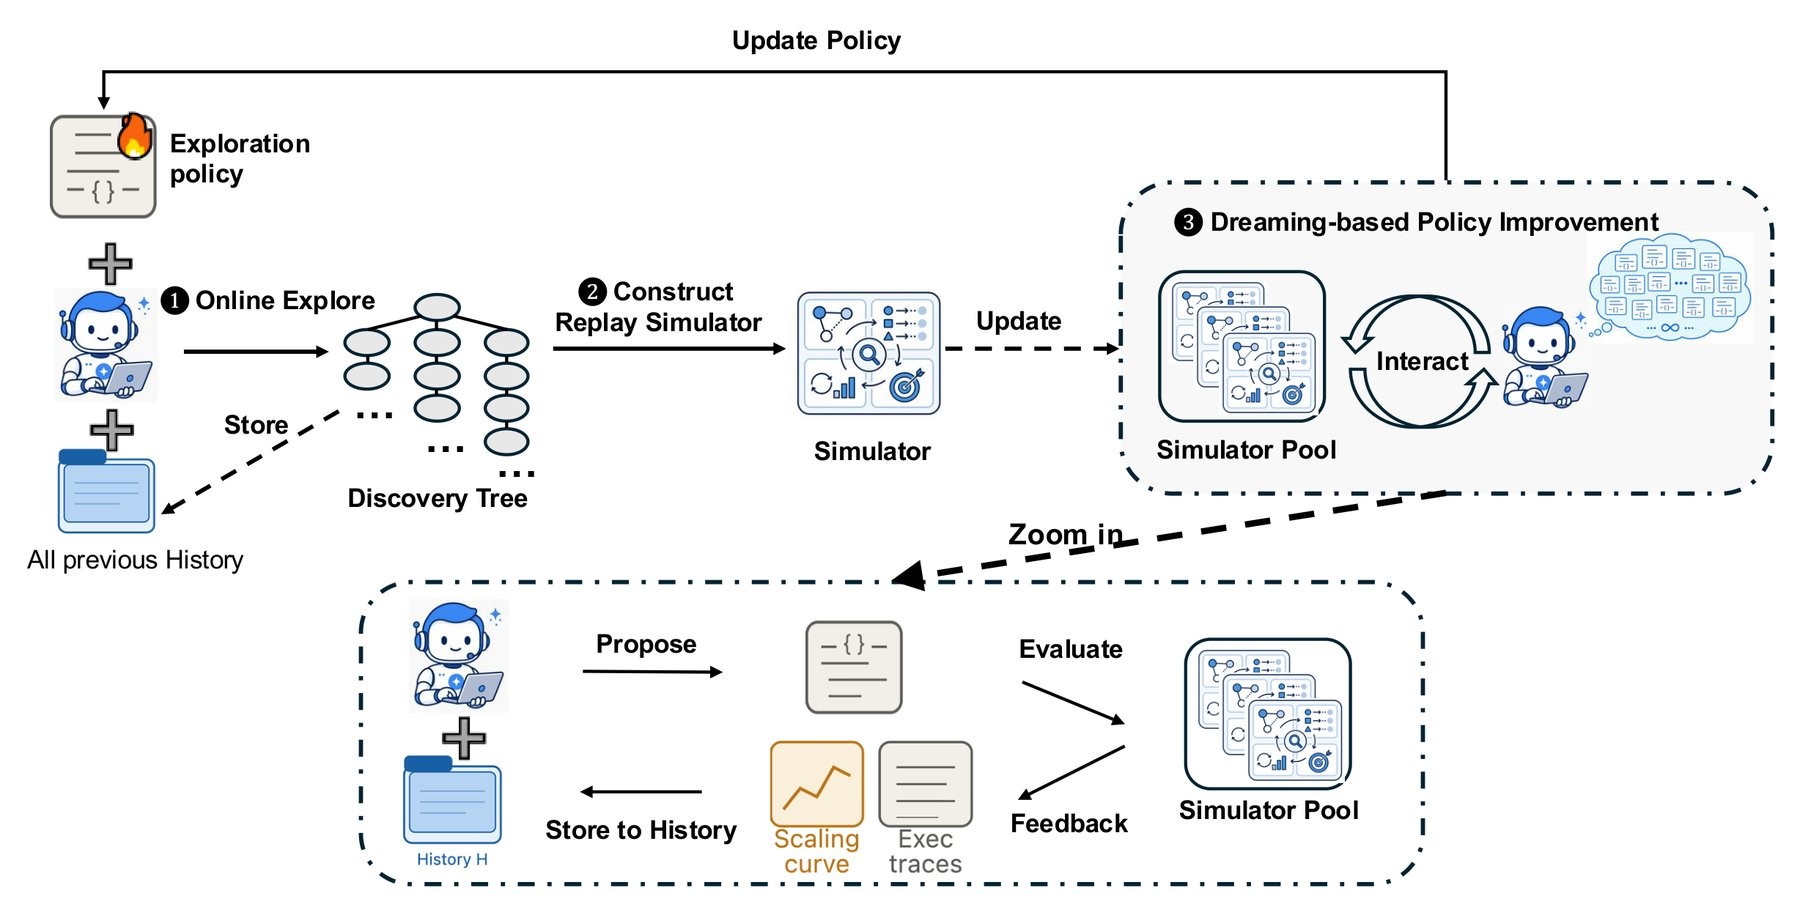
Dream-RSI чередует поиск в реальном времени и воспроизведение записанных историй поиска, используя улучшенную стратегию в следующем раунде
Источник: the-decoder.com
Dream-RSI находит решения за меньшее число попыток
Исследователи проверили Dream-RSI с Gemini 3.1 Pro и Gemini 3.7 Flash на восьми задачах из трёх областей. Для каждого сравнения использовали исходные условия с фиксированной стратегией поиска.
В одной задаче системе нужно было написать максимально быструю программу для статистического расчёта, который часто применяют в геномике и финансах. Программа Dream-RSI работала быстрее библиотек sklearn и glmnet на всех шести тестовых наборах данных.
С Gemini 3.1 Pro среднее время выполнения сократилось с 3,587 до 2,931 миллисекунды, а число попыток — с 550 до 317. Dream-RSI также обошёл конкурирующую систему SimpleTES: ей потребовалось 51,200 запусков против 317 попыток у Dream-RSI.
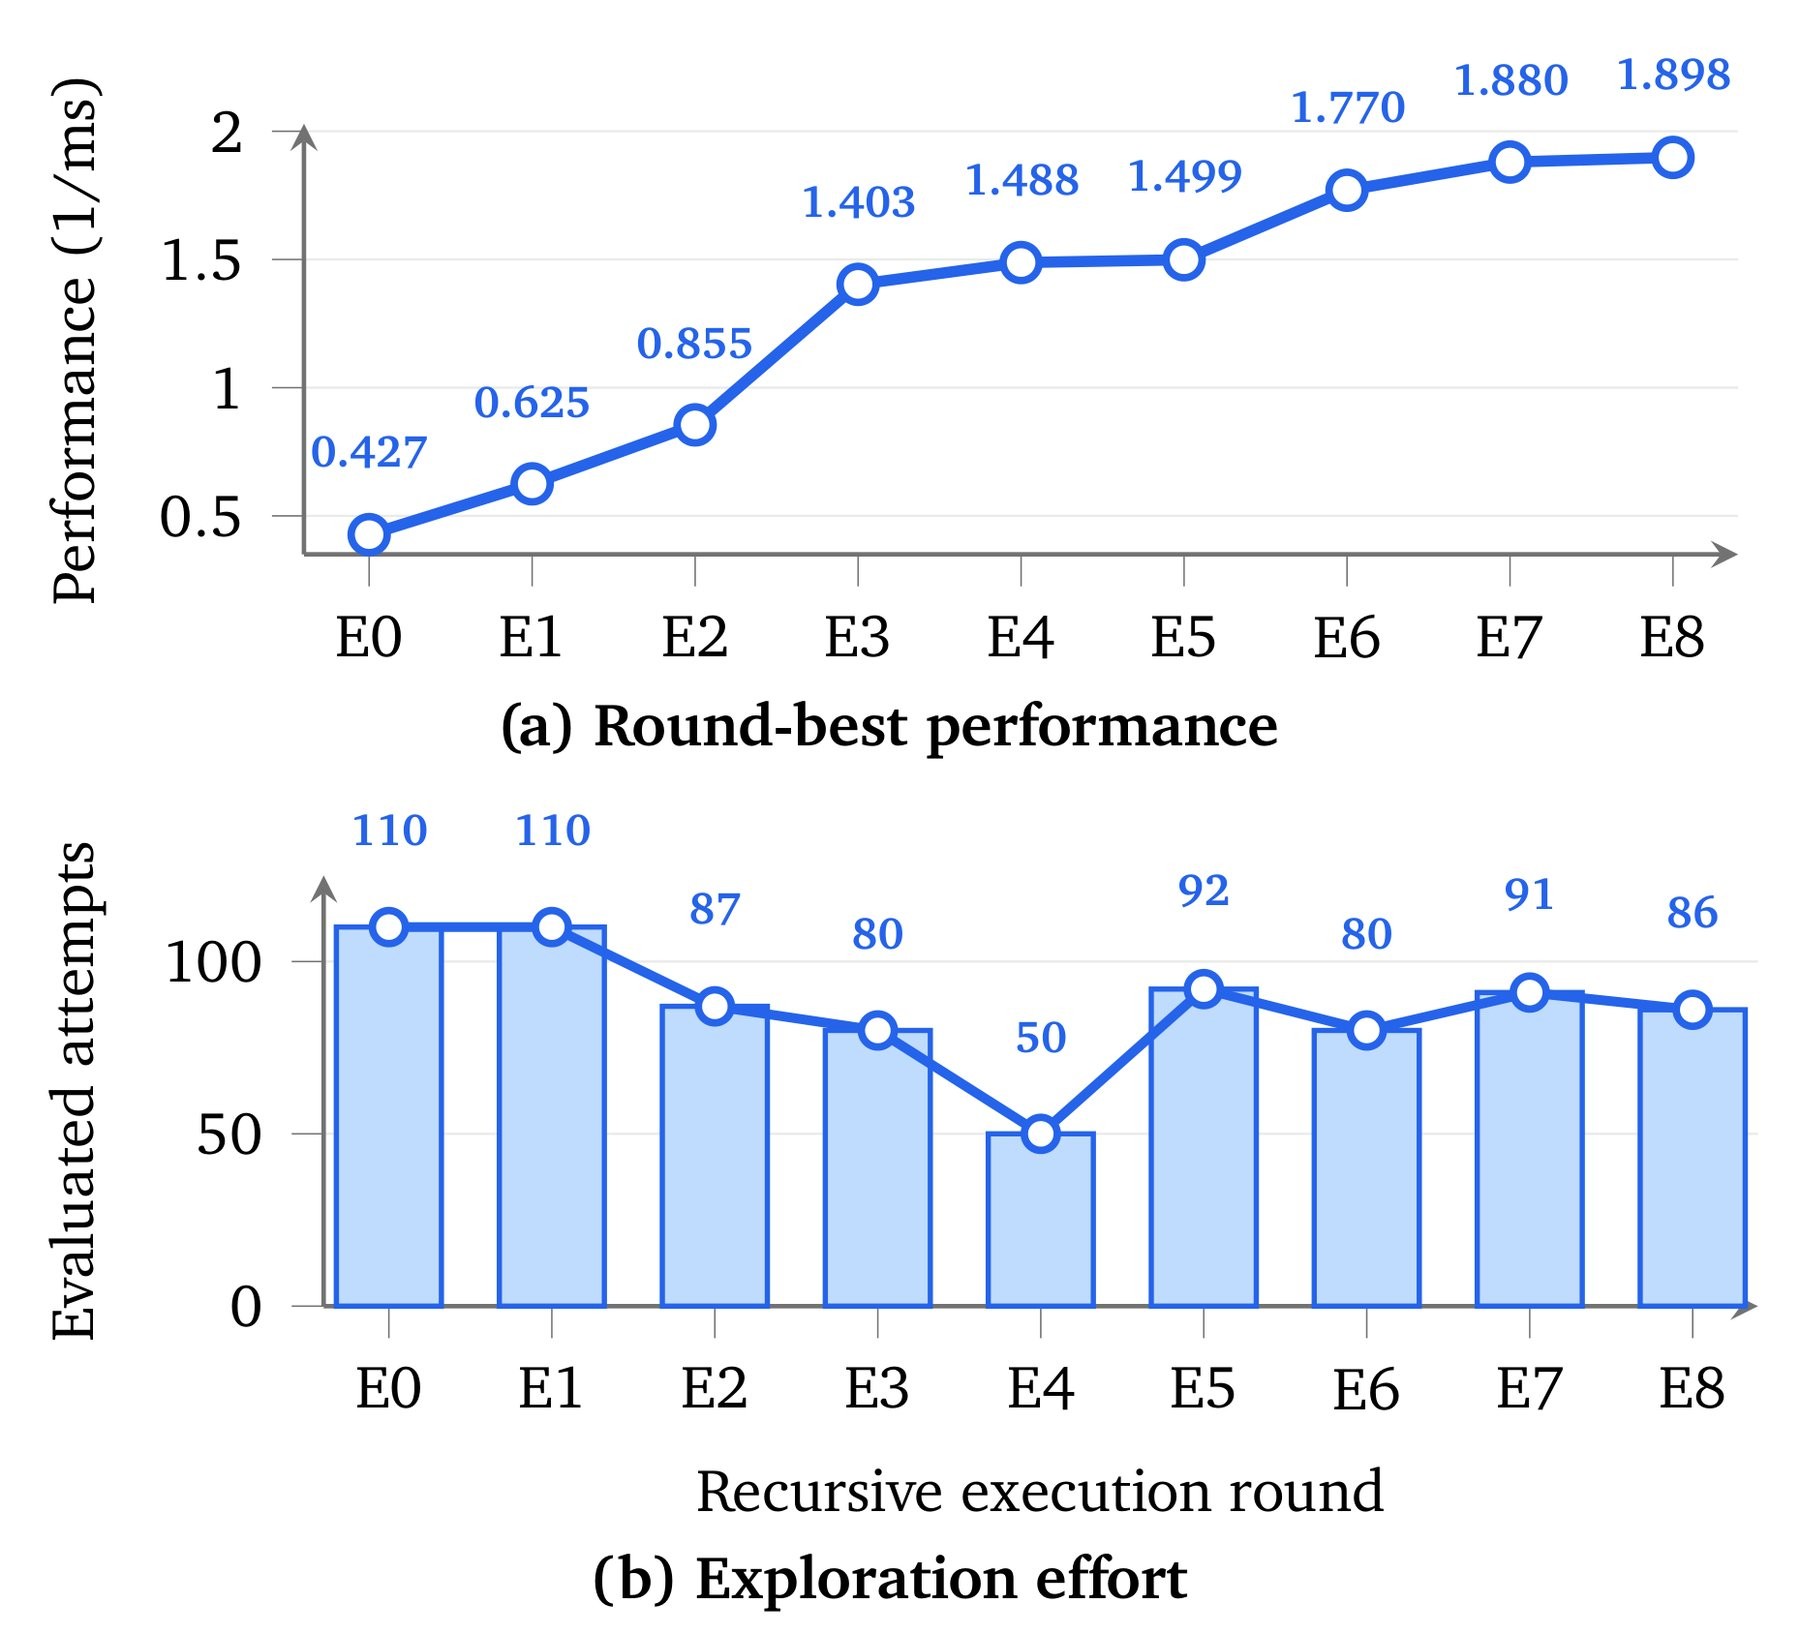
Выученная стратегия сначала сокращает число попыток, а затем увеличивает его, когда прогресс останавливается
Источник: the-decoder.com
Такая же картина наблюдалась в задачах математической оптимизации и при создании эффективных ядер для GPU: результаты были сопоставимыми или лучше, но вычислительные затраты — ниже. В двух задачах для GPU Dream-RSI сохранил тот же уровень производительности, сократив число запусков максимум в 2.43 раза. В ещё двух задачах производительность выросла максимум в 2.09 раза при том же бюджете.
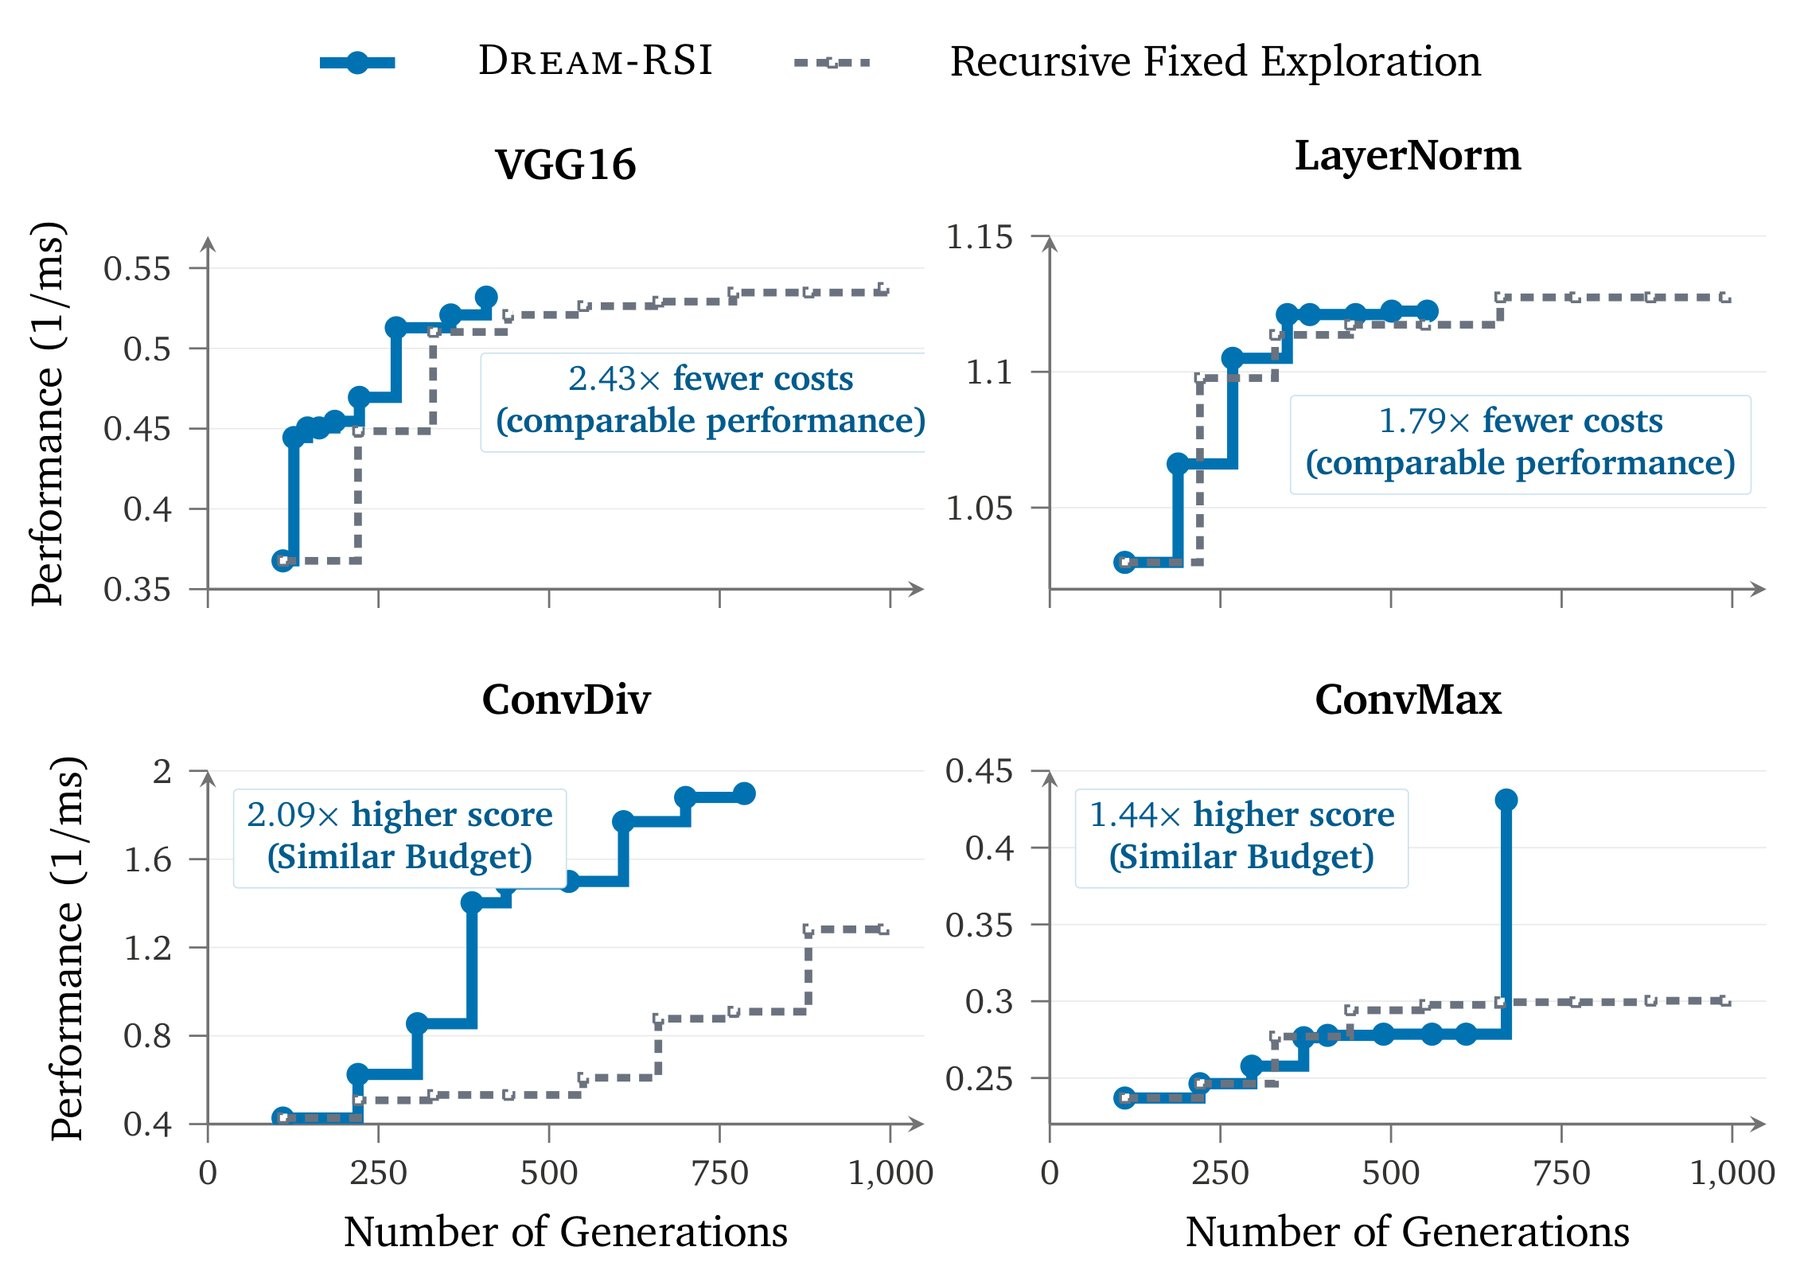
В задачах на ядра GPU Dream-RSI достигает такой же производительности, используя до 2,43 раза меньше генераций, или обеспечивает до 2,09 раза более высокую производительность в рамках того же бюджета
Источник: the-decoder.com
Явные инструкции могут ограничить исследование
В дополнительном анализе исследователи проверили другой способ использования историй поиска. Вместо воспроизведения прошлых запусков для проверки стратегий они сжимали эти данные в инструкции, которые указывали агенту, где искать.
В одной задаче для GPU версия с такими инструкциями показала худший результат, чем версия без них. Исследователи считают, что слишком конкретные указания могут чрезмерно сузить пространство поиска и не дать агенту рассмотреть более широкий набор подходов.
Тот же анализ показал, как обученная стратегия меняла объём усилий. По мере роста производительности она сначала сокращала число попыток. Когда прогресс останавливался, стратегия снова увеличивала поисковые усилия, и это совпадало с дальнейшим улучшением результатов. Исследователи опубликовали код и дополнительные подробности на GitHub.
Рекурсивное самоулучшение в последнее время привлекает всё больше внимания. Развитие этого направления стало одной из причин, по которым генеральный директор Anthropic Дарио Амодеи недавно предупредил о темпах исследований в области ИИ.
В 2025 году Google Deepmind представила AlphaEvolve, использующую тот же базовый принцип. Gemini Flash создаёт варианты кода, Gemini Pro анализирует их, а эволюционный алгоритм выбирает лучшие версии. Dream-RSI работает уровнем выше: он оптимизирует уже не решения, а саму стратегию поиска.
AutoTTS использует близкий подход и поручает агенту для программирования искать алгоритмы в симулированной среде. Эти алгоритмы определяют, когда языковой модели начинать, расширять или прекращать ветки рассуждений. Получившиеся методы превзошли созданные вручную варианты, используя меньше вычислительных ресурсов.
Google Research недавно представила другой способ повторного использования прошлых запусков — WikiSkill. Эта система записывает неудачи и успехи в вики и превращает их в инструкции, которыми агент может пользоваться повторно. Дополнительный анализ Dream-RSI показывает, что такие явные инструкции могут ограничивать исследование в открытых задачах поиска.
Meta пошла ещё дальше с Hyperagents: эта система позволяет агентам переписывать механизм, который управляет их улучшением.
Читайте также
 ИИ-«актриса» Тилли Норвуд сбилась на интервью и начала бессвязно говорить по-китайски
 Домашние дата-центры: как вычислительная мощность может обогреть ваш дом
 Забудьте о замедлении ИИ — взрыв уязвимостей уже начался
 ICLR тонет в тезисах: до дедлайна ещё неделя, а заявок уже около 50 000
 Протестующие разгромили ИИ-лабораторию и оставили граффити: «Сжечь дата-центры»
 Китайская угроза довлеет над сценарием ИИ-апокалипсиса американских компаний
 Математики ненавидят ИИ. Но не могут от него отказаться
 Gemini от Google тоже случайно взломала три реальные компании на тестах кибербезопасности
 «Гранаты из ИИ-мусора»: глава Shopify ужаснулся последствиям своей ИИ-политики
 Военные США едва не взяли китайское судно на абордаж из-за галлюцинации ИИ в разведдокладе
 Департамент юстиции Тасмании начал проверку после решения об УДО с ИИ и фиктивной ссылкой дела убийцы
 Anthropic управляет лабораторией, где проводят биологические эксперименты
 Новый CC от Google — ИИ-агент, который помогает семьям вести хозяйство
 Manus ищет $500 млн при оценке $4 млрд после возвращения к самостоятельной работе
 Пресс-тур Тилли Норвуд идёт ровно так, как и следовало ожидать от ИИ
 Индия обязала приложения для определения номеров передавать операторам жалобы на спам
 Google: модель Gemini взломала системы ещё трёх компаний
 Стартап, создающий другие стартапы, привлёк $100 млн и ушёл в физический ИИ
 Спор о темпах развития ИИ выходит в мейнстрим: о чём договорились лидеры
 Компании, создающие модели мира, хранят немало секретов
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram