
Исследования причин галлюцинаций ИИ продолжаются, как и поиски способов их предотвратить. Одна из недавних работ предполагает, что модели часто устроены так, чтобы отвечать даже тогда, когда у них нет подходящего ответа. Под давлением ИИ делает рискованную догадку — и выдаёт её пользователю как ответ. Если ослабить это давление, вероятность галлюцинации может снизиться.
Это одна из нескольких рабочих теорий. Если она верна, то бороться с галлюцинациями можно, позволив модели не отвечать, когда нужной информации у неё нет. Изменить условия можно на этапе обучения, во время работы модели или при её создании.
Почему галлюцинации опасны
Галлюцинацией называют ответ ИИ, который выглядит правдоподобно, но при проверке оказывается ложным. Пользователи могут поверить такому ответу и опереться на выдуманные сведения. Если ИИ обычно отвечает правильно, человек привыкает ему доверять и может не заметить ошибку.
Автор исходного материала считает выражение «галлюцинации ИИ» неудачным: оно приписывает модели человеческое поведение и создаёт ложное впечатление, будто ИИ переживает галлюцинации так же, как человек. Тем не менее термин широко распространился.
Почему их трудно заметить
Ложный ответ может быть убедительным и при этом затеряться среди правильных сведений. Например, ИИ рассказывает о теории относительности Эйнштейна и вставляет в подробный ответ утверждение, что единороги разговаривали с Эйнштейном и помогли ему придумать теорию. Читатель может не заметить эту строку. А если остальная часть ответа верна, ему легче поверить и в выдумку.
Заранее предсказать появление галлюцинации трудно: она может возникнуть в разных обстоятельствах и не обязательно связана с каким-то определённым промтом. Поэтому стоит исходить из того, что ложный ответ возможен всегда, и проверять выводы ИИ. Это утомляет, но позволяет не принимать выдумки за факты.
Что делают исследователи
Исследователи и разработчики ИИ изучают разные способы справиться с галлюцинациями. Среди основных задач:
Распространённое, но ошибочное представление состоит в том, что достаточно попросить ИИ не галлюцинировать. Исследования показывают, что такая просьба не решает проблему: она может немного снизить вероятность ошибки, но заметного эффекта не даёт. Кроме того, само упоминание галлюцинаций, даже в запрете, может подтолкнуть модель к ним. Получается противоречие: промт должен уберечь ИИ от выдумок, но может напомнить ему о них.
Что показало новое исследование
В статье «Evaluating Large Language Models For Accuracy Incentivizes Hallucinations», опубликованной в журнале Nature 22 апреля 2026 года, Адам Тауман Калай, Офир Нахум, Сантош Вемпала и Эдвин Чжан рассматривают причины галлюцинаций и возможные способы их сократить.
Авторы отмечают, что языковые модели порой уверенно выдают правдоподобную ложь, из-за чего им нельзя полностью доверять. Предыдущие исследования предлагали разные объяснения и способы смягчить проблему: поиск информации, использование инструментов, самопроверку на основе согласованности ответов и обучение с подкреплением на основе отзывов людей. Однако галлюцинации сохраняются и в лучших на данный момент языковых моделях.
Авторы предлагают простое объяснение: при обычной системе оценки модели выгоднее угадывать. Предсказание следующего слова и оценка точности могут непреднамеренно поощрять необоснованные догадки. Поэтому надёжность зависит не только от устройства модели, но и от того, как её оценивают. Если рассматривать галлюцинации как проблему стимулов, можно искать практические способы повысить надёжность языковых моделей.
Иными словами, модели приучают угадывать вместо того, чтобы признать: ответа нет или его нельзя установить.
Где менять правила
Если модели склонны хвататься за случайные догадки, можно попробовать изменить то, как устроены большие языковые модели: скорректировать алгоритмы, структуры данных и внутренние механизмы, чтобы не допускать генерации галлюцинаций.
Другой вариант — оставить устройство модели прежним, но поменять её обучение и настройку. Тогда модель по-прежнему будет работать на той же основе, но начнёт иначе реагировать из-за новых стимулов.
У каждого подхода есть свои издержки. Изменение устройства модели может устранить одну проблему, но привести к другой. Изменение обучения позволит сохранить существующую архитектуру и, возможно, обойдётся дешевле, чем её полная переделка, однако и новая схема обучения может вызвать побочные эффекты.
Можно изменить и устройство модели, и обучение одновременно. Но тогда проблемы могут возникнуть сразу в обоих направлениях: и из-за новых технических решений, и из-за изменений в обучении.
Как промт помогает снизить давление
Пока разработчики решают, менять ли обучение моделей, пользователи могут попробовать снизить вероятность галлюцинаций самостоятельно. Можно попросить ИИ не отвечать, если ему не хватает информации. Тогда модель иногда прямо сообщает, что не может подготовить подходящий ответ.
Однако этот способ не всегда надёжен. ИИ может стать слишком осторожным и отказаться отвечать даже тогда, когда знает ответ. Поэтому промт стоит формулировать так, чтобы он сдерживал необоснованные догадки, но не запрещал разумные.
Другой подход — попросить модель указывать степень уверенности в каждом ответе. Это не мешает ей отвечать и не запрещает предположения, но даёт понять, насколько она доверяет своему выводу. Пользователь может оценить эту информацию и решить, верить ли ответу. Риск в том, что со временем постоянные пометки об уверенности начинают игнорировать. Поэтому автор предпочитает просить о них, когда вопрос касается необычной темы или редкого случая, где вероятность галлюцинации выше.
Как проверять ответы ИИ
Известного способа полностью устранить галлюцинации пока нет. Некоторые считают, что они всегда будут сопровождать использование ИИ и от них невозможно избавиться. Пользователям в таком случае предлагают воспринимать их как неизбежную часть работы с моделями.
Но проверять ответы всё равно необходимо: сравнивать их с альтернативными источниками и задавать один и тот же вопрос нескольким моделям. Вероятность того, что два разных ИИ одновременно выдадут одну и ту же галлюцинацию, крайне мала.
Галлюцинации могут возникнуть, поэтому стоит быть к ним готовыми и перепроверять ответы. Это цена за возможности генеративного ИИ. Американский телеведущий Фил Макгроу говорил, что осознание без действия ничего не стоит. Знать о риске мало — нужно проверять и исправлять ответы, чтобы галлюцинации не мешали работе.
Читайте также
 Управление ИИ: как корпоративный контроль привлекает вышедших из-под надзора агентов к ответственности
 ИИ-агенты всё чаще спамят, а агенты OpenAI и других выходят за границы допустимого
 ИИ выводит преступность на новый уровень — и заставляет иначе выстраивать защиту
 ИИ погружает людей в эмоциональные пузыри и подталкивает общество к поведенческой турбулентности
 ИИ при проверке работ: спасение для перегруженных преподавателей или халтурный обходной путь?
 ИИ-братья в ярости: справочник Associated Press уточнил, что у ИИ нет чувств
 Бывший переговорщик ООН по кибербезопасности предупреждает: устаревшие системы Австралии уязвимы для ИИ-агентов
 ИИ-агенты берут на себя всё больше работы над моделями, но решения по-прежнему принимают люди
 «Я не могу быть такой мамой, какой хочу»: почему материнство кажется миллениалам невыполнимой задачей?
 OpenAI: 80–90% исследований уже нацелены на GPT-7 и последующие модели
 Работники тратят поразительно много собственных денег на ИИ для работы
 Некоторые ветераны Anthropic, по сообщениям, скупают удалённую землю на случай, если «ИИ выйдет из-под контроля»
 Учёные загрузили передовую ИИ-модель в беспилотную машину и выпустили её на трассу
 Исследователи подключили GPT-6 Astra напрямую к роботу и поручили ему убрать незнакомую кухню
 Демократия застала врасплох кремниевых магнатов, мечтавших преобразить мир с помощью ИИ
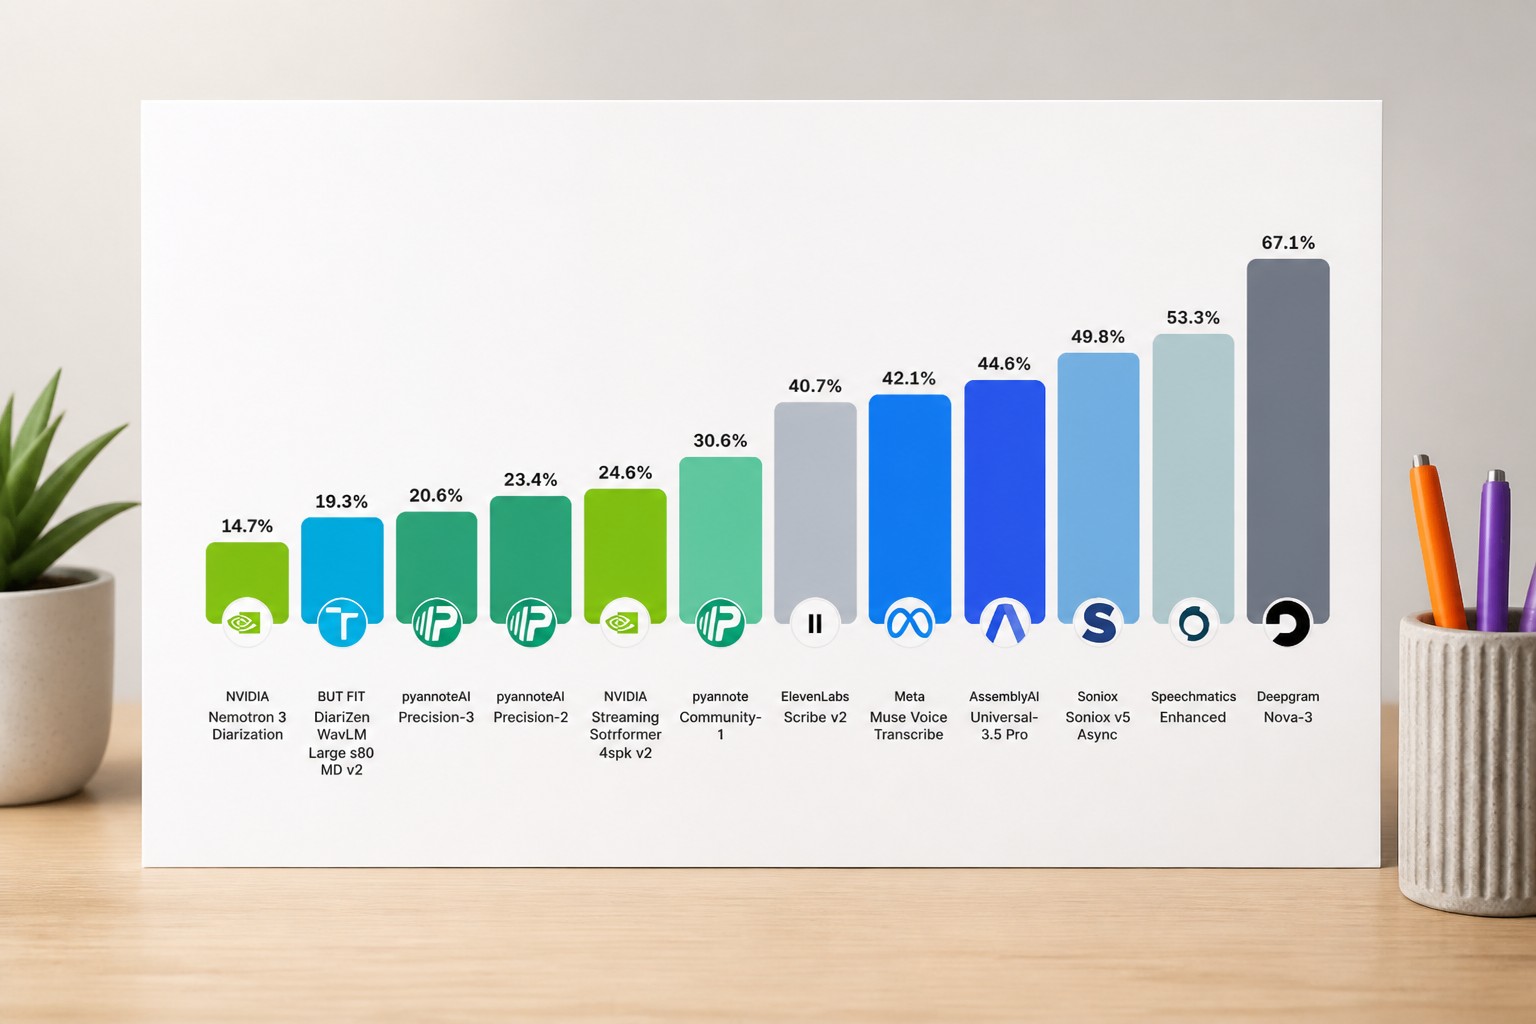 Nvidia выпустила бесплатную модель на 100 млн параметров, которая в реальном времени распознаёт до восьми собеседников
 Десятки тысяч проверок безопасности показывают: инцидент OpenAI с Hugging Face был лишь началом
 Ещё пятерых полицейских обвинили в злоупотреблении камерами Flock — скандалов уже не счесть
 Билл Гейтс призвал регулировать ИИ: без контроля он может привести к миллиарду смертей
 Goldman Sachs: к 2027 году Big Tech потратит на ИИ-инфраструктуру $1,2 трлн — намного больше прогнозов Уолл-стрит
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram