
В 2017 году Google представила федеративное обучение — метод, при котором модели обучаются на данных, распределённых между устройствами. Он используется, например, для предсказания следующего слова и функции Smart Compose в Gboard, подсказок ответов в Google Messages и функции Smart Text Selection в Android.
Разработка систем федеративного обучения в Google опирается на четыре принципа приватности: минимизацию данных, их анонимизацию, прозрачность и контроль, а также проверяемость и возможность аудита. Исследования анонимизации позволили обеспечить строгие гарантии дифференциальной приватности для производственных моделей — с помощью алгоритма матричной факторизации DP-FTRL (MF-DP-FTRL) и распределённой дифференциальной приватности в сочетании с безопасным агрегированием.
В 2025 году Google представила обновлённое определение федеративного обучения, в котором центральное место занимают эти четыре принципа. Это подход к машинному обучению, при котором несколько участников — клиентов — совместно решают задачу под управлением поставщика сервиса. Полноценная система должна позволять клиентам сохранять полный контроль над своими данными, перечнем задач, которым разрешён доступ к данным, и способами анонимизации результатов. Она также должна обеспечивать нужный уровень прозрачности и контроля для пользователей, чьи данные обрабатывают клиенты.
В работе «Toward provably private learning from federated data» исследователи описали новое поколение системы. Она использует доверенные среды исполнения (TEE), чтобы гарантировать проверяемую анонимизацию данных и возможность её аудита. Сторонние проверяющие могут удалённо удостовериться, какой код выполняется внутри TEE. Такая среда также обеспечивает конфиденциальность — её внутреннее состояние нельзя просмотреть — и целостность: работу кода нельзя нарушить. Эти гарантии действуют с учётом ограничений современных TEE.
Новая система сочетает свойства TEE на отдельных машинах в сквозную проверяемую систему федеративного обучения. По словам Google Research, это повышает гарантии приватности и точность моделей. Gboard уже перешла на новую систему и обучает модели существенно быстрее, чем прежде.
Как устроена система
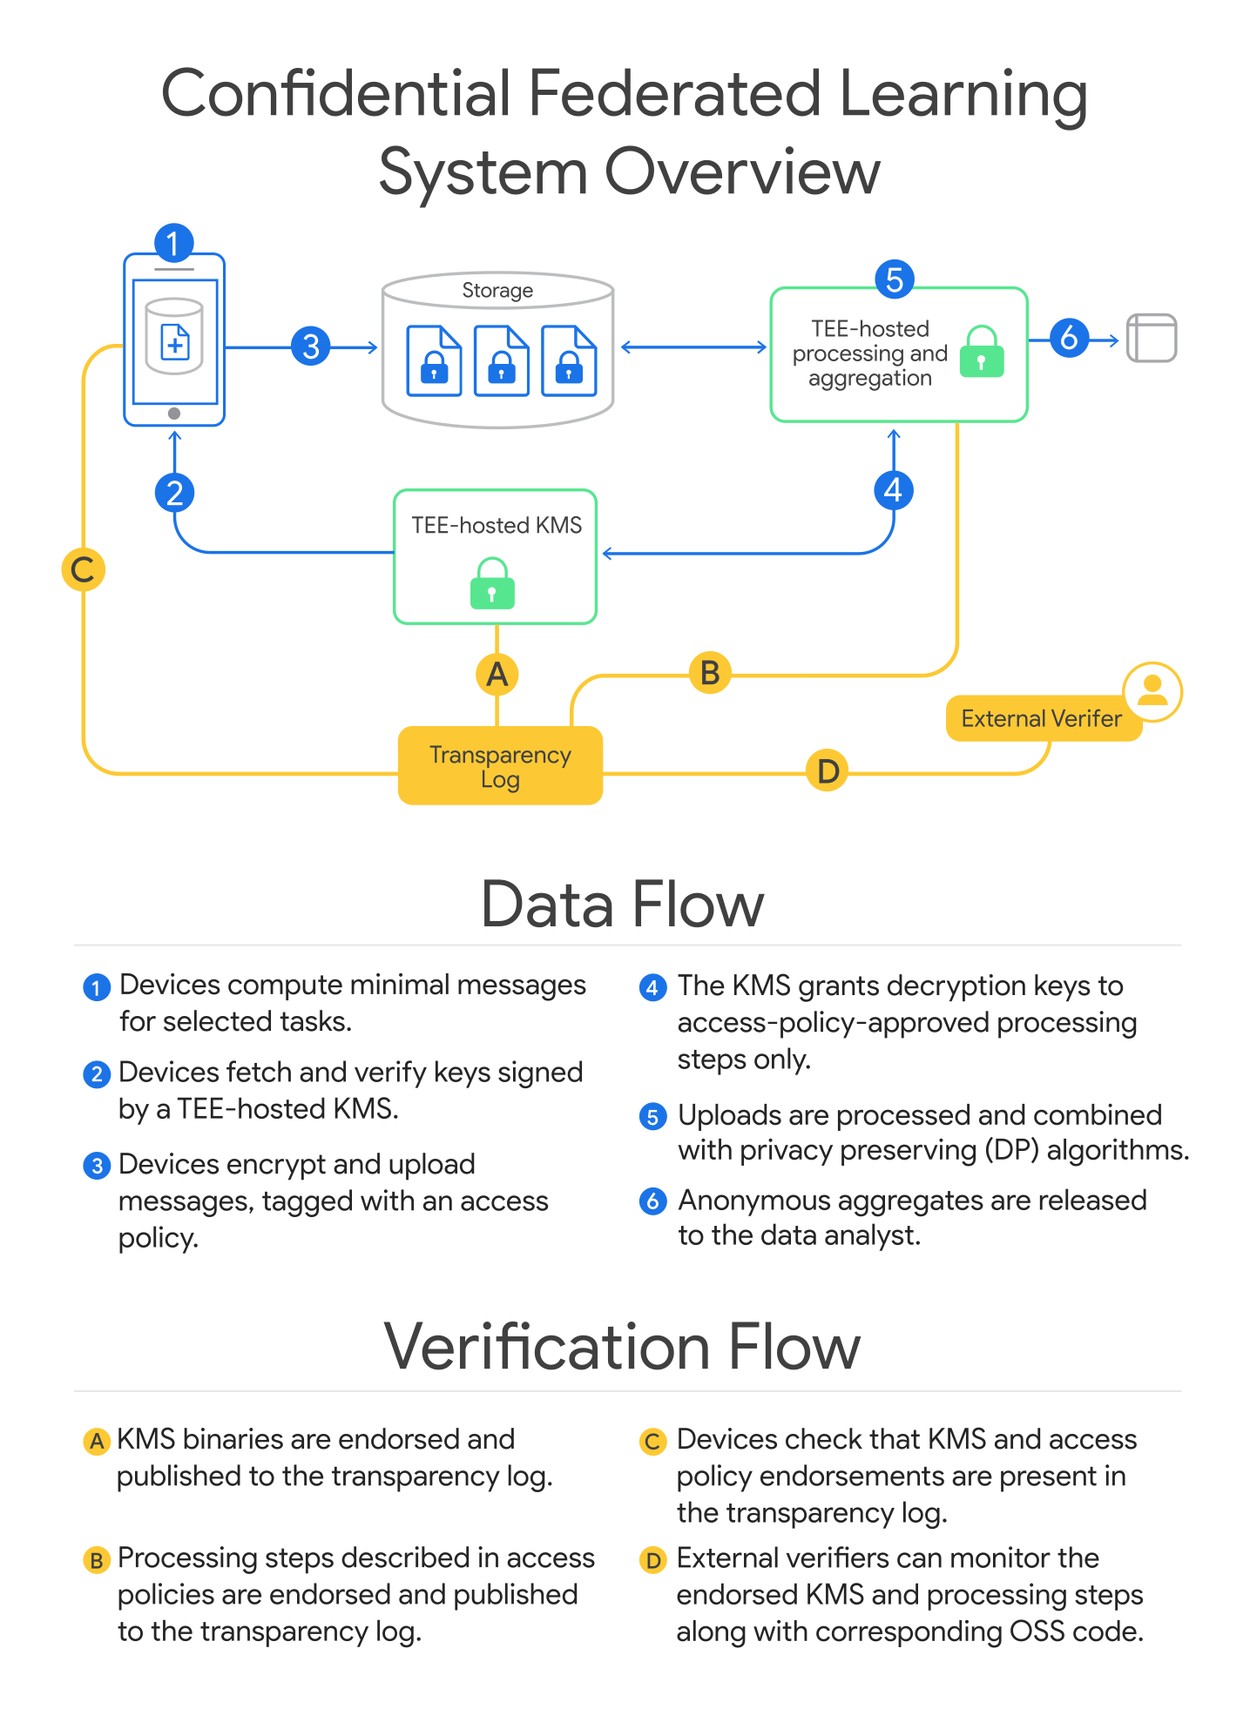
Система опирается на методы из предыдущих работ Google над конфиденциальной федеративной аналитикой и проверяемыми приватными выводами. В ней есть четыре основных компонента:
Источник: research.google
На схеме показаны потоки данных в системе и этапы проверки гарантий приватности для выполняемых в ней задач.
Подробное описание системы опубликовано в техническом документе «Toward provably private learning from federated data».
Как TEE усиливает приватность
В ранних системах федеративного обучения данные с устройств загружались для немедленного агрегирования, но внешние наблюдатели не могли проверить, что их не записывали и не просматривали. Позже безопасное агрегирование позволило защищать загрузки криптографическими средствами, однако этот метод не сочетался с передовыми гарантиями централизованной дифференциальной приватности. Новая система на базе TEE стала следующим этапом в работе Google над тем, чтобы серверному оператору не требовалось доверять обработку данных.
В новой системе операторы задач видят только метрики и веса моделей, защищённые дифференциальной приватностью. Зашифрованные обучающие данные с устройств можно расшифровать и обработать только внутри TEE, запущенных с программами на Python, указанными в политиках доступа. Доступ к данным ограничен по времени после загрузки.
Открытый журнал прозрачности и воспроизводимые сборки
Устройства, участвующие в новой системе, знают полный перечень серверных задач, которые могут получить доступ к загружаемым данным. Политики доступа, описывающие возможные будущие задачи, публикуются в Rekor — открытом журнале прозрачности. Внешние аудиторы могут следить по этим записям за всем набором серверных задач, к которым потенциально подключаются устройства.
Двоичные файлы KMS и компонентов обработки данных можно собрать заново из открытого исходного кода, опубликованного в репозитории Confidential Federated Compute на GitHub.
Проверяемое выполнение и динамическая загрузка данных
В прежних системах федеративного обучения ни устройства, ни аудиторы не могли проверить логику, выполнявшуюся на сервере. Поэтому пользователям приходилось доверять Google в том, что компания правильно добавляет случайный шум к суммам градиентов для обеспечения дифференциальной приватности.
В новой системе политики доступа, опубликованные в Rekor, непосредственно описывают программу на Python, задающую логику обучения. Чтобы сохранить в тайне архитектуры моделей и логику предварительной обработки данных, не лишая систему возможности аудита, TEE для обработки данных могут динамически загружать в программу сериализованные данные.
Пока вся логика, влияющая на приватность, жёстко задана в программе на Python, эта функция позволяет выполнять внутри TEE и закрытую логику, сохраняя сильные проверяемые гарантии приватности. Отдельно авторы обсуждают риски наблюдения за побочными каналами.
Как Gboard использует систему
Gboard применила новую систему федеративного обучения на базе TEE, чтобы запустить модели предсказания следующего слова на английском и японском языках. По словам Google Research, обновление повысило точность и усилило гарантии приватности. Авторы связывают эти улучшения с несколькими особенностями системы.
Как учитывается доступность устройств
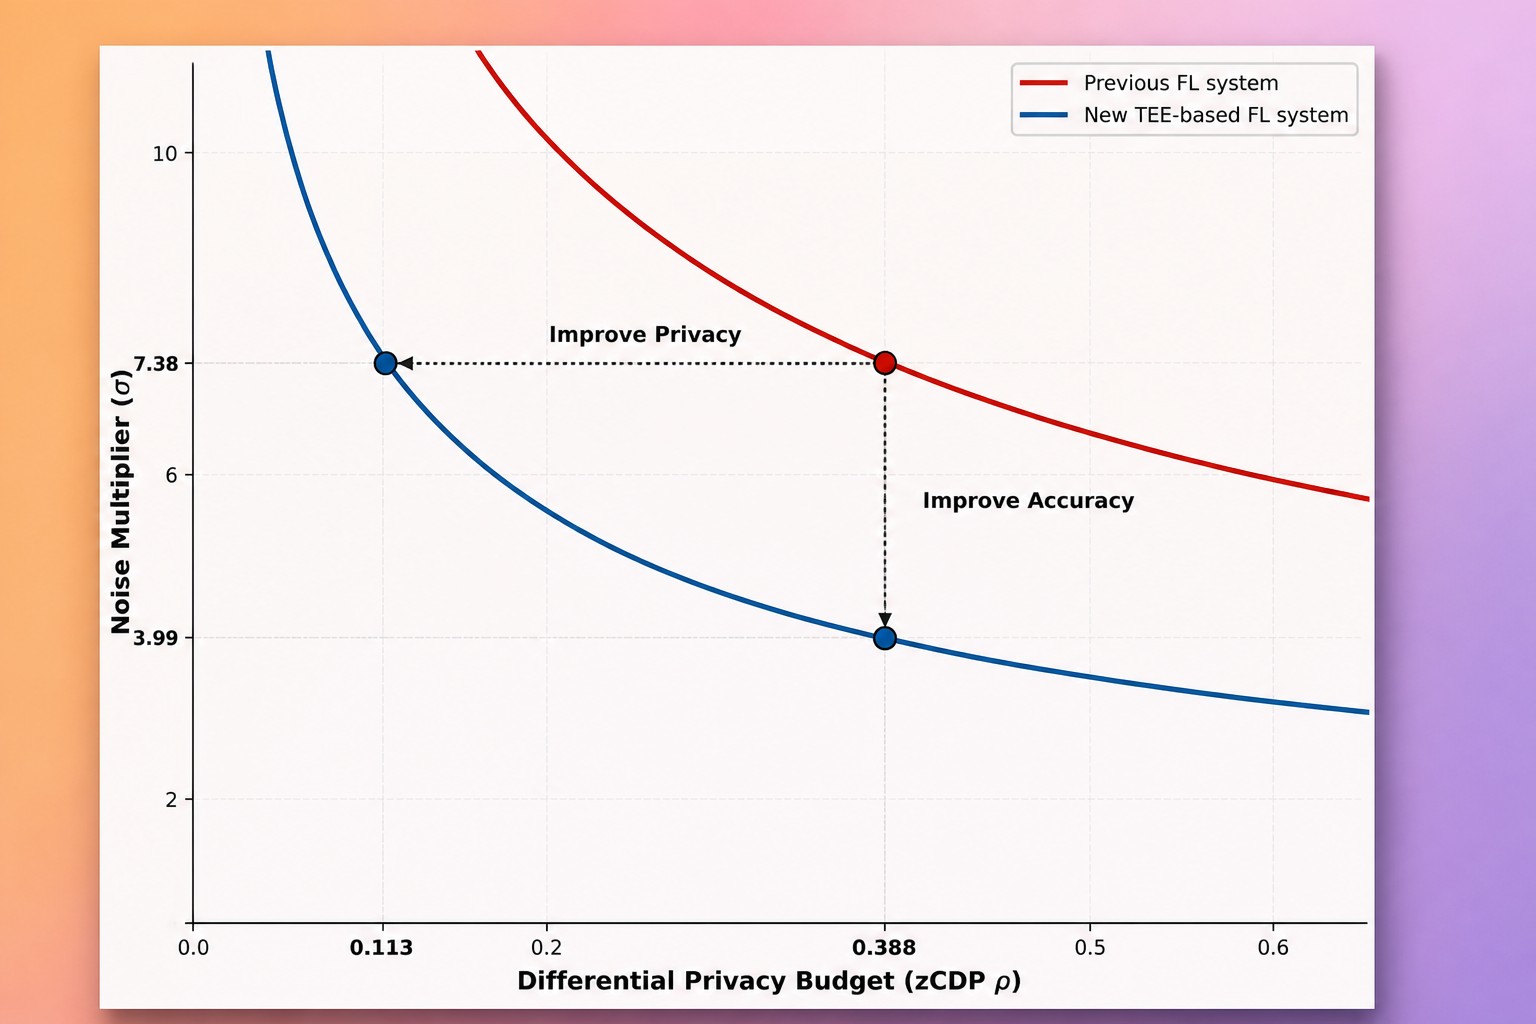
Теперь Google сначала собирает данные со всех устройств, а затем запускает обучение на сервере. Поэтому изменение доступности устройств в течение суток больше не влияет на ход обучения. Во время серверных вычислений программа может динамически подобрать оптимальное расписание участия устройств и использовать его для настройки других параметров дифференциальной приватности.
Оптимизация расписаний позволяет получить более строгие гарантии приватности и уменьшить множители шума. Кривые на графике построены по результатам обучения модели предсказания следующего слова на английском языке: 5000 раундов, в каждой группе — 6500 устройств.
Ускорение обучения
Раньше обучение таких моделей федеративного обучения занимало от одного до двух месяцев. Его ограничивали доступность устройств, вычислительные возможности самих устройств и конкуренция нескольких задач за одни и те же ресурсы.
В новой системе узкие места перенесены на сервер. Вычисления можно распараллелить на многих машинах, что заметно ускоряет обучение. Сейчас его скорость ограничивает только доступность ресурсов TEE.
Что дальше
Перенос вычисления градиентов с устройств на сервер снимает ограничения, связанные с вычислительными ресурсами устройств в прежних системах. Это открывает возможность обучать с помощью федеративного обучения всё более крупные модели. Для таких сценариев будет важно объединить TEE с ускорителями.
Описанная система подходит не только для проверяемого обучения моделей, но и для произвольных задач, которые можно выразить на Python. Google экспериментирует с другими типами вычислений на этой инфраструктуре, например с генерацией синтетических данных. Ещё одно направление — сочетание TEE, которые выполняют произвольный код на Python, с другими TEE для обработки данных, специализирующимися на задачах вроде инференса больших языковых моделей.
Эта работа приближает систему к строгому доказательству того, что серверная обработка сохраняет приватность каждого пользователя. Внешние проверяющие могут изучить код, который запускает Google, а компания — подтвердить, что данные на сервере обрабатываются именно так, как описано. Авторы ожидают, что новые поколения оборудования TEE и исследования способов защиты от наблюдения за побочными каналами усилят защиту динамически загружаемых задач от атак со стороны сервера. В перспективе такие системы могут получить полные доказательства корректности программных реализаций алгоритмов дифференциальной приватности и компонентов системы.
Авторы поблагодарили за вклад в проектирование и создание инфраструктуры Аруна Ганеша, Брендана Макмахона, Бретта Макларнона, Чуньсяна (Джейка) Чжэна, Эмили Гланц, Майю Спивак, Майкла Ринира, Нову Фаллен, Стефана Дирауфа, Сусинь Го, Тимона ван Овервелдта, Ю Сяо, Захари Чарльза и Захари Гарретта.
За помощь с интеграцией в Gboard они поблагодарили Хайчэна Суня, Хэн Су, Цзяньпэна Хоу, Лияна Цзяна, Норюки Такахаси, Вэньчжи Мао, Сяоцзюань Фан, Яньсяна Чжана, Инцзе Лю, Юаньбо Чжана и Юнь Вана. Работу поддержали Коринна Кортес, Шуминь Чжай и Йосси Матиас. Авторы также поблагодарили Майсама Муссалема за замечания к тексту.
Читайте также
 ИИ грозит разрушить многое в нашей культуре. Но больше всего мы можем потерять способность слушать
 Трамп запустил чат-бот «сверхразума» на America.org, но тот сразу стал спорить с ним — в том числе о победителе выборов 2020 года
 Исследование: ИИ-чатботы, которые техкомпании активно продвигают миллиардам пользователей, могут серьёзно вредить психике
 ИИ обходит лицензированных бухгалтеров по скорости и точности, но без контроля всё ещё не может закрыть книги
 Медики устали разгребать бардак, который устроила Palantir
 Уязвимость в приложении ChatGPT для Mac могла открыть хакерам доступ к личным данным
 Microsoft AI выпустила новые модели для распознавания и синтеза речи в голосовых ИИ-агентах
 Не обманывайтесь: большие языковые модели не рассуждают
 Индекс Ramp AI Index: компании используют ИИ активнее, но платят за него меньше
 Black Forest Labs выпустила Flux 3 Image: модель редактирует изображения поэтапно, не затрагивая остальную картинку
 Не стоит паниковать из-за ИИ — нужно привлекать его создателей к ответственности, когда что-то идёт не так
 Shopify представила Canvas — интернет-магазины можно создавать в диалоге с ИИ
 Что бы ни подразумевали под безопасностью ИИ, это точно не она
 Стартап Legato выпустил очки с ИИ для помощи людям с нарушениями слуха
 У ИИ-индустрии серьёзная проблема: большинство людей не мечтают доверить ИИ-агенту всю свою жизнь
 В Сингапуре мужчине грозит до трёх лет тюрьмы за ИИ-фейк, вызвавший массовую панику
 Google: для запуска космических дата-центров Starship должна совершить 1 800 полётов
 Теперь ChatGPT может виртуально примерить на вас одежду
 Ideogram: новая модель редактирует часть изображения, не портя остальное
 The Wall Street Journal: OpenAI рассталась с тремя исследователями по безопасности
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram