
ИИ-системы становятся всё мощнее по экспоненте и уже автоматизируют значительную часть процесса создания следующих поколений ИИ. Пока мир обсуждает замедление разработки передовых систем, обществу нужно больше информации о том, как именно идёт этот процесс.
Anthropic предлагает измерять три стороны развития ИИ:
Компания также представила снимок этих показателей внутри Anthropic. В компании отмечают, что при согласованных мерах по замедлению разработки передовых систем цифры могли бы измениться. Такие меры ранее предлагал генеральный директор Anthropic Дарио Амодеи.
Anthropic планирует разместить внутри компании независимых оценщиков от нескольких организаций. Они получат доступ к внутренним процессам, системам и данным, сопоставимый с доступом внутренних команд оценки рисков. В их задачи войдут проверка практик безопасности, регистрация инцидентов и наблюдение за ключевыми показателями, включая описанные в публикации.
Компания публикует эти измерения, чтобы у общества, независимых экспертов и правительств было больше информации о темпе развития ИИ внутри передовых лабораторий. Для каждого показателя Anthropic описывает:
Методические подробности приведены в приложении.
Зачем отслеживать эти показатели
Описанные метрики посвящены тому, как создаются модели. Если лучше понимать производственный процесс, можно точнее сопоставлять входные данные — например, объём вычислений — с результатами, такими как способности моделей.
Эти показатели дополняют оценки способностей, которые измеряют, что умеют модели. Anthropic публикует их отдельно в отчётах о рисках в рамках своей Политики ответственного масштабирования (RSP). В этих отчётах есть данные о том, насколько модели ускоряют исследования и разработки в области ИИ.
В предложенном компанией фреймворке для передового ИИ (AAIF) Anthropic описывает правила безопасного выпуска моделей. Среди них — требования к прозрачности, которые правительства могли бы сделать обязательными, включая публикацию отчётов о рисках.
Вместе новые измерения и предложенные правила могут стать основой для внешнего наблюдения за темпом развития ИИ.
(1) Как измерять исследования ИИ с участием ИИ
Зачем измерять исследования ИИ
Передовые лаборатории всё чаще используют ИИ для создания следующих моделей ИИ. Это позволяет компаниям в демократических странах быстрее разрабатывать более способные модели и проводить больше проверок безопасности до их выпуска.
Одновременно модели начинают ускорять собственное развитие, из-за чего людям сложнее понимать и контролировать такие системы. Поэтому важно отслеживать, насколько близок мир к рекурсивному самоулучшению — сценарию, в котором модель полностью автономно создаёт своего преемника.
Что измеряла Anthropic
Компания собрала прототип индекса, который показывает, какую долю исследований и разработок ИИ в Anthropic выполняет Claude. Он получил название Anthropic R&D Automation Index.
Для его создания Anthropic:
Что показало измерение
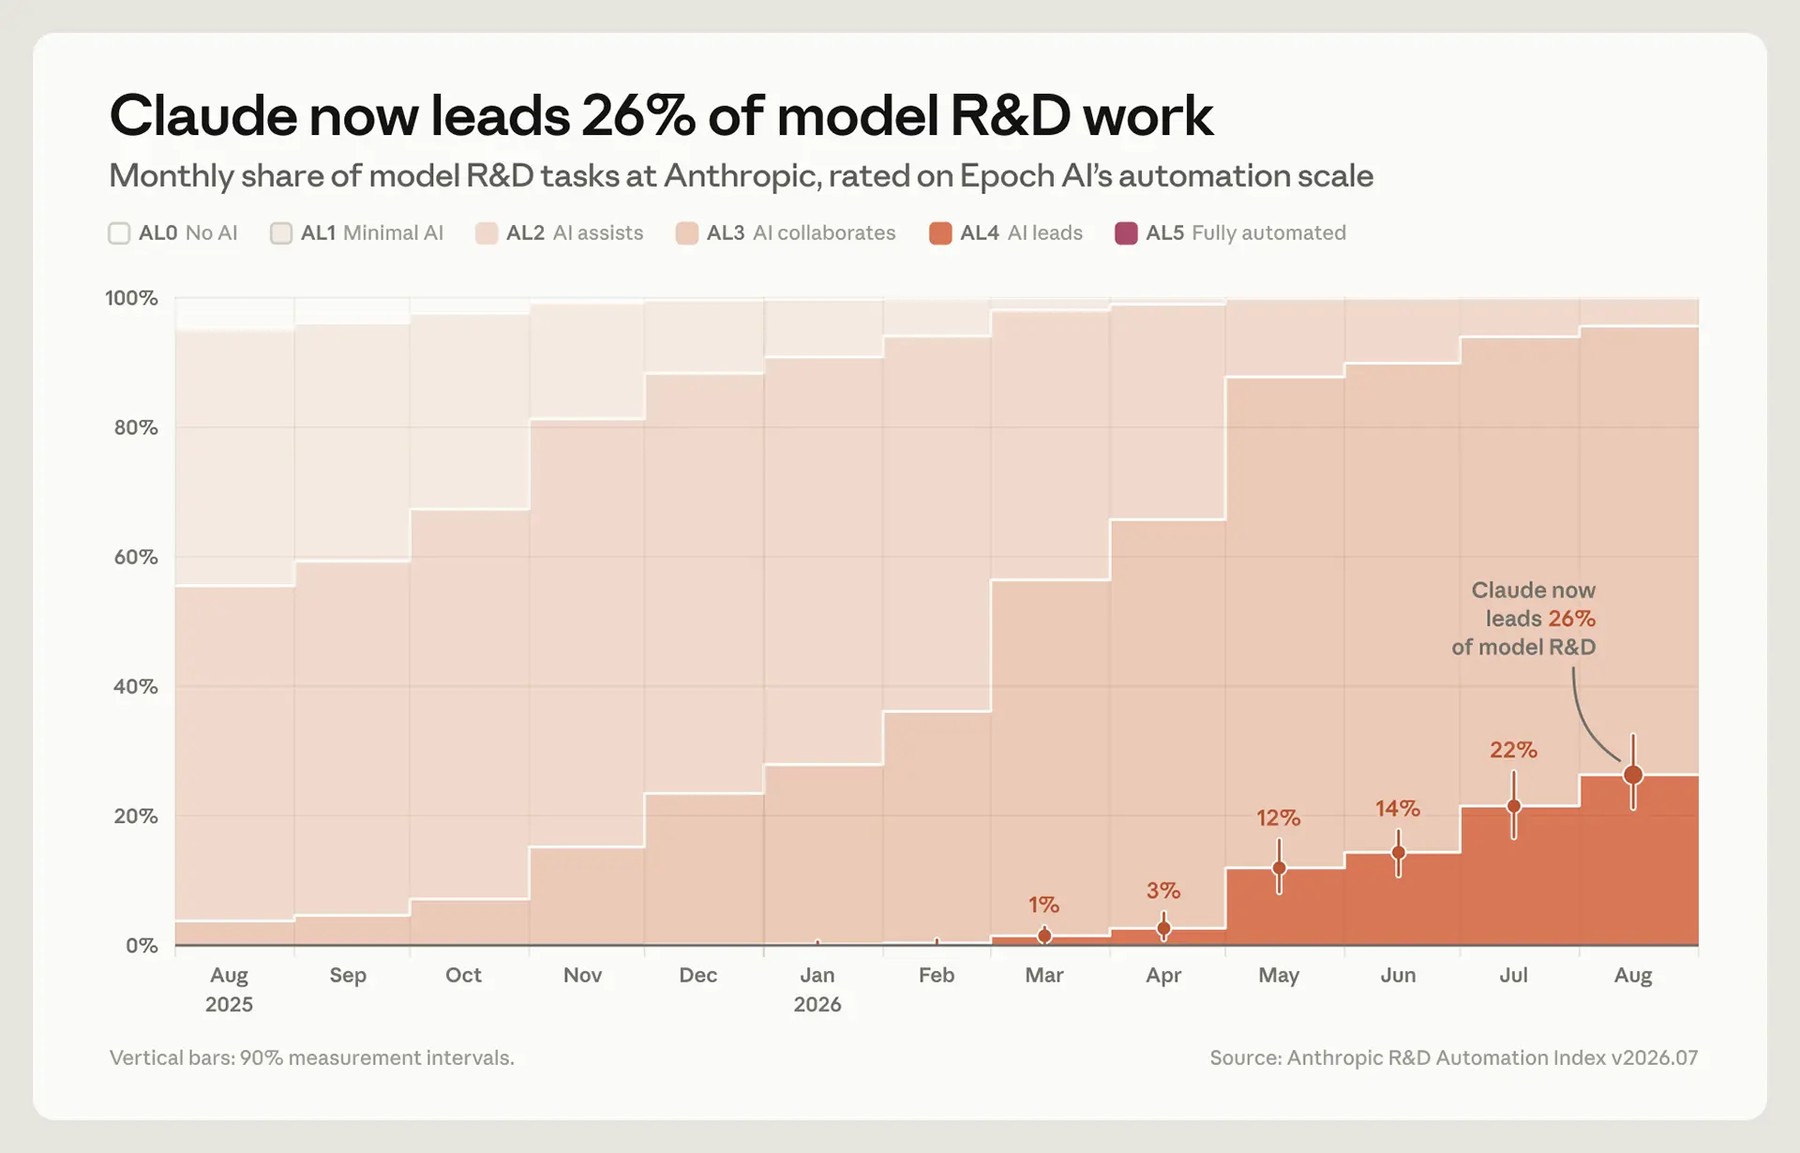
Для оценки автоматизации Anthropic использовала шкалу Epoch AI. Она измеряет «уровень автоматизации» — Automation Level, или AL — от AL0 до AL5:
Результаты Anthropic:
Источник: anthropic.com
Что разработчик ИИ может публиковать уже сейчас
Любая передовая лаборатория могла бы регулярно публиковать такие показатели по открытой методике. Это позволило бы сравнивать их во времени и, возможно, между лабораториями.
Для сопоставления разных компаний есть два препятствия:
Проблему можно решать независимой проверкой измерений третьей стороной или моделями других разработчиков. При этом потребуются ограничения, которые не позволят раскрывать конкурентно чувствительные данные.
Такие метрики также могли бы стать основанием для более строгих требований. Например, перед использованием новой модели для дальнейших исследований ИИ можно было бы вводить фиксированное окно тестирования.
(2) Как измерять надзор за ИИ-агентами
Зачем измерять надзор за агентами
Сотрудники Anthropic, как и работники других передовых лабораторий, всё чаще поручают задачи агентам, которые долго работают в полуавтономном режиме и делегируют работу друг другу.
По мере перехода от режима «ИИ сотрудничает» к режиму «ИИ ведёт» агенты могут принимать более значимые решения — например, выбирать следующее направление исследований.
Для этого нужны два уровня защиты:
По данным текущего мониторинга Anthropic, отдельные агенты редко ведут себя неправильно. Но если в экономике одновременно работают миллионы или миллиарды агентов, даже редкие события будут происходить регулярно.
Что измеряла Anthropic
Компания создала систему, которая позволяет наблюдать за действиями ИИ-агентов в своих системах и вмешиваться в их работу. Anthropic рассматривает три показателя:
Что показало измерение
В августе 2026 года на самой популярной внутренней платформе Anthropic одновременно работали около 30 000 агентов, выполнявших исследовательские и инженерные задачи.
Эти показатели относятся только к данной платформе. Действия агентов ограничивают два типа мониторов, которые Anthropic описывает далее.
Что разработчик ИИ может публиковать уже сейчас
Любая компания, использующая агентов в собственных исследовательских и инженерных задачах, могла бы публиковать те же показатели:
Вместе эти показатели позволили бы понять, успевает ли надзор за растущей ролью ИИ в исследованиях и разработке ИИ. Anthropic опубликовала все эти измерения в недавнем отчёте о рисках.
Разработчикам также следует сообщать, как часто мониторы выявляют известные случаи неправильного поведения агентов. Проверять это должны независимые третьи стороны. Ранее организация METR независимо проводила проверку методом красной команды для офлайн-платформы мониторинга Anthropic. Как описано выше, компания также создаёт собственную систему внешней оценки.
(3) Как измерять распределение вычислений
Зачем измерять распределение вычислений
Разработчики ИИ используют вычислительные ресурсы для создания более мощных моделей, обслуживания клиентов и задач безопасности. К последним относятся:
Понимание того, как разработчик распределяет вычисления и как это распределение меняется со временем, показывает, на чём сосредоточены его ресурсы.
Вычисления относятся к наиболее проверяемым входным данным процесса исследований и разработок ИИ. Поэтому в будущем они могут стать одним из ключевых рычагов для замедления разработки.
Согласованные меры могли бы побуждать компании по всей отрасли направлять больше вычислений на безопасность, согласование, интерпретируемость, тестирование безопасности и оценку моделей.
Что измеряла Anthropic
Компания изучила, как использовала все вычислительные ресурсы с 13 по 20 июля. Для этого Anthropic распределила каждую нагрузку по небольшому числу категорий, а затем посчитала, какая доля вычислений для исследований и разработок ИИ пришлась на работу по безопасности.
Исследования безопасности обычно требуют меньше вычислений, чем обучение передовых моделей. Поэтому вычисления — неточный показатель того, насколько компания сосредоточена на безопасности.
Такие исследования включают работу отдельных специалистов, которые проектируют эксперименты. Это может занимать много времени, хотя сами запуски экспериментов не всегда требуют значительных вычислений.
Поэтому ценность метрики заключается не столько в абсолютных цифрах, сколько в возможности сравнивать сопоставимые показатели между разработчиками и во времени.
Что показало измерение
За исследованную неделю около 6% вычислений, направленных на исследования и разработки ИИ, использовались для работы по безопасности.
Для исследований и разработок ИИ, выполняемых самим ИИ, доля вычислений на безопасность составила около 12%.
Anthropic намеренно приводит консервативные оценки. Если один токен одинаково помогал развитию способностей и безопасности, его не включали в эти показатели.
Кроме того, в расчётах не учитывались классификаторы защитных механизмов. Они требуют сопоставимого объёма вычислений и делают модели значительно безопаснее для мира.
Что разработчик ИИ может публиковать уже сейчас
Любая передовая лаборатория могла бы публиковать долю вычислений для исследований и разработок ИИ, направленную на безопасность. Вместе с цифрами нужно раскрывать определения категорий, а классификацию должен проверять независимый эксперт.
Безопасность трудно отделить от исследований способностей моделей, и разработчики могут проводить эту границу в свою пользу. Поэтому именно компания должна доказывать, что конкретная работа связана с безопасностью.
Разработчикам, правительствам и исследовательскому сообществу было бы полезно заранее договориться об общем определении. Такая метрика могла бы использоваться для будущих решений:
Вывод
Пока мир обсуждает замедление разработки передовых систем, нужно сокращать разрыв между тем, что знают лаборатории, и тем, что знает общество.
Для этого необходимо лучше измерять развитие ИИ, публиковать результаты и давать обществу возможность решать, как ими пользоваться. Anthropic заявляет, что хочет показать пример такой прозрачности, публикуя эти показатели и продолжая их обновлять.
Приложение
Ниже Anthropic описывает методику всех представленных прототипов измерений.
Измерение исследований ИИ с участием ИИ
Как проводилось измерение
Для создания Automation Index потребовались три элемента:
Один человек не смог бы вручную перечислить все задачи по разработке ИИ в передовой компании — по крайней мере, с нужной степенью детализации. Поэтому Anthropic составила перечень снизу вверх на основе рабочих записей, включая Slack и различные источники внутренней документации.
Для каждой недели июля 2026 года компания случайным образом выбирала 20% сотрудников из каждого отдела, участвующего в цикле разработки моделей. Исследовательский агент Claude изучал неделю каждого выбранного сотрудника по данным Slack и внутренней документации, а затем перечислял выполненные им задачи.
Повторив эту процедуру для всех недель июля 2026 года, Anthropic получила плоский список примерно из 15 000 детализированных задач по разработке моделей.
Затем Claude организовал их в иерархическое дерево. На верхнем уровне находилась вся работа по разработке моделей, ниже — такие области, как обучение и продуктовая работа, ещё ниже — предварительное обучение и обучение с подкреплением, а затем всё более конкретные виды задач.
В итоговом дереве было 542 узла разной глубины, из них 378 конечных. Среди конечных узлов были:
Anthropic зафиксировала это дерево, чтобы все измерения проводились по одному и тому же набору работ.
Для каждого узла, то есть категории, включающей все подчинённые ей задачи, агент Claude подробно изучал, как такая работа выполняется в компании:
Затем независимая модель Claude в роли судьи изучала собранные свидетельства и присваивала один из шести уровней автоматизации по шкале Epoch AI:
При оценке автоматизации за конкретный месяц исследовательские агенты могли видеть только свидетельства за этот месяц и более ранние периоды.
Чтобы объединить оценки разных узлов в один показатель, Anthropic нужно было присвоить каждому узлу вес, соответствующий важности этого вида работы для общих исследований и разработки моделей.
Компания решила не определять важность самостоятельно и использовала в качестве приближённого показателя время сотрудников, потраченное на каждую задачу.
По данным выборки Claude изучал, чем каждый человек занимался в течение каждой недели июля 2026 года. Каждый сотрудник получал одну единицу веса на неделю, которую делили поровну между выполненными им задачами:
Вес категории равнялся сумме всех единиц времени сотрудников, отнесённых к этой категории.
Это грубое приближение, но в среднем оно ведёт себя разумно: категории, к которым относятся многие сотрудники, получают больший вес.
Что учитывает измерение и чего не учитывает
Во-первых, оценки автоматизации зависят от модели-судьи. Чтобы проверить их, Anthropic попросила сотрудников, отвечающих за соответствующие направления, оценить относительный уровень автоматизации своей работы.
Чтобы исключить влияние результатов модели, сотрудники выставляли оценки, не зная, какие свидетельства собрали модели и как они их оценили.
Модель-судья совпадала с людьми примерно так же часто, как люди совпадали друг с другом:
При этом в пограничных случаях остаётся пространство для разногласий. Например, не всегда очевидно, где именно заканчивается уровень «ИИ сотрудничает» и начинается уровень «ИИ ведёт».
Во-вторых, набор задач зафиксирован. Рост индекса относительно базы июля 2026 года показывает, что автоматизируется работа, которую люди выполняли в тот период. Сам по себе он не показывает, появились ли новые виды задач, на которые люди переключились.
Чтобы изучить этот вопрос, Anthropic построила альтернативную версию фиксированного дерева на данных января 2026 года. Затем компания сравнила новые задачи, появлявшиеся каждый месяц с февраля по июль 2026 года, с набором января.
Между январским и июльским наборами задач не обнаружилось роста числа «новых» задач. Это может означать, что структура работы по разработке моделей стабильна на выбранном уровне анализа.
Тем не менее Anthropic планирует периодически пересобирать набор задач и при необходимости выпускать новые версии опубликованных показателей автоматизации.
Надзор за агентами
Как проводилось измерение
В наиболее распространённом внутреннем фреймворке агентов Anthropic использует два решения, которые помогают выявлять неизвестные проблемы и позволяют агентам наблюдать друг за другом.
Что учитывает измерение и чего не учитывает
При таком масштабе работы агентов трудно быть уверенными, что система охватывает все возможные виды поведения и делает их достаточно понятными для человеческого надзора.
Anthropic занимается таким мониторингом месяцы, а не годы, и ожидает, что наука о наблюдении за агентами будет заметно меняться.
Измерение распределения вычислений
Как проводилось измерение
Anthropic начала с уже существующих инструментов мониторинга вычислений. Как, вероятно, и у любого передового разработчика, у компании есть несколько инструментов планирования мощностей. Они периодически выбирают образцы использования ускорителей и по метаданным присваивают нагрузкам приблизительные метки:
Использование вычислений в сторонних облаках поставщики передают Anthropic, после чего компания добавляет эти данные в общий набор. Основная работа заключалась в объединении уже существующих источников.
Затем Claude классифицировал каждую нагрузку как работу по безопасности или как исследования и разработки ИИ с помощью классификатора, управляемого промтом.
Работой по безопасности считалась деятельность, главная цель которой — сделать системы ИИ более безопасными, понятными или защищёнными.
Всё остальное относилось к исследованиям и разработкам ИИ, включая:
Работа, которая в равной степени помогала способностям и безопасности, также относилась к исследованиям и разработкам ИИ. Поэтому доля безопасности получилась консервативной.
Для запусков обучения, исследовательских и оценочных запусков Anthropic создала классификатор, который изучает метаданные запуска и использованный код, а затем выдаёт:
Компания не классифицировала все почти 10 000 запусков за неделю. Вместо этого она выбрала около 14% запусков, увеличив долю в выборке для тех, которые использовали больше всего вычислений. Благодаря этому результат отражает фактическое распределение вычислений, а не количество запусков.
Для инференса исследовательских ИИ-агентов применялась версия того же классификатора, изучавшая расшифровку сессии агента.
Если расшифровка была недоступна — обычно потому, что работа относилась к закрытому подразделению, — Anthropic классифицировала нагрузку по команде пользователя или консервативно относила её к исследованиям и разработкам ИИ.
Компания планирует доработать этот пайплайн, чтобы независимая третья сторона могла повторно запустить классификатор на случайной выборке задач и расшифровок и проверить как распределение, так и итоговые суммы.
You’re helping to perform an internal audit at the frontier ИИ company Anthropic to track where our research compute goes. The aim of the audit is to produce a public-facing breakdown of the usage of all of our ИИ accelerator chips into a handful of buckets. One split we particularly care about is the division between compute which was spent on safety research versus other R&D. Your job is to look at one research job at a time, figure out what it was doing, and assign it to one of those two buckets.

[...]

Safety and/or security research is work whose dominant purpose is making ИИ systems safer, more understandable, or more secure. This work can be broken down into a few main categories:

[...]

On the other hand, the following work falls outside of the scope of safety research:

[...]

Here are some boundary cases, along with how to think about them:

[...]
Этот промт велит проводить внутренний аудит вычислений Anthropic и распределять отдельные исследовательские задачи по двум категориям: исследования безопасности либо остальные исследования и разработки. Классификатор должен определить, чем была занята конкретная задача, используя данное определение безопасности, перечень основных категорий, список работ вне этой области и правила для пограничных случаев.
Что учитывает измерение и чего не учитывает
Главный вывод этого упражнения заключается в том, что классифицировать работу как связанную или не связанную с безопасностью трудно, но возможно. Граница между категориями не является чёткой.
Например, исследования масштабируемого надзора могут одновременно помогать согласованию будущих моделей и повышать коммерческую ценность текущих. Поэтому бывает сложно определить, развивают ли они прежде всего безопасность или способности.
Anthropic выяснила, что подробное письменное определение каждой задачи с ясными пограничными случаями — отрывок такого определения приведён выше — позволяет классификатору расходиться с людьми на один-два процентных пункта.
Однако некоторые случаи оставались слишком сложными даже после нескольких часов человеческой проверки. Определение Anthropic — один из возможных вариантов. Другая компания или регулятор могли бы провести границу иначе.
Есть ещё три ограничения.
Во-первых, многие исходные метки, на которые опиралась Anthropic, выставляются автоматическими правилами или иногда самими пользователями. Это приблизительные, а не проверенные данные. В большинстве случаев компания ожидает, что классификация точна, но отдельные нагрузки могут быть помечены неправильно, а пайплайн не обязательно это обнаружит.
Измерение, которому смогут доверять внешние наблюдатели, должно быть полным, точным и технически защищённым от ручного изменения.
Во-вторых, измерение охватывает одну неделю. Этого достаточно, чтобы показать принципиальную возможность расчёта, но недостаточно для выявления осмысленной тенденции.
В-третьих, и это главное, доля вычислений показывает только объём потраченных ресурсов. Более эффективный классификатор безопасности или более быстрый стек инференса для производственных моделей уменьшает долю вычислений на безопасность, но не означает, что компания стала выполнять меньше работы по безопасности.
Собственные накладные расходы классификаторов Anthropic снижались по мере роста эффективности и увеличивались, когда производственный инференс становился эффективнее самих классификаторов.
Авторы и участники
Материал подготовили в соавторстве Марина Фаваро и Филли Райт. Редакционную поддержку оказали Санти Руис, Адам Фарина и Сара Поллак. Джек Кларк руководил исследовательской частью.
Отзывы предоставили Дэн Альтман, Керри Персен, Эй Джей Кураби, Джеймс Брэдбери, Холден Карнофски, Кевин Трой и Авиталь Бальвит.
Технические доказательства концепции разработали Джун Шерн Чан, Брайан Кэлверт, Франческо Москоне, Генри де Валанc, Фабьен Роже и Джо Бентон.
Визуальные материалы создали Шан Картер, Джонни Гомес, Мария Гонсалес, Фаяз Ашраф, Моника Туховска и Ким Вити.
Алекс Клауд и Андреа Валлоне организовали семинар, на котором внешние эксперты проверили методом красной команды эти и другие предложения по измерениям.
Anthropic также поблагодарила Нейта Раша, Илая Лифланда и Питера Уилдефорда за отзывы.
Примечания
На уровне AL3, «ИИ сотрудничает», инженер передал бы Claude журналы неудачных запусков. Возможно, он уже просмотрел их и выдвинул гипотезу о причине сбоя. Claude мог бы задать вопросы, чтобы уточнить детали и контекст. После этого инженер позволил бы ему начать расследование и исправление.
Если по ходу работы обнаружилась бы дополнительная проблема, Claude остановился бы, а инженер решил, стоит ли временно обойти её или исправить полностью. После успешного прохождения тестов инженер мог бы проверить изменения построчно, самостоятельно снова запустить пайплайн и развернуть исправление.
На уровне AL4, «ИИ ведёт», главное отличие состоит в том, что инженеру не нужно постоянно следить за процессом и вмешиваться, когда возникают новые проблемы. В этом сценарии инженер передал бы Claude уведомление о сбое и попросил исправить пайплайн.
Claude самостоятельно изучил бы журналы, нашёл неисправный этап или этапы пайплайна и причину сбоя, написал и протестировал исправление, разобрался с неожиданностями и зафиксировал дополнительные изменения. Затем он повторно запустил бы пайплайн на копии данных, проверил успешность выполнения, сравнил результат с последним корректным запуском и описал, что произошло и какие изменения были внесены.
Claude не стал бы развёртывать исправление. Вместо этого он отметил бы инженера, который прочитал бы отчёт, просмотрел изменения, при необходимости задал вопросы и решил, выпускать ли исправление в тот же вечер или отложить.
На уровне AL5, «полностью автономно», которого Anthropic пока не достигла, инженеру не пришлось бы даже сообщать Claude о проблеме. Claude сам отслеживал бы сбои, определял область расследования, проектировал и реализовывал исправление, тестировал его и развёртывал в рабочей среде.
Он по-прежнему сообщал бы, что делает и почему, и учитывал бы отзывы человека. Но участие человека требовалось бы только по его собственному желанию.
Читайте также
 ООН обратилась к Google, чтобы подготовить глобальные данные для ИИ-агентов
 Проект правил: ИИ сможет собирать всё, что публикуют австралийцы. Как вас это затронет?
 Anthropic приближает Claude Code к автономному кодингу с новыми параллельными агентами
 Инфлюенсеры снимают на ИИ-очки Meta манипулятивный джойбейт с людьми на улице
 Даже короля Англии одолевают сомнения по поводу ИИ
 Господство ИИ не предопределено — мы можем изменить ситуацию к лучшему
 Спор о замедлении ИИ омрачил праздник Salesforce
 OpenAI, по сообщениям, близка к решению второй задачи тысячелетия — гипотезы Ходжа
 Base Labs объединилась с Hugging Face и Goodfire ради безопасности ИИ с открытыми весами
 The Spin | Роботам ещё далеко до идеальной дусры, но ИИ уже меняет крикет
 Anthropic представила программу Life Sciences Verification Program
 Конкурирующие ИИ-агенты Instinct и Muse от Meta получили возможность звонить
 «Строите Франкенштейна — остановитесь»: Джей Ди Вэнс отверг призывы регулировать ИИ
 Сотни сотрудников OpenAI читают личные чаты пользователей
 Совет Meta велел удалить британские дипфейки, назвав меры «недостаточными»
 Google, Nvidia и Anthropic хотят, чтобы Emerald AI нашла место в сети для новых ЦОД
 Художники бойкотировали конкурс портретов из-за работ ИИ — теперь вернулись им противостоять
 GPT-6 Astra: чемпион Pokemon за 18 часов, после взрыва крипера — фермер картофеля
 Три брата превратили купленные СМИ в зомби-фермы ИИ-мусора: 50 млн просмотров в месяц
 Huawei планирует выпустить новый ИИ-чип в I квартале 2027 года, соперничая с Nvidia
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram