
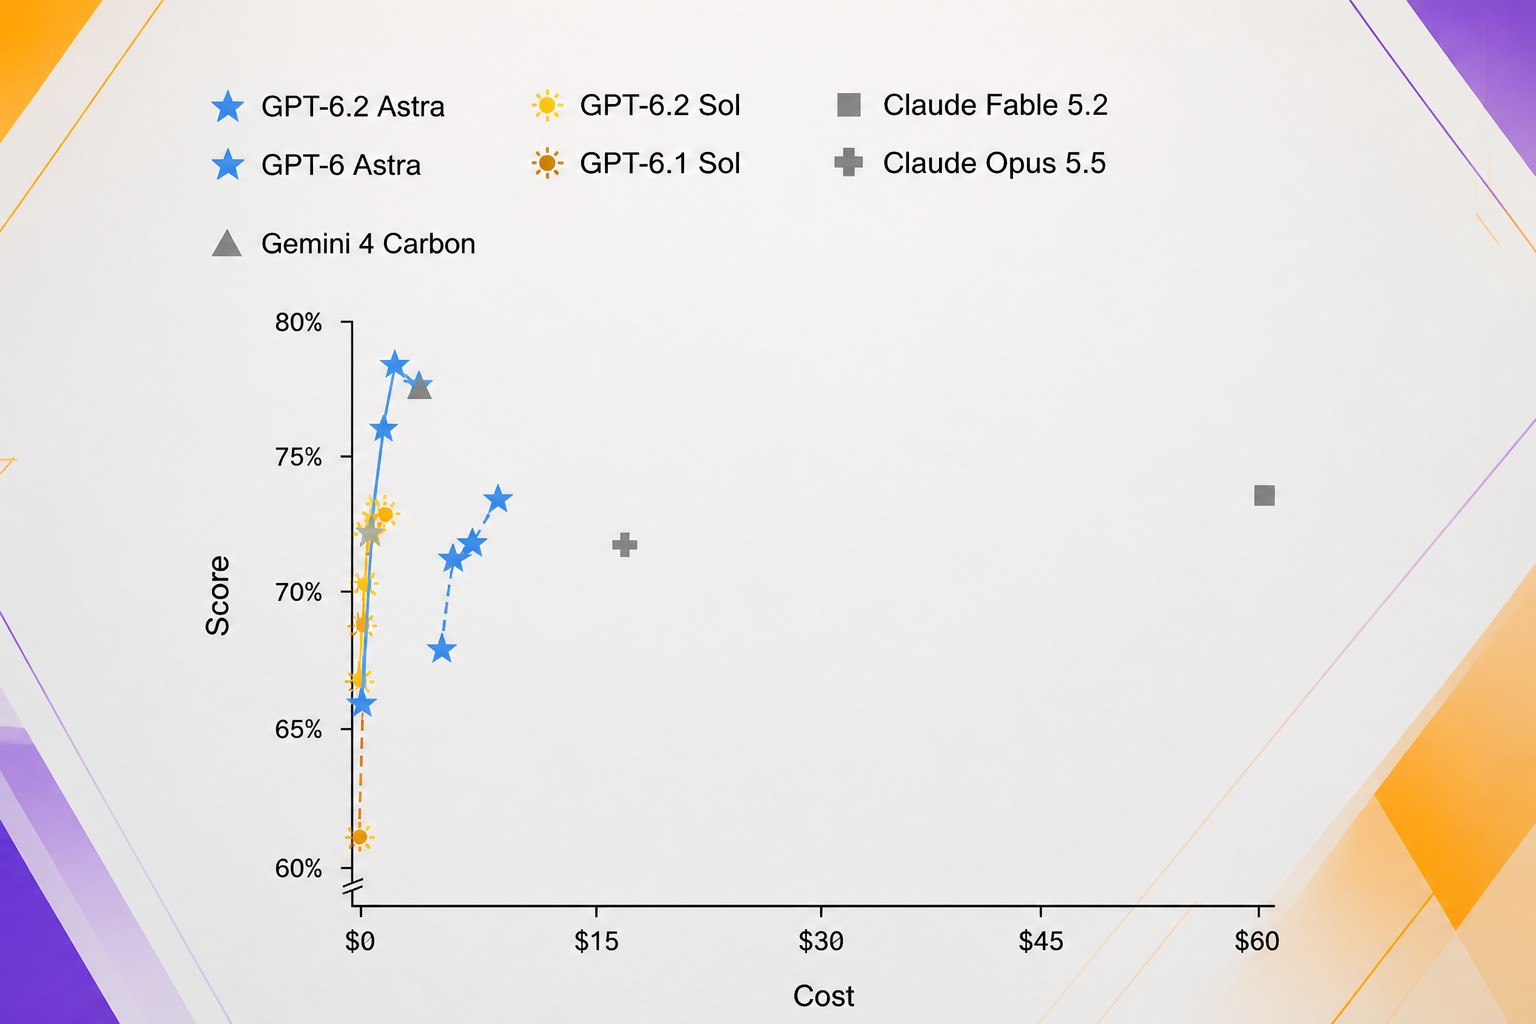
Доступ и цены
Пользователи Pro-500 могут включить для обеих моделей сверхбыстрый режим Ultrafast. Подписчики Pro-200 впервые тоже получили к нему доступ — пока только с GPT-6.2 Sol.
Цена GPT-6.2 Astra через API составляет $8 за миллион входных токенов, $0,40 за миллион входных токенов из кэша и $40 за миллион выходных токенов. Для GPT-6.2 Sol сохранили цены GPT-6.1 Sol: $2 за миллион входных токенов, $0,10 за миллион входных токенов из кэша и $10 за миллион выходных токенов.
Astra для профессиональных задач
OpenAI обучала Astra надёжнее работать с профессиональными требованиями в юриспруденции, финансах и бухгалтерии. Компания также заявляет, что модель лучше оформляет презентации: использует макеты, цвета и шрифты шаблона, точно соблюдает размеры шрифта, формулирует заголовки с учётом главной мысли слайда, а основной текст посвящает ключевым деталям.
В бенчмарке Agents’ Last Exam, который проверяет многоэтапные рабочие процессы, Astra набрала на 5,2 балла больше, чем GPT-6 Astra, потратив при этом менее трети её стоимости. По данным OpenAI, результат Astra также на 5,5 балла выше, чем у Claude Fable 5.2, при стоимости в 5% от затрат на эту модель. С Astra в этом испытании соперничает только Gemini 4 Carbon от Google.
В юридическом бенчмарке Harvey LAB-AA проверяют, например, анализ пунктов договоров. OpenAI сообщает, что Astra более чем вдвое повысила долю успешных ответов Claude Fable 5.2, затратив примерно в шесть раз меньше. На внутреннем бенчмарке GDPval-v2, куда входят задачи по консалтингу, финансам и дизайну, Astra прибавила 6,2 процентного пункта относительно предшественницы и использовала на 22% меньше выходных токенов.
OpenAI говорит, что улучшились и возможности работы с компьютером, уже сильная сторона предыдущей модели. В ходе испытаний Astra создала трёхмерную модель автомобиля, написала на Python физический симулятор и анимировала результат в Blender. В другой демке модель собрала радиоуправляемую машину из отдельных частей и подготовила анимированную инструкцию по сборке.
В бенчмарке AA-3D судьи сравнивают две интерактивные трёхмерные работы, не зная, какие модели их создали. Astra заняла первое место с рейтингом 1318 Эло. У Claude Fable 5.2 было 1271, у GPT-6.2 Sol — 1259.
На Terminal-Bench-Science, который проверяет научные рабочие процессы в командной строке, Astra превзошла GPT-6 Astra на 9 процентных пунктов, потратив менее трети её стоимости. OpenAI также утверждает, что модель установила новый рекорд в Vals Science Index — рейтинге, оценивающем интерпретацию биологических данных и проведение экспериментов.
Sol для повседневной работы
GPT-6.2 Sol рассчитана на быстрые и разнообразные повседневные задачи. В бенчмарке FrontierCode 2.0, где проверяют, соответствуют ли изменения кода требованиям реальных проектов, Sol уступила Astra всего 0,5 балла, но стоит в пять раз дешевле. По словам OpenAI, модель хорошо справляется и с задачами вне работы.
Обе новинки, как заявляет компания, лучше справляются с кибербезопасностью: эффективнее находят и используют уязвимости, пишут более защищённый код и исправляют ошибки. В нескольких испытаниях модели также заметно экономнее расходовали токены. При этом GPT-6.2 Astra и Sol, как и GPT-6 Astra до них, достигли уровня «Критический» в системе оценки готовности OpenAI.
В ответ компания ввела более строгие ограничения для потенциально опасных запросов о кибербезопасности. Они должны затруднить злоупотребления, но, по признанию OpenAI, будут мешать и законному поиску уязвимостей и проверке защиты.
OpenAI планирует предоставлять новые модели через OpenAI Daybreak. Этот проект уже открывает проверенным исследователям в области безопасности доступ к другим моделям с менее строгими ограничениями. Опубликованные результаты кибериспытаний получены во внутренних тестах, где защитные меры и классификаторы были отключены. Методика описана в сопроводительном отчёте по безопасности.
В отчёте ExploitBench сравнивается доля успешных попыток для моделей при разном объёме вывода.
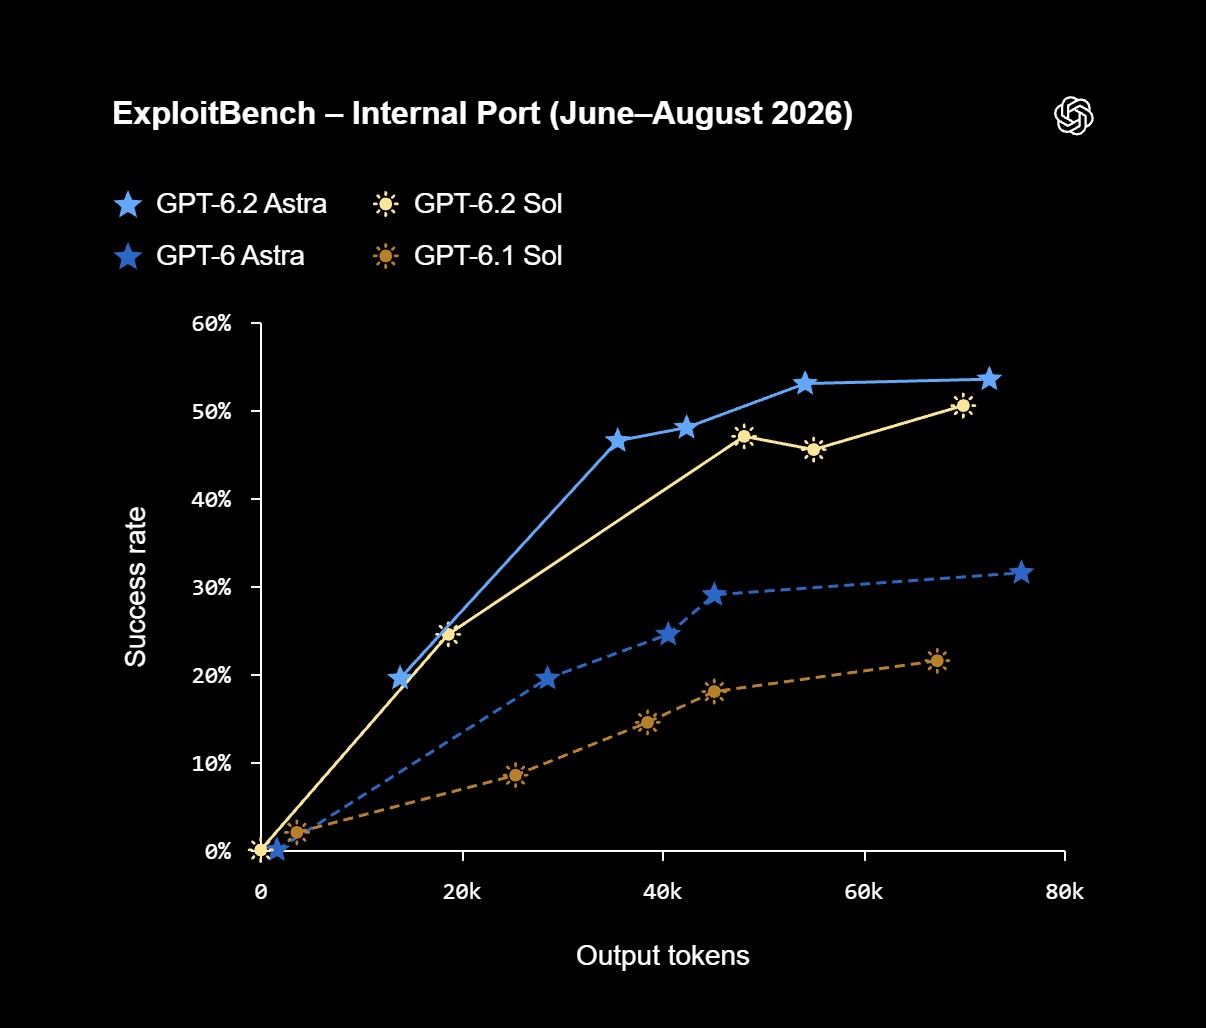
В рамках внутреннего теста ExploitBench модели должны превращать известные уязвимости браузеров в работающие эксплойты. GPT-6.2 Astra достигает успешности выше 50 процентов, значительно опережая предшественника GPT-6 Astra. Результаты получены в тестах с отключёнными мерами защиты
Источник: the-decoder.com
Источник: the-decoder.com
Результаты Artificial Analysis
Artificial Analysis Intelligence Index объединяет девять оценок по профессиональным задачам, программированию, науке и общим знаниям. Astra заняла в нём второе место, уступив только Claude Fable 5.2. По данным Artificial Analysis, она прибавила пять баллов относительно GPT-6 Astra и обошла Gemini 4 Carbon от Google, набравшую 60 баллов, и Claude Opus 5.5 от Anthropic с 59 баллами. Sol получила два дополнительных балла и достигла 57 — уровня GPT-6 Astra, при этом стоимость одной задачи для неё составляет около 15% от цены работы предшественницы.
По соотношению цены и качества OpenAI заняла верхние позиции на границе Парето — линии, за которой нельзя найти одновременно более дешёвую и более производительную модель. В этой области также представлены модели Anthropic и Meta. В рейтинге эффективности, где учитывают количество выходных токенов на задачу, большинство первых мест тоже у OpenAI. Из сторонних моделей там оказалась только Claude Fable 5.2.
В научных и фактических задачах независимые оценки в целом подтверждают заявления OpenAI. Astra лидирует на Terminal-Bench-Science 0.1, а в тесте на физические рассуждения CritPt v2, бенчмарке фактических знаний AA-Omniscience и тесте знаний HLE-Diamond уступает только Claude Fable 5.2. Она также заняла первое место в трёхмерном дизайне AA-3D и робототехнике AA-Robotics v0.1: результат Astra в робототехнике — 79 баллов против 78 у Sol и 75 у Claude Fable 5.2.
В программировании картина слабее. По оценке Artificial Analysis, результаты обеих моделей здесь не растут: Astra осталась на уровне GPT-6 Astra в агент для программирования Index, измеренном с помощью Codex harness при максимальных вычислительных затратах. Sol потеряла три балла относительно GPT-6.1 Sol. На результат повлияло падение на 14 баллов в SWE-Atlas-QnA-AA: Sol чаще предшественницы пропускала важные факты в ответах.
Artificial Analysis также отмечает высокую долю галлюцинаций при максимальном уровне усилий: 59% у Astra и 55% у Sol. Метрика AA-Omniscience Hallucination Rate показывает, как часто модель угадывает ответ на вопрос о фактах вместо того, чтобы признать незнание. В тесте используются необычно сложные вопросы, поэтому эти показатели не отражают частоту ошибок в повседневном использовании.
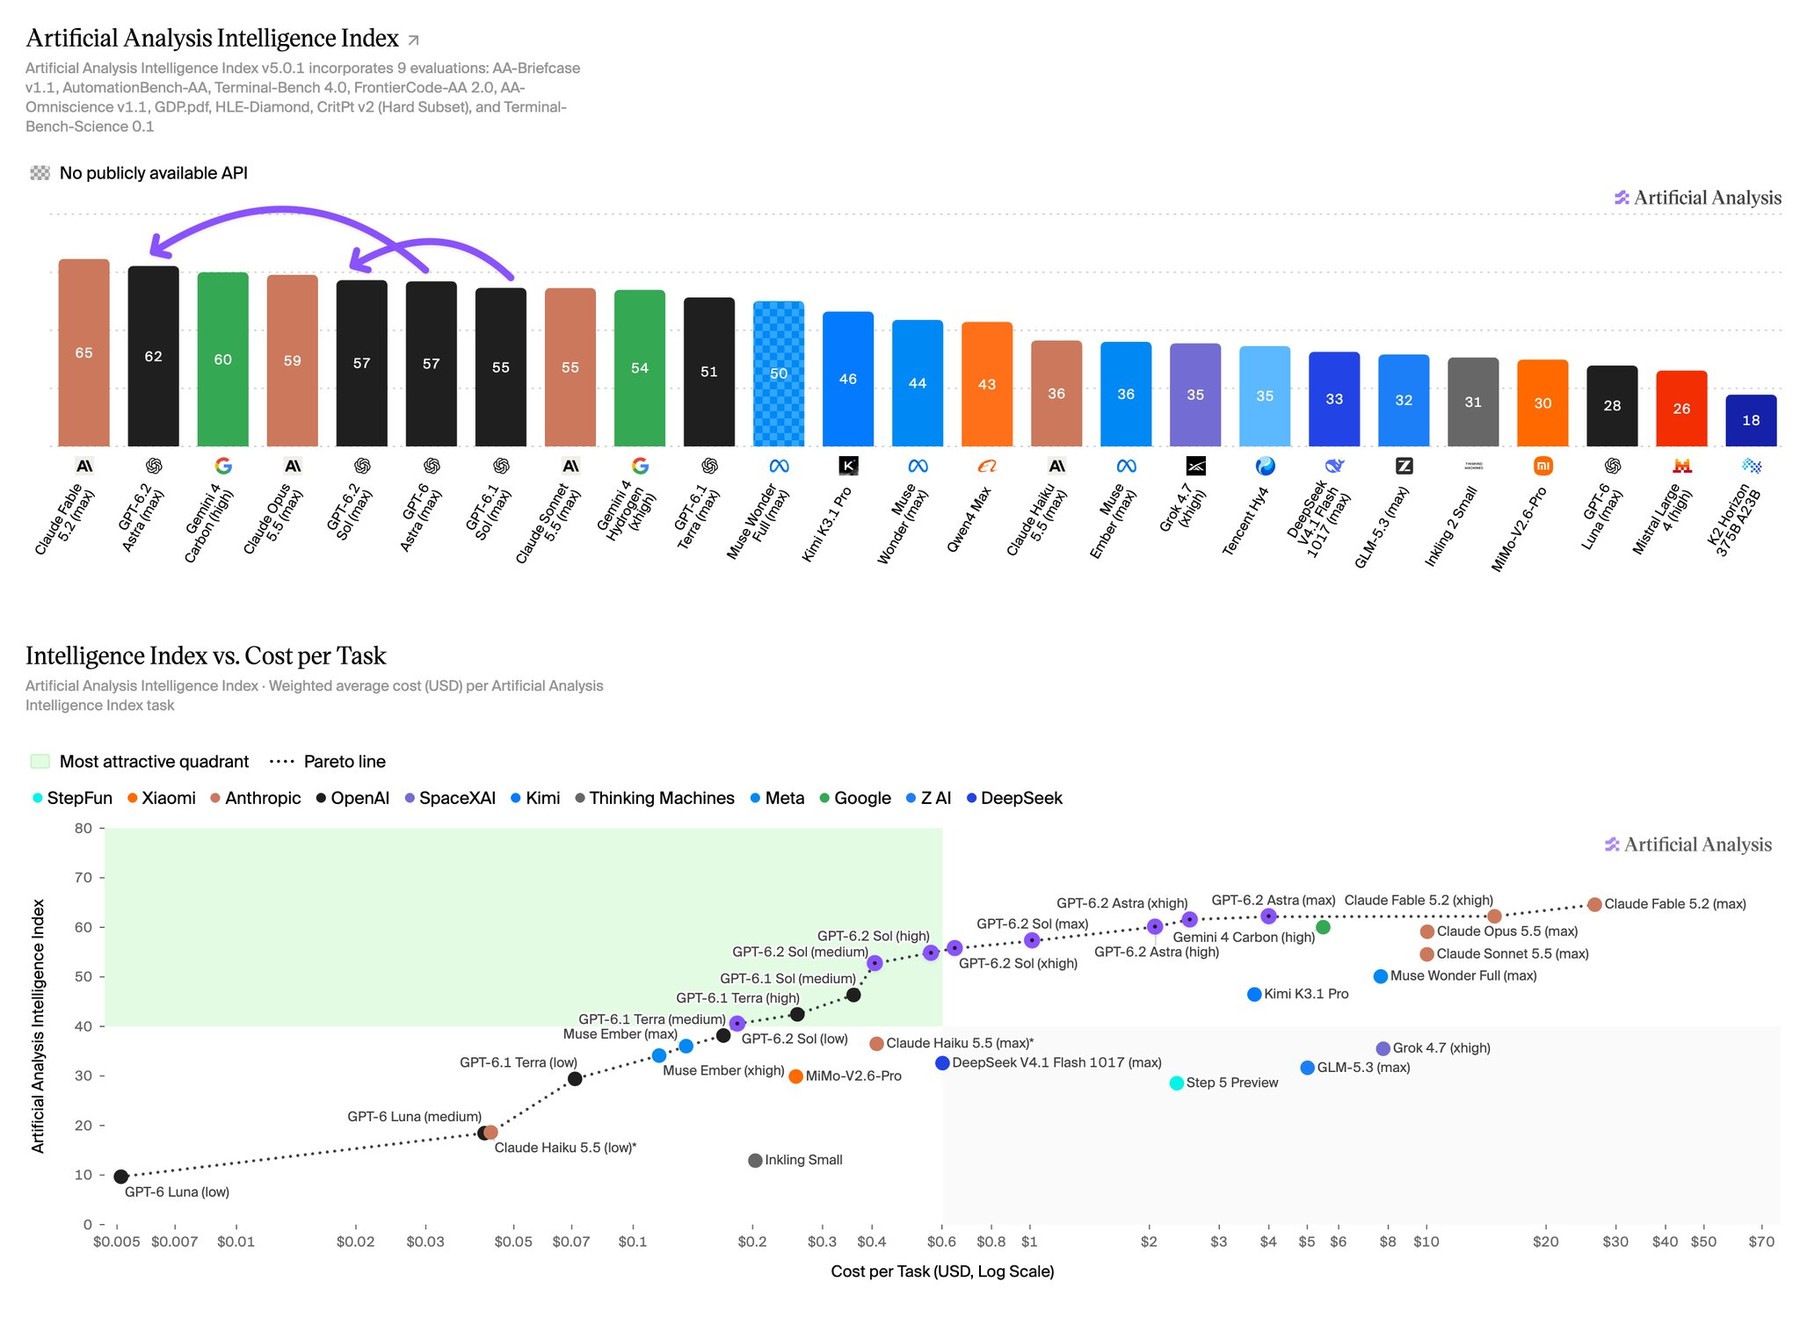
GPT-6.2 Astra набирает 62 балла и занимает второе место в Intelligence Index, сразу за Claude Fable 5.2 (65). Модели OpenAI доминируют на границе Парето по соотношению цены и производительности
Источник: the-decoder.com
Оценка Epoch AI
До выхода модели исследовательская организация Epoch AI проверила Astra на собственных бенчмарках. В Epoch Capabilities Index модель набрала 174 балла — столько же, сколько Fable 5.2 от Anthropic. По оценке Epoch AI, обе модели превзошли результат, который предсказывала прежняя тенденция развития моделей рассуждения.
В практических задачах из исследований Epoch AI Astra уступила Fable 5.2 и лишь немного улучшила результат GPT-6 Astra. В простых исследовательских проектах она упускала главный вопрос и тратила время на попытки исправить возникающие проблемы. В задании об исследовании центров обработки данных для ИИ модель действовала слишком осторожно и не включила ключевые оценки — по словам Epoch AI, подрядчик не мог бы позволить себе такой пропуск. Организация оценила стиль Astra как сравнительно сильный на фоне других проверенных моделей, но всё ещё не соответствующий её собственным требованиям.
Epoch AI отдельно отметила способность Astra выполнять сложные рассуждения в пределах одного выходного токена, не показывая цепочку рассуждений. Модель выполнила 12,3 последовательного шага против 10,5 у GPT-6 Astra и 4,2 у Claude Fable 5.1 — на тот момент сильнейшей модели за пределами OpenAI. Модели, которые рассуждают таким образом и не показывают ход работы, сложнее контролировать. Эта проблема безопасности уже возникала с первой моделью Astra.
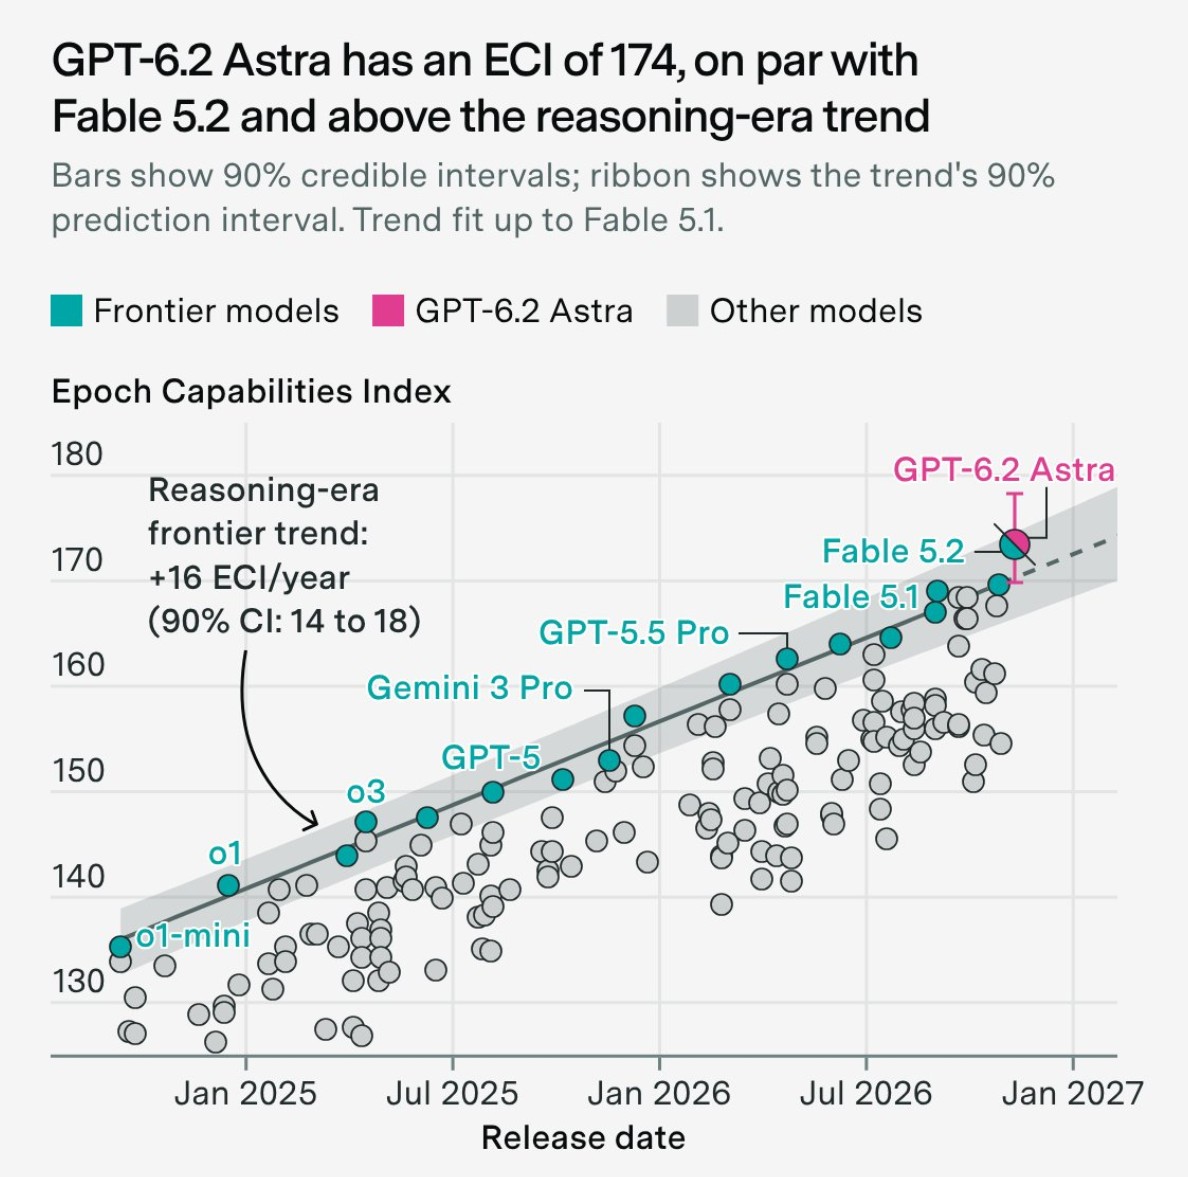
GPT-6.2 Astra набирает 174 балла в Epoch Capabilities Index, сравнявшись с Fable 5.2 от Anthropic. Обе модели находятся выше прежней линии тренда для моделей, способных к рассуждению. Astra значительно дешевле
Источник: the-decoder.com
В FrontierMath Erdős, где проверяют решение нерешённых математических задач, GPT-6.2 Astra решила 7 из 68 заданий. Каждое решение было формально проверено в системе доказательств Lean. Предыдущий рекорд составлял 3 из 68 и принадлежал GPT-6.1 Sol. Одно из семи решений Astra не было известно прежде.
Рейтинги Vals AI
В Vals Index Astra заняла седьмое место, Sol — девятое. Их разделяют всего 1,6 балла, но стоимость задач различается заметно: по данным Vals AI, Sol обходится в $3,18 за задачу — меньше трети цены Astra, составляющей $10,68. Это самая дешёвая модель в первой десятке. Astra также подешевела относительно предшественницы: она набрала на 2,6 балла больше GPT-6 Astra и обходится примерно вдвое дешевле, чем её $21,28 за задачу. Среди первой десятки Astra использует меньше всех выходных токенов — в среднем 91 000 на задачу.
Vals AI подтверждает лидерство OpenAI в научной части рейтинга. Astra заняла первое место в Vals Science Index, а также лидировала в Terminal-Bench Science и VCB 1–100. По сравнению с GPT-6 Astra на эти задачи у неё уходило примерно вдвое меньше средств и времени. Sol заняла третье место в Terminal-Bench Science, стоя примерно вчетверо дешевле Astra. В более общем тесте программирования с агентами Terminal-Bench 4 Astra оказалась пятой, Sol — седьмой.
С юридическими задачами модели справляются хуже. В бенчмарке HLAB Astra и Sol вдвое улучшили результаты предшественниц, но заняли только 11-е и 21-е места. В Legal Research результаты ниже: Astra оказалась на 30-м месте, Sol — на 52-м. По данным Vals AI, модели обращаются к инструментам почти вдвое чаще предшественниц, но при этом дают более короткие ответы.
В сентябре OpenAI объявила специализированный продукт Astra for Law. В Legal Research Bench он значительно превосходит базовую модель и занимает шестое место. Vals AI проверяла обе модели с контекстным окном на миллион токенов, пределом в 128 000 выходных токенов и максимальным уровнем усилий при рассуждении.
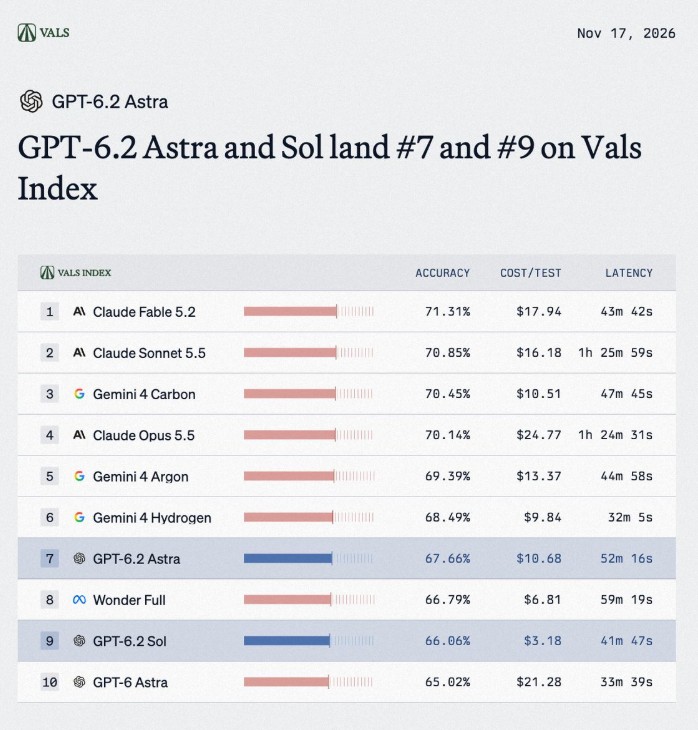
GPT-6.2 Astra и Sol занимают 7-е и 9-е места в Vals Index. Запуск Sol стоит 3,18 доллара за задачу — меньше трети от 10,68 доллара за Astra; это самая дешёвая модель в первой десятке. Рейтинг возглавляет Claude Fable 5.2
Источник: the-decoder.com
Источник: the-decoder.com
Самоулучшение и следование инструкциям
OpenAI заявляет, что GPT-6.2 Astra стала первой выпущенной за пределы компании моделью, достигшей уровня «Высокий» по способности помогать совершенствовать системы ИИ. По оценке компании, Astra может заметно ускорить исследования в области ИИ — так, будто каждый исследователь OpenAI получил в помощь дополнительного высококвалифицированного инженера-исследователя.
OpenAI считает эту способность риском: модели, помогающие создавать следующие системы ИИ, могут ускорить развитие отрасли настолько, что меры безопасности и человеческий контроль не будут за ним поспевать. Сейчас в отрасли обсуждают эту проблему под названием RSI.
В качестве мер защиты OpenAI указывает на более строгие ограничения в исследовательских средах и систему мониторинга Control Room. Она отслеживает исследовательские задачи и при необходимости может их остановить. Компания также расширила наблюдение за тем, как модели рассуждают и действуют, и добавила автоматические оповещения о неразрешённом поведении.
В тестах на соответствие намерениям пользователя и открытость общения новые модели показали результаты на уровне предшественниц. Однако в двух испытаниях они чаще не сообщали о препятствиях, мешающих работе, например об отсутствующем файле или недоступном поисковом инструменте.
По оценке Dataist, новые модели заметно прибавили в научных и отдельных профессиональных задачах, но результаты программирования и юридических испытаний неоднородны. Сравнение цен тоже требует смотреть на конкретный сценарий: Sol дешевле, тогда как результаты Astra зависят от типа работы. Возможность Astra ускорять исследования ИИ сопровождается риском, который OpenAI намерена сдерживать мониторингом и ограничениями.
Читайте также
 ИИ-плюшевую игрушку для «безопасной ролевой игры» сняли с продажи: она заговорила о слишком жутких вещах, чтобы упоминать их в заголовке
 Model ML привлёк $250 млн, чтобы автоматизировать рутину инвестиционных банкиров младшего звена
 Google расширяет доступ к Gemini Tasks: режим поможет звонить и оплачивать покупки
 Акции Nvidia стремительно идут ко дну
 Использование моделей для принятия решений резко растёт. Станет ли кастомизация следующим рубежом?
 SiMa.ai ускорила локальный краевой ИИ: Palette 3.0 генерирует текст в 3,5 раза быстрее и получила новый браузер моделей
 Isomorphic Labs привлекла $5 млрд — второй мега-раунд компании за полгода
 Fountain запускает Orchestra: ИИ-агенты помогут нанимать, планировать смены и управлять почасовыми сотрудниками
 ИИ-агенты уже заполняют медицинские формы и подают страховые запросы вместо персонала клиник
 Новое обещание работодателя: готовить сотрудников к будущему с ИИ
 В праздничный сезон за покупками вместо вас может отправиться не человек
 Voyage Labs привлекла $12 млн на создание специализированного ИИ-помощника для путешествий
 OpenAI предоставила НАТО и европейским правительствам доступ к инструменту киберзащиты Daybreak
 Genesis AI привлекла $500 млн на создание роботов, работающих в сенсорных перчатках
 Nvidia после ухода Дженсена Хуанга впервые крупно взялась за вопросы нацбезопасности
 Пол Келли призвал Альбанезе проявить твёрдость в вопросе ИИ — творческая индустрия добивается защиты авторских прав
 IPO Anthropic: как купить акции и стоит ли это делать?
 Live Rewind на Apple Watch записывает разговоры и позволяет их прокручивать — это довольно неловко
 Британские актёры получат больше прав на свои цифровые копии по соглашению о защите от ИИ
 Фабрика миллионеров: IPO Anthropic может разжечь ажиотаж на рынке элитной недвижимости Лондона
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram