
Почему расчёта вычислений недостаточно
Для плотного трансформера объём вычислений при обучении оценивают как 6·P·D, где P — число параметров, а D — число обучающих токенов. Если разделить эту величину на производительность графических процессоров, получится оценка времени цикла обучения:
T_theoretical = (6 · P · D) / (N_GPU · FLOPS_peak · MFU)N_GPU — число графических процессоров, FLOPS_peak — пиковая производительность одного устройства по спецификации, а MFU (Model FLOPs Utilization) — доля этой производительности, которую фактически использует обучение. Из-за обмена данными с памятью, передачи данных между устройствами и неэффективности вычислительных ядер задачи не работают на пике. Обычно MFU составляет от 30% до 60%, но заранее определить подходящее значение для конкретной задачи нельзя.
Эта формула оценивает цикл оптимизации, но полное задание включает и другие этапы. До обучения нужно настроить окружение, загрузить и подготовить модель, выполнить токенизацию. Во время обучения запускаются периодические оценки и отправка контрольных точек, а в конце итоговая модель сохраняется в объектном хранилище. На общем кластере эти операции конкурируют за сеть и хранилище с другими заданиями.
Накладные расходы зависят от настроек и не растут предсказуемо вместе с объёмом задачи или числом графических процессоров. Поэтому два задания с одинаковым расчётным объёмом вычислений могут завершиться с разницей в несколько часов. Для честного сравнения авторы включили в базовый расчёт FLOP также токены оценки и проверили разные значения MFU.
Как устроен прогноз
Авторы рассматривают длительность задания от запуска на выделенных графических процессорах до завершения как задачу регрессии. Время ожидания в очереди не учитывается. Все входные признаки берутся из конфигурации, поданной до запуска: гиперпараметров, размеров наборов данных, идентификаторов моделей и выделенных графических процессоров. Текущие журналы работы и промежуточный прогресс модели недоступны — поэтому такой прогноз можно использовать при планировании.
Помимо исходных настроек, исследователи рассчитали признаки, связанные с накладными расходами: num_eval_data — количество примеров, обработанных за все циклы оценки; num_saves и num_params_saved — характеристики операций с контрольными точками; объём токенов на один графический процессор. Оценка по FLOP с фиксированным MFU 0,45 также вошла в модель как признак baseline_time: модель начинает с оценки вычислительной нагрузки и корректирует её с учётом других факторов.
Авторы сравнили линейную регрессию, Ridge, XGBoost и CatBoost. Для отбора признаков использовали фильтрацию по корреляции, взаимную информацию и перестановочную важность признаков. Проверили 18 наборов признаков, а затем провели поиск по сетке, выбирая варианты по средней абсолютной ошибке. В итоговую модель CatBoost вошли 24 признака.
Какие задания вошли в выборку
Данные включали 272 запуска контролируемого дообучения (SFT) из журналов корпоративной производственной среды. В выборке были несколько семейств моделей размером до 15 млрд параметров, полное дообучение и LoRA, а также наборы данных и гиперпараметры разных размеров.
Задания запускались на одном, двух или четырёх графических процессорах из общего пула на 8–32 NVIDIA H200, размещённых на одном–четырёх узлах. Одновременно на инфраструктуре шли другие задания по обучению и инференсу, поэтому измерения отражают реальную конкуренцию за ресурсы. Длительность запусков составляла от 1,6 до 172,4 часа: среднее — 23,43 часа, медиана — 15,29 часа.
В программный стек входили Hugging Face Transformers и Unsloth. Его учитывали как категориальный признак, не предполагая заранее фиксированного выигрыша в скорости от одного варианта над другим.
Сравнение методов
Все результаты получены с помощью стратифицированной перекрёстной проверки на пяти частях выборки. Первые четыре базовых метода были аналитическими и не требовали обучения модели.
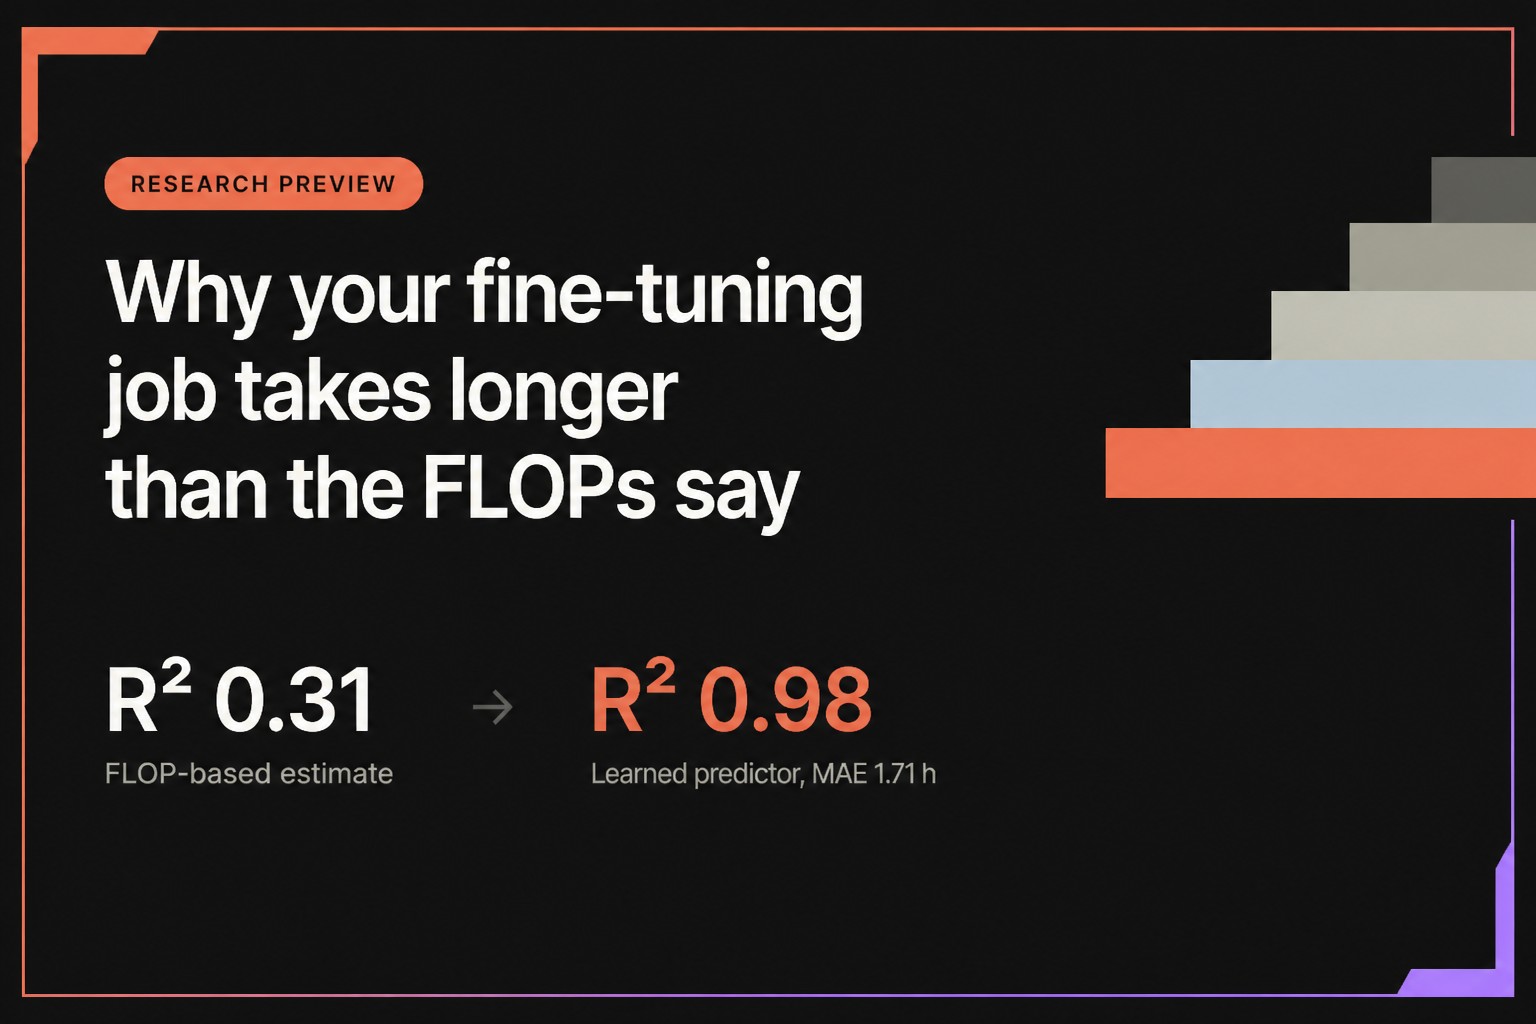
Ни один выбранный коэффициент MFU не сделал оценку по FLOP точной. Авторы перебрали значения от 0,25 до 0,65. Лучший результат получился при MFU 30%, но средняя ошибка всё равно превышала 12 часов при средней длительности задания около 23 часов.
Более подробная аналитическая модель также не устранила разрыв. В качестве второго ориентира исследователи взяли Calculon — модель производительности обучения больших языковых моделей, описанную Isaev и соавторами на SC ’23. Она строит явный граф слоёв и учитывает вычисления, обмен данными с памятью и связь между устройствами. Авторы расширили открытую реализацию, добавив поддержку LoRA, группированного внимания с запросами, объединённого внимания, bfloat16 и SwiGLU. Однако медианное предсказанное время составило лишь 11% фактической длительности. По словам авторов, это не опровергает полезность Calculon для оценки отдельных шагов: модель предназначалась именно для этого. Результат показывает, какая часть производственного задания приходится на операции за пределами шага оптимизации.
Линейные модели улучшили прогноз, но их возможности оказались ограничены: Ridge снизил среднюю абсолютную ошибку до 7,23 часа. Связь между настройками задания и его длительностью не удаётся достаточно точно описать только линейной зависимостью.
Наибольшую часть работы взяли на себя методы градиентного бустинга. CatBoost и XGBoost различались по всем метрикам не более чем на одно стандартное отклонение. Для дальнейшего анализа авторы выбрали CatBoost: у него была наименьшая средняя ошибка.
Какие параметры связаны со временем
Важность признаков CatBoost сосредоточена вокруг нескольких параметров. Среди них — характеристики модели и объёма работы, а также настройки оценки и сохранения контрольных точек. На первом месте оказался num_eval_data — общее число примеров, обработанных при оценке за всё задание. Далее следовали num_trainable_params, batch_eval_size_percent, num_all_params и num_gpus*batch_train_percent; близко к ним находился num_params_saved.
Анализ SHAP дал сходную картину: большой объём оценки последовательно увеличивал предсказанное время. Число обучаемых параметров влияло нелинейно, причём заметным это влияние становилось для самых крупных моделей. Важность признака сама по себе не доказывает причинно-следственную связь, но обнаруженные зависимости согласуются с тем, как распределяется время задания: на результат влияют частота и размер оценок, число сохраняемых контрольных точек, масштаб модели и набора данных. Многие из этих параметров задают при подготовке конфигурации обучения.
Число выделенных графических процессоров в модели связано с увеличением предсказанного времени. Однако в этой выборке более крупные выделения ресурсов соответствовали и более крупным заданиям, поэтому число устройств частично отражает масштаб задачи. Это не означает, что добавление графических процессоров само по себе замедляет обучение.
Где точность снижается
Для всех 272 предсказаний вне обучающих частей выборки медианная абсолютная ошибка составила 0,51 часа. В 80% случаев ошибка не превышала 2,20 часа, а в 90% — 4,31 часа.
Для заданий длительностью до 60 часов медианная ошибка оставалась около часа или меньше. На более длинных запусках прогнозы становились менее точными. Таких заданий было всего 13, поэтому авторы связывают ухудшение результатов с нехваткой данных.
На фиксированной отложенной выборке размером 20% средняя абсолютная ошибка снизилась с 1,63 до 1,50 часа, когда доля данных для обучения выросла с 85% до 100%. Явного плато при этом не появилось.
Применение и ограничения
Прогноз позволяет планировщику оценить длительность задания до его запуска: решить, какие задания запускать одновременно, когда освободятся графические процессоры и успеет ли обучение завершиться к сроку.
Модель проверили только на SFT: другие стратегии обучения и настройки предпочтений, включая RLHF, DPO и RLVR, в выборку не вошли. Все запуски прошли на H200, поэтому численные результаты нельзя автоматически переносить на другие поколения графических процессоров — модель потребуется переобучить. Для смешанных пулов устройств в неё также нужно будет включить характеристики оборудования: вычислительную производительность, объём и пропускную способность памяти, а также топологию соединений.
По словам авторов, на другие инфраструктуры можно перенести сам подход: признаки, учитывающие накладные расходы, отбор с учётом мультиколлинеарности и протокол сравнения. Полная версия статьи должна содержать формулы признаков, процедуру отбора, пространства поиска и итоговые гиперпараметры — это позволит восстановить пайплайн на наборе журналов выполнения сходной структуры.
Дальнейшие направления работы — признаки, специфичные для оборудования, и проверка на других типах графических процессоров; перенос обучения на конфигурации с малым числом наблюдений; другие цели обучения; сбор дополнительных данных о длительных запусках. Полная статья, как сообщают авторы, скоро появится на arXiv.
По оценке Dataist, результаты показывают, насколько планирование обучения зависит от операций вокруг вычислительного цикла — прежде всего оценки и сохранения контрольных точек. Но пока выводы относятся к SFT на NVIDIA H200: переносимость модели на другие типы оборудования и режимы обучения ещё предстоит проверить.
Читайте также
 После IPO Amazon и Google будут владеть почти 30% Anthropic вдвоём
 «Просто нелепо»: знаменитый философ спорит с идеей сознания у ИИ
 Microsoft заменяет сторонние ИИ-модели в своих продуктах более дешёвыми собственными разработками
 ИИ-функция Google в поиске получила собственный режим инкогнито
 За кулисами первой общей встречи Nvidia после ухода Дженсена Хуанга: повышение зарплат и больше акций
 OpenAI: её модели добавили год оптимизации чипов поверх инженерной работы AMD
 Nvidia уточнила, когда будет и не будет финансировать облачных провайдеров для ИИ
 Индийская Humyn Labs привлекла $47 млн, чтобы снабжать американские компании в сфере робототехники нужными данными
 Стартап в сфере запахов утверждает, что его ИИ-нос не уступает человеческому
 Новая функция Visuals от Suno объединяет созданную ИИ музыку с созданным ИИ видео
 Lovable предлагает создать дело мечты с помощью вайб-кодинга
 Элтон Джон неожиданно появился на премии ARIA, чтобы поддержать австралийских артистов в борьбе с ИИ
 Google будет хранить чаты Gemini два месяца вместо 72 часов, даже с выключенной историей
 Ориентированная на приватность альтернатива ChatGPT и Claude от Proton, Lumo, вышла на компьютеры
 Pedestal AI привлекла $4,7 млн, чтобы внедрить ИИ-агентов в цепочки поставок
 Слово human стало словом года по версии Cambridge Dictionary
 Больше трети поколения Z полагаются на ИИ в поисках дружеского общения
 Новый ИИ-агент Daydream станет вашим личным стилистом и поможет с покупками too
 Инвестиции Nvidia в стартапы выросли до $65 млрд, но после ухода Хуанга будущее новых сделок под вопросом
 После ухода Дженсена Хуанга Nvidia отказывается от Китая
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram