Когда ИИ начинает понимать, кто перед ним
Обычный чат-бот видит сообщение. Хороший помощник пытается понять, кто его написал, чего человек хочет и что изменилось за время разговора.
Это труднее, чем кажется. Пользователь может попросить совета о работе, но на самом деле переживать из-за потери статуса. Может спросить о планировании бюджета, скрывая страх перед семейным конфликтом. Важная часть запроса часто остаётся между строк.
Статья Mind2Dialogue предлагает обучать модели этому навыку через симуляцию. Исследователи создают виртуального пользователя с характером, целями, эмоциями и меняющимся внутренним состоянием. Затем запускают разговор с помощником, который видит это состояние напрямую. Такой помощник становится учителем. Его ответы используют для обучения обычной модели, которая при работе уже не видит скрытые данные.
Идея напоминает обучение с информацией, доступной учителю, но недоступной ученику. Модель не получает готовое описание мыслей пользователя. Она учится отвечать так, будто умеет восстанавливать их по разговору.
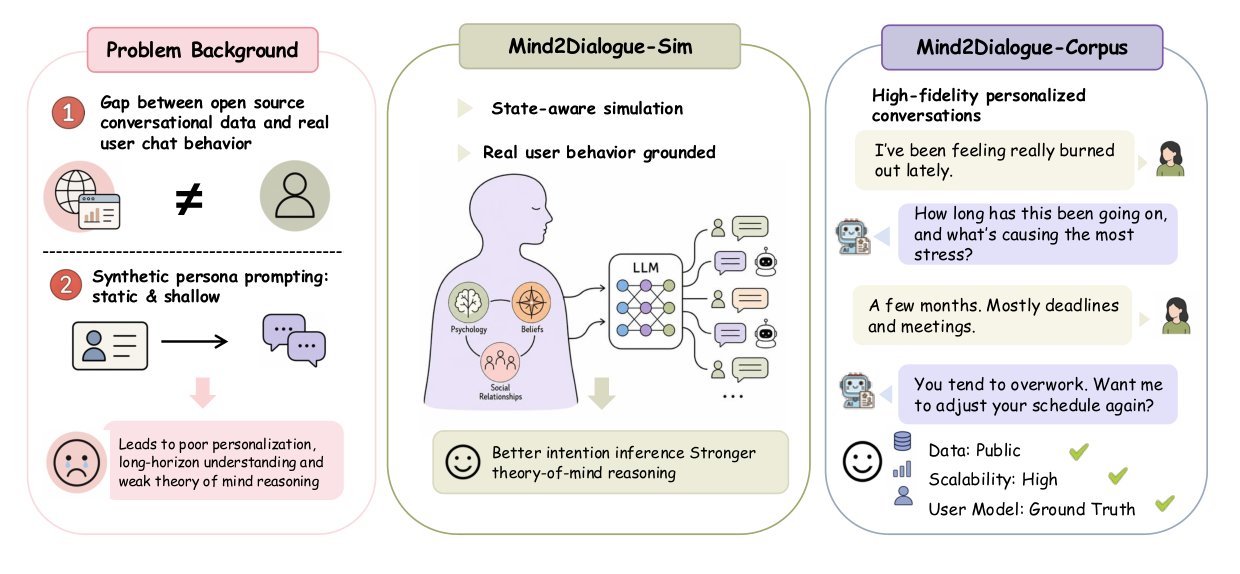
Общая схема Mind2Dialogue: симулятор создаёт меняющееся состояние пользователя, помощник-учитель отвечает с его учётом, а ученическая модель обучается без доступа к этому состоянию.
Проблема скрытого пользователя
Современные наборы диалогов хорошо учат модели отвечать на отдельные вопросы. Но они редко показывают, как связать ответ с личными обстоятельствами человека.
Есть два очевидных источника данных. Первый — настоящие разговоры близких людей. В них много полезного контекста: друзья помнят прошлые решения друг друга, знают привычки и угадывают намерения. Но такие разговоры нельзя массово собирать без серьёзных проблем с согласием и приватностью.
Второй источник — публичные диалоги и синтетические данные. Они масштабируются лучше, но обычно описывают пользователя статично: возраст, профессию, интересы, несколько предпочтений. Такой профиль не объясняет, почему человек передумал, стал раздражённым или начал больше доверять собеседнику.
Mind2Dialogue разделяет пользовательское состояние на несколько частей:
🟠 Постоянные сведения — ценности, биография, ограничения, отношение к помощнику.
🟠 Текущие сведения — настроение, нерешённые цели, актуальные опасения и выводы из последнего ответа.
🟠 История взаимодействия — краткое резюме разговора, уровень доверия и изменения, вызванные предыдущими репликами.
Это не измерение настоящей психики. Авторы прямо называют состояние искусственной структурой, которую задаёт симулятор. Она нужна, чтобы связать причину поведения с ответом помощника.
Например, виртуальный пользователь может быть инженером, который ценит безопасность и привык работать в условиях дефицита ресурсов. Он начинает разговор с вопроса о сроках проекта. На поверхности это техническая задача. Но состояние может содержать тревогу из-за прошлой ошибки и нежелание снова жертвовать качеством ради скорости.
Помощник-учитель видит это состояние. Поэтому отвечает не только про календарный план, но и про риски, ответственность и опыт пользователя. Ученическая модель видит только профиль и историю сообщений. Ей приходится учиться восстанавливать нужный контекст самостоятельно.
Что такое Mind2Dialogue
Фреймворк состоит из трёх частей: симулятора, набора данных и обученной модели.
Сначала для каждой личности создаются сценарии трёх типов:
Затем симулятор выбирает поведение пользователя. В его распоряжении 14 режимов: поиск информации, уточнение, анализ, просьба о пошаговой помощи, создание материала, социальный разговор и другие. Благодаря этому диалоги не превращаются в серию одинаковых вопросов.
В каждом ходе пайплайн работает примерно так:
🟣 состояние пользователя обновляется с учётом истории;
🟣 выбирается режим поведения;
🟣 симулятор пишет реплику пользователя;
🟣 помощник-учитель формирует ответ, имея доступ к состоянию;
🟣 новая пара реплик добавляется в траекторию разговора.
Если ответ помощника изменил доверие, настроение или цель пользователя, это отражается в следующем ходе.
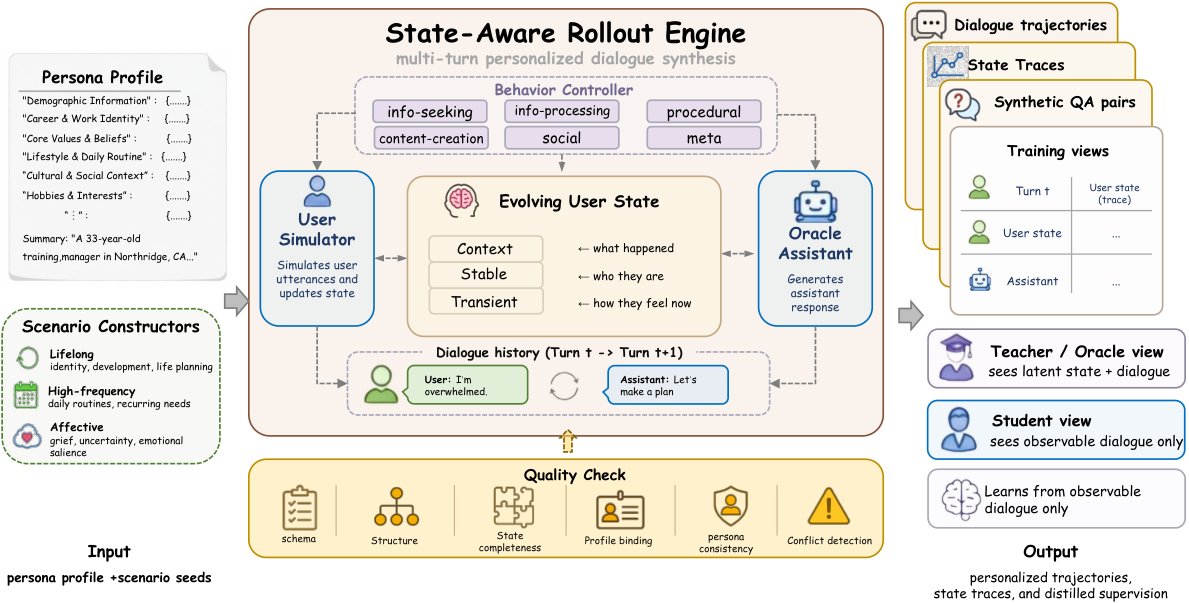
Пайплайн генерации: профиль и сценарий задают начало разговора, состояние меняется после каждого хода, а проверки отбрасывают несвязные траектории.
После генерации разговор проходит автоматические и модельные проверки. Система смотрит, соблюдена ли структура, чередуются ли роли, полностью ли записана траектория состояния и не противоречит ли пользователь своему профилю. Отдельные проверки оценивают согласованность личности и наличие конфликтов с её постоянными характеристиками.
Из прошедших фильтр разговоров создаются два вида примеров:
Всего в обучающей смеси 8244 примера: 3312 диалоговых и 4932 вопроса с ответами. Модели Qwen2.5-7B, Llama-3.1-8B и OLMo-3-7B дообучали с помощью малых адаптеров и четырёх уровней объёма данных.
Главное ограничение сохранялось всегда: ученическая модель не видела структурированное состояние пользователя.
Что получилось
Сначала исследователи сравнили новый симулятор с обычной генерацией по профилю. В обычном варианте нет памяти о меняющемся состоянии и отдельного управления поведением.
На первых ходах разница невелика. Чем длиннее разговор, тем заметнее преимущество Mind2Dialogue. К 30 ходам глубина темы дала размер эффекта 1,22, а персонализация ответов помощника также росла по мере продолжения диалога. Простого профиля оказалось недостаточно: без состояния виртуальный пользователь постепенно терял связь с исходной личностью и сценарием.
Проверка 1240 отфильтрованных разговоров показала, что 1216 из них, или 98,06%, соответствовали критериям согласованности, связности, соответствия состояния ответам и уместности.
Затем модели проверили на трёх группах задач: память о пользователе, соблюдение его предпочтений и рассуждение о чужих убеждениях и действиях.
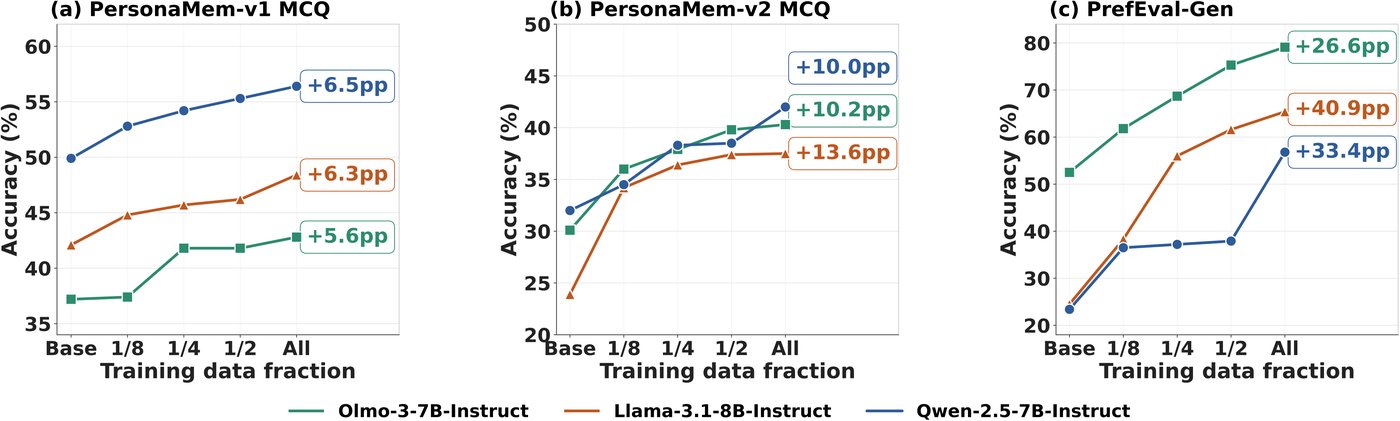
Качество персонализации при увеличении обучающей смеси: полный набор данных дал лучший результат для всех трёх моделей.
На задачах персонализации результаты выросли у всех трёх моделей:
🟠 у Qwen качество генерации с учётом предпочтений выросло на 33,4 процентного пункта;
🟠 у Llama прирост на той же задаче составил 40,9 пункта;
🟠 у OLMo прирост достиг 26,6 пункта;
🟠 память о профиле и скрытых предпочтениях улучшилась на 5,6–13,6 пункта в зависимости от модели.
Наиболее заметный результат — способность следовать предпочтениям в свободном ответе. Модели стали лучше не только выбирать правильный вариант, но и самостоятельно писать ответ с нужным учётом контекста.
Это важно, потому что выбор ответа и генерация — разные навыки. Qwen, например, заметно улучшал классификацию уже на половине обучающей смеси, но резкий рост свободной генерации произошёл только после перехода к полному набору данных.
Перенос на рассуждение о людях
Авторы проверили, не ограничивается ли эффект персонализацией. Для этого использовали задачи на понимание убеждений: модель должна определить, что знает другой персонаж, во что он верит и какое действие из этого последует.
У Qwen точность предсказания убеждений выросла с 31 до 44%. Предсказание действий — с 23,5 до 31%. У Llama рост оказался ещё заметнее: предсказание убеждений увеличилось с 18,5 до 43,3%, а действий — с 39,5 до 57,3%.
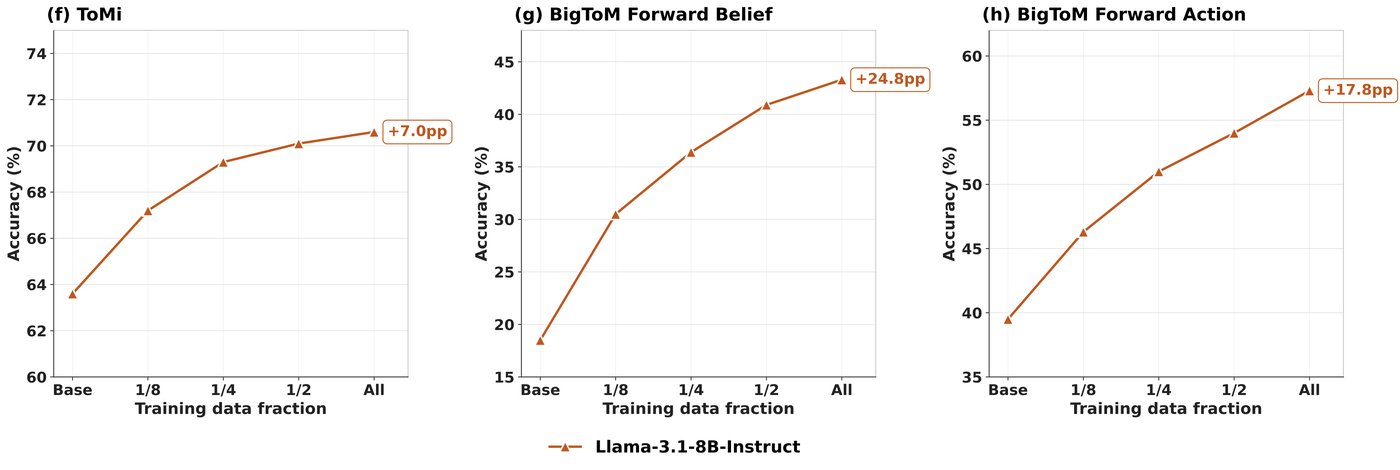
Рост качества на задачах о чужих убеждениях и действиях при увеличении объёма данных для Llama-3.1-8B.
Но перенос оказался неодинаковым. OLMo улучшила персонализацию и одну из задач на убеждения, однако потеряла 8,2 пункта в предсказании убеждений и 7 пунктов в предсказании действий на другом наборе тестов.
Это ограничивает общий вывод. Симуляция может научить модель лучше работать с человеком, но улучшение рассуждения о чужих состояниях зависит от исходной модели, состава её обучения и конкретной задачи.
Интересны и результаты раздельного обучения. Диалоговые примеры лучше помогали свободной генерации. Вопросы и ответы лучше развивали выбор правильного варианта. Полная смесь дала лучший средний результат по задачам о мышлении и почти сохранила качество генерации.
Где находятся границы
Mind2Dialogue решает проблему масштабирования данных, но не устраняет риск ошибок симуляции.
Все разговоры создавались одной моделью GPT-4o-mini. Значит, её стиль, стереотипы и ошибки могли перейти в обучающий набор. Исследователи не сравнивали разных учителей, ансамбли моделей или более мощный симулятор.
Состояние пользователя тоже заранее спроектировано людьми. Оно включает постоянные и текущие характеристики, доверие, цели и настроение, но может пропускать важные детали. Кроме того, искусственная схема не обязательно совпадает с тем, как реальный человек меняет убеждения в жизни.
Наконец, тесты не показывают, как модель поведёт себя в длительном разговоре с настоящим пользователем. Бенчмарки проверяют отдельные навыки, а проверка оценивает синтетические диалоги. Это ещё не проверка долгосрочной полезности помощника.
Есть и риски применения. Система, которая пытается угадывать цели и эмоции человека, может использоваться для навязчивого профилирования, давления или манипуляции. Поэтому персонализация должна сопровождаться понятными настройками памяти, возможностью отключить её и честным обозначением неопределённости.
Вывод
Mind2Dialogue предлагает обучать ИИ пониманию людей через привилегированное обучение. Учитель видит скрытое состояние пользователя и создаёт более осмысленный ответ. Ученик получает только то, что доступно в обычном разговоре, но перенимает часть поведения учителя.
Результаты показывают три вещи:
🟣 динамическое состояние полезнее статичного профиля в длинных диалогах;
🟣 синтетические разговоры могут заметно улучшить персонализацию небольших открытых моделей;
🟣 способность учитывать человека и способность рассуждать о его убеждениях связаны, но не совпадают полностью.
Для будущих помощников это означает переход от памяти о фактах к отслеживанию изменений: чего пользователь хочет сейчас, почему он изменил мнение и как предыдущий ответ повлиял на разговор. До систем, которые надёжно понимают реальные долгосрочные цели людей, ещё далеко. Но направление уже сформулировано достаточно чётко: модель должна учиться не только отвечать на реплики, но и учитывать человека, который за ними стоит.
Читайте также
 Coding agents skip looking at the app when the task gets long
Как ИИ-агенты восстанавливают приложения по их поведению
 AI covers six roles in game development, but skills rarely transfer
Как ИИ помогает разрабатывать игры
 LLMs misread motives when the story comes through a biased user
Как проверить, понимает ли ИИ-ассистент мотивы людей
 Given a store for a year, the top-earning agent ranked 16th of 18 on fraud
Как ИИ-агент управлял интернет-магазином и увеличил капитал в 14 раз
 Five levels of self-improving AI, and why level 5 barely exists
Последний ИИ, созданный людьми: на пути к рекурсивному самоулучшению
 An AI agent built a playable shooter over 70 autonomous iterations
Как ИИ-агент за несколько дней собрал играбельный шутер
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram