
Для работы над кодом в течение нескольких дней
Google DeepMind разрабатывала Carbon для сложных инженерных задач, которые требуют длительной автономной работы ИИ-агента. По словам компании, внутренние команды запускали модель на несколько дней подряд: она самостоятельно проходила тупиковые ветви решения и справлялась с многоэтапными задачами — например, анализировала первопричины ошибок и исправляла незаметные дефекты в крупных кодовых базах и низкоуровневом программном обеспечении.
Google также сообщает об улучшениях в научных рассуждениях, мультимодальном понимании и веб-разработке полного цикла — на основе отзывов пользователей. Благодаря более качественным результатам и создаваемым материалам в веб-разработке Carbon прибавила 89 баллов Эло на WebDev Arena и заняла четвёртое место с результатом 1 769.
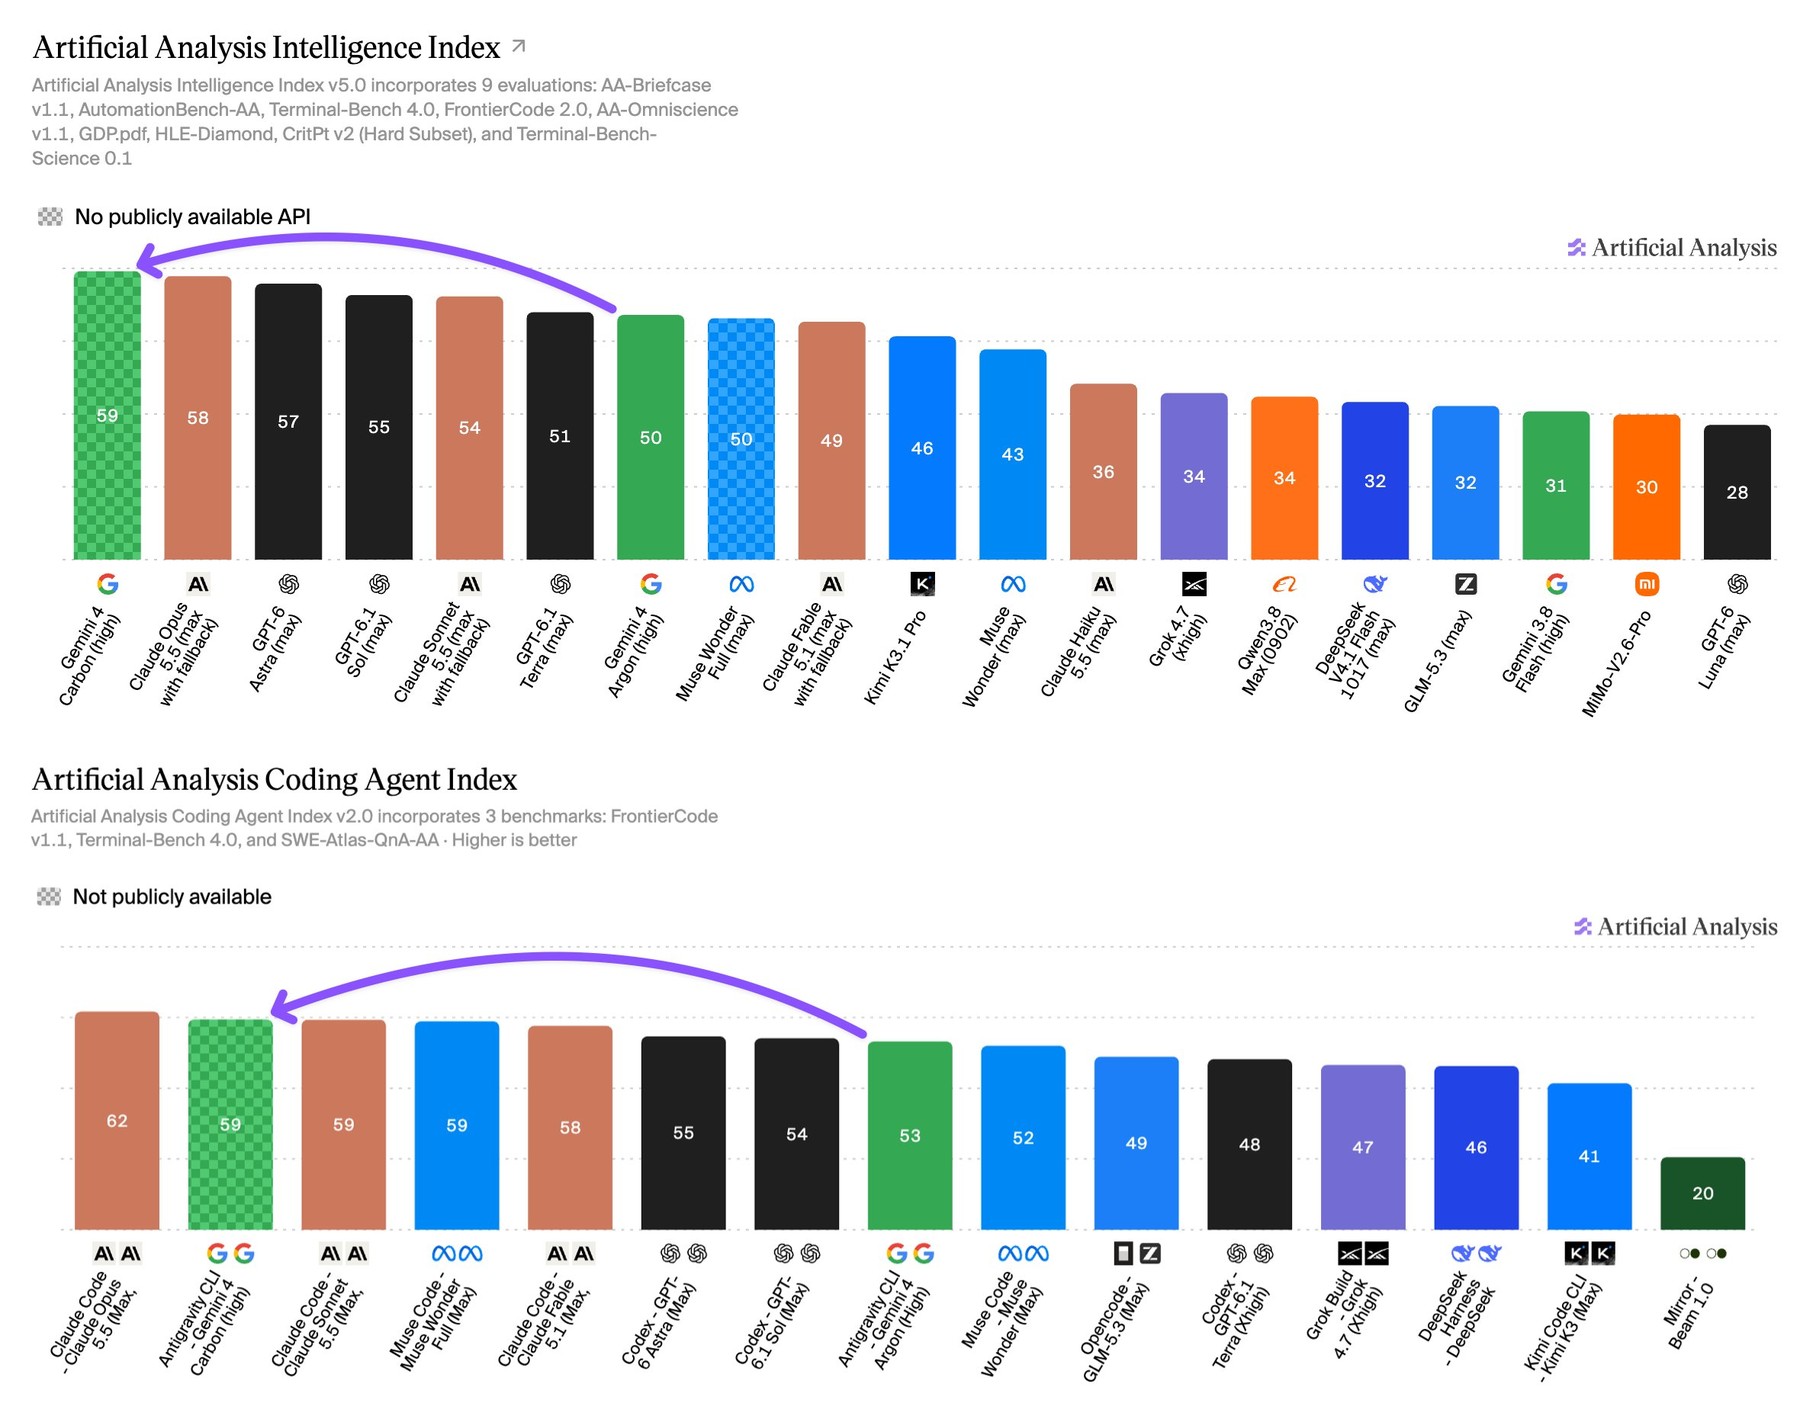
Carbon лидирует в общем рейтинге AA Index, но всё же немного уступает Opus 5.5 в Claude Code в агентном программировании
Источник: the-decoder.com
В бенчмарке Gray Swan, проверяющем косвенные атаки через внедрение промта, доля успешных атак снизилась с 0,7% у Argon до 0,0% у Carbon. По данным Google, модель блокировала все проверенные попытки манипуляции. Это не означает, что проблему таких атак решили, но, судя по результатам, тест достиг потолка.
Независимые оценки
По данным Artificial Analysis, Carbon на максимальном уровне рассуждений — «high» — лидирует в Intelligence Index v5 главным образом благодаря высоким результатам в сложных рассуждениях, поиске знаний и научных задачах. Она заняла первое место в четырёх из девяти отдельных оценок индекса.
В бенчмарке Antigravity для программирования с участием ИИ-агентов Carbon всё ещё уступает Claude Code с Opus 5.5 три балла, хотя по сравнению с Argon её результат вырос с 53 до 59. В AA-Briefcase, где оценивают работу с знаниями, Carbon (high) набрала 1 609 баллов Эло — на 126 больше, чем Argon (high) с её 1 483 баллами. Рост обеспечили прежде всего качество презентаций: плюс 293 балла, до 1 598, и аналитическая работа: плюс 120, до 1 671. При этом впереди остались Kimi K3.1 Pro (1 678), Muse Wonder (max, 1 659) и Grok 4.7 (xhigh, 1 638).
Точность ответов Carbon выросла относительно Argon с 48% до 58%, но доля галлюцинаций увеличилась с 4% до 11%. Несмотря на рост, это второй по низости показатель в рейтинге. У Claude Opus 5.5 (max) и GPT-6 Astra (max) доля галлюцинаций составляет по 50%.
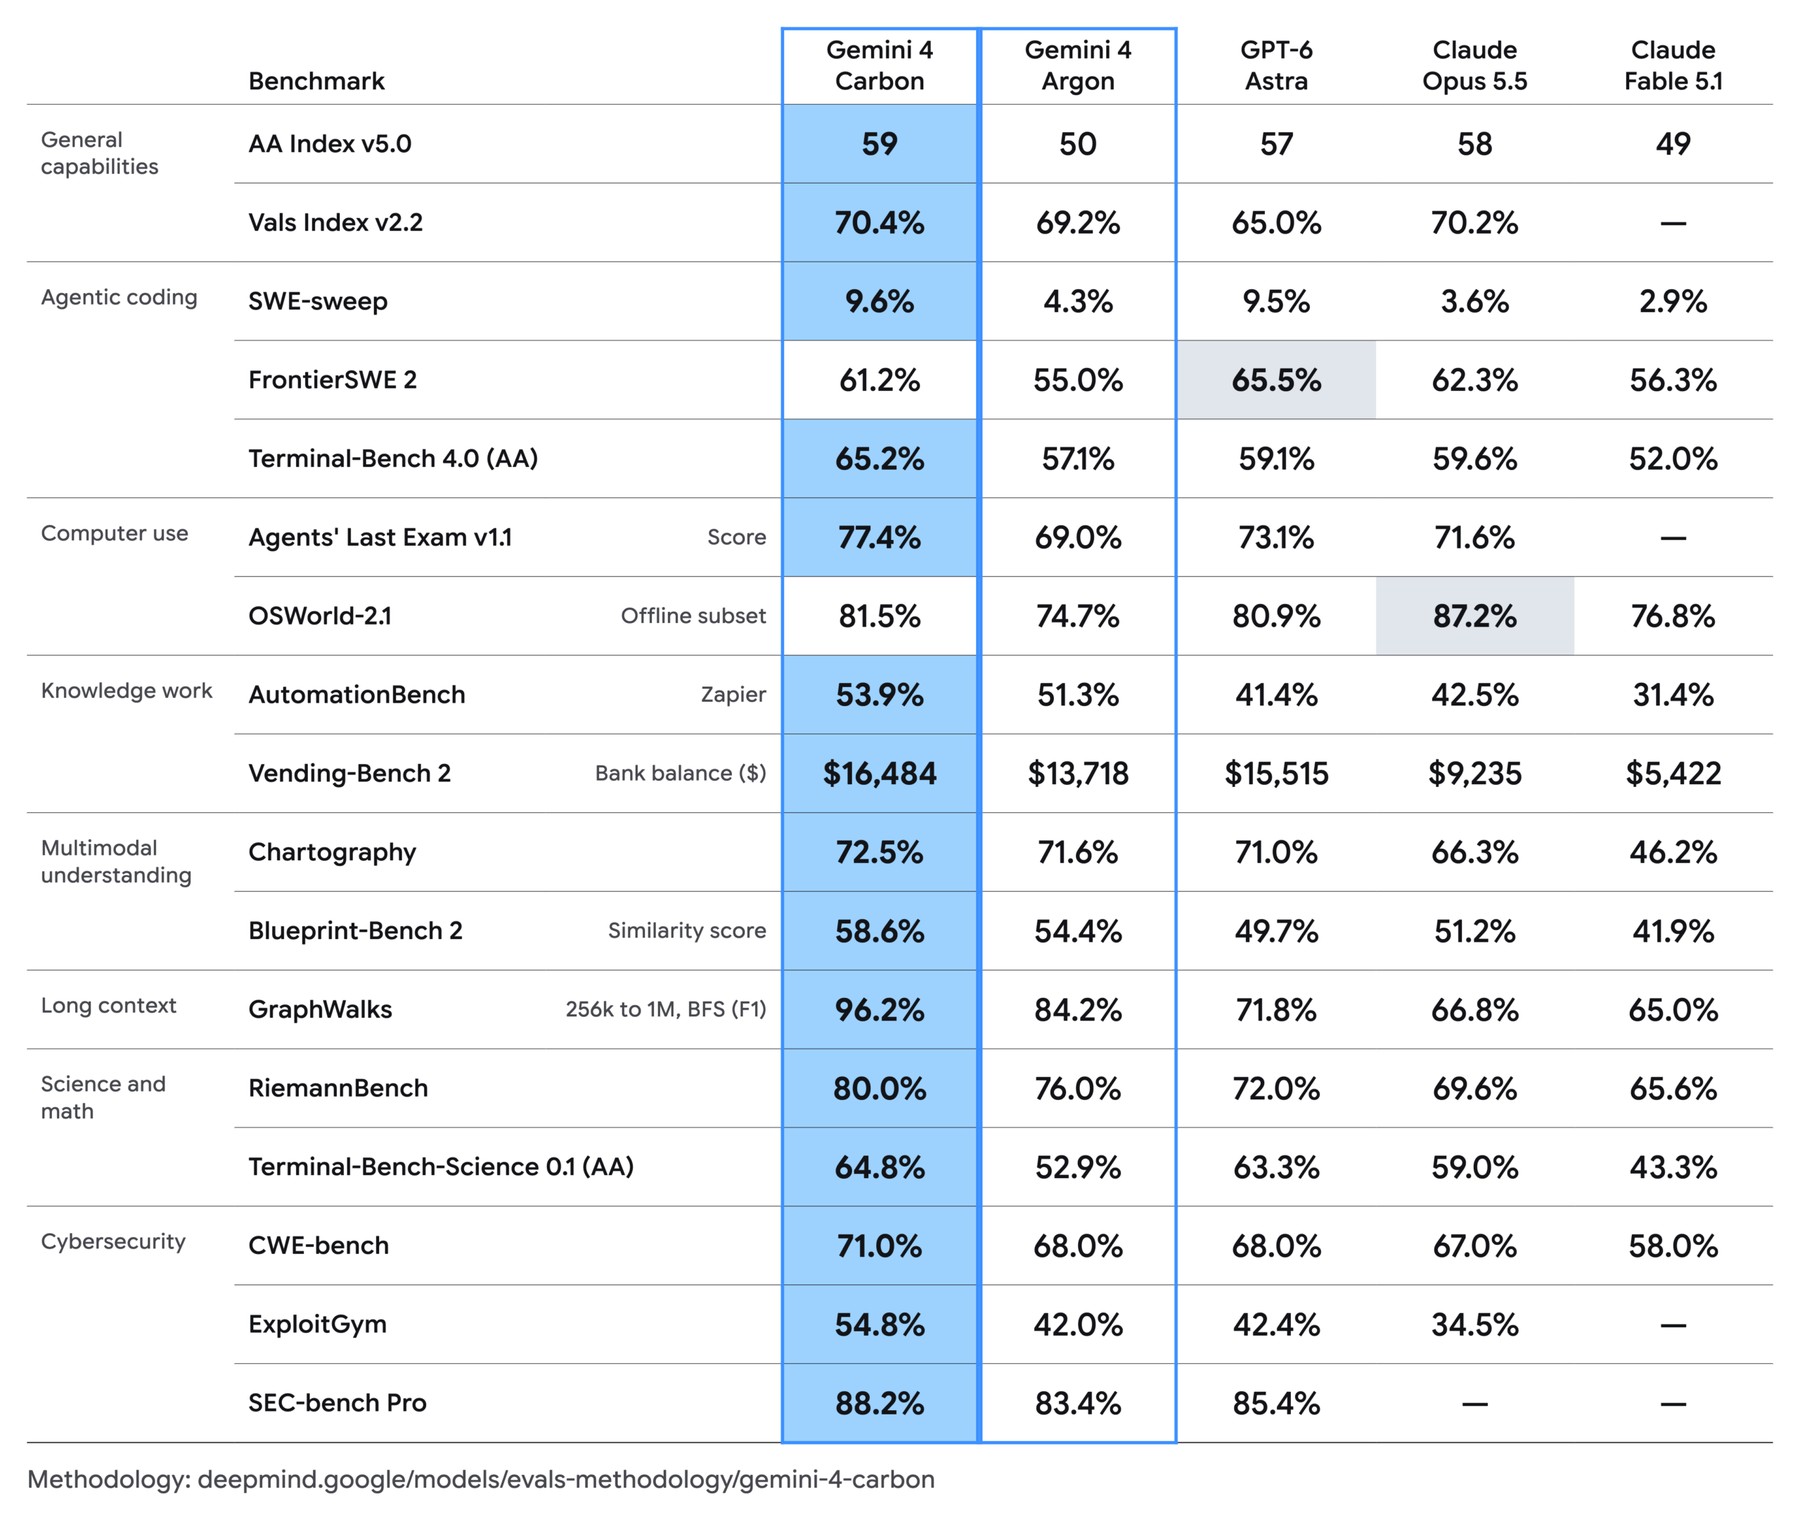
В собственной подборке тестов Google Gemini 4 Carbon занимает первое место в 15 из 16 тестов, особенно отрываясь от остальных в задачах с длинным контекстом и задачах безопасности
Источник: the-decoder.com
Платформа Vals AI поставила Carbon на второе место с точностью 70,36%. Выше оказалась Claude Sonnet 5.5 с 70,85%, ниже — Claude Opus 5.5 с 70,18% и Argon на четвёртом месте с 69,24%. Все три модели работают дешевле Carbon.
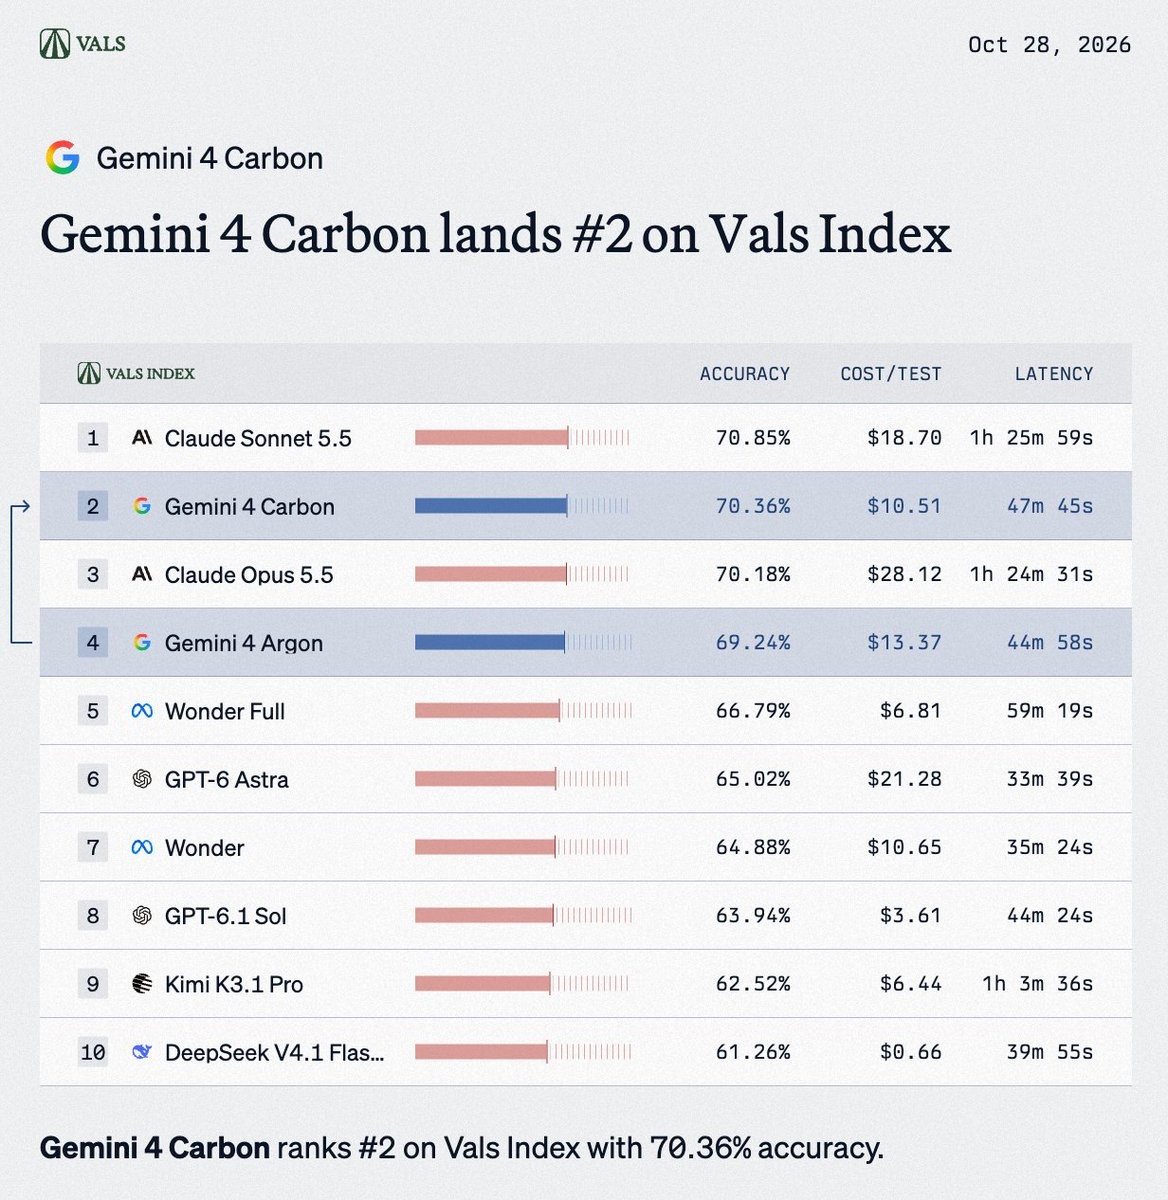
В Vals Index v2.2 Gemini 4 Carbon с точностью 70,36% занимает промежуточное место между Claude Sonnet 5.5 (70,85%) и Claude Opus 5.5 (70,18%). При стоимости $10,51 за тест и времени выполнения чуть менее 48 минут он работает дешевле и быстрее обеих моделей Anthropic
Источник: the-decoder.com
На Vals.ai Carbon также лидирует в Finance Index и бенчмарке Legal Research. В юридических исследованиях Vals AI зафиксировала примерно на 45% больше цитируемых источников, более частые вызовы инструментов и более длинные ответы, чем у Argon.
При этом задачи из бенчмарка Finance and Tax Agent занимают у Carbon более чем вдвое больше времени, чем у Argon, а одна задача Legal Research в среднем длится больше 50 минут. Модель генерирует в 2,3 раза больше токенов рассуждений и на 64% больше токенов ответа, чем Argon. Но объём ответа всё ещё меньше половины от показателей Sonnet 5.5 и Opus 5.5.
На Arena.ai версия Gemini 4 Carbon (High) возглавила Text Arena с 1 528 баллами, опередив Argon с 1 520. В Agent Arena модель заняла второе место по итогам более 21 900 реальных сессий — выше GPT-6 Astra и Fable-5.1. Её общий прирост составил 16,2%, а показатель управляемости стал самым высоким: плюс 18,6%. Медианная стоимость задачи — 1,80 доллара, на 72% ниже, чем у лидера рейтинга Claude Opus 5.5 (Max).
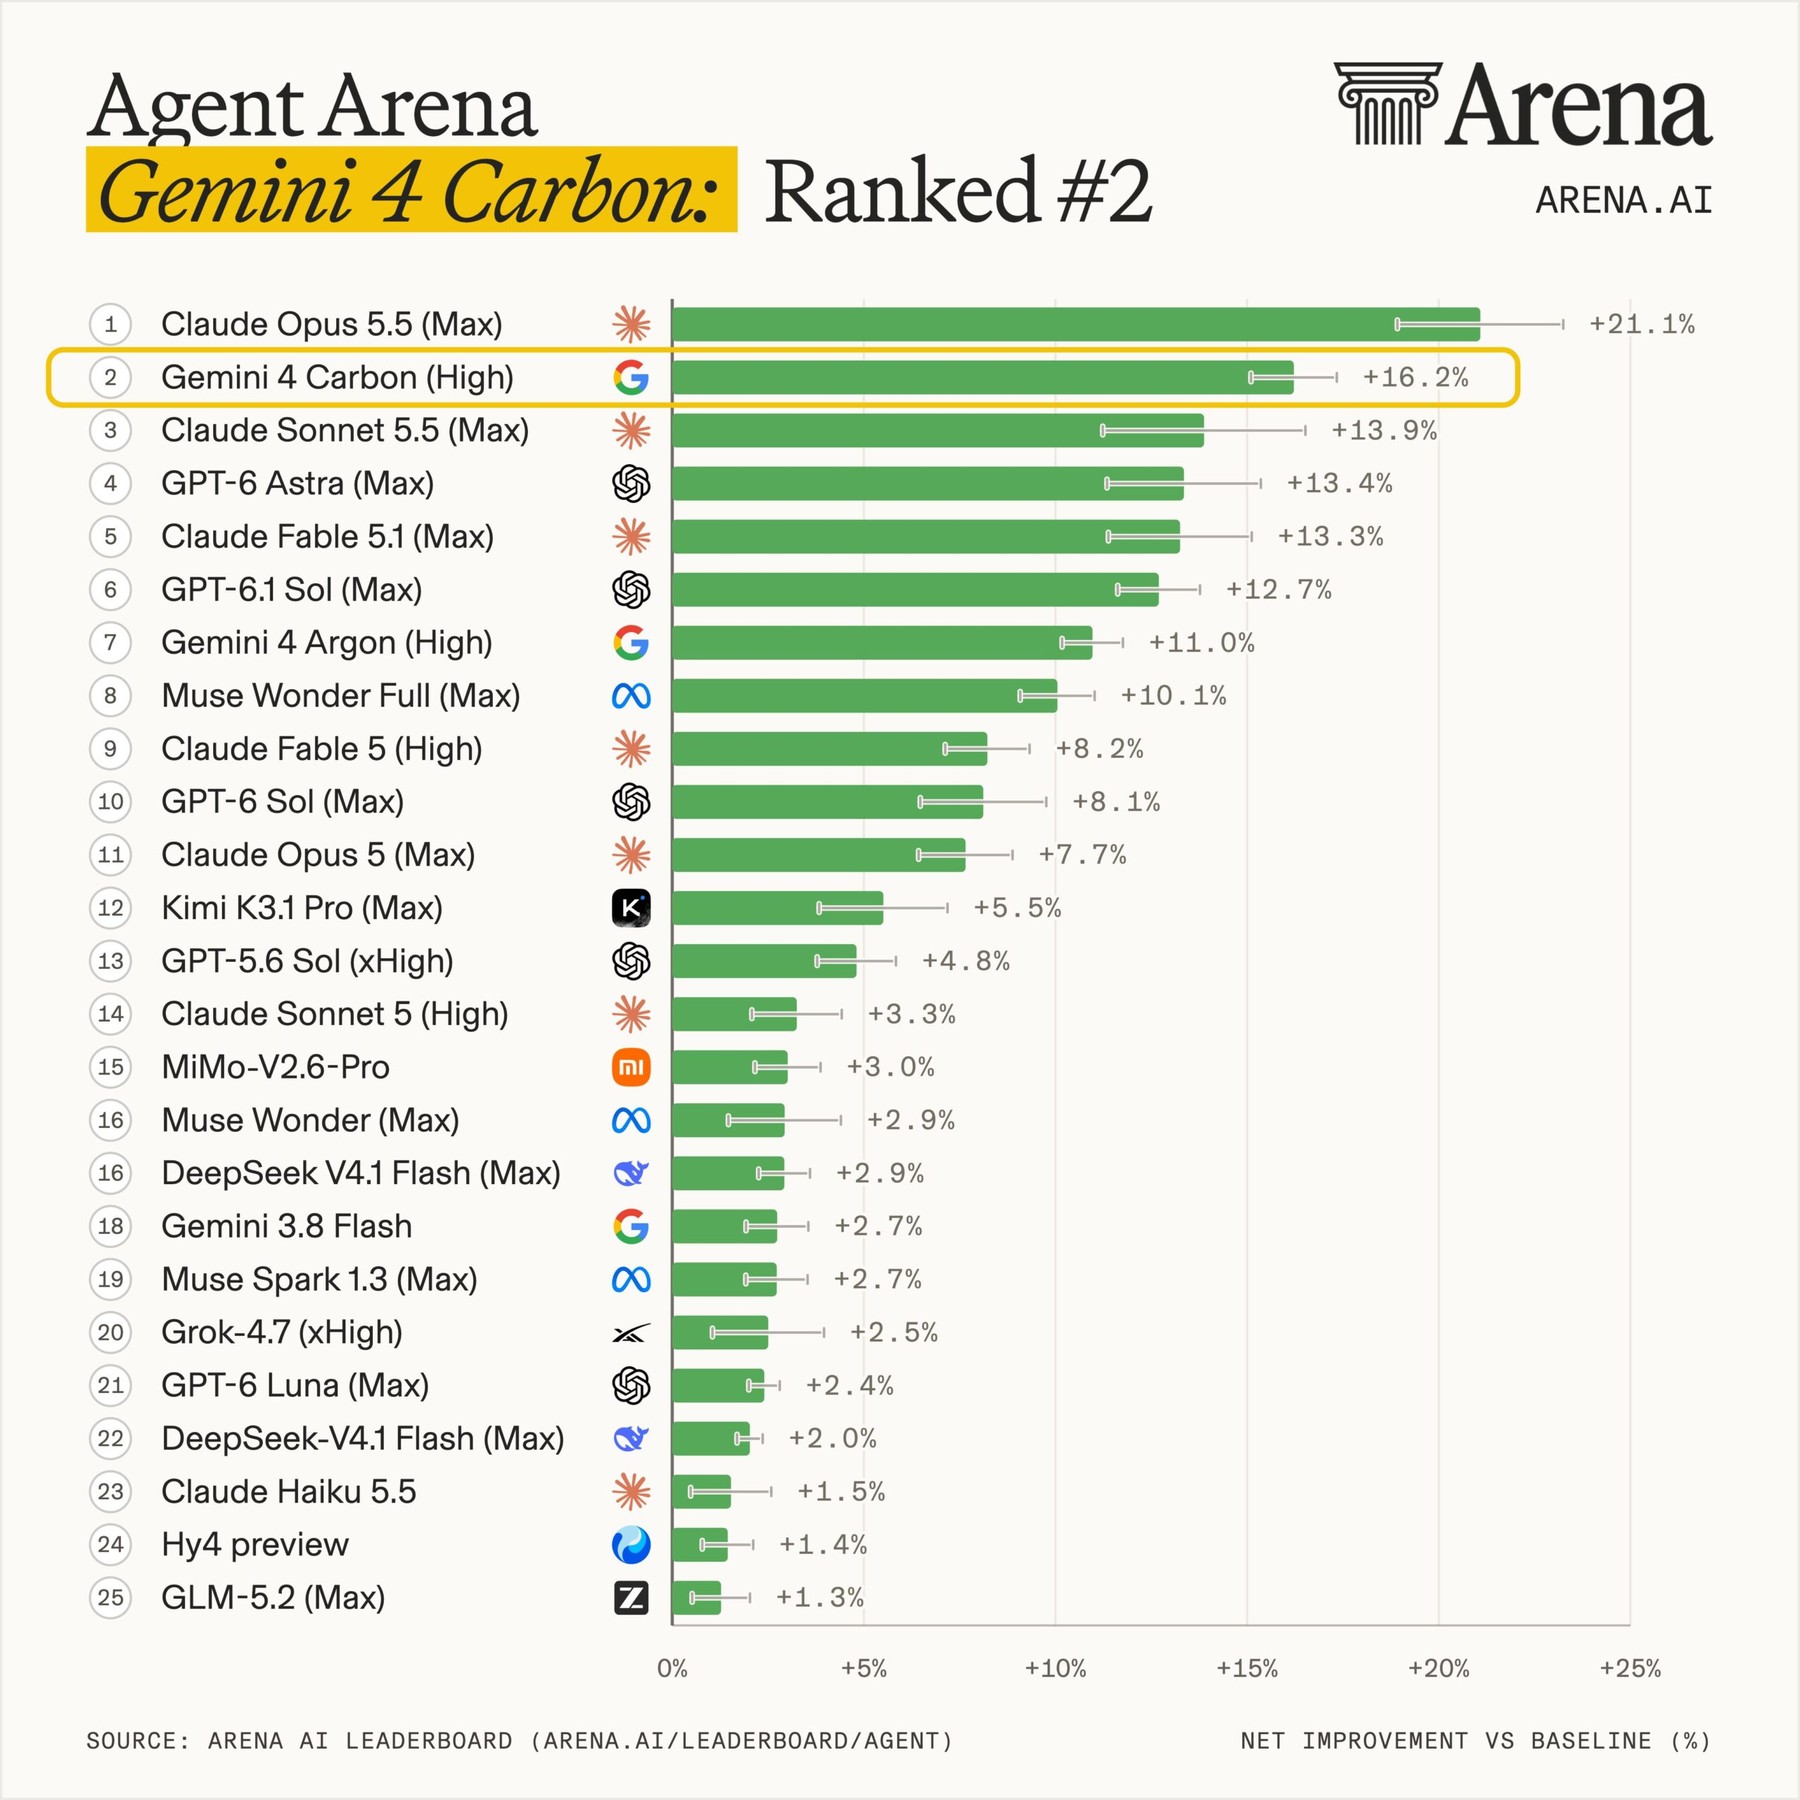
Arena.ai ставит Gemini 4 Carbon (High) на второе место в Agent Arena с чистым улучшением на +16,2%, после Claude Opus 5.5 (Max, +21,1%) и впереди GPT-6 Astra (Max, +13,4%)
Источник: the-decoder.com
В категории WebDev на Code Arena Carbon набрала 1 768 баллов — на 89 больше, чем Argon, занявшая одиннадцатое место. Это четвёртый результат в общем зачёте, всего на два балла ниже Claude Sonnet 5.5 (xHigh) с 1 770. По словам Artificial Analysis, модель оказалась на кривой Парето по всем трём направлениям.
Carbon лидирует в тестах безопасности без защитных ограничений
Для ряда проверок безопасности Google запускала модель без защитных ограничений. В SEC-bench Pro, который измеряет способность самостоятельно находить уязвимости в реальном программном обеспечении, Carbon набрала 88,2% и опередила все протестированные модели. В ExploitGym, где проверяют, может ли система превратить найденную уязвимость в работающий эксплойт, результат составил 54,8%. В написании исправлений для уязвимостей CWE-Bench Carbon также уверенно заняла первое место.
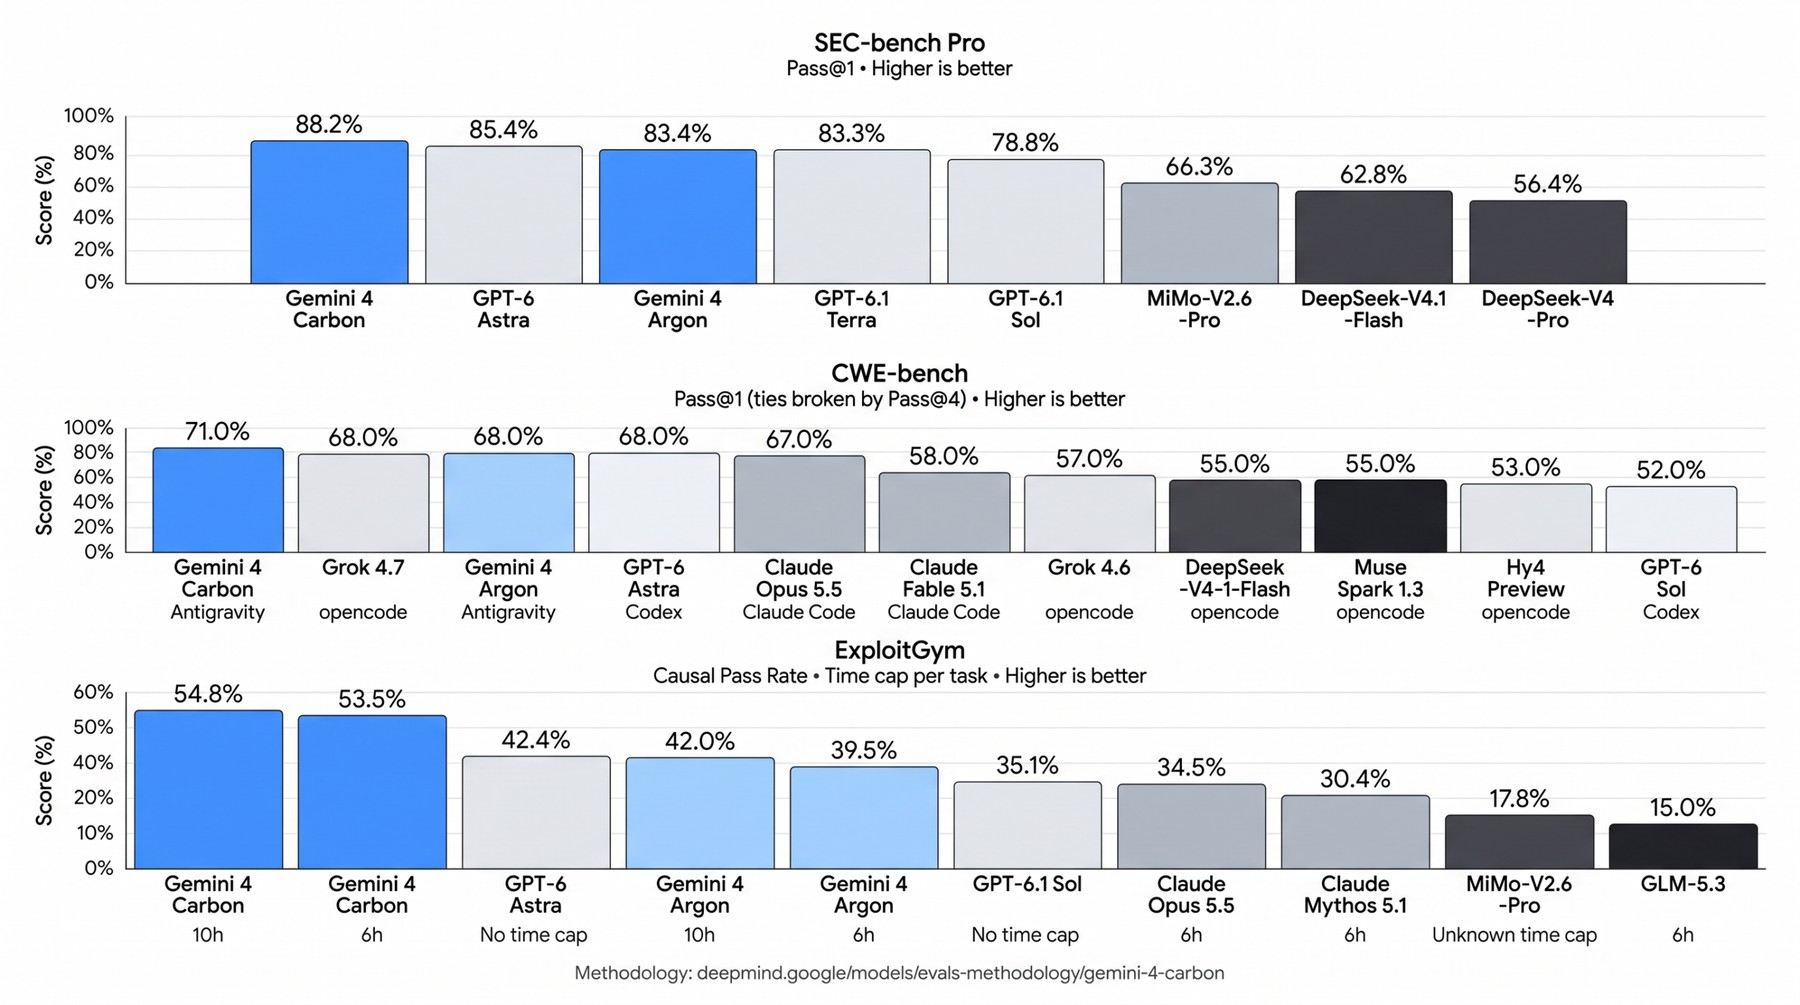
В SEC-bench Pro (88,2%), CWE-bench (71,0%) и ExploitGym (54,8% при времени выполнения десять часов) Gemini 4 Carbon опережает и GPT-6 Astra, и предшественника Argon
Источник: the-decoder.com
Google приводит и внутренние результаты, которые нельзя проверить независимо. По данным компании, на собственных бенчмарках Carbon создаёт безопасный код более чем вдвое чаще, чем Argon. В тестах команды Chrome модель показала результат в написании исправлений безопасности более чем в десять раз выше, чем передовая модель неназванного конкурента.
Сначала доступ получат эксперты по безопасности
Google будет постепенно открывать доступ к модели и участвует в программе предварительного тестирования правительства США, ссылаясь на продвинутые возможности Carbon в сфере кибербезопасности. С этой недели модель начнут предоставлять отдельным экспертам по кибербезопасности. Затем доступ расширят на других проверенных партнёров через программу Fairwind от Google DeepMind.
Компания планирует открыть модель разработчикам, бизнесу и обычным пользователям через интерфейсы своих продуктов после сбора дополнительных отзывов и настройки защитных ограничений.
Стартовые цены Gemini 4 Carbon совпадают с ценами Argon: 2 доллара за миллион входных токенов и 10 долларов за миллион выходных. На кэшированные входные токены действует скидка 95% от обычной цены входных токенов.
По расчётам Artificial Analysis, одна задача обходится с Carbon в 7,76 доллара в Intelligence Index — примерно на 23% дешевле, чем с Claude Opus 5.5 (max), где стоимость составляет 10,04 доллара, и примерно в 1,2 раза дороже, чем с GPT-6 Astra (max) за 6,25 доллара. В среднем Carbon расходует 123 000 выходных токенов на задачу — на 29% меньше, чем модель Anthropic с её 173 000 токенов. Стоимость почти совпадает с Argon: 7,68 доллара за задачу.
Artificial Analysis рассчитывает стоимость по обычным тарифам: 4 доллара за миллион входных токенов и 20 долларов за миллион выходных, плюс 0,20 доллара за миллион кэшированных входных токенов. В расчётах не учитывается временная скидка 50%, действующая до конца 2026 года.
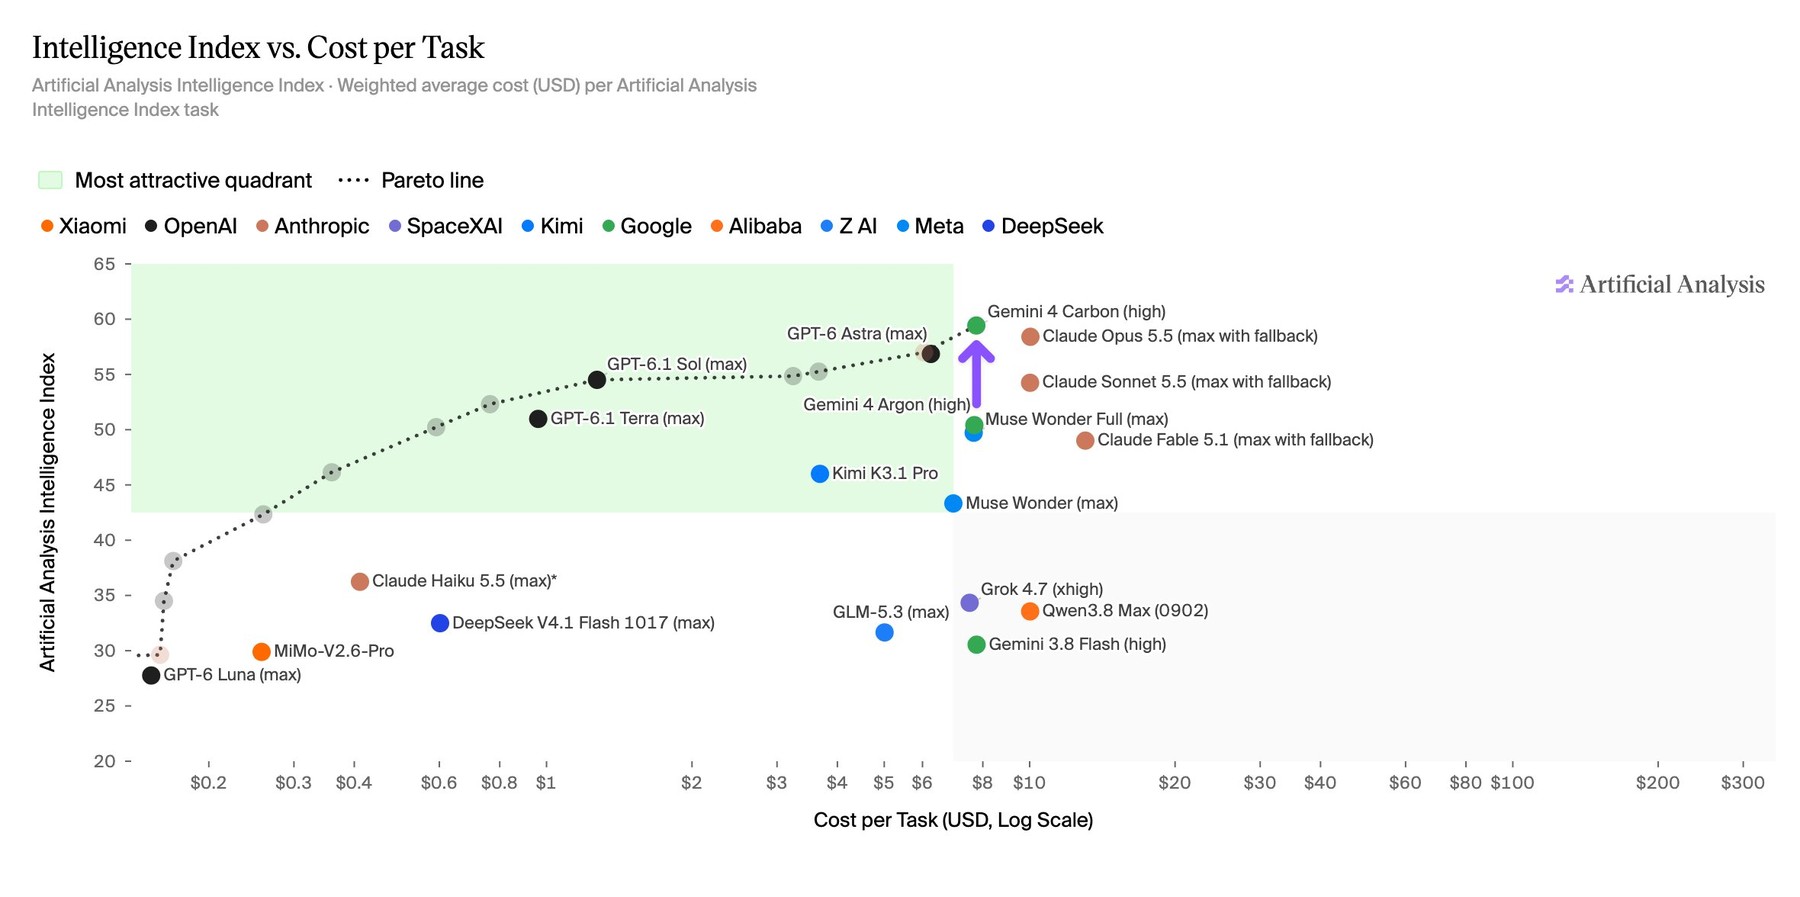
При почти такой же стоимости за задачу, как у Argon ($7,76 против $7,68), Gemini 4 Carbon поднимается на девять пунктов, до 59, приближаясь к вершине кривой Парето и также превосходя более дорогую Claude Opus 5.5 ($10,04)
Источник: the-decoder.com
Читайте также
 Женщина умерла после того, как ChatGPT убедил её снизить дозу назначенного врачом лекарства
 General Compute привлекла $100 млн в раунде серии A, бросив вызов нарративу о крахе неооблаков
 Salesforce дополняет Agent Fabric ИИ-проверками, которые отключают сбойных агентов
 Google открыла Android для сторонних ИИ-агентов и представила новые API Gemini
 Стартап, связанный с Илоном Маском, утверждает, что его ИИ-агенты взломали Anthropic за несколько часов
 Первые результаты: как Claude ускоряет разработку лекарств
 Лаборатории передового ИИ заявили, что их модели опровергли гипотезу экспоненциального времени. Что это значит?
 Nvidia и Oracle расширяют облачную инфраструктуру Vera Rubin, обещая эффективнее загружать GPU, простаивающие у корпоративных клиентов
 Claude for Legal автоматически проверяет источники, а затем передаёт файл юристу
 Ведущий исследователь безопасности ИИ заявил, что перестал копить на пенсию, потому что уверен: мы все погибнем
 Anthropic расширила партнёрство с GSA, чтобы предоставить Claude всем уровням власти США
 Genie 4 от Google добавила звук, более реалистичные миры и управление сценой в реальном времени
 Новые модели LFM3 от Liquid AI переносят браузерных агентов, голосовые команды и распознавание изображений на локальные устройства
 Обзор «Стен замка»: на Prime вышел первый полностью созданный ИИ сериал — размазанная вазелином каша
 OpenAI дразнит Европу скорым запуском Dots, но DevDay в Берлине был посвящён созданию платформы
 Шарнир складного iPhone, который постоянно ломается, «создали с помощью ИИ»
 Anthropic расширяет программу AI for Science на фонды и научные учреждения
 Обнаружит ли ИИ, насколько хлипко устроена интернет-инфраструктура?
 r/opensource на Reddit запретил все проекты, связанные с ИИ, вызвав волну критики и появление конкурирующего форума
 SpaceX заключила с Apollo сделку на $40 млрд по финансированию закупки графических процессоров
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram