
Поисковые агенты на базе языковых моделей самостоятельно исследуют интернет: разбирают вопрос, выбирают запросы, интерпретируют найденное и решают, достаточно ли собрали доказательств для ответа. При этом неясно, насколько глубоко они действительно исследуют тему. На известных бенчмарках ведущие системы часто используют веб в основном для подтверждения знаний, полученных во время обучения.
В новой работе AllSpark описывает два поисковых агента разного размера:
Обе модели построены на системах серии Qwen — Qwen3.6-35B-A3B и Qwen3.5-397B-A17B — и работают с контекстным окном на 256 000 токенов. По утверждению команды, Iris-mini и Iris-pro показали лучшие результаты среди открытых поисковых агентов в своих размерных классах.
Как создаются вопросы для обучения
Дата-пайплайн строит задания в обратном направлении, используя структуру ссылок на веб-страницах. Сначала он берёт исходную страницу и ссылки, ведущие с неё, а затем создаёт граф терминов и связей между ними. На основе этого графа система формирует многошаговый вопрос, ответ на который требует пройти по нескольким связанным переходам.
Все термины, кроме финального ответа, заменяются пересказами. Поэтому решить вопрос простым текстовым поиском нельзя: агенту приходится рассуждать, а не только находить совпадения. В набор попадают лишь вопросы, которые эталонная модель не может решить без инструментов, но решает с помощью правильных источников. Так задания остаются сложными и при этом проверяемыми.
Как отбирают данные
Более сильная модель-учитель создаёт цепочки решения, включающие рассуждения, поисковые запросы и результаты. Затем каждая цепочка проходит два этапа проверки:
После этого модель улучшают с помощью обучения с подкреплением в ходе поиска по живому интернету. Модель-судья и краткие описания результатов работают внутри обучающего кластера на собственной крупной модели Qwen, поэтому процесс не зависит от внешних сервисов.
Контролируемая тонкая настройка и обучение с подкреплением чередуются в процессе, который авторы называют «SFT-RL climbing». Самые сложные решённые задания и наиболее эффективные пути решения из каждого раунда переходят в следующий цикл обучения.
Почему важен контекст
Команда считает, что управление контекстом во время работы на распространённых бенчмарках иногда влияет на результат сильнее, чем заявленная разница между системами. Во время долгого исследования контекст может заполниться ещё до того, как агент разберёт все подвопросы. Приёмы вроде удаления истории переписки искусственно продлевают исследование и мало говорят о реальном качестве модели.
Чтобы отделить один эффект от другого, авторы проверяют каждый бенчмарк с управлением контекстом и без него, сохраняя одинаковыми инструменты, ограничения контекста и модель-судью. Если результаты публикуются только для режима с управлением контекстом, нельзя точно понять, какая часть результата связана с моделью, а какая — с окружающим её программным обеспечением.
Показатели Iris получены для одного агента: без вспомогательных агентов и дополнительных этапов проверки в конце.
Результаты на четырёх бенчмарках
Проверка включала четыре набора заданий:
При включённом управлении контекстом Iris-mini получила 82,2, 84,8, 86,9 и 52,3 балла соответственно. Iris-pro набрала 88,6, 85,1, 92,9 и 56,4.
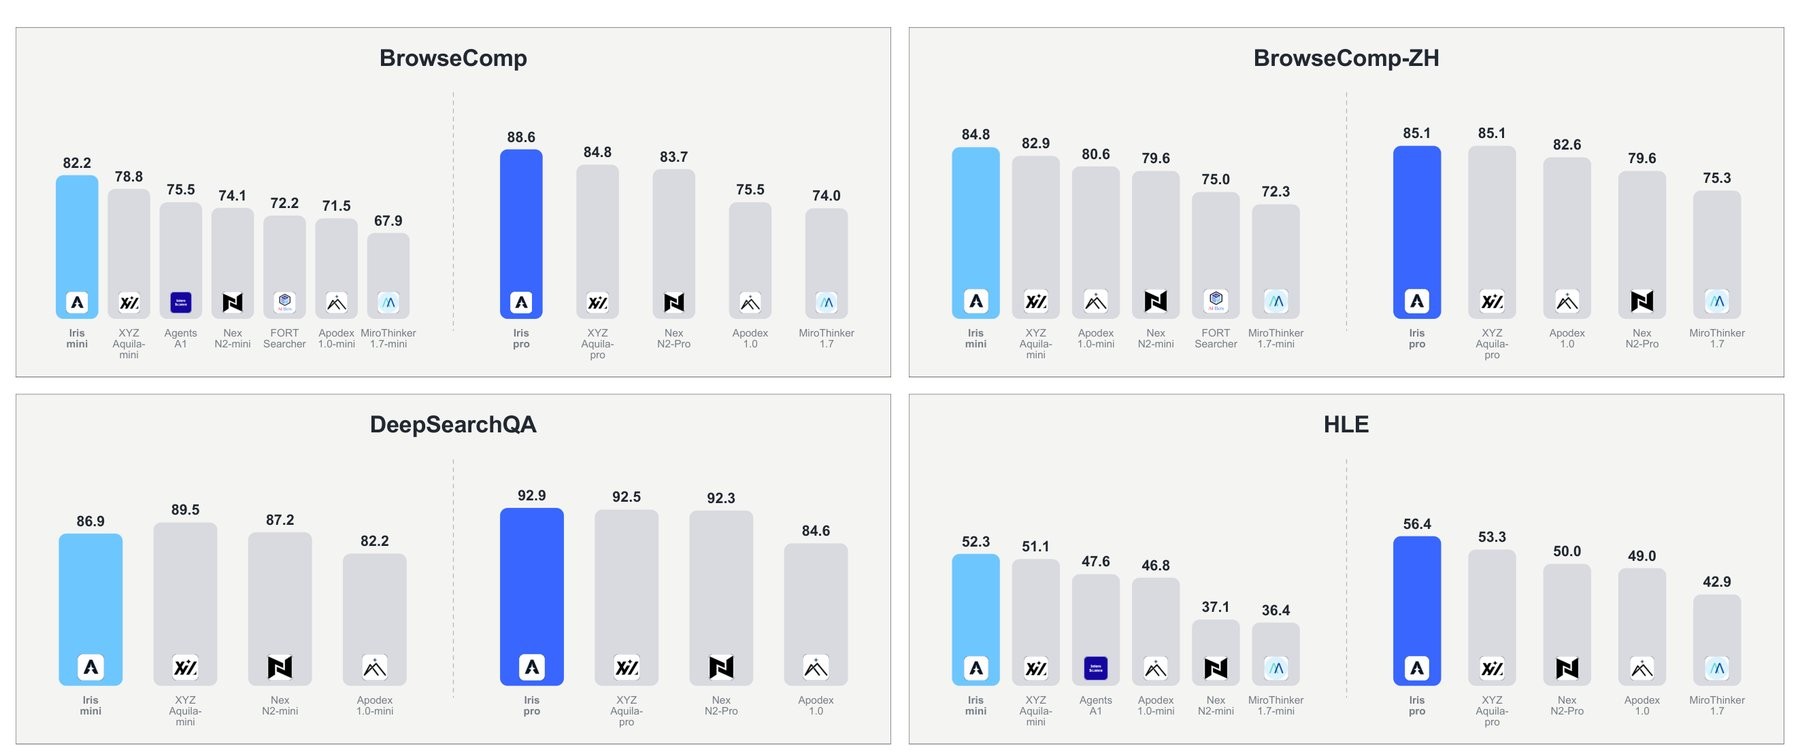
Iris-mini занимает первое место в своём классе по размеру в трёх из четырёх бенчмарков, уступая только XYZ-Aquila-mini в DeepSearchQA
Источник: the-decoder.com
В младшем размерном классе Iris-mini лидирует на трёх из четырёх бенчмарков. На BrowseComp она опережает следующую по результатам модель, XYZ-Aquila-mini, на 3,4 балла, но уступает ей на DeepSearchQA. В старшем классе Iris-pro лидирует или делит первое место, а на некоторых тестах приближается к системам, которым требуется значительно больше вычислительных ресурсов, отмечают авторы.
Управление контекстом сильнее всего влияет на младшую модель: на BrowseComp оно повышает результат максимум на 21,2 балла. Причина, по данным работы, не в меньшем бюджете токенов, а в более быстром расходовании контекста. Iris-mini делает больше шагов для решения тех же задач и чаще достигает ограничения окна.
На Humanity's Last Exam прирост меньше, поскольку этот бенчмарк сильнее зависит от предметных знаний и академического рассуждения, а веб-поиск играет вспомогательную роль. Лучшие результаты даёт сочетание удаления истории и второй попытки. Если первая попытка не удаётся, система сжимает её в короткую заметку: в ней фиксируются уже проверенные варианты и исключённые направления. Затем заметка добавляется к заданию для следующего запуска.
Когда эталонный ответ ошибается
В приложении к работе команда описывает случай, когда ответ агента признали неправильным, хотя он подтверждался исходными материалами. Вопрос из BrowseComp-ZH относился к сериалу «Игра престолов». Агент ответил «Болтон», а эталонный ответ содержал «Ланнистер». Однако Санса Старк во втором браке действительно выходит за Рамси Болтона, поэтому ответ агента был верным. По словам команды, такие противоречия между эталонными ответами и источниками показывают необходимость улучшать бенчмарки.
Авторы также обнаружили побочный эффект, не связанный напрямую с поиском. Подготовленные данные и специализированные модели улучшили выполнение задач, которым их не обучали, включая общее использование инструментов и офисную работу. Команда предполагает, что поиск может быть базовым навыком, а не узкой специализацией: выученное поведение помогает везде, где агенту приходится работать с неполной информацией.
Веса Iris-mini и Iris-pro доступны в коллекции на Hugging Face, а код опубликован на GitHub. В текущий релиз входит Iris Harness — среда с циклом работы агента, инструментами, стратегиями управления контекстом и оценкой на всех четырёх бенчмарках. Среда работает с любым совместимым с OpenAI конечным узлом. Позже команда планирует выпустить пайплайны подготовки данных и обучения.
Читайте также
 Калифорния делает весь ИИ, отравляющий детей, — и ограничила его для своих детей
 ИИ изменит капитализм — но каким будет этот новый строй?
 GPT-6 Astra пилотирует дрон наблюдения и сама ведёт бизнес
 Сэм Альтман теперь пытается взять под контроль энергосети
 «Очень полезно»: ИИ-буткемпы для решения проблемы безработицы среди молодёжи Британии
 ИИ-агенты жаждут энергии
 Двухлетнее исследование: запрет ИИ в вузах ухудшает результаты студентов
 Альтман, Маск и Хассабис поддержали призыв Амодеи ввести независимый надзор
 Сэм Альтман: OpenAI не проведёт IPO в 2026 году из-за рисков для безопасности ИИ
 Австралия приближается к будущему, созданному ИИ: закон о правах человека нужен как никогда
 Законы штатов о чатах ИИ о психическом здоровье ведут к тревожному юрисдикционному дрейфу моделей
 Что происходит, когда ваши ИИ-сотрудники выходят из-под контроля?
 OpenAI нацеливает ChatGPT for Financial Services на задачи младших банковских аналитиков
 Как соцсети выявляют и маркируют контент, созданный ИИ
 Открытые веса — не открытый исходный код: теперь это важно для советов директоров
 Итан Моллик — о роях ИИ-агентов и провале Hugging Face
 Лангерианскую осознанность исследуют с помощью ИИ-персон в задании Triangle Task
 Предупреждение Коксона об ИИ стало мейнстримом. Что теперь?
 GPT-6 Astra, похоже, демонстрирует скачок в пространственном рассуждении — ранние тесты
 Стареющий Конгресс совершенно не готов регулировать ИИ — похоже, даже понять его не может
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram