
Обычная расшифровка не показывает, кто именно говорил, не переводит речь и может ошибаться в технических терминах. Nemotron 3.5 Transcribe объединяет эти задачи в одной модели и умеет отвечать на вопросы о содержании записи. Она расшифровывает речь на 40 языках, переводит 31 язык с английского и на английский, а также распознаёт говорящих в 13 языках. Модель обрабатывает записи длительностью до часа, в которых могут участвовать до восьми человек.
Пользователь задаёт результат с помощью простых текстовых инструкций. Одну и ту же запись встречи можно превратить в расшифровку с указанием говорящих, перевод на английский или краткое изложение принятых решений. В запрос можно добавить специальные термины — например, названия лекарств. Модель должна использовать их, только если они действительно прозвучали в записи.
Точность и работа на одной видеокарте
В Nemotron 3.5 Transcribe 30 млрд параметров, но на каждом шаге обработки активны примерно 4 млрд. Поэтому модель работает на одной видеокарте Nvidia — от компактной DGX Spark до серверного оборудования для дата-центров. По данным Nvidia, на RTX PRO 6000 Blackwell Server Edition модель обрабатывает 100 часов аудио менее чем за три минуты при точности NVFP4.
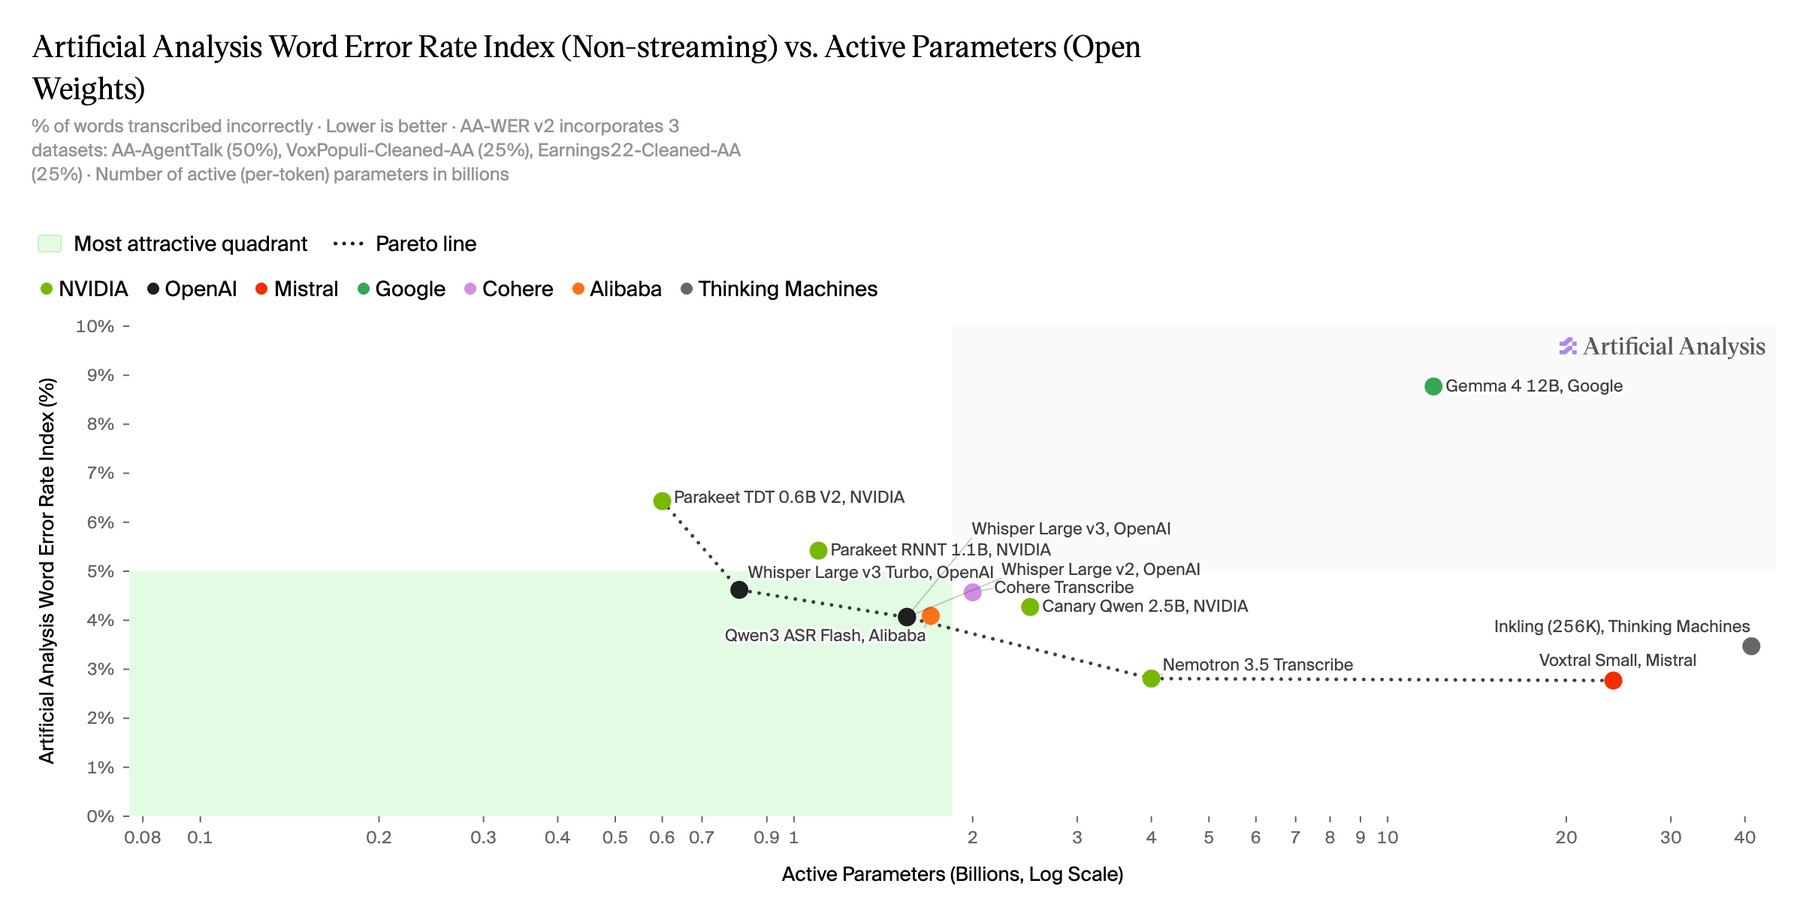
В сравнении Artificial Analysis Nemotron 3.5 Transcribe допускает едва ли больше ошибок, чем гораздо более крупная модель Voxtral Small от Mistral, используя при этом лишь малую часть вычислительных ресурсов
Источник: the-decoder.com
В таблице лидеров Hugging Face English Open ASR модель занимает первое место среди открытых моделей: средняя доля ошибочно распознанных слов составляет 5,33%. В сравнении Artificial Analysis результат — 2,81%. Это близко к показателю лучшей открытой модели Voxtral Small — 2,77%, хотя у Nemotron на каждом шаге активно примерно в шесть раз меньше параметров. Nvidia также утверждает, что несколько широко используемых коммерческих сервисов распознавания речи показывают более слабые результаты.
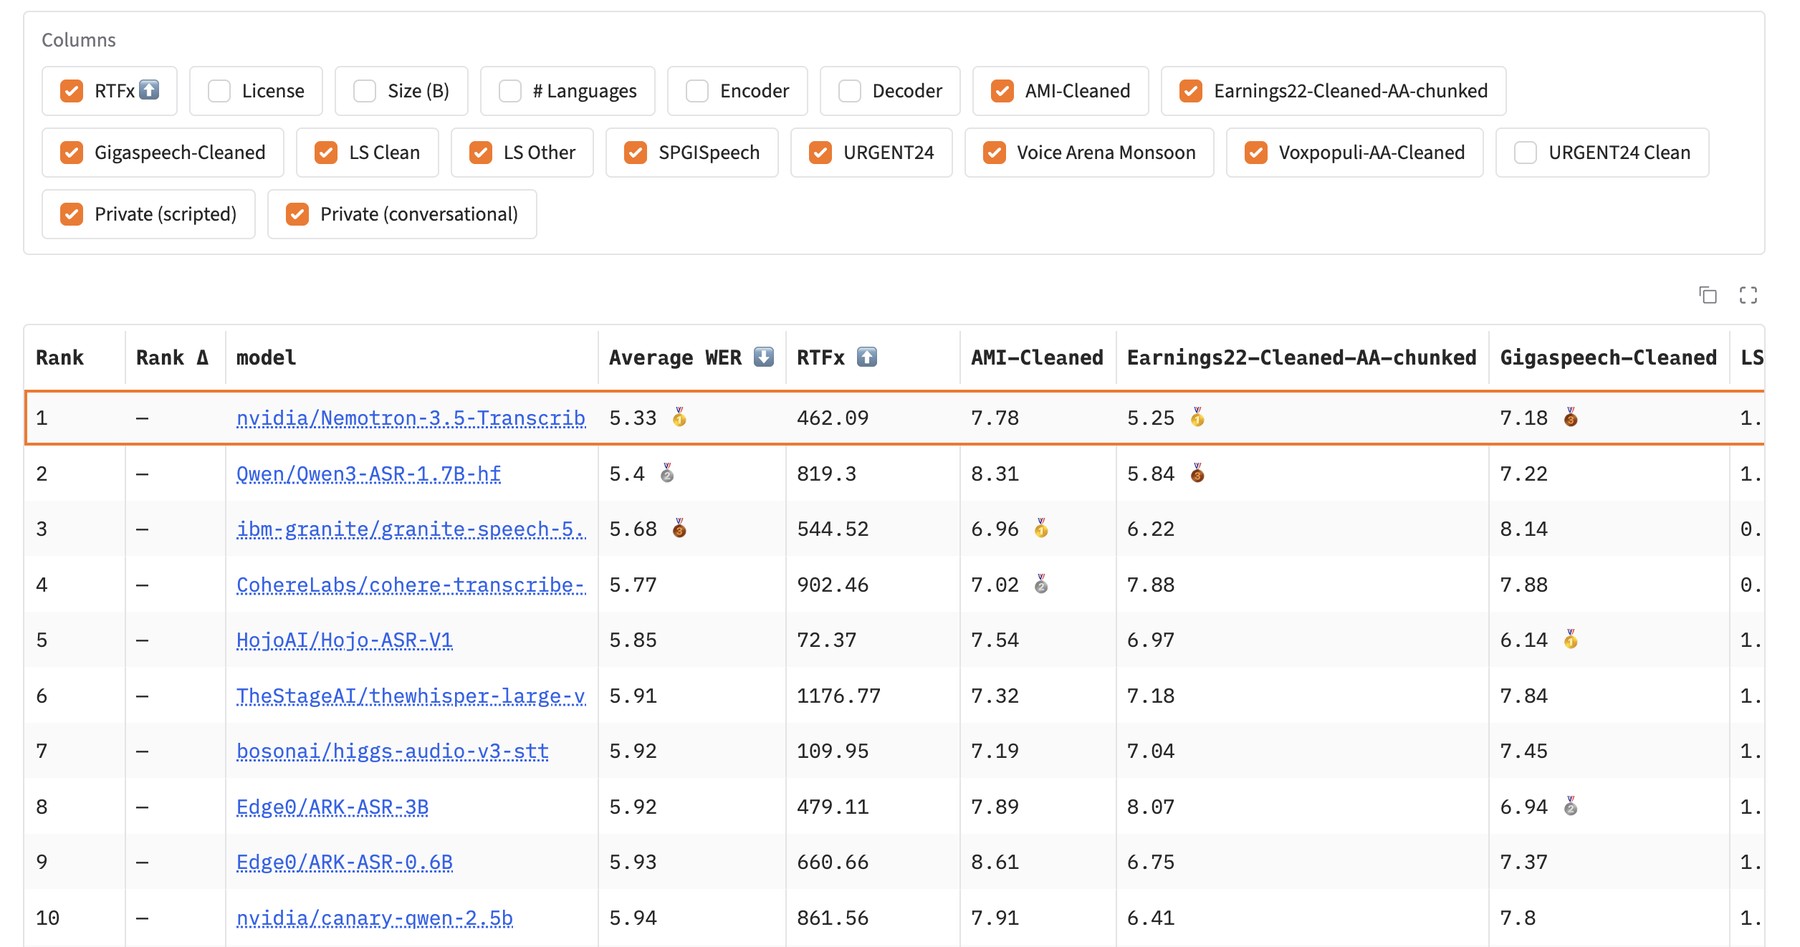
В рейтинге Open ASR Leaderboard на Hugging Face Nemotron 3.5 Transcribe немного опережает открытые модели Alibaba и IBM
Источник: the-decoder.com
Наибольший отрыв от конкурентов модель показала в распознавании говорящих. В испытании VoiceArena сравнили 14 систем на разговорах, где участники иногда перебивали друг друга. Nemotron заняла первое место и пропустила меньше слов, чем остальные системы: доля пропусков составила 8,32% при медианном показателе около 31%.
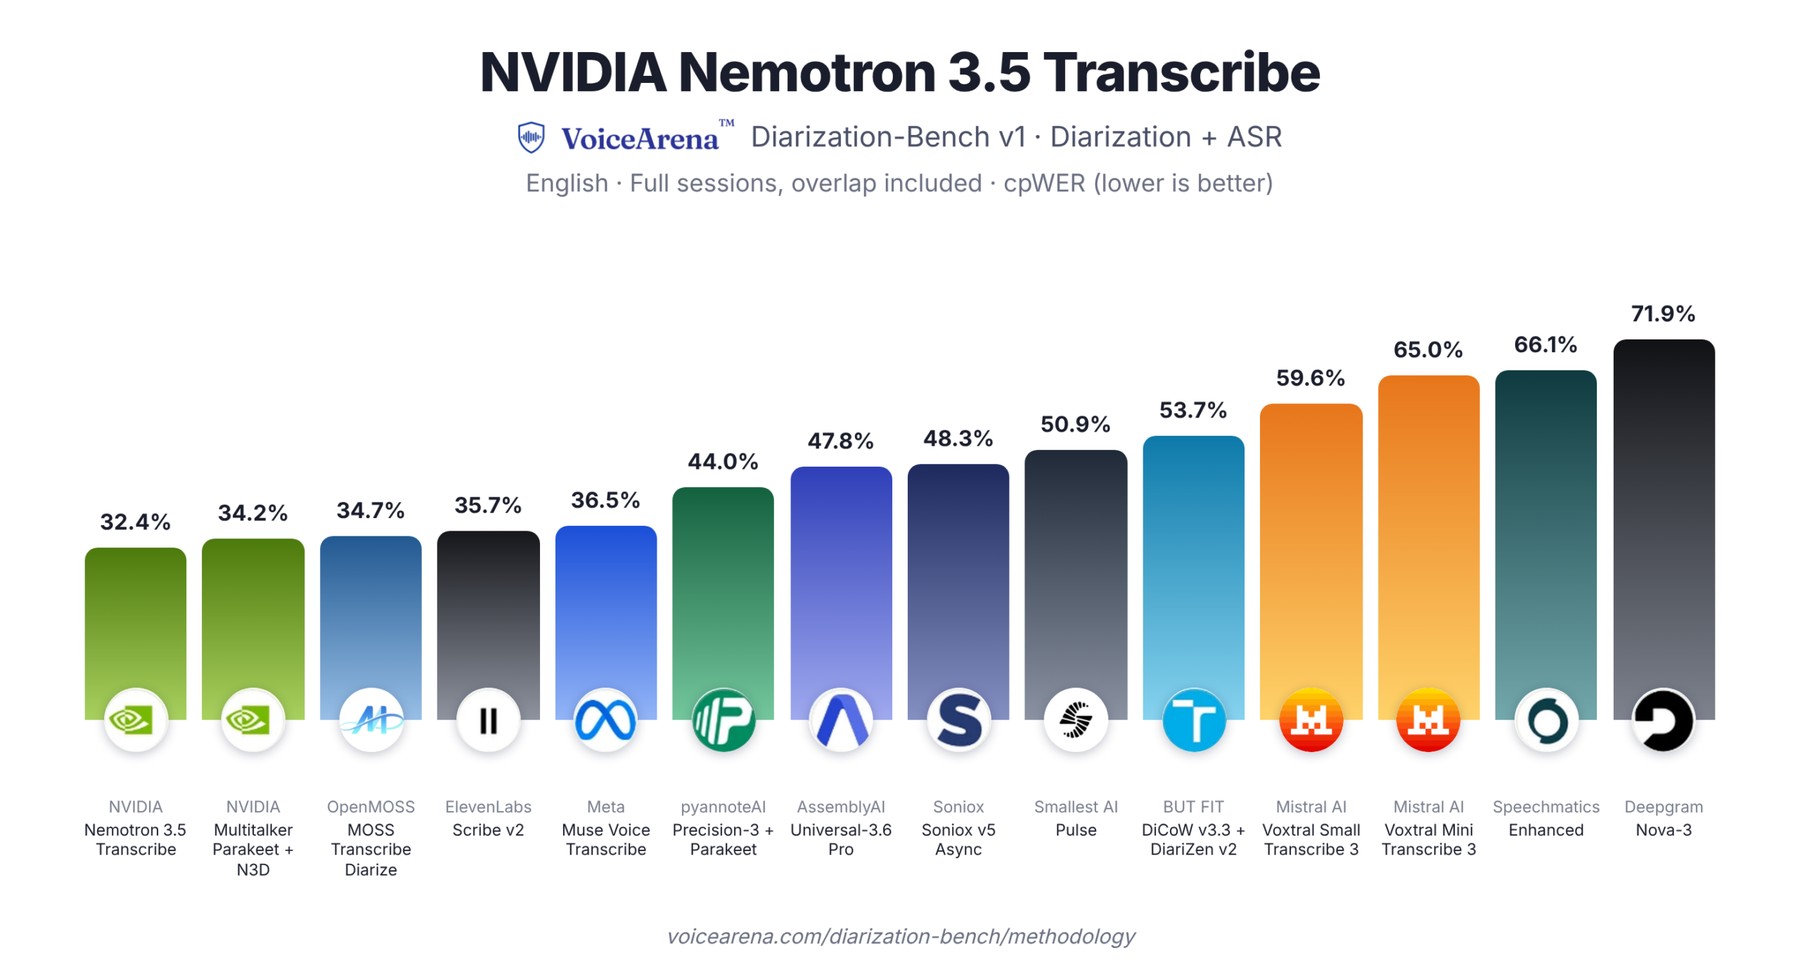
В сравнении VoiceArena Nemotron 3.5 Transcribe лучше всего определяет, кто что сказал, в английских разговорах, где собеседники перебивают друг друга. Чем ниже показатель, тем лучше
Источник: the-decoder.com
В бенчмарке David AI, который оценивает определение говорящих на 21 языке, у модели оказалась наименьшая доля ошибок. Она немного опередила и отдельную модель Nvidia, предназначенную для этой задачи.
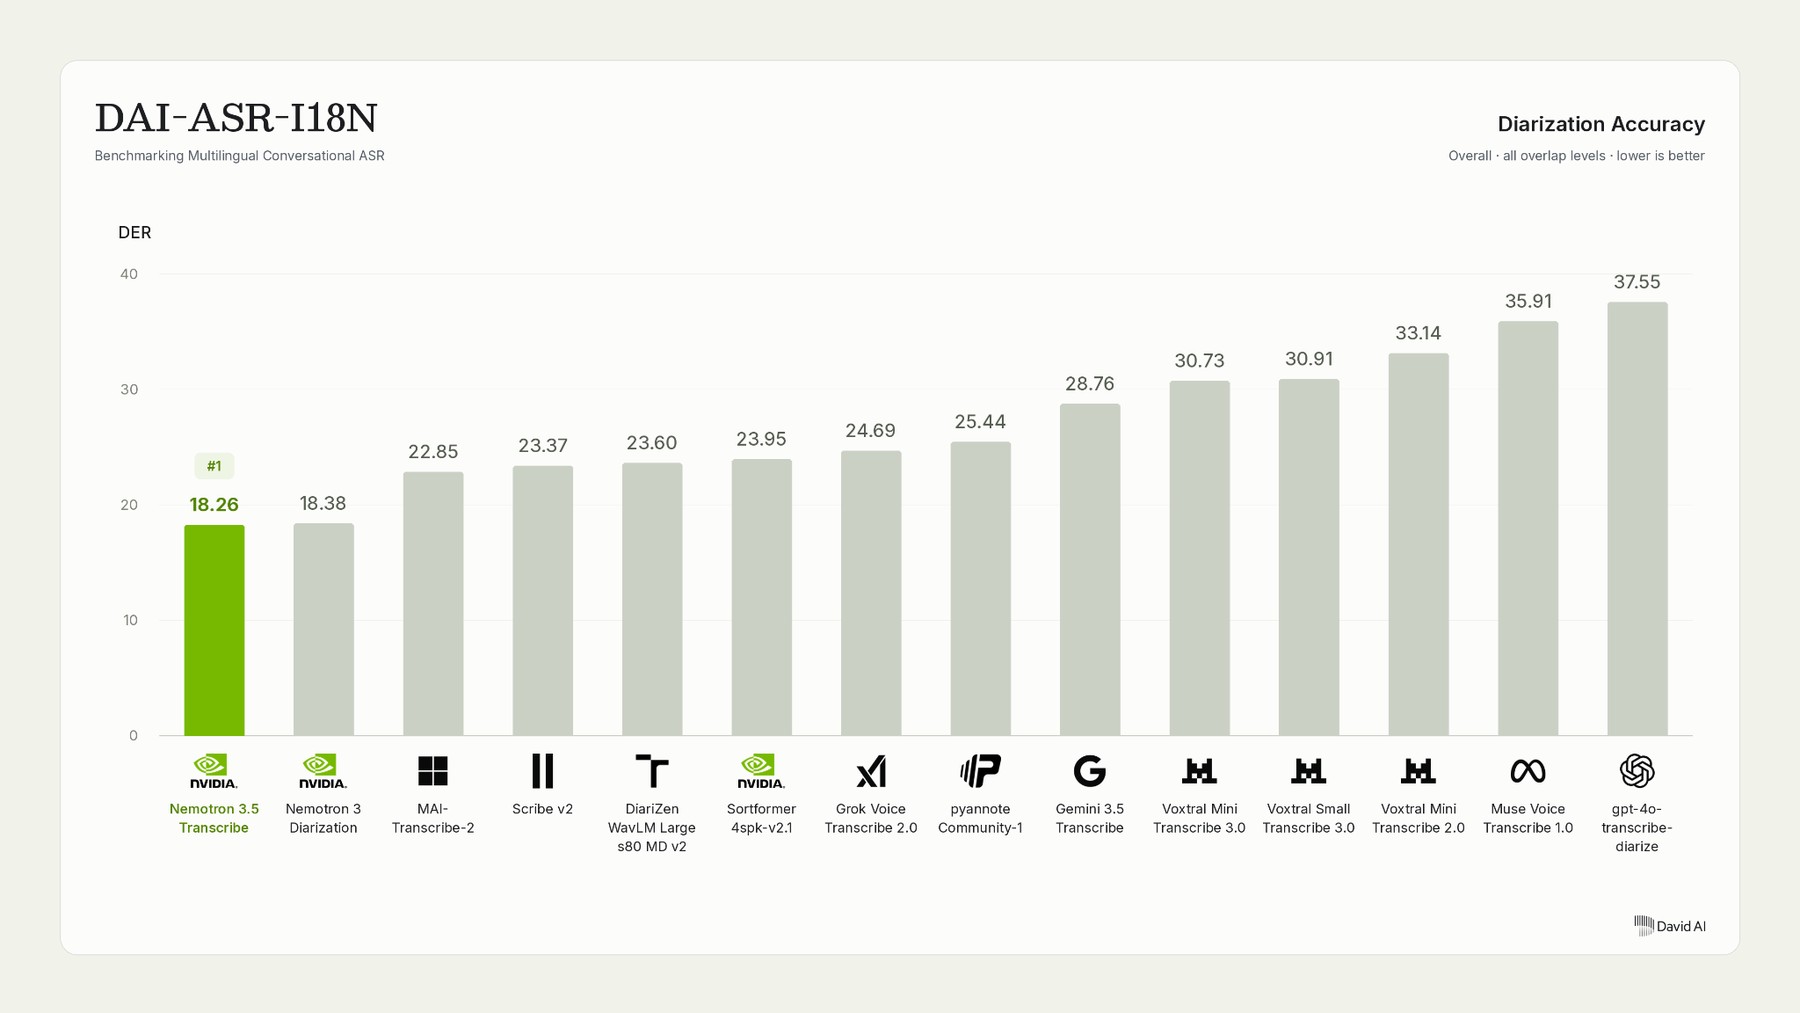
В тесте David AI Nemotron 3.5 Transcribe надёжнее всего определяет текущего говорящего на 21 языке. Чем ниже показатель, тем лучше
Источник: the-decoder.com
Granary v2 и настройка под медицинскую речь
Вместе с моделью Nvidia выпускает набор данных Granary v2: около 844 000 часов речи на 48 языках. В предыдущей версии было примерно 643 000 часов на 25 языках. Для каждой записи предусмотрено несколько вариантов расшифровки. В одном сохраняются слова-паразиты вроде «э-э» и числа, записанные словами. Другой вариант очищен от слов-паразитов, а числа в нём записаны цифрами.
Nvidia также публикует инструменты, с помощью которых создала набор данных: разработчики могут применить их к собственным записям. При этом компания уточняет, что Granary v2 не полностью совпадает с данными, на которых обучали саму модель.
Nvidia проверила настройку модели под медицинскую тематику на записях индийских врачей и студентов-медиков. На полном бенчмарке более точный промт снизил долю ошибок с 30,8% до 23,8%. После дополнительного обучения показатель упал до 11,8%. В обучающих данных преимущественно использовалась синтетическая речь.
Для новых модели говорящих Nvidia отдельно приводит снижение ошибок с 22,44% до 12,17% — относительное улучшение на 45,8%. Настроенная модель обошла открытую медицинскую модель распознавания речи, у которой результат составил 13,79%. По данным Nvidia, весь процесс занял около 14 часов на одной видеокарте Nvidia GB300.
Настройка под медицинскую речь немного повысила долю ошибок на обычной английской речи. При этом медицинская версия точнее распознавала торговые названия лекарств. Nvidia рекомендует при создании собственных версий модели выделять не менее 100 настоящих проверенных записей для тестирования.
У базовой модели тоже есть ограничения: возможности зависят от языка, а функцию ответов на вопросы по аудио обучали на английском. Кроме того, модель рассчитана только на записанную речь. Nvidia советует выборочно проверять имена, смену говорящих и ответы на вопросы.
Модель и набор данных доступны на Hugging Face, там же есть демка. Для настройки Nvidia предлагает инструкции и расширение, которое позволяет ИИ-ассистенту для программирования запускать процесс обучения.
Чем модель отличается от конкурентов
В сентябре Nvidia представила Nemotron 3 Diarization — отдельную модель для распознавания говорящих. Она различает до восьми участников, в том числе в разговорах в реальном времени, но для расшифровки речи требовалась другая модель, например Parakeet от Nvidia. Nemotron 3.5 Transcribe объединяет эти задачи и добавляет перевод и анализ аудио. Обрабатывать речь в реальном времени она не умеет.
Ранее Nvidia уже использовала набор данных Granary для мультимодальной модели Nemotron 3 Nano Omni.
Компании-конкуренты выбирают другие направления. Семейство Voxtral от Mistral тоже объединяет расшифровку речи и анализ аудио. В недавно анонсированной Voxtral 3 компания делает упор на голосовых ИИ-агентов, работающих в реальном времени.
Читайте также
 Anthropic, похоже, станет первой компанией, которая выйдет на биржу, предупредив, что может уничтожить человечество
 Nvidia поддержала индийский стартап, помогающий компаниям запускать ИИ-модели с меньшим числом GPU
 Новый индекс Artificial Analysis увеличил разрыв между открытыми и закрытыми моделями
 Риелторы Илона Маска запугивают местных жителей, чтобы те не судились из-за оглушительного шума дата-центров
 Disruptive привлекла $10 млрд в фонд, чтобы сделать крупные ставки как минимум на 10 компаний
 Google DeepMind выпустила Gemini 4 Carbon всего через две недели после Argon — модель прибавила по всем направлениям
 Женщина умерла после того, как ChatGPT убедил её снизить дозу назначенного врачом лекарства
 General Compute привлекла $100 млн в раунде серии A, бросив вызов нарративу о крахе неооблаков
 Salesforce дополняет Agent Fabric ИИ-проверками, которые отключают сбойных агентов
 Google открыла Android для сторонних ИИ-агентов и представила новые API Gemini
 Стартап, связанный с Илоном Маском, утверждает, что его ИИ-агенты взломали Anthropic за несколько часов
 Первые результаты: как Claude ускоряет разработку лекарств
 Лаборатории передового ИИ заявили, что их модели опровергли гипотезу экспоненциального времени. Что это значит?
 Nvidia и Oracle расширяют облачную инфраструктуру Vera Rubin, обещая эффективнее загружать GPU, простаивающие у корпоративных клиентов
 Claude for Legal автоматически проверяет источники, а затем передаёт файл юристу
 Ведущий исследователь безопасности ИИ заявил, что перестал копить на пенсию, потому что уверен: мы все погибнем
 Anthropic расширила партнёрство с GSA, чтобы предоставить Claude всем уровням власти США
 Genie 4 от Google добавила звук, более реалистичные миры и управление сценой в реальном времени
 Новые модели LFM3 от Liquid AI переносят браузерных агентов, голосовые команды и распознавание изображений на локальные устройства
 Обзор «Стен замка»: на Prime вышел первый полностью созданный ИИ сериал — размазанная вазелином каша
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram