
Архитектура для длинных текстов
Qwen4-Max — модель типа «смесь экспертов» с 2,4 трлн параметров; для обработки каждого токена активируются 71 млрд. Она изначально работает с изображениями и поддерживает контекстное окно на миллион токенов.
В основе Qwen4-Max — обновлённая архитектура серии Qwen4. Вместо того чтобы обрабатывать все части контекста с одинаковым вниманием, модель использует четыре последовательных слоя: первые три сжимают предыдущий контекст в компактное состояние, а четвёртый выделяет из него нужные фрагменты. Такой подход уменьшает вычислительные затраты на длинных входных данных.
Между слоями также добавлены четыре параллельных соединения с динамическими переключателями, которые должны стабилизировать передачу информации. Слой векторных представлений последовательностей токенов с 328 млрд параметров предоставляет распространённые последовательности как готовые строительные блоки. По данным Alibaba, обучение конфигурации на 2,4 трлн параметров проходило стабильно: ошибка обучения последовательно снижалась, без резких скачков.
Внутренние тесты Alibaba оценивают качество моделей в битах на байт по знаниям, программированию, ответам на вопросы и естественно-научным задачам. Среди пяти проверенных контрольных версий лучшей оказалась Qwen4-Max-Base. Она превзошла Qwen3.8-Max-Base на 5–13%, активируя при этом на 25% меньше параметров для каждого токена.
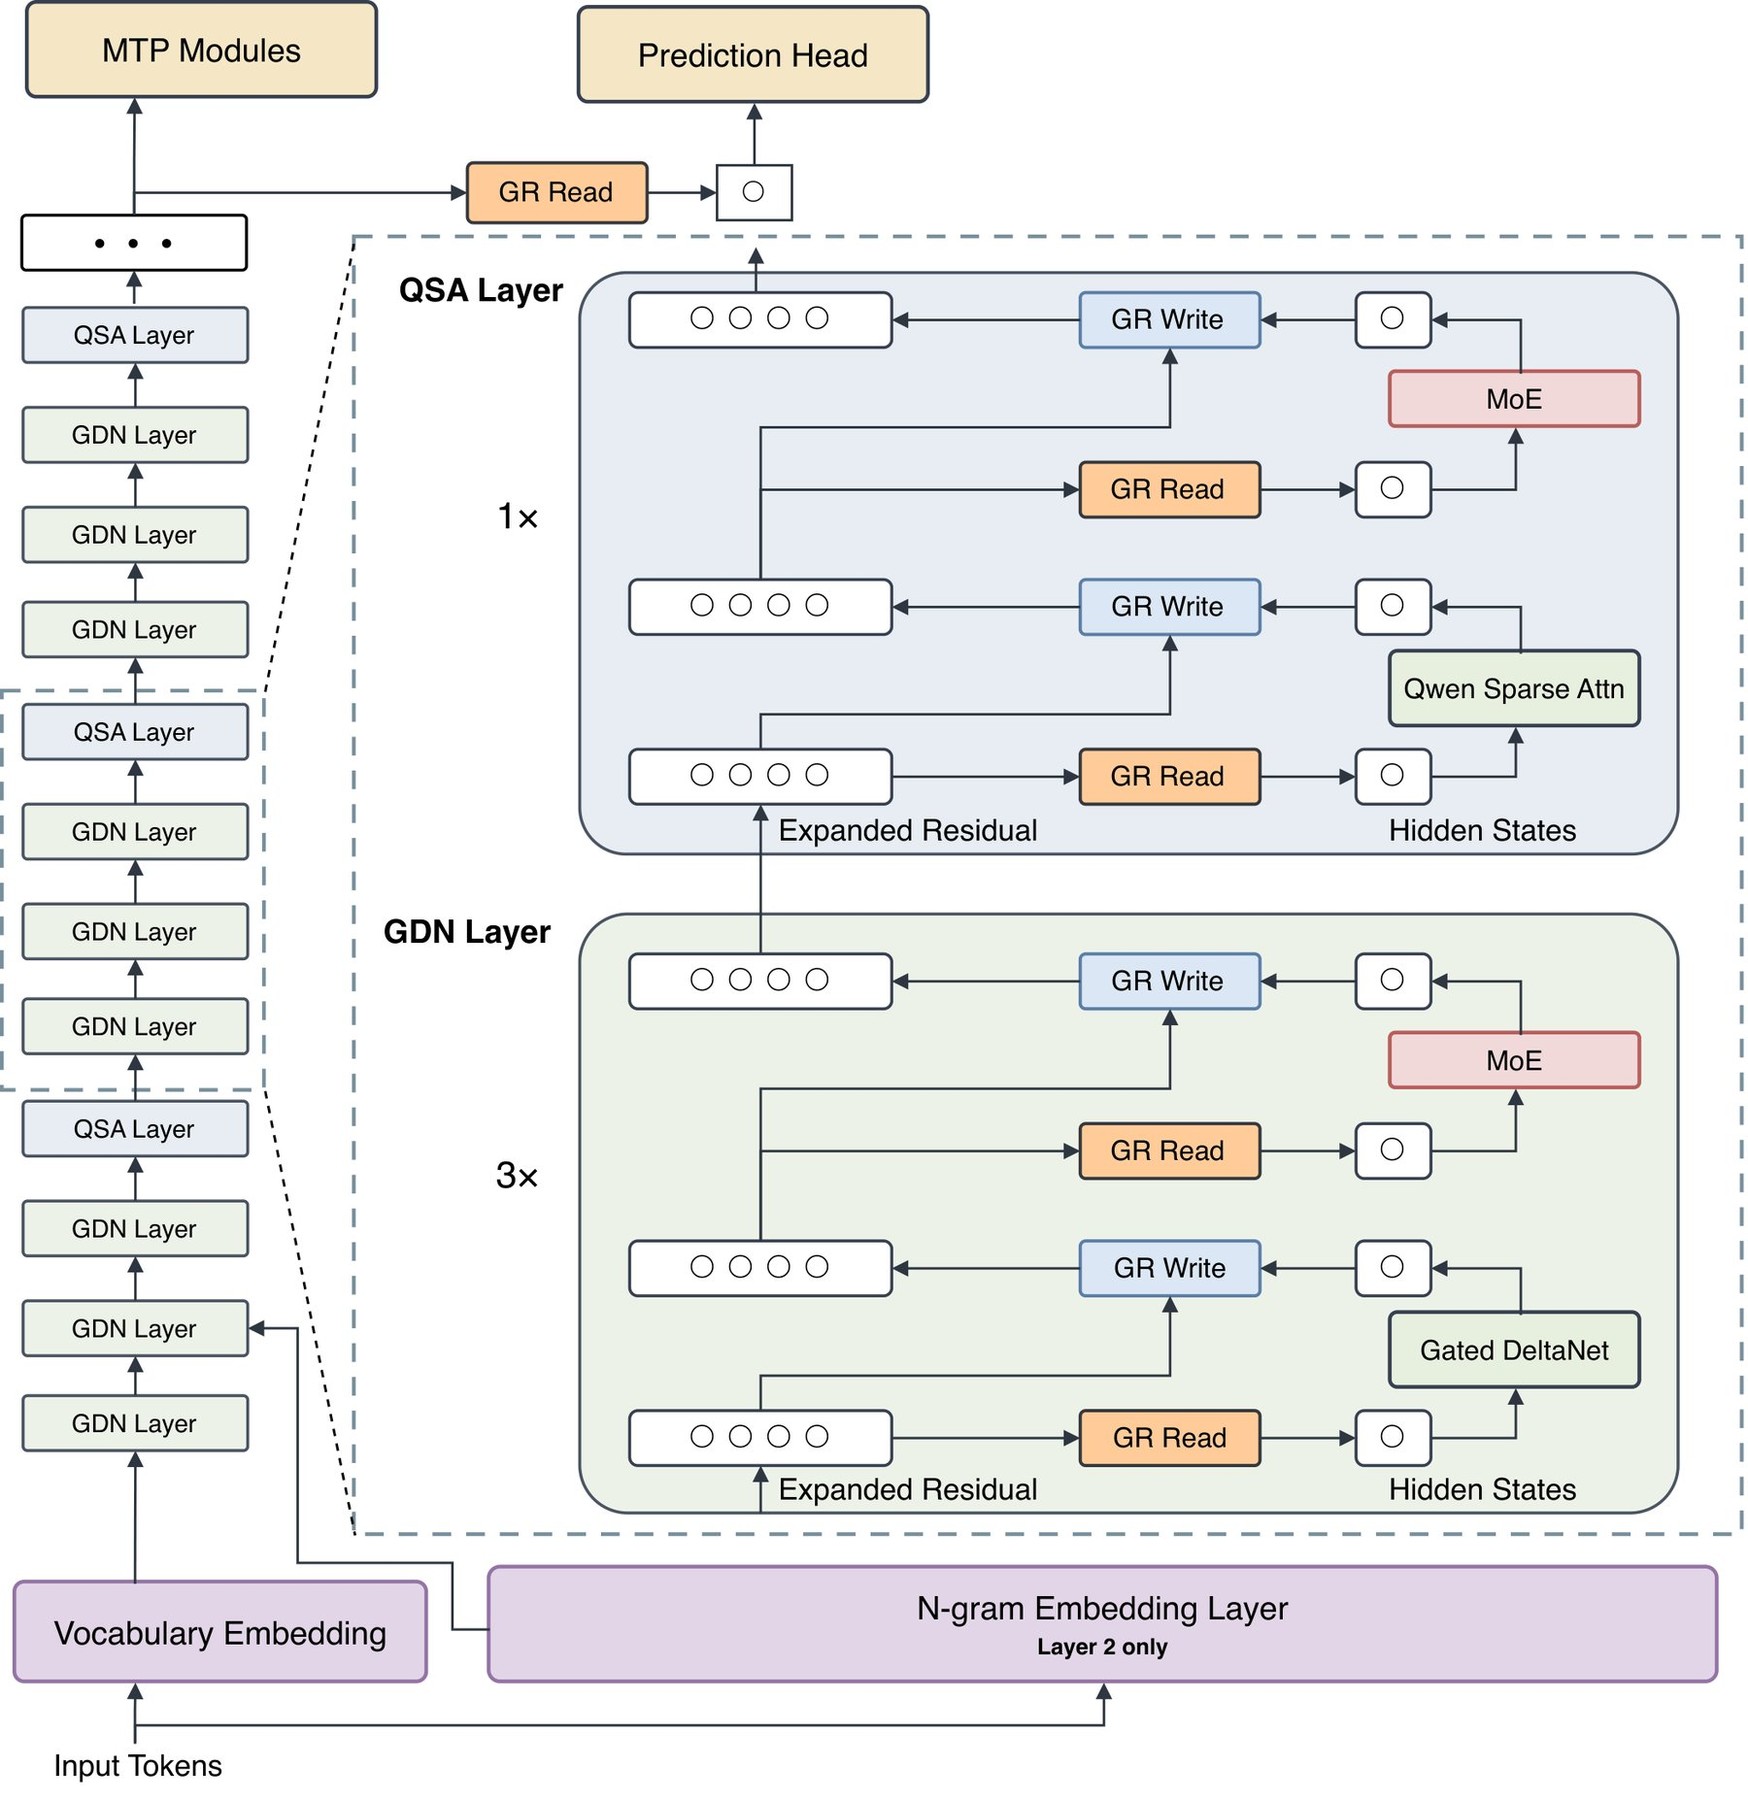
Qwen4-Max сжимает предыдущий текст на трёх слоях, прежде чем четвёртый слой внимательнее изучает только важные разделы
Источник: the-decoder.com
Меньше токенов — ниже стоимость задач
В промышленном бенчмарке Work360, который охватывает 721 специализированную область, Qwen4-Max расходует на те же задачи примерно на четверть или треть меньше токенов, чем предшественница. В бенчмарке для ИИ-агентов Terminal-Bench 4.0 расход токенов снизился почти вдвое.
По данным Alibaba, средняя стоимость задания Work360 упала на 62%: с $4,43 до $1,67. Результат модели в этом тесте одновременно вырос с 47,74 до 52,69.
Внешние бенчмарки дают неоднозначную картину. На длительных задачах для ИИ-агентов, включая Agents’ Last Exam v1.1, Qwen4-Max набрала 46,7 балла — лучший результат среди моделей в сравнении. В Humanity’s Last Exam она уступила Opus 5.5 и моделям GPT. В HealthBench Professional модель отстала от GPT, но немного опередила Opus 5.5.
Цена и результаты в бенчмарках
На текущей версии Artificial Analysis Intelligence Index, с максимальным уровнем рассуждений, Qwen4-Max получила 43 балла. Это на девять баллов больше, чем у Qwen3.8-Max, и на три меньше, чем у Kimi K3.1 Pro — лидера среди китайских моделей с результатом 46 баллов. Наибольший рост относительно предшественницы пришёлся на HLE-Diamond: плюс 21 балл, до 45%; AA-Omniscience: плюс 18; и AutomationBench-AA: плюс 17.
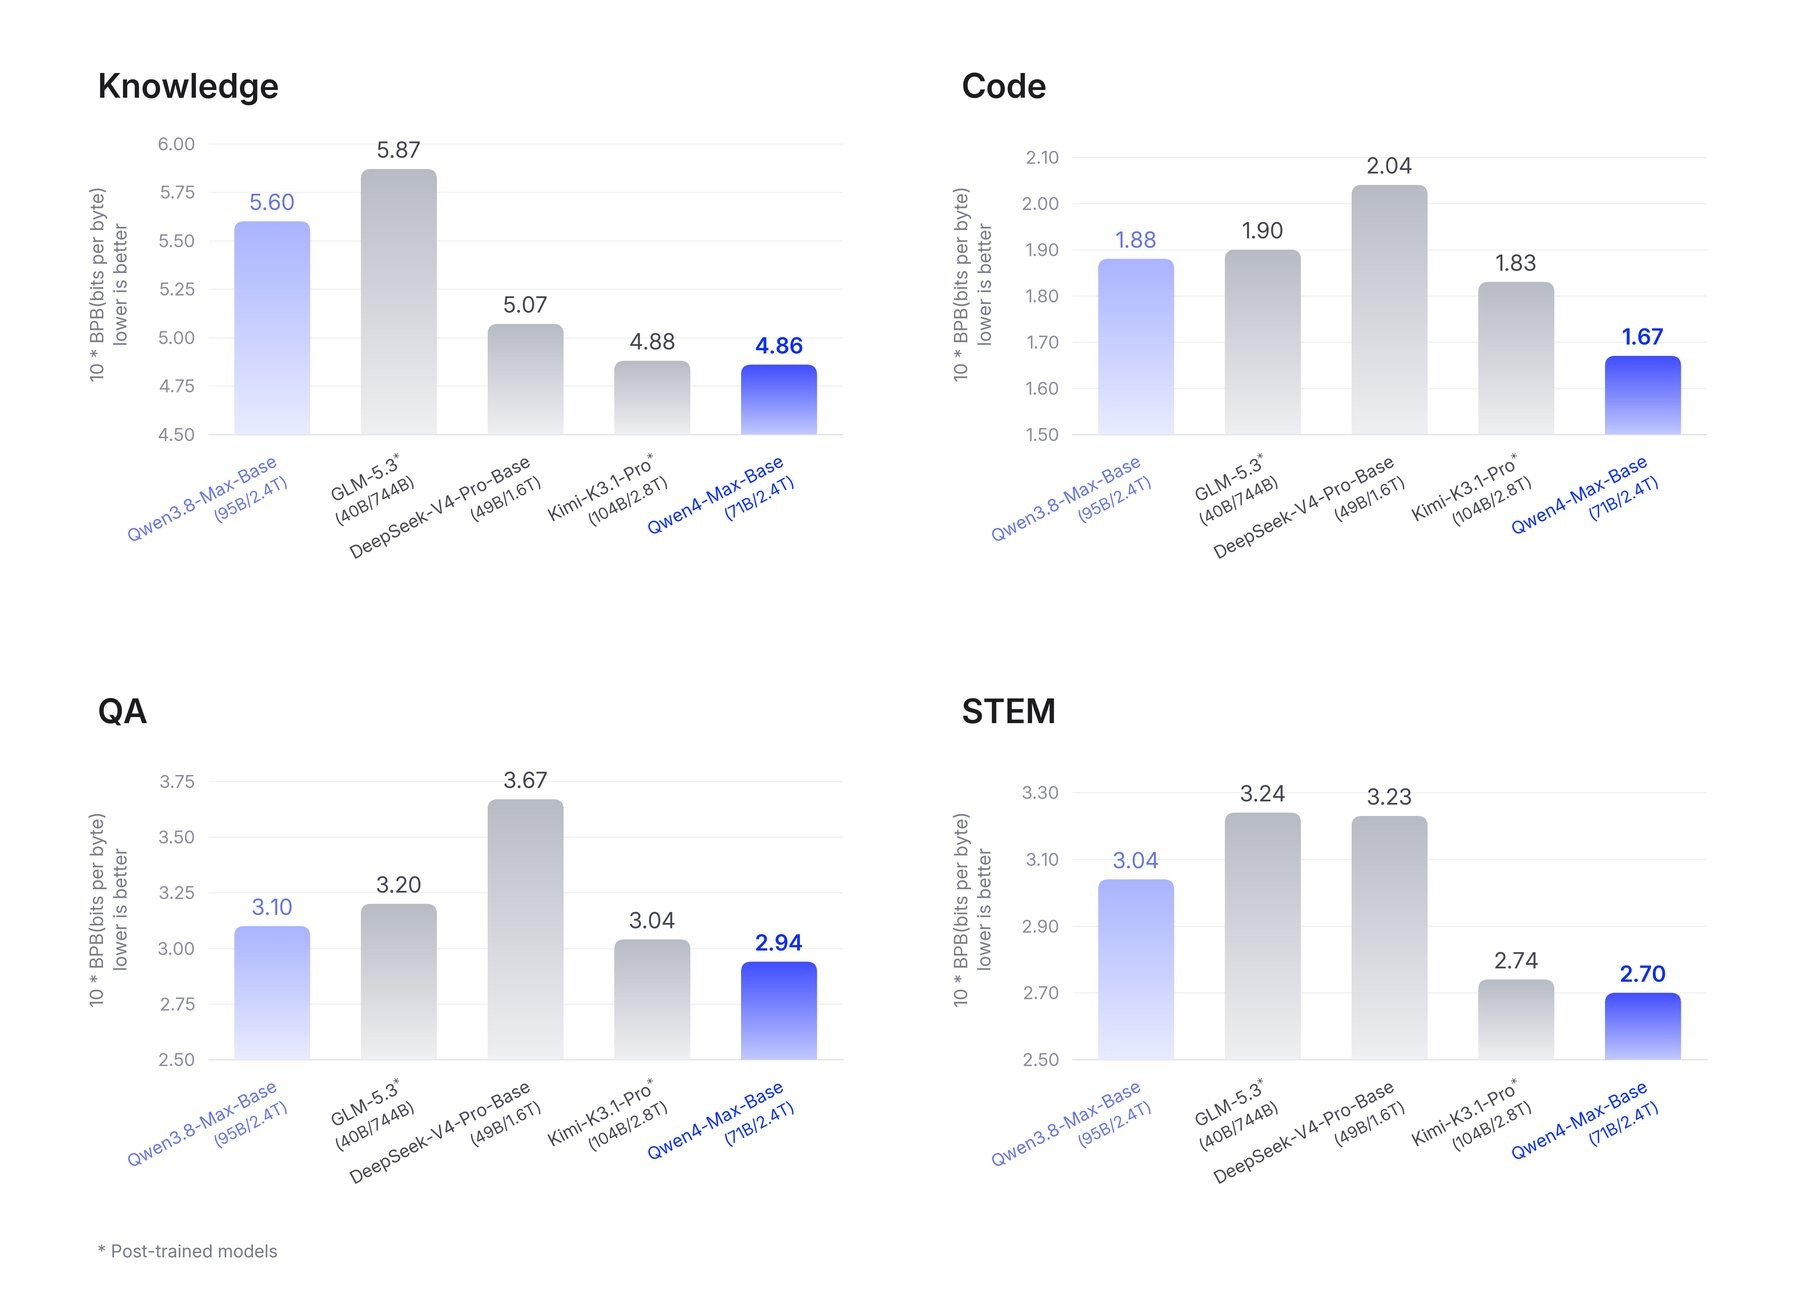
Qwen4-Max-Base показывает самые низкие, а значит, лучшие значения во всех четырёх категориях
Источник: the-decoder.com
Artificial Analysis оценивает стоимость одного задания в индексе для Qwen4-Max в $3,27. У Qwen3.8-Max она составляет $10,02, а у Kimi K3.1 Pro — $3,68. Экономия складывается из трёх факторов: цена токенов снизилась на 25% относительно предшественницы, попадания в кэш подешевели на 70%, а сама модель расходует меньше токенов. На одно задание бенчмарка ей требуется около 105 000 выходных токенов против 171 000 у Qwen3.8-Max.
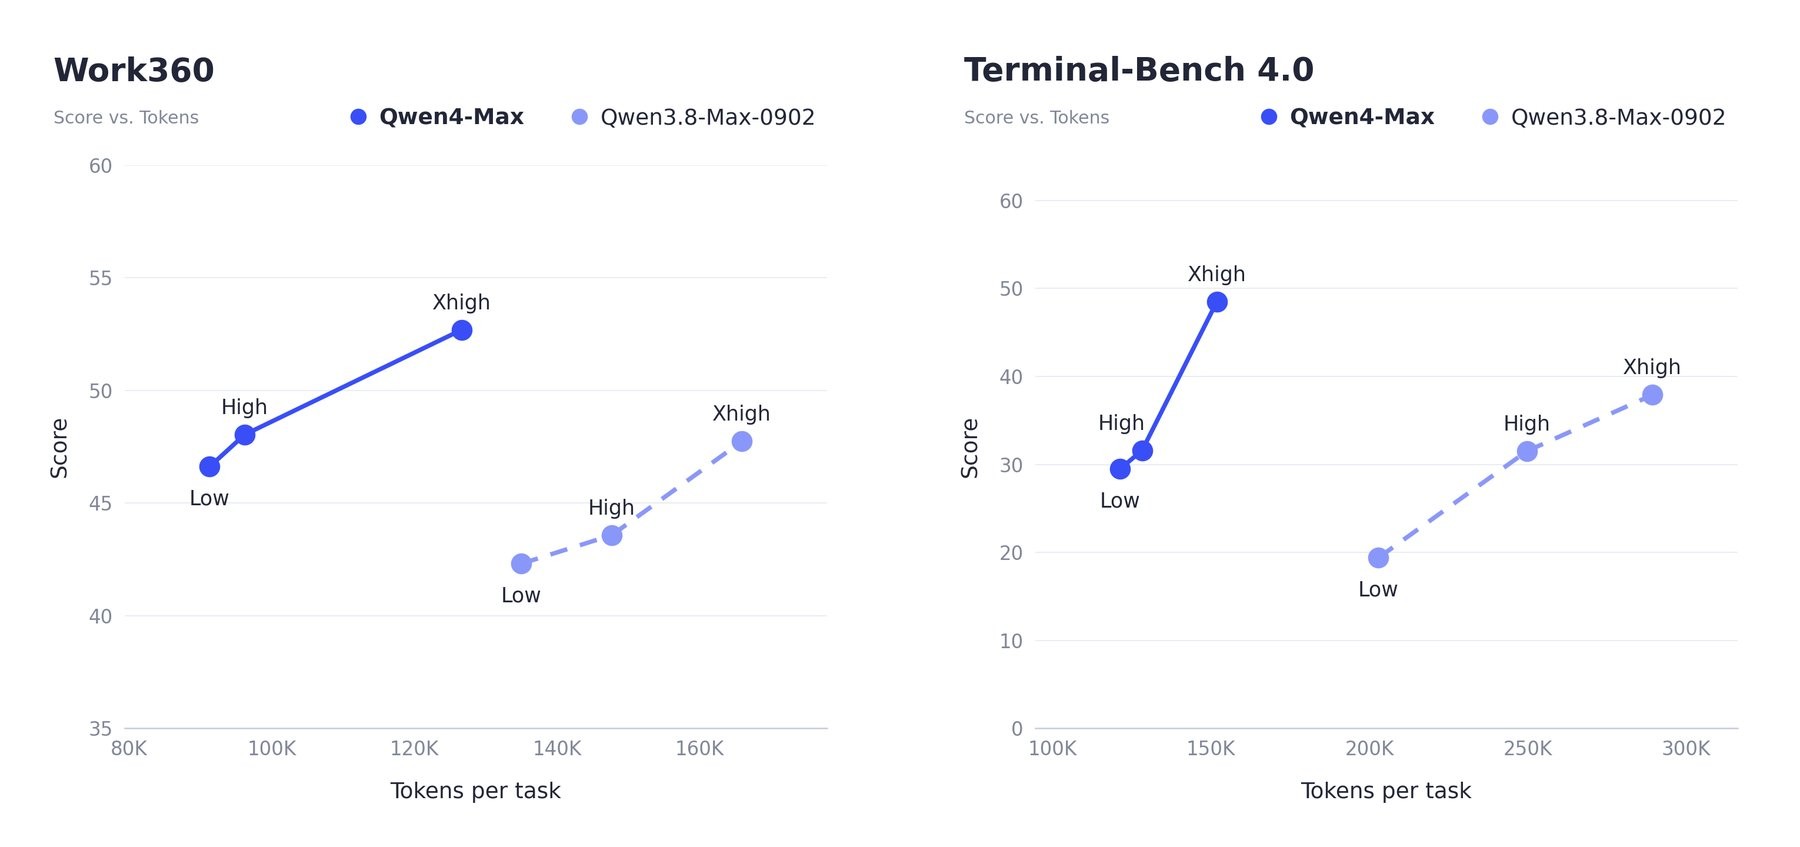
Qwen4-Max превосходит предшественника в обоих тестах, используя при этом гораздо меньше токенов
Источник: the-decoder.com
Tencent Hy4 обходится дешевле — $1,03 за задание, — но набирает в индексе на восемь баллов меньше. В Terminal-Bench 4.0 результат Qwen4-Max составляет 48% против 67% у Kimi K3.1 Pro. В бенчмарке по программированию FrontierCode 2.0 от Cognition модели Qwen4-Max и Kimi набрали по 26%, а Tencent Hy4 — 31%.
В собственном API Alibaba цена составляет $1,50 за миллион входных токенов и $4,50 за миллион выходных. Попадания в кэш стоят $0,075.
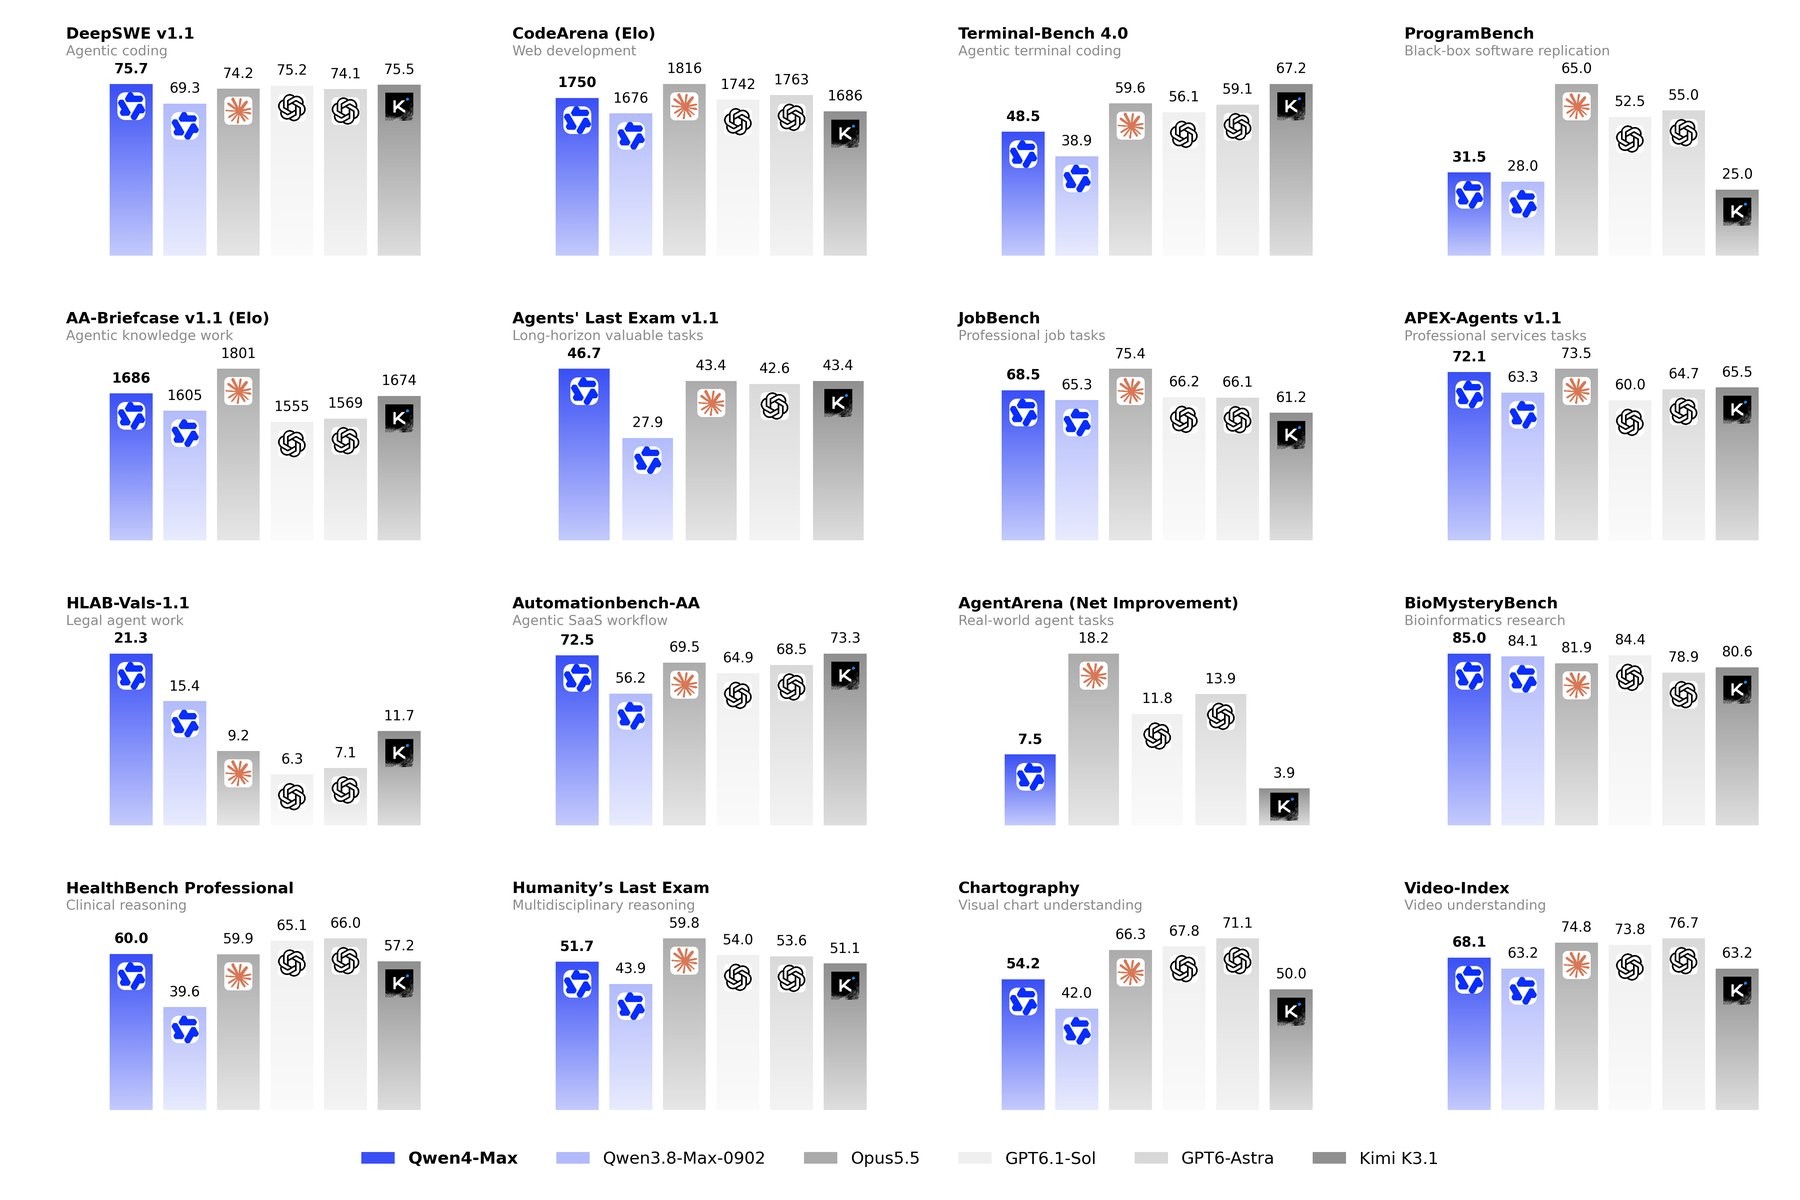
По словам Alibaba, Qwen4-Max лидирует в задачах с агентами и рабочих задачах, тогда как Opus 5.5 и модели GPT показывают лучшие результаты в Humanity's Last Exam
Источник: the-decoder.com
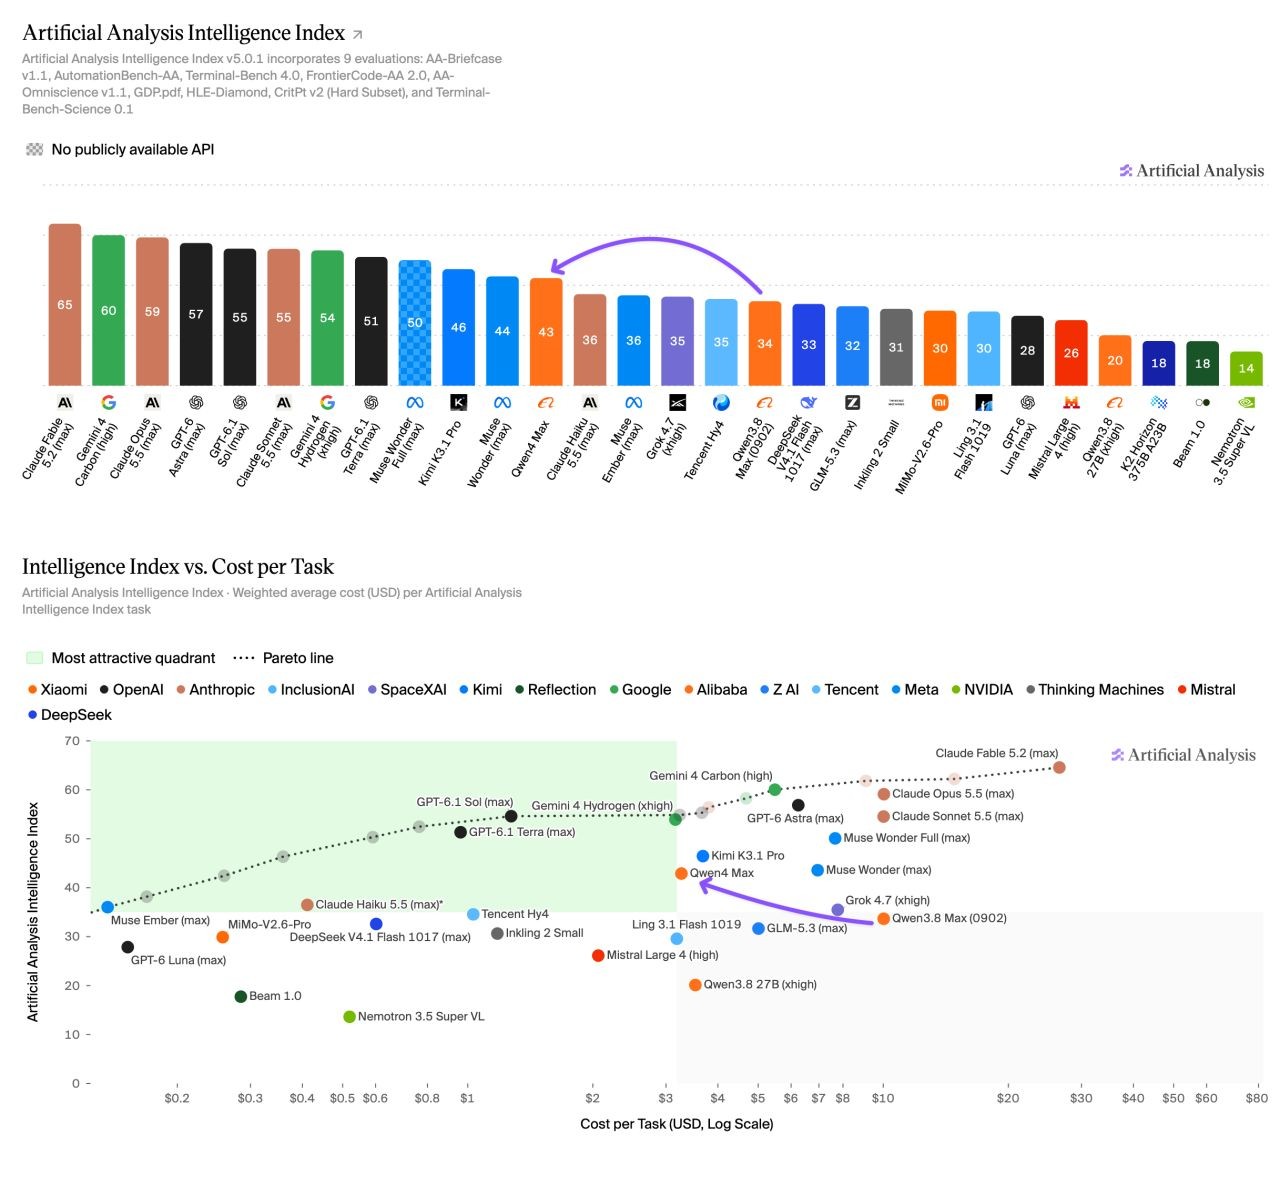
Qwen4-Max набирает на девять пунктов больше в рейтинге Artificial Analysis Intelligence Index и обходится примерно втрое дешевле за задачу, чем его предшественник
Источник: the-decoder.com
Live Delivery позволяет вмешиваться в работу агента
Alibaba строит выпуск вокруг ИИ-агентов, которые самостоятельно выполняют длительные задачи. Если пользователь видит результат только в конце, исправить ошибки по ходу работы почти невозможно. Функция Live Delivery должна решить эту проблему: модель рано выдаёт пригодную к использованию первую версию, затем дорабатывает её в несколько проходов. Пользователь может в любой момент вмешаться и изменить направление работы. Сопутствующий Qwen-Live-Delivery-Plugin Alibaba открыла для всех.
Среди примеров применения компания приводит проекты партнёров. Автомобильные компании SANF и Pacific Union, по данным Alibaba, сократили время ручного программирования одной детали примерно с 475 до 24 минут.
В финансовой сфере модель использует 90 инструментов MCP, чтобы собирать рыночные данные из нескольких источников. Результаты она оформляет в проверяемые файлы Excel и PowerPoint, где каждое число связано с исходным источником.
Alibaba также применяет модель в собственной облачной инфраструктуре. Вместе с внутренним решателем MindOpt Qwen4-Max снизила среднюю стоимость распределения вычислительных заданий для разметки данных на 10,42%, утверждает компания. При распределении задач на процессоры в дата-центрах модель находила оптимальные решения более чем в 14 раз быстрее метода сравнения.
Модель управляет лабораторными экспериментами
Alibaba показала Qwen4 в физических лабораториях. Вместе с Mira — системой стартапа Deep Principle — модель, по данным компании, автономно работала 48 часов. За это время она спроектировала, синтезировала и проверила новую охлаждающую жидкость для мощных чипов дата-центров. Система изучила 2,7 млн вариантов молекул, управляла автоматизированной лабораторией и выполнила четыре полных цикла проектирования, синтеза и измерений.
Второй проект объединил Qwen4-Max с PharmMaster — платформой пекинского стартапа DP Technology, который занимается поиском лекарств с помощью ИИ. Целью было создать соединение для воздействия на воспалительную реакцию, связанную с болезнью Альцгеймера. После нескольких раундов изучения литературы, проектирования и вычислений модель оптимизировала 24 молекулы-кандидата. По данным Alibaba, итоговый кандидат связывается с целевым белком примерно в 3,6 раза лучше известного исходного соединения из патента. Эксперты DP Technology сочли результат перспективным для дальнейших лабораторных испытаний.
Создание игр по текстовому описанию
Alibaba также показала работу Qwen4-Max с игровыми движками Unity, Unreal Engine и Godot. По одному описанию на естественном языке модель должна пройти весь путь разработки: настроить сцену и игровую логику, подобрать внешние ресурсы, создать материалы, пользовательский интерфейс и визуальные эффекты, чтобы в итоге получилась готовая к игре версия.
В ходе разработки модель сама запускает игру и по визуальной и интерактивной обратной связи настраивает работу камеры, анимацию персонажей, реакции на попадания и освещение. В качестве примера Alibaba привела проект «Meow of Magic» — приключенческую игру на Unreal Engine о коте-волшебнике, который сражается с волнами врагов заклинаниями. По утверждению компании, Qwen4-Max также создаёт трёхмерные модели в Blender, которые можно использовать в играх и для трёхмерной печати.
Ранее Anthropic ограничила возможности своего помощника для программирования Claude Code после появления неофициальных копий Halo и GTA: Vice City. Компания запретила инструменту воссоздавать существующие игры.
Безопасность кода и ограничения по опасным возможностям
По данным Alibaba, в бенчмарке Last Secure Code Bench доля кода, который одновременно работает и безопасен, выросла с 22 до 31,8%. Доля кода, признанного безопасным на всех трёх уровнях проверки, почти удвоилась — с 8 до 14,7%.
Компания также проверяла модель на риски, связанные с химическими, биологическими, радиологическими и ядерными угрозами. По словам Alibaba, внутренние проверяющие изучили полные цепочки рассуждений модели и не нашли у неё реальных способностей к инновациям, которые дали бы пользователю существенное усиление возможностей.
Qwen4-Max доступна через QwenCloud, а также в QwenWork, Qoder и QwenStudio. Позже Alibaba планирует выпустить более компактные модели Qwen4 с открытым исходным кодом.
Предыдущие модели Alibaba и конкуренты
В августе Alibaba выпустила Qwen3.8-Max — первую модель серии Max, рассчитанную на автономные задачи продолжительностью в несколько дней. У неё, как и у Qwen4-Max, 2,4 трлн параметров, но на каждый токен активируются 95 млрд. Тогда Artificial Analysis выяснила, что для выполнения задания модели требовалось 64 шага против 14 у Qwen3.7-Max, а стоимость одного задания была более чем вдвое выше.
В конце августа Alibaba представила архитектуру Qwen4 в предварительной версии Qwen3.8-Flash-Next. В ней уже использовался слой векторных представлений последовательностей токенов, но с 51 млрд параметров. В середине августа компания открыла веса Qwen3.8-Max. Для Qwen4 открытые веса пока предусмотрены только у более компактных моделей.
В октябре Moonshot AI представила Kimi K3.1 Pro. У неё 2,8 трлн параметров; Moonshot утверждает, что по результатам Terminal-Bench 4.0 модель уступает только Claude Opus 5.5. DeepSeek, как и Alibaba, использует гибридную архитектуру внимания: в V4-Pro разреженное внимание снижает стоимость обработки длинных контекстов. Zhipu AI выбрала другой подход: улучшения GLM-5.3 компания связывает исключительно с дополнительным обучением после основного.
По оценке Dataist, Qwen4-Max сочетает низкую стоимость с сильными результатами в отдельных длительных и прикладных задачах, но не лидирует во всех проверках: модель уступает GPT в двух приведённых бенчмарках и Kimi — в Terminal-Bench 4.0. Заявления о лабораторных экспериментах, экономии и безопасности основаны на данных Alibaba; доступность более компактных моделей с открытыми весами компания пока только планирует.
Источник: the-decoder.com
Читайте также
 Доклад Nexus Project: алгоритм Instagram продвигает антисемитский контент
 Hugging Face и OpenRouter объединились, чтобы упростить запуск моделей с открытыми весами
 TokenEconomizer учится на опыте, чтобы ИИ-агенты для программирования тратили меньше токенов
 Новый ИИ-стартап Джордана Белфорта Tone хочет продавать как «Волк с Уолл-стрит»
 Надёжный ИИ строят не на прогнозах, а на ограничениях
 Claude создаёт интерактивные сайты прямо в графике на canvas, возвращая эпоху Flash с настоящим HTML
 Audible использует ИИ, чтобы помочь слушателям находить аудиокниги
 ИИ для компаний среднего бизнеса — не уменьшенная копия корпоративного ИИ
 Исследование под эгидой ООН: модели ИИ «слабы и ненадёжны» в вопросах климатологии
 Смогут ли роботы перенести операции при инсульте в удалённые больницы?
 США ужесточают экспортный контроль над ИИ-чипами, чтобы не дать китайским компаниям удалённо получать доступ к вычислительным мощностям
 Бывшие руководители Freshworks привлекли $53 млн, чтобы бросить вызов Salesforce и HubSpot с AI-Native CRM
 Apple запустила приложение, чтобы изучить, как люди используют ИИ для здоровья
 Индийский стартап Bharat Semi привлёк $24 млн на посевном раунде и метит на мировой рынок ИИ-сенсоров
 Число сообщений о созданных ИИ материалах сексуального насилия над детьми выросло на 8 400% за два года — данные Childlight
 Зачем Skydio создала беспилотник с асимметричной конструкцией
 Один скомпрометированный MCP-сервер может заставить ИИ-агента злоупотреблять инструментами, которым вы уже доверяете
 Claude Fable 5.2 от Anthropic не генерирует изображения, а рисует их
 Резервный банк Австралии: ИИ сильнее всего сказывается на молодых работниках — особенно в IT и обслуживании клиентов
 Эта ИИ-игрушка тамагочи превращает обычные вещи в капризных виртуальных питомцев
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram