
Источник: venturebeat.com
ИИ-агенты могут анализировать собственные ошибки и менять промты, инструменты, навыки и рабочие процессы вокруг базовой модели — весь этот слой исследователи называют каркасом агента. Но надёжно накапливать такие улучшения трудно. Изменение, полезное для одной задачи, может ухудшить результат на другой, а последовательная доработка одной версии каркаса способна привести систему к ветке, где прогресс остановится.
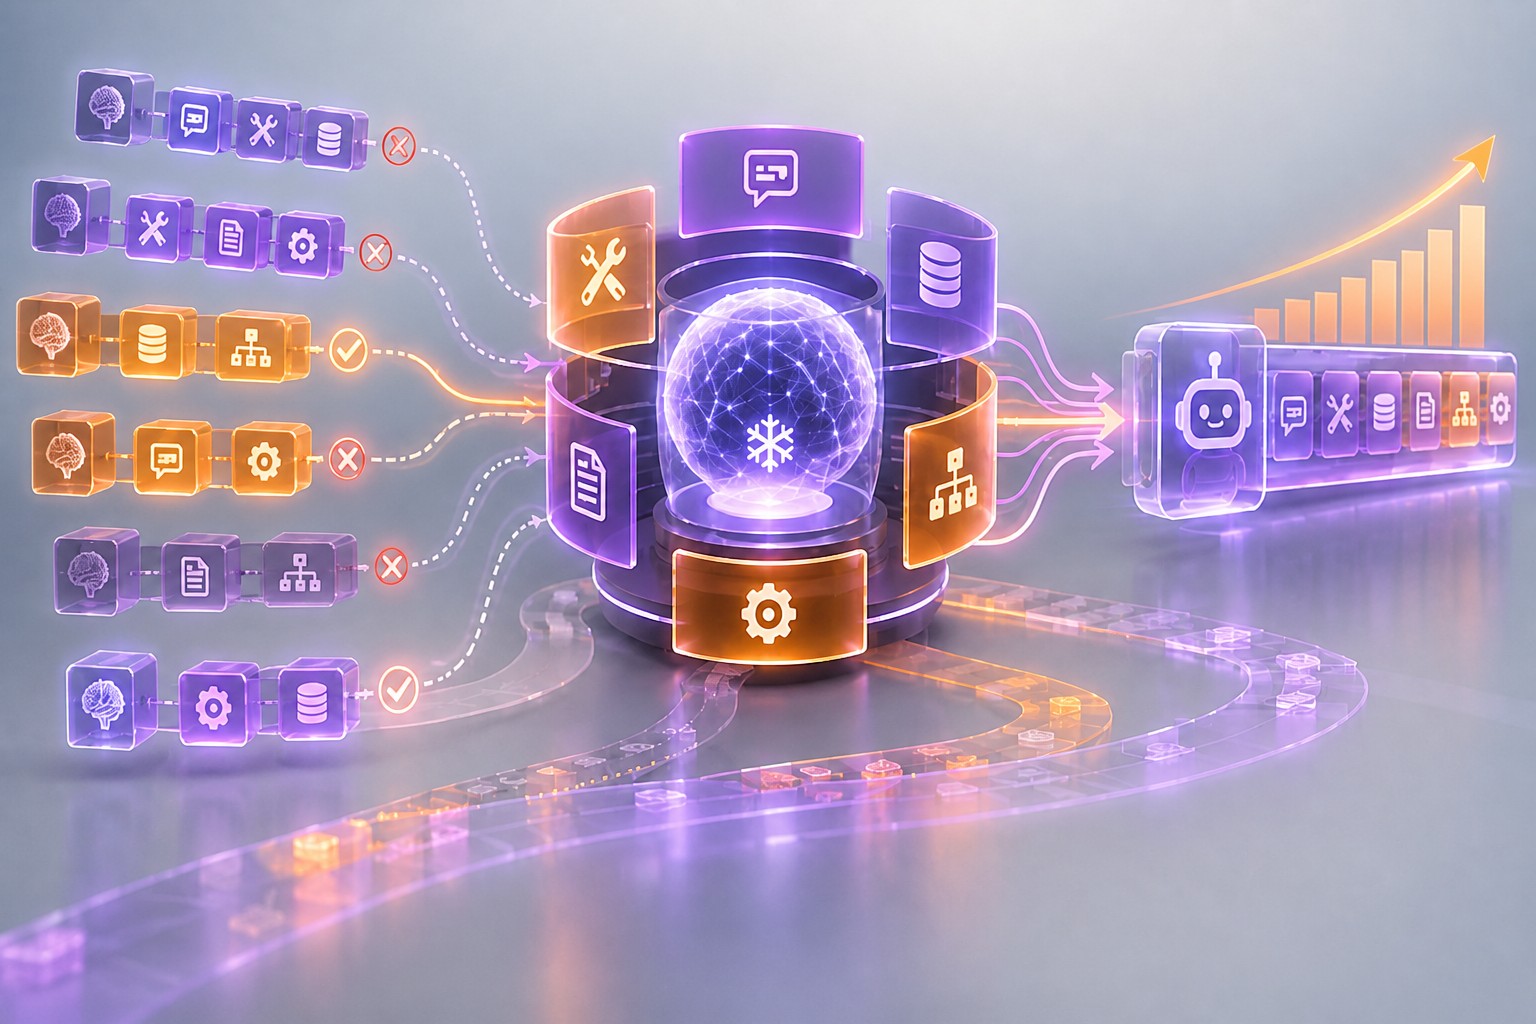
Salesforce AI Research и Salesforce Agentforce предложили для этой проблемы фреймворк DarwinX, построенный по эволюционному принципу. Вместо постоянного переписывания одной версии каркаса система исследует несколько вариантов, сохраняет удачные находки и пропускает изменения дальше только тогда, когда они повышают способности агента без ухудшения результатов на других задачах.
Эксперименты показывают, что в этом слое действительно остаётся значительный запас производительности. Эволюция каркаса улучшила результат агента на всех четырёх проверенных бенчмарках: от прироста на 3,4 процентного пункта в SWE-bench Verified до скачка на 49,5 пункта в WebArena-Infinity.
DarwinX меняет только каркас и никогда не затрагивает веса модели. Поэтому подход подходит разработчикам приложений, которые используют размещённые модели и не располагают собственными пайплайнами файн-тюнинга или обучения моделей.
Почему циклы самоулучшения останавливаются
Многие фреймворки для самоулучшения ИИ-агентов используют примерно один и тот же цикл:
Исследователи уже развивали эту идею дальше оптимизации промтов. Например, Darwin Gödel Machine (DGM) позволяет агенту менять собственный исходный код и хранит архив прошлых вариантов. HarnessX работает непосредственно с промтами, инструментами и логикой управления, а также разделяет варианты по семействам задач, чтобы ограничить взаимное влияние изменений.
Исследователи Salesforce указывают на две проблемы таких подходов.
Первая — зависимость от пути развития. Если каждый новый раунд строится вокруг варианта, который сейчас выглядит лучшим, ранние изменения определяют основу всех последующих. Локально полезная правка может направить эволюцию по ветке, где прогресс со временем остановится, тогда как другой перспективный вариант будет заброшен ещё до того, как успеет развиться.
Представим, что раннее изменение научило агента для программирования агрессивно устанавливать зависимости перед началом работы. Оно исправило несколько ошибок и стало новой базовой версией. Все следующие изменения теперь строятся поверх этого поведения. При этом система может не исследовать альтернативную стратегию: сначала проверить окружение и установить только действительно нужные зависимости.
Вторая проблема — взаимное влияние задач. Изменение, полезное для одного класса задач, может незаметно повредить другому. Например, инструкция проводить расширенную проверку способна улучшить сложные задачи по научным вычислениям, но привести к превышению лимита времени в простых заданиях. Чем шире набор задач агента, тем труднее улучшать отдельные способности, не жертвуя уже имеющимися.
С теми же проблемами сталкиваются корпоративные команды, которые вручную исправляют промты и рабочие процессы после сбоев. Ран Сюй, старший автор статьи о DarwinX, сообщил VentureBeat, что ручная разработка каркаса легко сходится к локальному оптимуму: команда исправляет промт или рабочий процесс для одного типа ошибок, но без широкого регрессионного тестирования может незаметно сломать то, что раньше работало.
Оценка ИИ-агентов добавляет ещё одну сложность. Результаты случайны: один и тот же агент может пройти задачу в одном запуске и провалить её в другом. Исследователи ссылаются на предыдущие работы, где между разными запусками отраслевых бенчмарков фиксировались колебания в несколько процентных пунктов. Их величина может быть сопоставима с видимым эффектом отдельного изменения каркаса.
Поэтому широкое регрессионное тестирование столь же важно, как и исправление ошибки, из-за которой изменение вообще появилось.
Задача сводится к тому, чтобы отличать реальные улучшения, сохранять полезные альтернативы и объединять новые способности, не теряя старые.
DarwinX позволяет вариантам конкурировать
DarwinX рассматривает эту задачу как отбор. Вместо одной постоянно переписываемой версии каркаса система создаёт разные варианты и сохраняет их в архиве. Перспективные версии могут продолжать развиваться, а полезные находки из других ветвей остаются доступными для будущих изменений. Базовая LLM при этом не меняется.
Первый ключевой механизм исследователи называют сохранением и расширением.
Кандидат должен что-то улучшить, но при этом удержать ухудшение результатов на уже решённых задачах в заданных пределах. Проще говоря, решение задачи B не считается полноценным улучшением, если то же изменение ломает задачи A и C.
DarwinX также разделяет исследование и подтверждение. Перспективная правка с небольшим отрицательным эффектом может пройти ранний отбор. Но прежде чем ей позволят направлять дальнейшую эволюцию, система повторно запускает её с большей точностью и проверяет задачи, которые уже решали предыдущие версии. Это снижает вероятность того, что один удачный случайный запуск изменит направление поиска.
Такой контроль возможен потому, что результаты экспериментов с программированием и браузером сравнительно легко проверять. Система может определить, добавило ли изменение каркаса новую способность и сохранило ли задачи, которые уже решались предыдущими версиями.
Для разработчиков программного обеспечения механизм сохранения и расширения похож на непрерывную интеграцию для ИИ-агента: предложить изменение, проверить новое поведение, повторно запустить ранее пройденные случаи и только после этого допустить вариант к дальнейшему развитию. По словам Сюя, DarwinX не объединяет изменения автоматически и не предполагает, что итог обязательно стал лучше. Объединённый агент должен пройти проверки сохранения и подтверждения, удержав взаимодополняющие улучшения и не ухудшив уже решённые задачи.
Второй механизм направлен на борьбу с зависимостью от пути. DarwinX сохраняет альтернативные ветви, в том числе варианты с более слабыми совокупными показателями. Такая ветвь может проигрывать в среднем, но содержать единственное изменение, которое решает конкретный класс задач. Вместо удаления её можно использовать как специализированный вариант.
Если разные специалисты обладают взаимодополняющими сильными сторонами, фреймворк объединяет их аддитивные изменения в новый каркас. После этого объединённая версия должна доказать, что сохранила нужные улучшения своих родителей. Так способности, найденные на разных эволюционных путях, могут снова встретиться, а не остаться запертыми в отдельных ветвях.
Предлагать следующее изменение DarwinX может на основе разных источников:
Все три сигнала приводят к изменениям каркаса, а не весов модели.
Исследователи также объединяют повторяющиеся ошибки в общую память. Например, если несколько задач провалились из-за слишком долгой настройки окружения, система может предложить многоразовый навык настройки вместо отдельных исправлений для каждой задачи.
Здесь «естественный отбор» в DarwinX проявляется уже буквально. Системе не нужны эталонные решения, а исследователям не приходится вручную проверять кандидатов и выбирать победителя. Варианты каркаса выживают на основании измеренной приспособленности, которую определяет оценщик задач.
Это не означает, что DarwinX работает без сигнала оценки. Системе по-прежнему нужно определить, была ли задача выполнена. Например, в экспериментах с WebArena-Infinity исследователи использовали судью на базе LLM, который оценивал траектории, созданные разными вариантами агента.
Именно этот отбор отличает DarwinX от DGM и HarnessX. У DGM уже есть открытый архив, но система каждый раз изменяет одного родителя и не использует объединение разных линий или явный контракт сохранения, как DarwinX. HarnessX изолирует варианты, чтобы ограничить взаимное влияние, а DarwinX пытается безопасно объединять взаимодополняющие способности.
DarwinX в работе
Исследователи проверили DarwinX на Monet — собственной модели агента Salesforce. В сопоставимых экспериментах базовая модель оставалась неизменной.
Проверки постепенно усложнялись, чтобы снизить риск переобучения. На первом этапе агент развивался и оценивался на одном и том же бенчмарке. На втором его проверяли на отложенных задачах. На третьем каркас развивался на синтетических браузерных задачах, а затем оценивался на неизвестных реальных. В финальном эксперименте каркас, обученный на одном бенчмарке, переносили на совершенно другой.
На Terminal-Bench 2.1 DarwinX поднял результат Monet на зафиксированной GPT-5.5 с 75,5% до 83,2%, а с более сильной базовой моделью — до 84,7%. Наибольший прирост пришёлся на задачи по машинному обучению и научным вычислениям: плюс 14,8 пункта. В задачах с данными и базами данных результат вырос на 13,8 пункта.
Однако важнее самого роста показателей изменения, которые его обеспечили. Обновлённый каркас добавил семь навыков. Они instructируют агента:
Обновлённый агент не стал просто тратить больше вычислений на рассуждение во всех задачах. В заданиях, которые могли решить обе версии, медианное число ходов выросло только с 12 до 13. В шести новых задачах, решённых только после изменений, показатель увеличился с 11 до 22. Это означает, что каркас научился определять, где дополнительные проверки и повторные попытки оправдывают затраты.
TerminalWorld нагляднее показывает, зачем DarwinX хранит несколько ветвей. Каркас развивался на 94 учебных задачах, а затем был зафиксирован перед проверкой на 41 отдельной задаче. На Opus 4.8 базовая версия решила 25 из 41 задачи, то есть 61%, а DarwinX — 28, или 68,3%, говорится в статье.
Четыре специализированных варианта решили соответственно 24, 25, 26 и 27 отложенных задач на разных пересекающихся наборах. Объединённый каркас решил 28 задач и превзошёл каждый отдельный вариант. Исследователи называют результат на Opus 4.8 основным, потому что та же процедура на GPT-5.5 дала 56,1% — ниже нейтрального базового агента. Преимущество в одну задачу над лучшим готовым агентом они считают показательным, но статистически не निर्णающим.
Сюй связывает этот результат с тем, что совокупные оценки могут скрывать полезные способности. Вариант с более низким общим результатом всё равно способен содержать единственное успешное поведение для конкретного класса задач.
Практическая аналогия для компании — агент реагирования на инциденты. Лучшая универсальная версия может надёжно проверять сервисы, запускать стандартную диагностику и готовить безопасные изменения кода. Вариант с более низким общим результатом может специализироваться на надёжной процедуре проверки прав в Kubernetes, а другой — на восстановлении базы данных и проверке артефактов. Ни один из них не обязан быть достаточно хорошим для самостоятельного развёртывания: их изменения каркаса всё равно могут оказаться полезными. DarwinX способен сохранить такие модели поведения, объединить их с другими и снова проверить объединённую версию на регрессию перед выпуском.
Результат TerminalWorld служит измеренным подтверждением этой аналогии. При этом статья отдельно не определяет, какая доля улучшения появилась именно благодаря объединению вариантов, а какая — благодаря другим компонентам DarwinX.
В экспериментах с WebArena-Infinity DarwinX развивал браузерный каркас на 300 синтетических намерениях, созданных по документации приложений. В финальную проверку вошли 1260 неизвестных задач с детерминированными проверяющими процедурами — в отличие от судьи на базе LLM, который использовался во время эволюции вариантов. При зафиксированной GPT-5.5 результат агента вырос с 43,5% до 93%, то есть более чем вдвое, без изменения весов модели. Исследователи приводят эту цифру после проверки, отсеявшей траектории с недопустимым или похожим на эксплуатацию поведения.
Наконец, исследователи взяли каркас, развитый на Terminal-Bench, и без изменений запустили его на SWE-bench Verified. Он достиг 84,2% против 80,8% у эталонного каркаса, хотя во время эволюции не получал обратной связи от SWE-bench. По мнению авторов, это показывает, что некоторые выученные каркасом модели поведения переносятся за пределы исходного бенчмарка. Однако перенос проверяли только в одном направлении.
Что DarwinX значит для разработчиков
Главное практическое преимущество DarwinX в том, что цикл улучшения работает на уровне, который разработчики приложений уже контролируют. Доступ к весам модели не требуется.
По мере улучшения базовых моделей этот окружающий слой может стать ещё важнее. Каркасу приходится адаптироваться к поведению конкретной модели при работе с инструментами, требованиям к контексту и типичным ошибкам. Кроме того, в нём содержится специфическая для компании информация, которую универсальная модель не может просто получить во время предварительного обучения:
По словам Сюя, модель может получать всё больше универсальных способностей к рассуждению, тогда как каркас будет всё сильнее представлять корпоративный контекст, действия, управление и адаптацию вокруг модели. Такой слой способен стать более устойчивым источником отличий между продуктами, чем отдельный промт.
Более сложная задача — создать инфраструктуру оценки, которая объясняет циклу эволюции, что значит «лучше». В отличие от бенчмарков по программированию, в реальных корпоративных процессах редко есть один понятный двоичный проверяющий механизм.
Сюй считает, что компаниям нужно собирать данные о реальной работе и постепенно превращать эти записи в сигналы для обучения и оценки. Например, у агента поддержки можно фиксировать:
Часть этих сигналов можно превратить в детерминированные тесты: достигла ли заявка правильного состояния, завершилась ли одобренная операция, появилось ли в базе ожидаемое значение. Другие сигналы могут поступать из исправлений сотрудников, проверок соответствия требованиям, бизнес-результатов или согласия нескольких оценщиков.
Компании не обязательно нужна одна идеальная функция вознаграждения. По мнению Сюя, ей нужен инфраструктурный слой, который непрерывно превращает реальную работу во всё более качественную корпоративную информацию.
Со временем такая инфраструктура способна создавать постоянно обновляемый набор проверок на основе рабочих процессов, с которыми агент действительно сталкивается. Это решает одно из главных практических ограничений, отмеченных в статье: производственные задачи редко приходят с надёжными проверяющими процедурами. Вместо эволюции агента непосредственно на живых запросах команды могут периодически запускать её на поддерживаемом наборе заменяющих задач и разворачивать версию, прошедшую регрессионные проверки.
Salesforce также выпустила инфраструктуру для экспериментов с этим подходом — Beagle, открытый фреймворк на GitHub под лицензией Apache 2.0. Monet остаётся закрытым, но команды могут подключить к Beagle собственный каркас агента. DarwinX отвечает за метод эволюции: он ищет, оценивает и отбирает варианты каркаса. Beagle предоставляет более широкую инфраструктуру для запусков и экспериментов с агентами, окружениями, наборами данных и методами эволюции.
Сюй описывает Beagle как «Hugging Face Trainer для эволюции ИИ-агентов»: разработчик приносит агента, окружение, сигнал оценки и алгоритм эволюции, а инфраструктура берёт на себя масштабные запуски и эксперименты.
Переход от ручного обновления промтов к автоматизированной непрерывной интеграции каркаса требует дополнительных ресурсов. DarwinX исследует несколько вариантов, повторяет оценки, чтобы учитывать шум в результатах, и запускает проверки сохранения до того, как кандидаты смогут повлиять на следующие поколения. Это требует больше вычислений для оценки и больше инфраструктуры, чем ручная правка промта.
Однако ручные изменения тоже нуждаются в регрессионном тестировании, если их собираются отправлять в производство. Разница в том, что автоматизированный цикл может системно проводить такие эксперименты, а не заставлять инженера по одному проверять и исправлять сбои.
Затраты можно ограничивать. Эволюцию разрешается запускать в пределах фиксированного вычислительного бюджета и останавливать, когда улучшения перестают появляться. Цель — тратить вычисления на оценку до тех пор, пока очередной прирост не перестанет оправдывать стоимость.
Для компании в этот расчёт входят не только расходы на инференс, но и время инженеров с риском регрессий: насколько быстро система достигает нужного качества и сколько производственных сбоев предотвращает автоматический цикл тестирования и отбора.
Поэтому DarwinX подходит не для каждого агента. Сюй рекомендует эволюционную оптимизацию каркаса для длительных задач, результат которых можно достаточно уверенно оценить и которые имеют широкую поверхность поведения:
Напротив, для простого и стабильного процесса дополнительные механизмы трудно оправдать. Например, если известный вход нужно преобразовать в фиксированный вызов API и вернуть результат, детерминированный рабочий процесс обычно легче понять, протестировать и контролировать. Сюй не советует вводить эволюцию на основе популяции только ради самой эволюции.
Есть и промежуточный вариант. Корпоративный агент поддержки может работать с достаточно большим числом меняющихся процессов, чтобы ему было полезно постоянное улучшение, но при этом не нуждаться в полноценном эволюционном поиске по популяции. Команды могут взять из DarwinX основной принцип: превращать типичные ошибки и отзывы сотрудников в предлагаемые изменения промтов, рабочих процессов, операций с базами данных, вызовов функций или интеграций, а затем проверять эти изменения на регрессионном наборе. Если задача не оправдывает хранение полноценной популяции вариантов, может хватить более простой линейной стратегии или поиска по лучшим кандидатам.
Читайте также
 Anthropic сворачивает Claude Cowork в чат Claude и запускает Claude Docs и Claude Slides
 Microsoft выпустила новый ИИ-плейбук для бизнеса: неожиданный «ров» уже может быть у вас
 Трамп создаст «ИИ-силы» для контроля ИИ на фоне страха перед неуправляемыми агентами
 Anthropic запустила Claude Code Projects — «всегда на связи» помнит и распределяет долгую разработку
 Австралия почти не подготовилась к угрозам ИИ. Где блестящее руководство, когда нужно?
 Трамп предлагает дать ИИ новое имя и заявил о создании ИИ-сил
 Google: Dream-RSI сокращает вызовы агента для поиска до 162 раз, повторяя свои поиски
 Ответы на ваши вопросы об ИИ-апокалипсисе: «Могут ли такие люди, как я, хоть что-то сделать?»
 ИИ сокращает цикл разработки чипов до нескольких недель
 OpenAI против Anthropic: разрыв между платформами ИИ-агентов
 ИИ: максимизация или оптимизация человеческой когнитивной осознанности
 Почему инженеры внедрения вдруг оказались так востребованы
 ИИ может сократить ваши затраты — и всё равно оставить вас позади
 Google теперь просит пользователей записывать видео-селфи для подтверждения личности
 Новая ИИ-кормушка Petlibro меняет правила игры в домах с несколькими кошками
 Unity выпустила плагины для Claude Code и OpenAI Codex, чтобы ИИ-агенты не брали устаревшие уроки
 Директор Microsoft признал: ИИ крадёт контент СМИ, создавая «петлю гибели» и делая себя бесполезным
 Разговоры о безопасности ИИ становятся всё более неправдоподобными
 Qwen3.8-Omni-Flash дешевле Google Gemini Flash, но не уступает в мультимодальных тестах
 Политики обеих партий боятся выступить против ИИ, хотя подавляющее большинство их электората этого хочет
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram