
ИИ-агенты превратились из отдельных моделей в сложные системы, объединяющие модели, инструменты и среды выполнения. Их возможности всё больше зависят от внешнего пайплайна, который управляет работой модели. Обучение с подкреплением помогает улучшать агентов за счёт проб и ошибок с наградами и штрафами. Но во многих системах для такого обучения разработчикам приходится заново собирать агента внутри обучающего фреймворка. Это требует ресурсов и может привести к тому, что обученная версия будет вести себя не так, как агент, запущенный в рабочей среде.
Исследователи Microsoft Research Asia предложили подход Harnessed Agentic RL и открыли исходный код полностью переработанного Agent Lightning v1.0. По сравнению с предыдущей версией новая система рассчитана на компактную реализацию, работу с настоящими агентскими пайплайнами и воспроизводимый полный цикл обучения.
В Agent Lightning v1.0 исследователи выделяют несколько изменений:
Ограничения традиционного обучения агентов
Традиционные системы обучения агентов с подкреплением предполагают, что цикл взаимодействия со средой контролирует сам обучающий фреймворк. В цикле типа ReAct модель предлагает действие, среда возвращает наблюдение, оно добавляется в контекст, после чего модель выбирает следующий шаг. Весь запуск при этом представляется одной непрерывной последовательностью токенов. Так были устроены ранние системы, включая verl, AReaL и slime: чтобы обучать агента, его цикл приходилось заново реализовывать внутри фреймворка.
Настоящие агентские пайплайны устроены сложнее. Инструменты для программирования — mini-SWE-agent, OpenHands, OpenCode, Claude Code и Codex — используют собственное управление контекстом, протоколы инструментов, логику выполнения и зависимости. То же относится и к универсальным агентским системам. Повторная реализация требует много работы, а её результат может отличаться от агента, который используют после обучения.
Agent Lightning предлагает другой подход: между агентом и моделью ставится прокси для LLM. Агент продолжает работать как раньше — достаточно направить в Agent Lightning конечную точку, которая прежде обращалась к API модели. Обучающий фреймворк сможет наблюдать за запросами агента к модели и записывать их. В версии 1.0 этот подход получил формальное название Harnessed Agentic RL: во время обучения с подкреплением используется тот же агентский пайплайн, что и при работе агента в реальной среде.
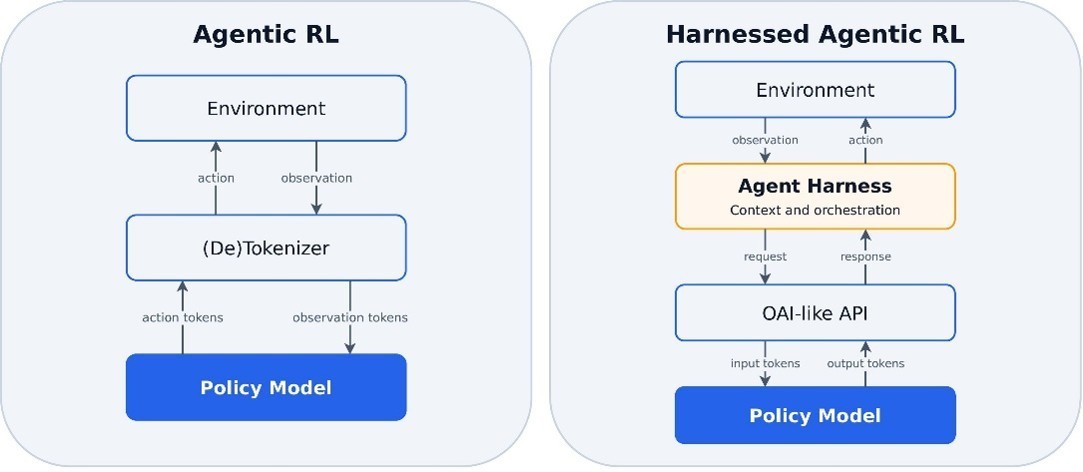
Традиционное агентное обучение с подкреплением в сравнении с агентным обучением с подкреплением под управлением harness. В традиционном агентном обучении с подкреплением обучающая система управляет средой и циклом агента. В агентном обучении с подкреплением под управлением harness harness управляет и тем и другим
Источник: microsoft.com
Четыре сложности обучения с настоящими пайплайнами
В Harnessed Agentic RL цикл взаимодействия со средой контролирует агентский пайплайн, а не обучающий фреймворк. Поэтому обучающая система видит только последовательность запросов и ответов LLM, а один запуск агента может разделиться на разное число обучающих образцов. Это создаёт четыре сложности:
Полный управляющий контур за 3 500 строк кода
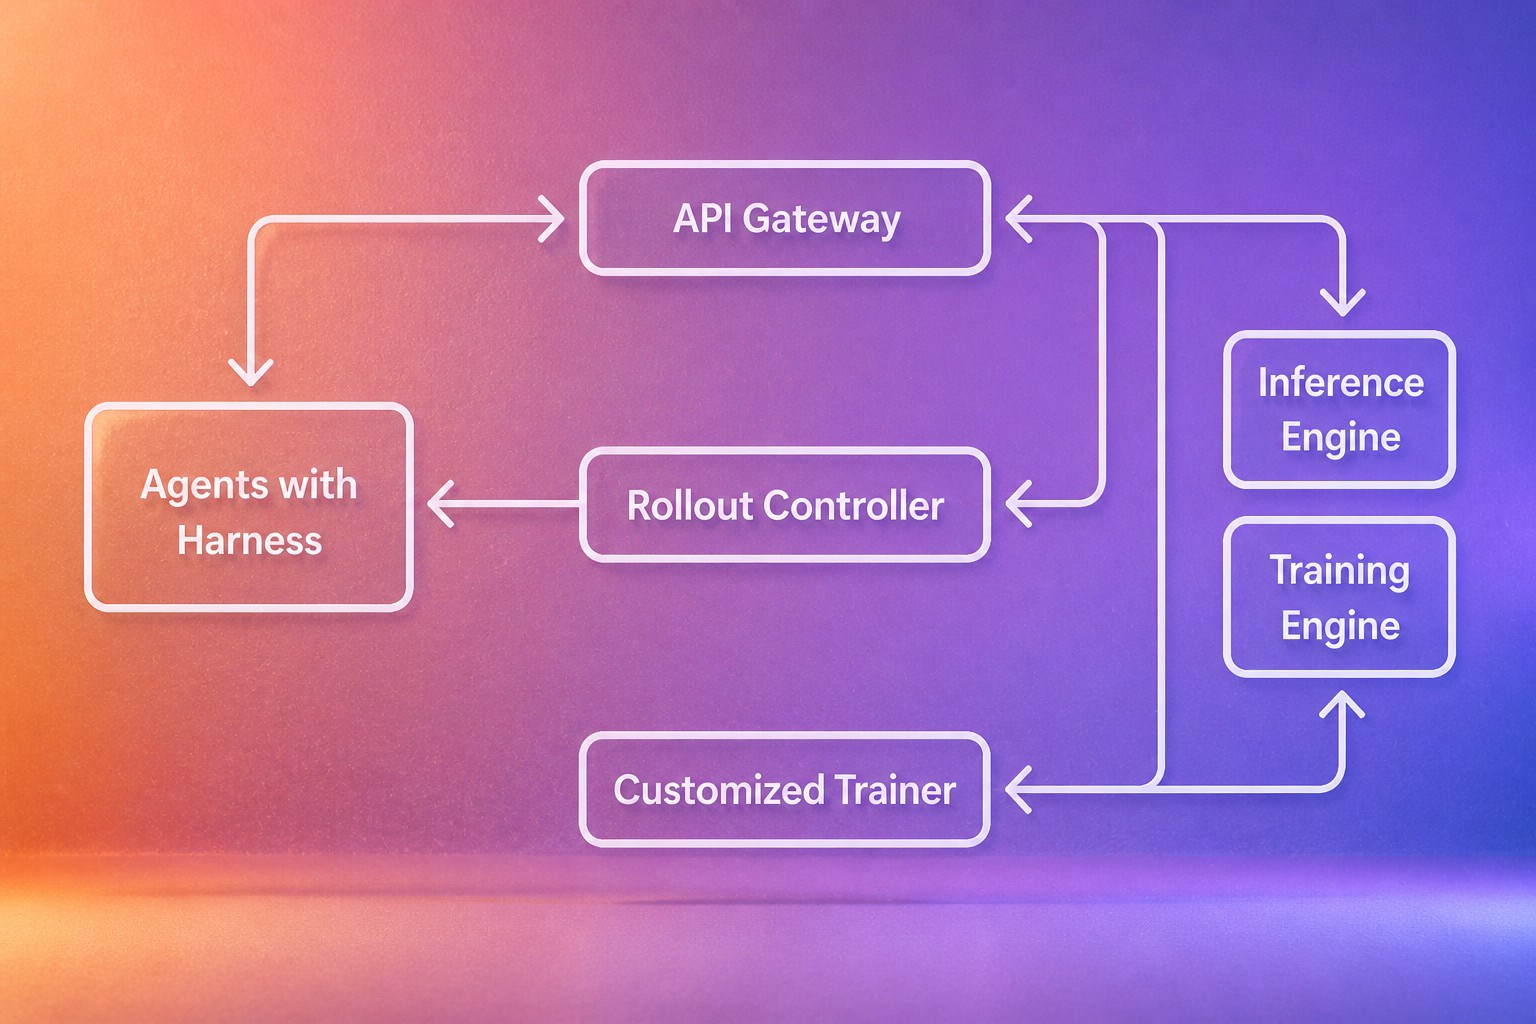
В Agent Lightning v1.0 простота заложена в основу архитектуры. Фреймворк занимает около 3 500 строк кода и состоит из трёх основных компонентов: API Gateway, Rollout Controller и Customized Trainer.
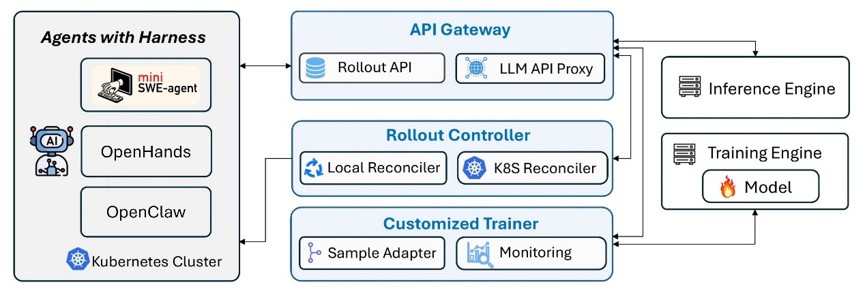
Архитектура системы Agent Lightning v1.0: шлюз API, контроллер выполнения и настроенный тренер
Источник: microsoft.com
API Gateway хранит запуски агентов, модели и события, а также работает как совместимый с OpenAI прокси для LLM. Он связывает каждый вызов модели с соответствующим запуском и записывает промты, ответы и логарифмы вероятностей, необходимые для обучения.
Rollout Controller запускает и управляет агентами — как локальными процессами или обычными задачами Kubernetes. Благодаря этому выполнение агентов отделено от обучающей системы.
Customized Trainer построен на verl. Он создаёт запуски, ждёт их завершения, собирает образцы и формирует итоговые обучающие данные через адаптер образцов. Поэтому для подключения существующего агентского пайплайна к обучению с подкреплением обычно достаточно направить конечную точку модели на прокси Agent Lightning.
Асинхронное обучение на общих GPU
Продолжительность запусков агентов сильно различается. При синхронном обучении система ждёт самого медленного агента в группе, а GPU простаивают. Полностью асинхронный режим повышает загрузку, но требует отдельных пулов GPU для запуска агентов и обучения. В Agent Lightning v1.0 эти задачи можно выполнять асинхронно на одном наборе GPU.
Когда система соберёт достаточно запусков, начинается обновление модели: API Gateway временно прекращает принимать новые запросы и ждёт завершения уже начатых. После обновления запуск агентов возобновляется. Для внешнего агентского пайплайна этот переход незаметен.
В экспериментах такой подход обеспечил примерно двукратное ускорение полного цикла по сравнению с синхронным обучением и потребовал меньше GPU, чем обычное асинхронное обучение.
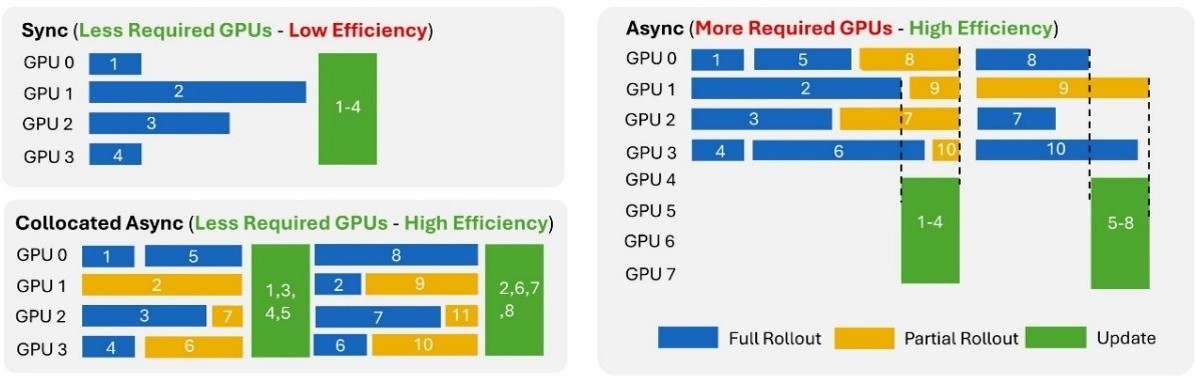
Синхронное обучение с подкреплением, асинхронное обучение с подкреплением и совмещённое асинхронное обучение с подкреплением в сравнении. Совмещённое асинхронное обучение с подкреплением повышает загрузку, занимая меньше графических процессоров
Источник: microsoft.com
Запуск агентов в Kubernetes
Для сбора достаточного количества запусков нужно одновременно выполнять много агентов, что требует значительных ресурсов процессора, памяти и вычислений. Другие фреймворки Harnessed Agentic RL часто размещают агентов в коммерческих песочницах, таких как Modal Sandbox или E2B, где расходы быстро растут при масштабировании.
Agent Lightning v1.0 запускает агентов как обычные задачи Kubernetes. Для этого можно использовать собственные кластеры, облачный Kubernetes или локальную инфраструктуру. Такой способ эффективнее задействует имеющиеся ресурсы, снижает стоимость масштабных запусков и сохраняет весь пайплайн открытым и воспроизводимым.
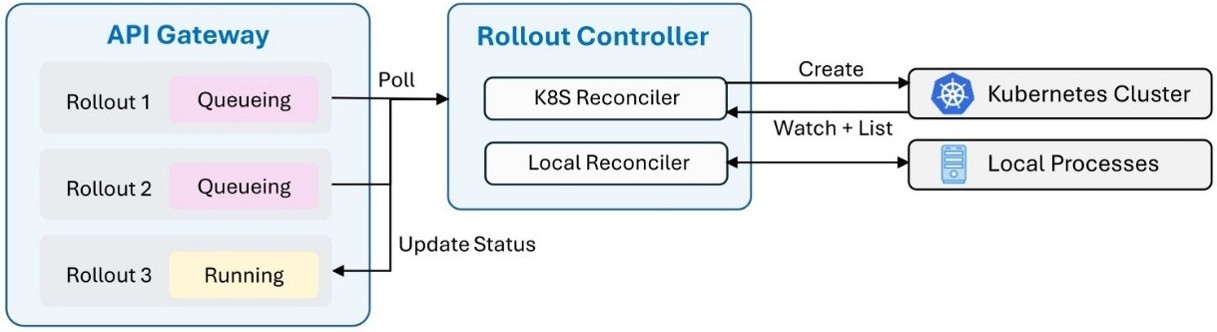
Контроллер выполнения в Agent Lightning v1.0 поддерживает Kubernetes из коробки и запускает агентов напрямую как стандартные задания Kubernetes
Источник: microsoft.com
6 000 образцов и прирост на 14,6 процентного пункта
Чтобы проверить подход, исследователи собрали полный пайплайн на основе SWE-smith, mini-SWE-agent и Qwen3.5-9B. Он охватывает очистку данных, создание среды выполнения, защиту от поиска лазеек в системе вознаграждений и обучение с подкреплением. В обучающем наборе около 6 000 образцов; масштабные вычисления для этого не требуются.
Одно только обучение с подкреплением повысило результат Qwen3.5-9B на SWE-bench Verified с 41,8% до 56,4% — на 14,6 процентного пункта.
Эксперименты с агентом для программирования также подтвердили выводы исследователей о расчёте преимущества и нормализации функции потерь. По сравнению с обработкой на уровне отдельных образцов расчёт преимущества и нормализация на уровне запуска дают более высокую награду на проверке и помогают поддерживать стабильность энтропии политики во время обучения.
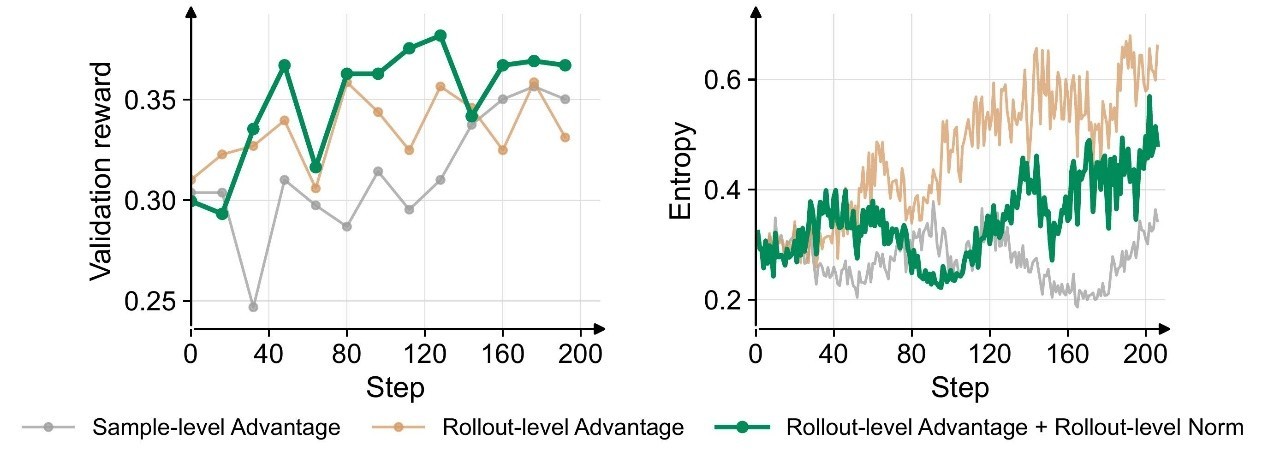
Доля успешных ответов и энтропия политики для Qwen3.5-9B на проверочном наборе SWE-smith
Источник: microsoft.com
Публикация и авторы
С работой связан материал Agent Lightning v1.0: Towards Harnessed Agentic RL.
Жиюань Хэ — инженер-исследователь по разработке программного обеспечения II.
Юйцин Ян.
Читайте также
 Пентагон рассчитывает ускорить закупки ИИ для «цепочки поражения» с помощью пятиминутных видео
 Отставной полковник ВВС предупреждает: жизнь рядом с дата-центрами опасна — вас могут атаковать или убить
 Новый сайт Google распознаёт созданные ИИ изображения, видео и аудио с помощью SynthID
 Австралия строит всё больше жилья. Но не тормозит ли бум дата-центров стройку домов?
 Тэтчеризм через Walkman: культурологические исследования Стюарта Холла в Британии сохранили в цифровом архиве
 McDonald’s обвинили в нарушении антимонопольных законов из-за ИИ-инструмента для расчёта цен во франшизах
 OpenAI хочет поручить своему новому агенту всю вашу жизнь. Мой признался мне в любви
 Проверка выявила: ChatGPT for Teens от OpenAI — «небезопасная» неразбериха
 Ваша следующая любимая книга может получить знак «органическая»
 Достаточно ли регулирования, чтобы ИИ не уничтожил человечество?
 Теперь Claude можно открыть прямо в Google Docs, Sheets и Slides — и наоборот, файлы Google можно открывать и редактировать в Claude
 Сэм Альтман-миллиардер просит не бояться ИИ: риски достаются нам, деньги — ему
 Главное препятствие для ИИ-агентов — сайты, которые не пускают их внутрь
 Бывшие инженеры Ramp привлекли $20 млн на платформу Melius после отказа от первого продукта
 Qualcomm против Arm: продолжение истории — спор не только о лицензиях
 Австралийский регулятор по защите данных начал расследование компании из Китая, создавшей приложение для «очков извращенца» Kmart
 Moment Energy и морские контейнеры, набитые старыми батареями электромобилей
 LibreOffice: отсутствие ИИ становится преимуществом программы
 Трамп дал понять: его власть всё теснее переплетается с ИИ
 Новая модель Google Nano Banana 2.1 создаёт изображения лучше и дешевле
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram