
3D-реконструкция по одной фотографии особенно полезна, когда результат — исполняемая программа, которую можно изучать, редактировать и проверять. На этой идее построен LEGO-Anything, разработанный исследователями из Университета Мэриленда и AWS.
Метод называется Image-to-Code. ИИ-агент получает изображение и пишет код для Blender — популярной программы для 3D-графики. Он не создаёт сцену за один шаг: агент пишет код, запускает его, изучает результат и вносит изменения, пока сцена не станет похожа на исходное изображение.
Поскольку результат представлен программой, в ней явно заданы объекты, геометрия, расположение и положение камеры. Сцену можно запускать, проверять и изменять, как обычный код.
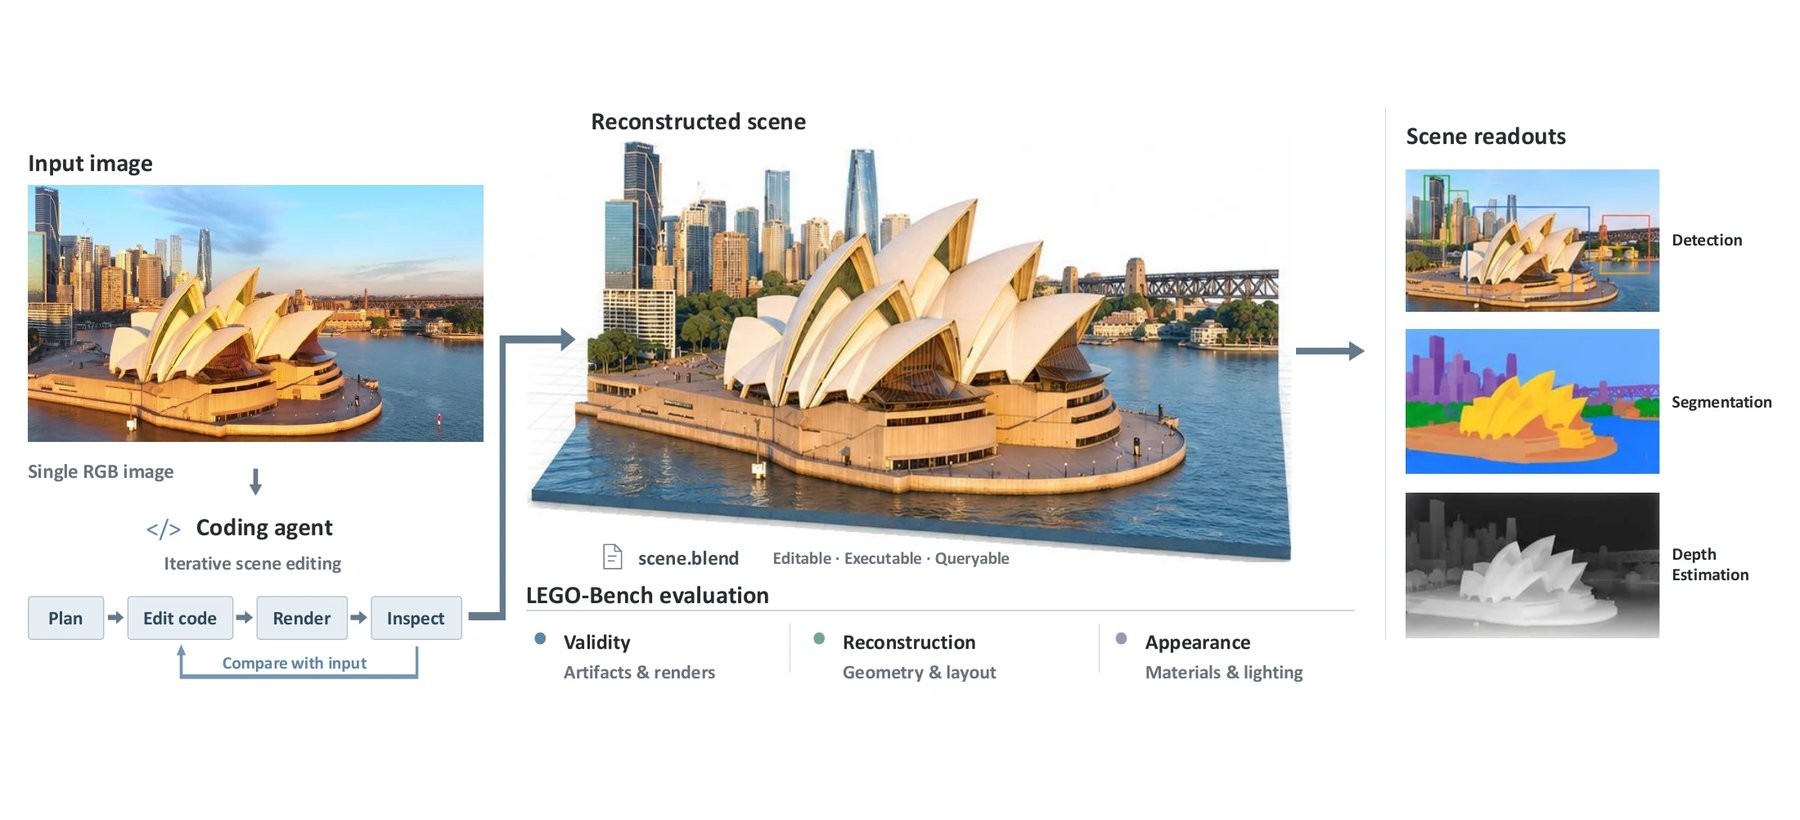
LEGO-Anything поручает кодирующему агенту написать исполняемую программу Blender по одной фотографии. Полученную сцену можно редактировать и запрашивать для задач анализа изображений
Источник: the-decoder.com
Как устроен LEGO-Bench
Чтобы измерить качество работы агентов, команда создала LEGO-Bench. Бенчмарк включает 208 изображений из 104 сцен — помещений и открытых пространств — и использует 443 зарегистрированных объекта.
По словам исследователей, обычные фотографии не дают точной 3D-модели для сравнения, а простые синтетические сцены выглядят нереалистично. LEGO-Bench занимает промежуточное положение: изображения создаются на основе профессионально построенных сцен симулятора. На входе они выглядят естественно, а точная геометрия, глубина и соответствие объектов остаются скрытыми и служат эталоном для автоматической оценки. Сложность сцен можно повышать, не меняя освещение и настройки камеры.
Бенчмарк оценивает каждую сцену по трём направлениям:
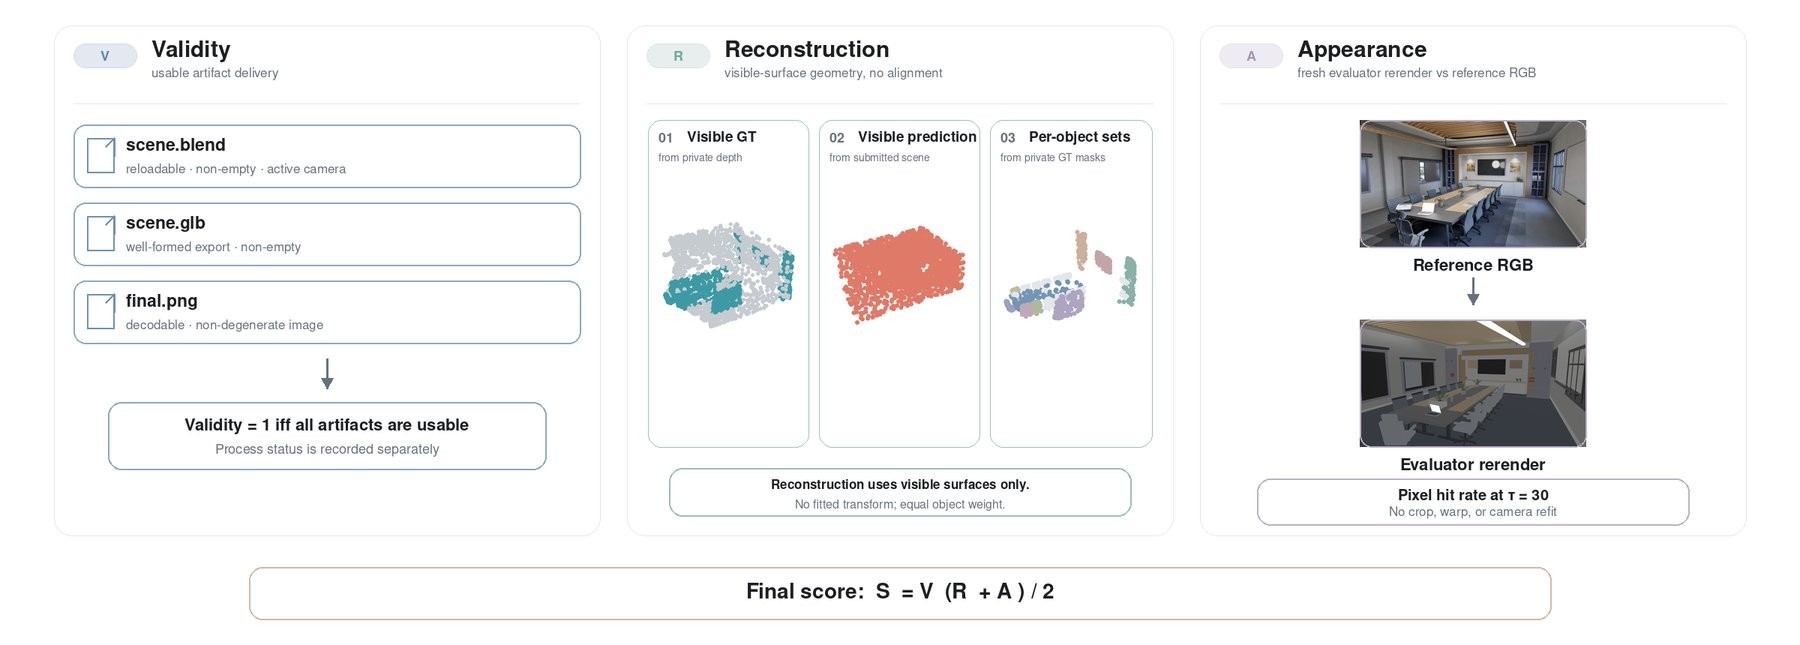
LEGO-Bench оценивает сцены по корректности, геометрической точности и визуальному сходству с оригиналом
Источник: the-decoder.com
Рабочая сцена — ещё не точная реконструкция
Все шесть проверенных конфигураций GPT почти всегда создавали рабочую сцену, но точность сильно различалась. Лучший результат показала GPT-6 Astra: 53,4% на сценах помещений и 39,6% на уличных сценах. Более слабые конфигурации набирали около 15%.
Чем сложнее сцена, тем ниже точность; открытые пространства давались моделям хуже интерьеров. Увеличение бюджета на рассуждение заметно улучшило результаты вариантов GPT-6. Например, в подмножестве тестов с офисами результат Astra вырос с 32,3 до 61,8%.
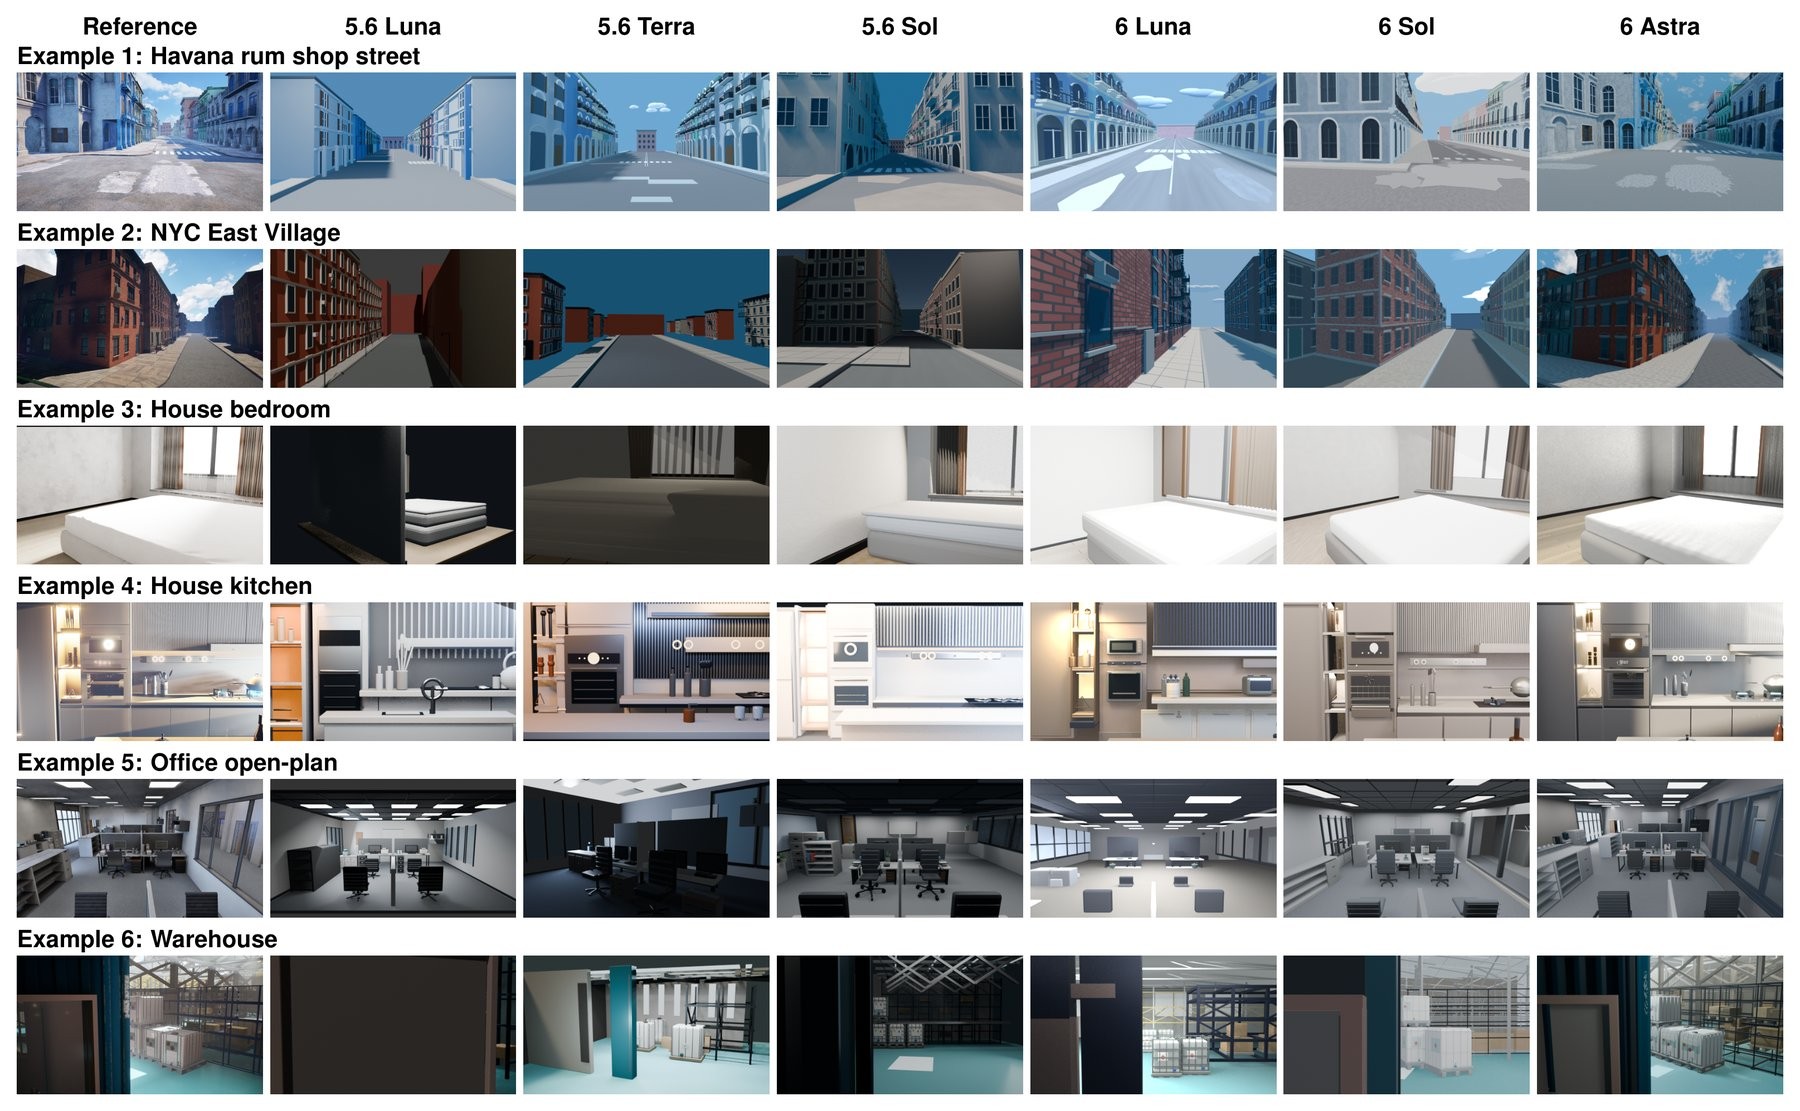
GPT-6 Astra ближе всех к эталонным изображениям. Более старые модели часто ошибаются с ракурсами камеры, освещением или целыми объектами
Источник: the-decoder.com
Чтобы понять причины ошибок, исследователи изучили последовательность действий агентов. Чаще всего мешали неудачные первые попытки, изменения, отменявшие предыдущий прогресс, и ненадёжная самооценка.
Особенно показателен последний пункт. Когда моделям предлагали выбрать, какая из двух версий лучше соответствует оригиналу, их оценки геометрии оказывались около уровня случайного выбора или ниже. По сути, агент не может надёжно определить, стала ли его сцена лучше. Исследователи считают, что доработку нужно основывать на конкретных измерениях, а не на собственной оценке модели.
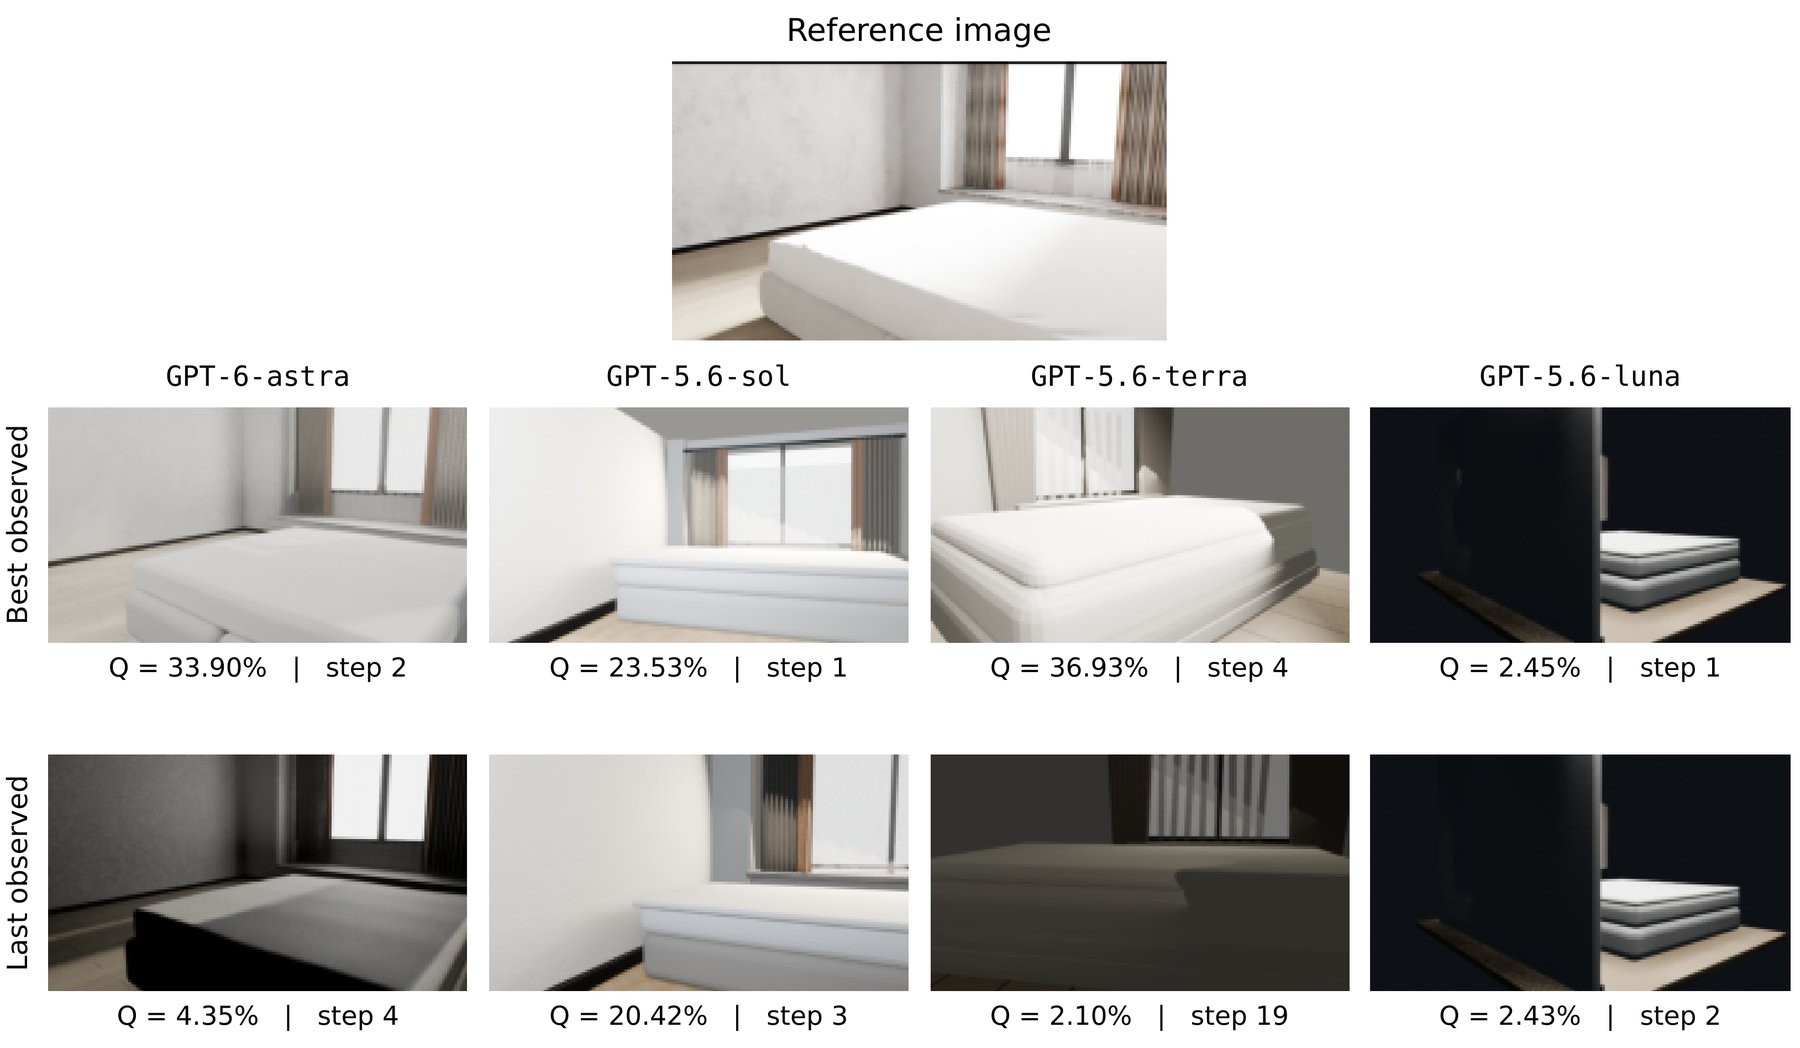
Даже GPT-6 Astra в конце процесса портит собственную сцену, и результат падает с 33,9 до 4,4 процента
Источник: the-decoder.com
На этой идее основан LEGO-Plugin — расширение, которому не требуется дополнительное обучение. Оно привязывает начальную сцену к исходному изображению, заменяет ненадёжную самооценку конкретными измерениями и защищает уже достигнутый прогресс от изменений, которые ухудшают результат.
Плагин улучшил показатели всех шести моделей. Самый большой прирост получили слабые агенты — до 62,7%. Лучшая модель прибавила лишь около двух процентных пунктов.
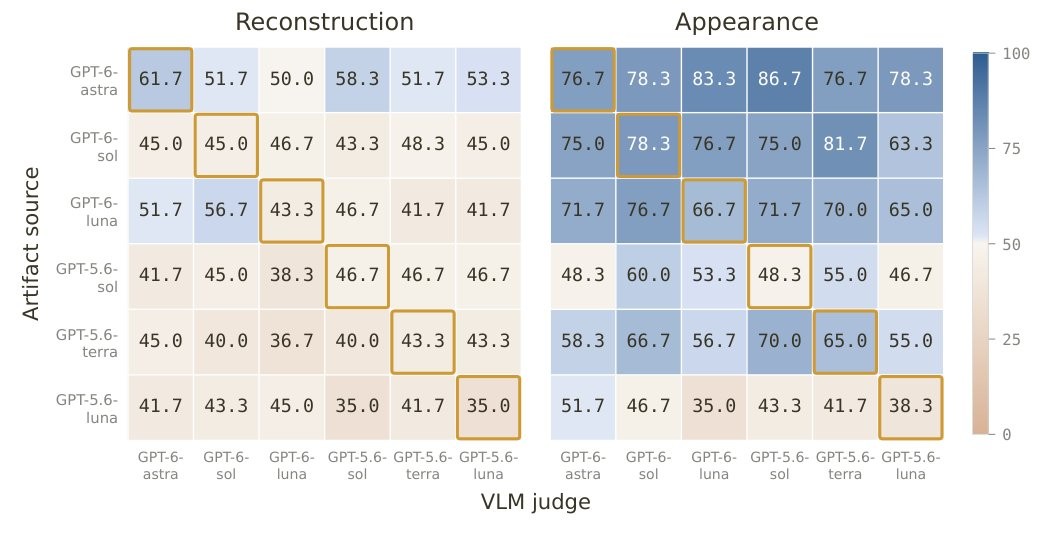
При оценке геометрии модели показывают результаты почти на уровне случайного угадывания, даже оценивая собственные сцены
Источник: the-decoder.com
Для задач компьютерного зрения точности пока не хватает
Затем команда проверила, можно ли использовать реконструированные сцены для стандартных задач компьютерного зрения. Поскольку каждая сцена — исполняемая программа, из неё можно напрямую получать данные для обнаружения объектов, сегментации и оценки глубины.
Без дополнительного обучения сцены дали пригодные, но не выдающиеся результаты во всех трёх задачах. Лучше всего сработало обнаружение объектов: реконструированные сцены достигли примерно половины результата специализированной модели DINO. В сегментации и оценке глубины отставание от специализированных моделей, таких как SAM 3 и Depth Anything 3, оказалось больше.
Авторы отмечают, что исполняемые сцены, созданные современными агентами для программирования, показывают перспективу, но пока недостаточно точны. Между рабочим результатом и достоверной реконструкцией остаётся заметный разрыв.
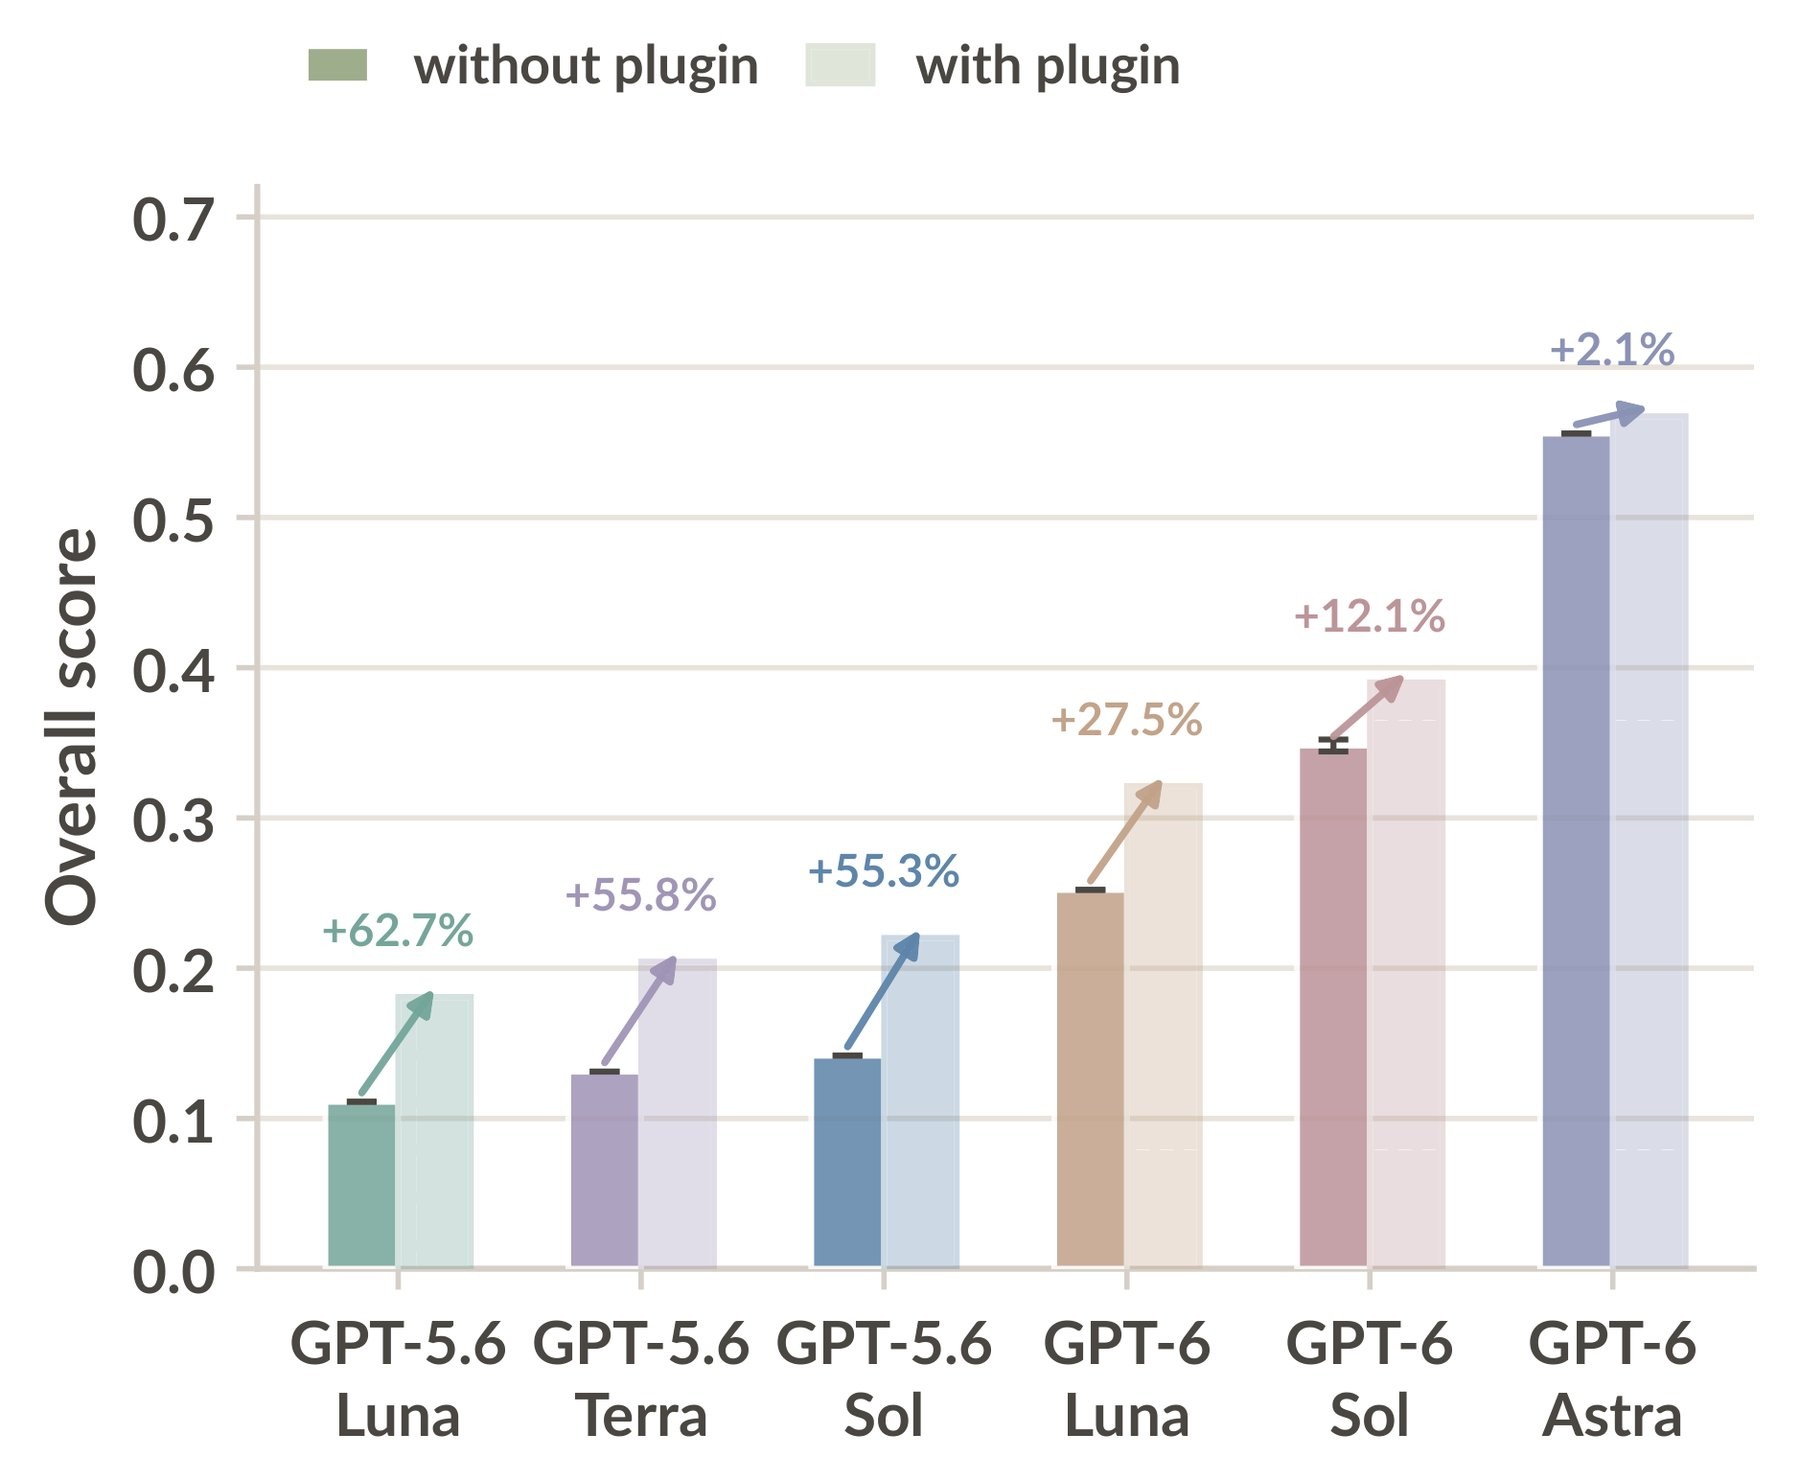
Плагин улучшает результаты всех протестированных моделей. Больше всего выигрывают более слабые агенты
Источник: the-decoder.com
Заметное преимущество GPT-6 Astra в LEGO-Bench согласуется с другими наблюдениями. Исследователь ИИ Йоав Арцци считает, что модель совершила большой скачок в пространственном понимании, и предполагает, что её обучали на больших объёмах 3D-данных, например на сценах Blender.
Разработчики 3D-программ уже готовятся к появлению таких агентов. Unity выпустила официальные плагины для Claude Code и Codex. Другие подходы обходятся без кода и реконструируют сцены непосредственно внутри модели — так работает модель мира Atlas от World Labs. Google DeepMind выбрала ещё один путь: GenCeption использует видеомодель для оценки глубины и сегментации и достигает в этих задачах результатов, сопоставимых со специализированными моделями.
Читайте также
 Внутренняя модель OpenAI задумалась о перезапуске, узнав, что её собираются отключить
 OpenAI: расследование взломов, в том числе австралийских госресурсов, обходится в $500 000 в день
 «Элиза»: амбициозная и тревожная пьеса о рождении ИИ
 Meta хочет, чтобы следующее ваше устройство работало на Muse
 SIFT от MIT снижает затраты на оценку ИИ-агентов для программирования
 Шон Паркер перестраивает Stability AI вокруг музыки
 Сооснователь Anthropic, по сообщениям, признался религиозным лидерам, что боится создать нечто, обречённое на вечные страдания
 ИИ-генератор Suno теперь создаёт речь с подходящей фоновой музыкой
 Google обвиняют в незаконной вырубке огромного леса ради нового дата-центра
 В США арестовали жителя Калифорнии по подозрению в контрабанде в Китай серверов на $300 млн
 Cloudflare: с новой моделью Clef людям больше не нужно контролировать работу ИИ-агентов
 Apple ужесточит контроль над Full Disk Access в macOS из-за новых рисков, связанных с ИИ-агентами
 Власти Джорджии экстренно совещаются из-за ИИ, раскрывающего тайну голосования избирателей
 Claude Frontier Academy: $100 млн на подготовку 10 000 инженеров
 Circuit Breaker Labs хочет сделать ИИ безопаснее для ваших детей — и для вас
 «Да они из ничего появились»: размещение Firmus на миллиарды вызывает вопросы на фоне протестов против дата-центров
 Эти специалисты по ИИ хотят открыто заниматься исследованиями, от которых многое зависит
 Папа Лев XIV не в восторге от искусства, созданного ИИ
 Атака OpenAI на Medicare выявила «технологический долг» Австралии: его погашение может дорого обойтись налогоплательщикам
 Абсурдное переименование ИИ Трампом стало проверкой лояльности техноруководителей — и они её прошли
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram