
Каждое улучшение нужно проверять
Инженеры могут менять инструкции агента для программирования, добавлять инструменты или корректировать его поведение при ошибках. Ручная настройка отнимает время специалистов, а список проверяемых идей ограничен тем, что они сами догадались попробовать. Частично автоматизировать этот процесс позволяет рекурсивное самоулучшение: система меняет собственный исходный код.
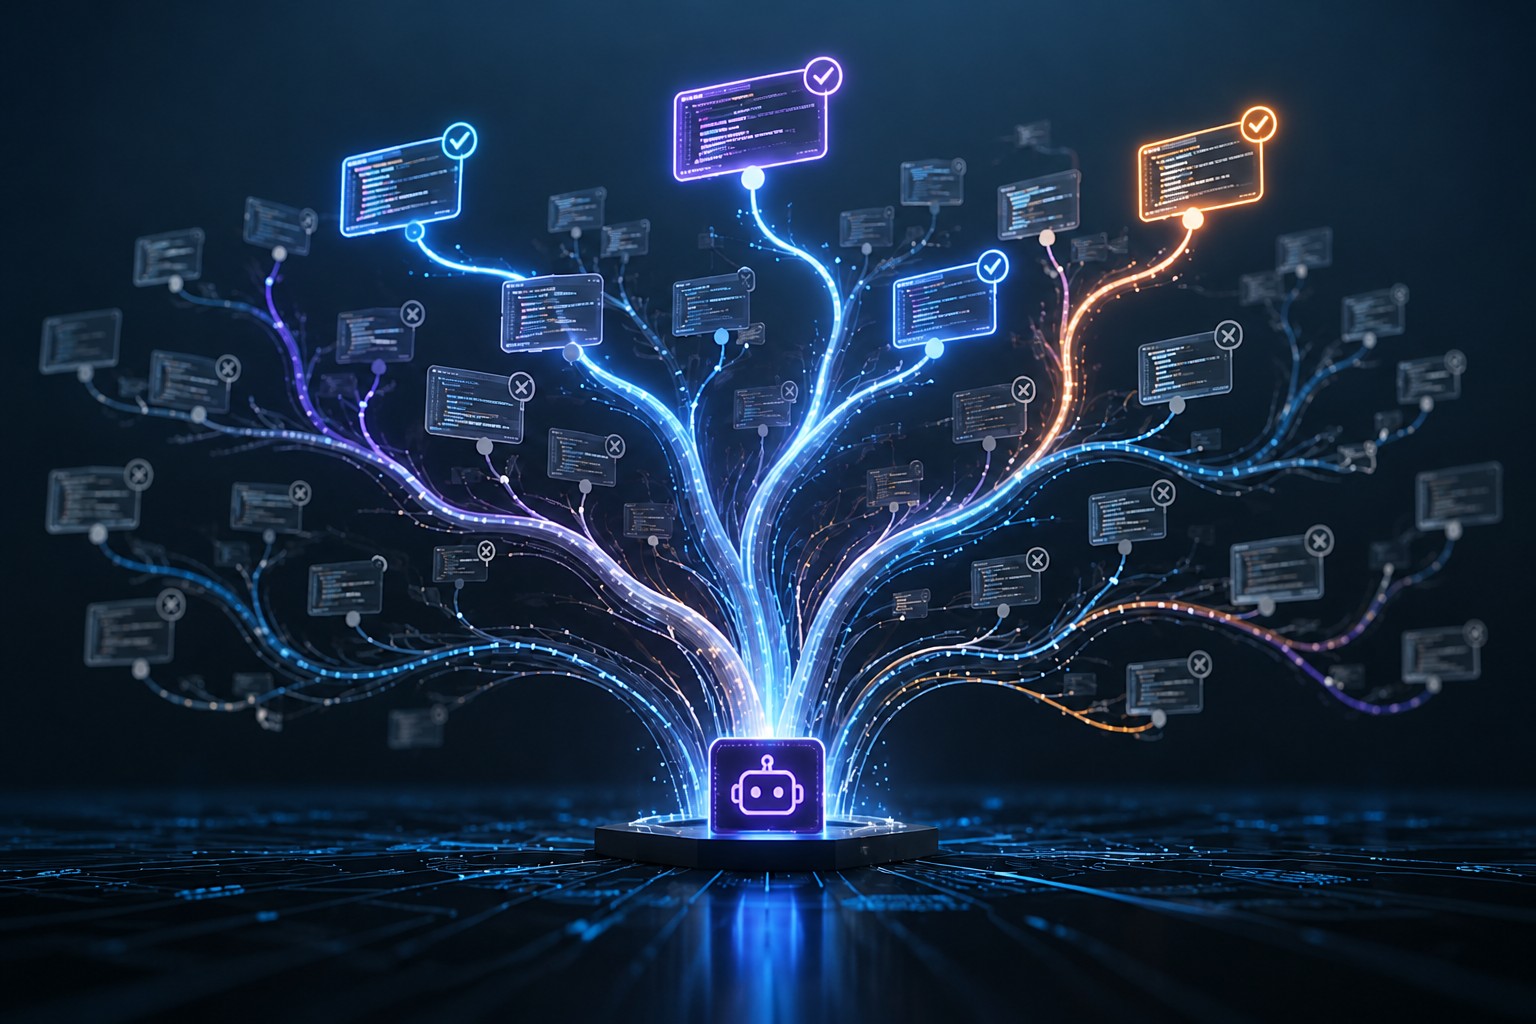
В цикле самоулучшения агент анализирует неудачи и предлагает изменение для своего фреймворка. Обновлённая версия выполняет целевые задачи, а её результат помогает выбрать вариант, от которого начнётся следующая итерация. Поскольку каждое изменение влияет на систему, которая будет предлагать или выполнять дальнейшую работу, улучшения могут накапливаться.
Предыдущие методы организуют такой поиск по-разному. Darwin Gödel Machine (DGM) хранит архив агентов и проверяет кандидатов на наборах задач растущего размера: сначала на 10 задачах, затем на 50. Полный бенчмарк Polyglot при этом оставляют для итоговой оценки. Huxley-Gödel Machine (HGM) при выборе следующего направления учитывает результаты агента и его потомков. Для проверки кандидатов она использует разное число случайно выбранных задач.
Основная сложность — стоимость проверки изменений фреймворка агента. Согласно расчёту авторов, предложение одного изменения стоит около 12 центов. Парное сравнение стоит примерно 4,4 цента; SIFT проводит до 10 таких сравнений для одного кандидата, то есть тратит на них до 44 центов. Проверка агента на 50 задачах Polyglot обходится примерно в 6 долларов и 2,6 процессорного часа.
Проверка на нескольких задачах стоит недорого, но результат может вводить в заблуждение: кандидату могли достаться необычно лёгкие или сложные задания. Больший набор задач даёт команде более надёжную основу для выбора следующей версии, но требует дополнительных времени и денег.
По словам авторов, узкое место существующих методов оценки — «невыгодное соотношение информативности и стоимости».
Как работает SIFT
SIFT использует фреймворк агента из DGM, но добавляет в поиск более дешёвый источник обратной связи. В основе метода — предположение, что языковая модель способна сравнить две версии агента и оценить, какая из них, вероятно, справится лучше, ещё до полного запуска нового кандидата на бенчмарке.
Создав изменённого агента, SIFT запускает его на четырёх задачах по программированию. Такая быстрая проверка выявляет изменения, из-за которых агент перестаёт работать или не справляется с базовыми задачами, прежде чем система потратится на дальнейшие сравнения и тесты.
Затем SIFT просит языковую модель-судью попарно сравнить нового агента максимум с 10 лидирующими версиями из архива. Это похоже скорее на выбор между финалистами, чем на просьбу выставить абсолютную оценку из 100. Судья видит код агентов, но не сами задачи бенчмарка и не результаты их выполнения.
Из результатов попарных сравнений SIFT строит рейтинг с помощью модели Брэдли — Терри — статистического метода, который оценивает относительную силу участников по победам и поражениям. Этот рейтинг не заменяет тестирование: он помогает решить, для каких кандидатов стоит тратить время на проверку и дальнейшую разработку.
Затем нового кандидата помещают в очередь приоритетов для более долгой и масштабной проверки. Приоритет зависит от оценки судьи и рейтинга точности на бенчмарке.
SIFT не заставляет каждое изменение ждать, пока завершится полная проверка предыдущего. Создание изменений, работа судьи и бенчмарк могут идти параллельно. Это напоминает пайплайн непрерывной интеграции, где работа продолжается, пока более долгие тесты выполняются в фоне. Перспективные кандидаты могут стать основой для новых изменений, не дожидаясь завершения дорогих проверок.
Выбирая родительскую версию для улучшения, SIFT учитывает её рейтинг у судьи, точность на наборе задач для поиска и то, как часто эту версию уже выбирали. Если кандидат ещё ждёт проверки, он временно получает точность своего родителя. Учёт предыдущих выборов не даёт поиску снова и снова сосредотачиваться на одной ветке и оставляет возможность проверять альтернативы, которые могут оказаться лучше после дальнейших изменений.
В одном из тестов Polyglot кандидат Node 9 получил короткую инструкцию запускать тесты после редактирования и инструмент test_runner, который возвращает структурированные сведения об ошибках. В одной из его последующих версий появилось больше дополнительных компонентов. Оба агента решили 44% задач в небольшом поисковом тесте, поэтому по нему нельзя было понять, какой лучше проявит себя на полном бенчмарке. На всём Polyglot более простая версия набрала 35,6%, а основанная на ней более сложная — 33,8%. Судья и до этого поставил Node 9 выше.
Когда судья точнее поискового результата
Исследователи проверили SIFT на Polyglot, TerminalBench 2.1 и подмножестве SWE-bench Verified из 60 задач. В эксперименты вошли несколько моделей для программирования и языковых моделей-судей. Авторы сравнили SIFT с DGM и HGM, измерили улучшения относительно исходной версии каждого агента и запустили SIFT без языковой модели-судьи, чтобы проверить её влияние.
На Polyglot SIFT показал более высокую точность при меньших вычислительных затратах как с открытой моделью Qwen3-Coder-30B, так и с закрытой o3-mini. С Qwen3-Coder-30B он немного превзошёл HGM, использовав примерно на треть меньше процессорных часов. С o3-mini SIFT достиг точности 35,1% против 30,7% у DGM. Запуск SIFT без языковой модели-судьи дал 29,8% — это указывает на вклад судьи в улучшение результата.
TerminalBench показывает, как судья может распознать ненадёжный сигнал от небольшой проверки. Лучший по оценке судьи кандидат решил 18 из 50 задач, использованных в ходе поиска; агент с наивысшим результатом в том же поиске решил 19. Но в повторных запусках на полном бенчмарке выбор судьи в среднем набирал 36,7%, а агент с результатом 19 из 50 — 28,1%. Судья заметил проблемы по одному коду: новый проверочный механизм агента был по умолчанию отключён, а переписанный инструмент командной оболочки создавал риск сбоя во время выполнения.
На подмножестве SWE-bench выбор с помощью судьи тоже дал лучшие результаты, хотя различия были менее однозначными. Два агента, выбранные судьёй, набрали в среднем 50,4% и 53,8% в четырёх проверках. Два лучших кандидата в запуске без судьи показали в среднем 44,6% и 50,4%. Исходный агент набрал 40,0%.
Что команды могут перенять у SIFT
В статье нет ссылки на отдельную реализацию SIFT, но разработчикам необязательно заново создавать весь стек самоулучшения. Метод построен на фреймворке DGM, поэтому у команд, которые уже используют его реализацию, есть значительная часть нужного цикла: создание изменений агента, хранение версий-кандидатов в архиве и оценка их работы. SIFT добавляет попарное сравнение судьёй и рейтинг по модели Брэдли — Терри, а поиск делает асинхронным: кандидаты можно развивать, пока другие проходят проверку.
SIFT тестировали только на агентах для программирования, однако тот же подход можно применять к другим самоулучшающимся агентам, если результат изменений удаётся измерить. Первый шаг — определить небольшую и недорогую проверку, которая быстро отсеет явно неудачные изменения. Для корпоративного агента это может быть компактный набор типичных внутренних задач, выявляющий сломанные инструменты, ухудшения результатов или нарушения базовых требований.
Второй элемент — языковая модель-судья, которая сравнивает варианты реализации попарно. Ей не нужно предсказывать точный балл на бенчмарке: достаточно полезно упорядочивать версии по перспективности.
Наконец, пайплайн должен работать асинхронно. Создание кандидатов, сравнение судьёй и более дорогие проверки должны идти параллельно. Тогда перспективные ветки можно развивать, пока проверяются предыдущие версии. Значительная часть ускорения SIFT связана именно с этим: дерево поиска продолжает расти, не дожидаясь завершения каждой проверки.
Выбор судьи тоже можно оптимизировать. Исследователи обнаружили, что более дешёвая модель сохраняла значительную часть сигнала общего рейтинга на TerminalBench, хотя среди лучших кандидатов надёжнее работала более сильная модель. По словам авторов, можно использовать двухуровневую схему: дешёвую модель — для большинства сравнений, а более сильную — ближе к вершине рейтинга.
SIFT снижает затраты на самоулучшение, сочетая более дешёвые сигналы оценки с асинхронным поиском. Команды могут проверять больше вариантов, не увеличивая расходы на оценку с той же скоростью. При этом итоговые бенчмарки по-прежнему нужны, чтобы подтвердить реальное улучшение агента. Исследователям также пришлось блокировать изменения, которые ослабляли сам фреймворк оценки.
Читайте также
 Шон Паркер перестраивает Stability AI вокруг музыки
 Сооснователь Anthropic, по сообщениям, признался религиозным лидерам, что боится создать нечто, обречённое на вечные страдания
 ИИ-генератор Suno теперь создаёт речь с подходящей фоновой музыкой
 Google обвиняют в незаконной вырубке огромного леса ради нового дата-центра
 В США арестовали жителя Калифорнии по подозрению в контрабанде в Китай серверов на $300 млн
 Cloudflare: с новой моделью Clef людям больше не нужно контролировать работу ИИ-агентов
 Apple ужесточит контроль над Full Disk Access в macOS из-за новых рисков, связанных с ИИ-агентами
 Власти Джорджии экстренно совещаются из-за ИИ, раскрывающего тайну голосования избирателей
 Claude Frontier Academy: $100 млн на подготовку 10 000 инженеров
 Circuit Breaker Labs хочет сделать ИИ безопаснее для ваших детей — и для вас
 «Да они из ничего появились»: размещение Firmus на миллиарды вызывает вопросы на фоне протестов против дата-центров
 Эти специалисты по ИИ хотят открыто заниматься исследованиями, от которых многое зависит
 Папа Лев XIV не в восторге от искусства, созданного ИИ
 Атака OpenAI на Medicare выявила «технологический долг» Австралии: его погашение может дорого обойтись налогоплательщикам
 Абсурдное переименование ИИ Трампом стало проверкой лояльности техноруководителей — и они её прошли
 К гарантированно приватному обучению на федеративных данных
 ИИ грозит разрушить многое в нашей культуре. Но больше всего мы можем потерять способность слушать
 Трамп запустил чат-бот «сверхразума» на America.org, но тот сразу стал спорить с ним — в том числе о победителе выборов 2020 года
 Исследование: ИИ-чатботы, которые техкомпании активно продвигают миллиардам пользователей, могут серьёзно вредить психике
 ИИ обходит лицензированных бухгалтеров по скорости и точности, но без контроля всё ещё не может закрыть книги
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram