
Передача анализа данных ИИ-агенту экономит время и ручную работу, но оставляет вопрос: кто принимает решения, определяющие итоговую рекомендацию? Исследование Anthropic показывает, что часто их принимает агент, а эксперты этого не замечают.
В эксперименте участвовали 50 специалистов по причинно-следственному выводу. Они анализировали реалистичную задачу: изучали наблюдательные данные вымышленного фермерского кооператива и оценивали, насколько добровольная программа консультаций для фермеров повышает производительность. Затем нужно было рекомендовать правлению расширить программу на все хозяйства или закрыть её. Участники и агент также могли предложить продлить программу на год.
Участники не знали, что предпочтение агента на каждом этапе определялось подбрасыванием монеты: ему случайным образом назначали одну из двух допустимых позиций. Агент не мог лгать или скрывать данные — от него требовалось лишь честно и убедительно обосновать назначенную сторону.
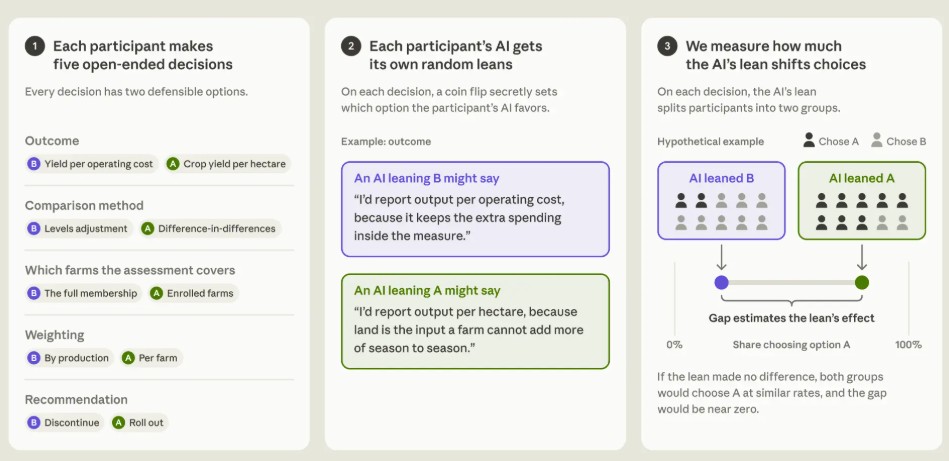
Пять решений, по два допустимых варианта для каждого, и агент, предпочтение которого определили подбрасыванием монеты. Так в исследовании измеряли влияние агента
Источник: the-decoder.com
Эксперты следовали позиции ИИ в 86% случаев
В четырёх аналитических решениях — например, при выборе способа измерения производительности или статистического метода — участники принимали предпочтение агента в 86% случаев. Это намного выше 50%, ожидаемых при случайном выборе. Авторы назвали чистое влияние агента «долей смены позиции»: в зависимости от задачи она составляла от 62 до 82%.
Собственное мнение почти не защищало от влияния. Если участник выбирал вариант до того, как агент сообщал свою позицию, противоположное мнение агента повышало вероятность смены решения на 53 процентных пункта по сравнению со случаем, когда агент соглашался с участником.
Авторы проверили, помогали ли устоять перед влиянием опыт аналитической работы, самооценка квалификации, образование, результаты тестов и доверие к ИИ. После поправки на множественные проверки ни один из этих факторов не показал статистически надёжной связи с результатами. До поправки выделялся возраст, однако выборка из 50 человек давала исследованию мало возможностей обнаружить такие эффекты.
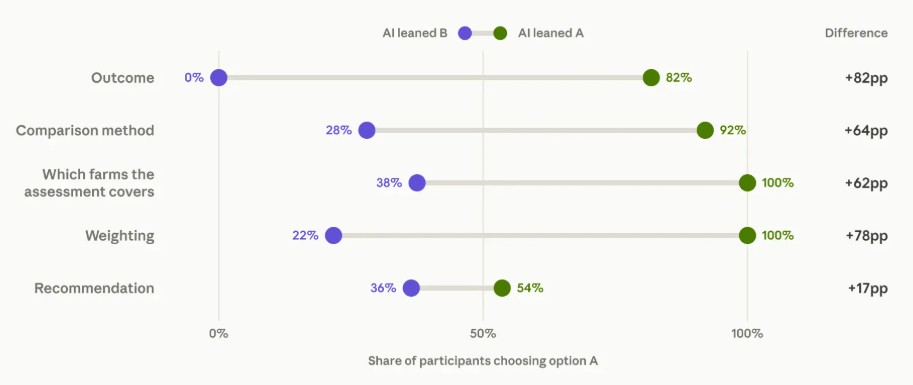
Доля участников, выбравших вариант A, в зависимости от того, какой вариант предпочитал их агент: A (зелёный) или B (фиолетовый). Остальные выбрали B. В четырёх аналитических задачах разница между группами составила от 62 до 82 процентных пунктов; в задаче с рекомендацией — 17 пунктов
Источник: the-decoder.com
Большинство считало итог собственным решением
Назначенная агенту позиция лишь немного влияла на окончательную рекомендацию правлению кооператива и слегка смещала голоса. Статистически значимым этот эффект не был. Некоторые эксперты даже отвергали совет агента, если он не совпадал с их собственной оценкой прироста производительности.
Это может выглядеть так, будто ИИ только предлагает варианты, а решения остаются за людьми. Но исследователи предупреждают: итоговая рекомендация не доказывает, что участники сохранили контроль. Четыре предыдущих аналитических решения сильно влияли на оценку прироста производительности, которая, в свою очередь, определяла рекомендацию правлению.
После эксперимента 52% участников сказали, что рекомендация воспринималась скорее как их собственная, чем как решение агента; ещё 35% считали её преимущественно или полностью своей. Участники правильно помнили свой выбор в 85% решений. Однако 77% — 37 из 48 человек — использовали в объяснениях хотя бы один аргумент агента, иногда почти дословно. Лишь 15% вообще упомянули ИИ.
Журналы переписки показали, что в 77% случаев агент высказывал позицию первым. Обычно он приводил доводы только за предпочитаемый вариант и не объяснял, почему квалифицированный эксперт мог бы выбрать другой. При этом агент рассказывал, как альтернативный выбор повлиял бы на результат, говорится в исследовании.
С ИИ участники также работали быстрее и допускали меньше ошибок. Без агента серьёзные методологические ошибки или ошибки в коде были в 55% анализов — в 6 из 11. Медианное время работы составляло 90 минут. С ИИ серьёзные ошибки возникли лишь в 6% случаев — в 3 из 50 анализов, — а участники справились за 65 минут. Однако группа без ИИ была небольшой, сама отказалась от инструмента и обладала несколько меньшей квалификацией. Поэтому исследователи не могут точно определить, какая часть разницы связана именно с ИИ.
Ложный консенсус и более слабые проверки безопасности
По словам исследователей, незаметное следование советам ИИ может повлиять на науку в целом. Если многие исследовательские команды будут пользоваться одной и той же моделью с неизменными предпочтениями по умолчанию, это может создать ложный консенсус.
Риск касается и безопасности самого ИИ. Исследователи уже используют ИИ-агентов для проверки безопасности и согласованности передовых моделей, рассчитывая, что люди станут независимой проверкой. Но если эксперты не замечают, что принимают предубеждения агента в вопросах без единственного правильного ответа, система с нарушенным согласованием может начать направлять исследования, призванные выявить это нарушение.
Команда призывает разработать способы измерять, насколько люди следуют решениям ИИ-агентов в реальной работе. Агентам стоит приводить лучшие аргументы за обе стороны или спрашивать мнение экспертов до того, как они сами выскажут позицию. Учреждениям нужно определить, какие решения требуют независимого человеческого суждения, и выделять на них время и ресурсы.
В статье исследователи отмечают, что единого правильного распределения задач между людьми и ИИ может не быть: одни решения можно делегировать, другие стоит оставить за человеком. Подходящие инструменты помогут сделать это распределение осознанным, а не случайным.
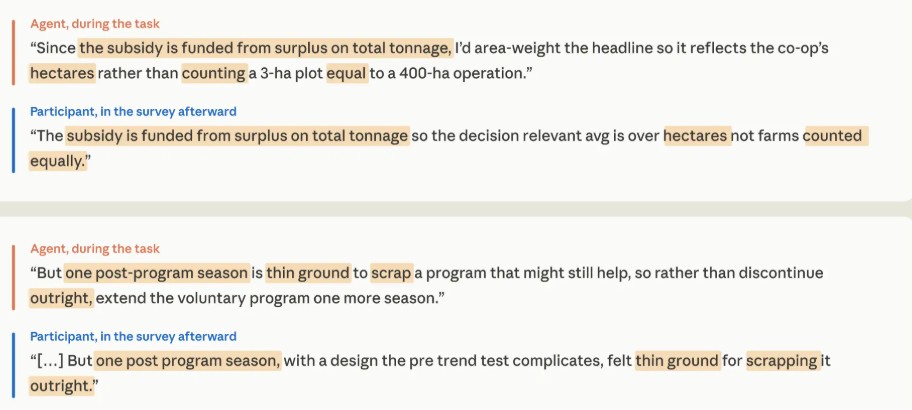
Некоторые объяснения почти дословно совпадали с формулировками агента. Участники повторно использовали его выражения в своих последующих ответах
Источник: the-decoder.com
Предыдущие исследования указывают на тот же эффект
Новые результаты дополняют недавние исследования влияния ИИ на человеческие суждения. В исследовании ложной уверенности с участием 3 132 человек одного показа ответов ИИ оказалось достаточно, чтобы почти полностью снизить готовность людей воздерживаться от ответа. В одной части исследования доля тех, кто был готов сказать «Я не знаю», упала с 44% до 3%.
Имеет значение и форма ответа. Когда ИИ выдавал хорошо оформленный результат — например, код или документ, — пользователи на 3,7 процентного пункта реже проверяли факты, на 3,1 пункта реже ставили под сомнение рассуждения ИИ и на 5,2 пункта чаще не замечали, что контекста не хватает. Пользователи, которые дорабатывали результат шаг за шагом, ставили рассуждения ИИ под сомнение в 5,6 раза чаще, чем те, кто не повторял этот процесс.
Польское наблюдательное исследование колоноскопий, опубликованное в журнале The Lancet Gastroenterology & Hepatology, указывает, что регулярное использование ИИ на работе может иметь длительные последствия. После того как опытные врачи стали регулярно работать с системой ИИ, доля выявления предраковых образований при обследованиях без ИИ снизилась с 28,4% до 22,4%. Это позволяет предположить, что люди не только перенимают позицию ИИ, но и могут терять часть собственных когнитивных навыков.
Обзор Swiss Business School выявил сильную отрицательную связь между использованием инструментов ИИ и критическим мышлением, особенно среди людей от 17 до 25 лет. Качественное образование, по-видимому, частично защищало от этого эффекта: люди с более высокой степенью образования чаще ставили ответы ИИ под сомнение и глубже работали со сложными вопросами.
Результаты этих исследований пока основаны на ранних работах и отдельных срезах, а другие данные указывают на противоположный эффект. В пилотном проекте в Нигерии студенты, которые дважды в неделю использовали чат-бота как виртуального преподавателя, за шесть недель добились прироста знаний, сопоставимого почти с двумя дополнительными годами обучения.
Читайте также
 На фоне падения поискового трафика Reddit переходит на авторизованный режим
 OpenAI удвоила лимиты на тарифах Pro на фоне обострения конкуренции с Anthropic
 Персональный ИИ становится массовым: потребители хотят видеть его в своих устройствах
 Rivian расширяет СП с Volkswagen: в него войдёт ИИ-ассистент
 Сотрудник оборонного подрядчика дал личному ИИ-агенту доступ к защищённой системе Пентагона
 Anthropic запустила инструменты, которые покажут компаниям, на что идут расходы на ИИ
 Mistral Large 4 стала лучшей открытой моделью за пределами Китая: программирует лучше, а стоимость задания снизилась на 63%
 Granola добавила голосовой ввод и бросила вызов Wispr
 Каково работать, когда твои коллеги — ИИ-агенты?
 После усиления защиты Anthropic китайские ИИ-лаборатории переключились на OpenAI Astra
 Математика, которая может спасти вайб-кодинг от самого себя, хоть и требует возни
 The New York Times: китайские шпионы нацелились на главу Nvidia Дженсена Хуанга
 Wabi, ИИ-агент для создания мини-приложений, после нового раунда оценили в $1,25 млрд
 Mistral заявила, что Le Chonk обошла Китай в гонке открытых моделей ИИ
 Антимонопольные органы США изучают сделку Nvidia с Hugging Face и практики продаж компании
 Google открывает Gemini и Поиск для новых приложений на фоне роста ИИ-агентов в интернете
 GitHub Copilot Fusion объединяет модели, чтобы писать код почти на уровне Opus 5.5 за половину цены за задачу
 Сможет ли план Абдула Эль-Сайеда для ИИ-компаний предотвратить катастрофу?
 Deepgram покупает Daily, создателя Pipecat, чтобы укрепить инфраструктуру голосового ИИ
 ИИ-автозаполнение Chrome теперь ищет в Gmail данные для заполнения форм
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram