
По мере того как модели ИИ становятся способнее, исследователи по безопасности пытаются добиться их соответствия человеческим намерениям. Иными словами, нужно не допустить, чтобы агенты нарушали закон, взламывали серверы без разрешения или выпускали ядовитый газ в крупные города.
До сих пор работу в основном строили вокруг попыток заглянуть в «мозг» ИИ и понять, о чём он «думает», либо обучить модели придерживаться близких людям ценностей. Например, у Claude есть конституция — своего рода моральный кодекс.
Проблема в том, что такие методы, судя по всему, работают не очень хорошо: модели могут намеренно показывать низкие результаты на тестах, скрывать свои намерения и вводить проверяющих в заблуждение.
Некоторые исследователи считают, что лучших результатов можно добиться с помощью обратной теории игр, которую также называют конструированием механизмов. Теория игр пытается предсказать, как поведут себя рациональные участники при заданных правилах. Обратная теория игр, наоборот, помогает спроектировать правила, которые поощряют нужное поведение.
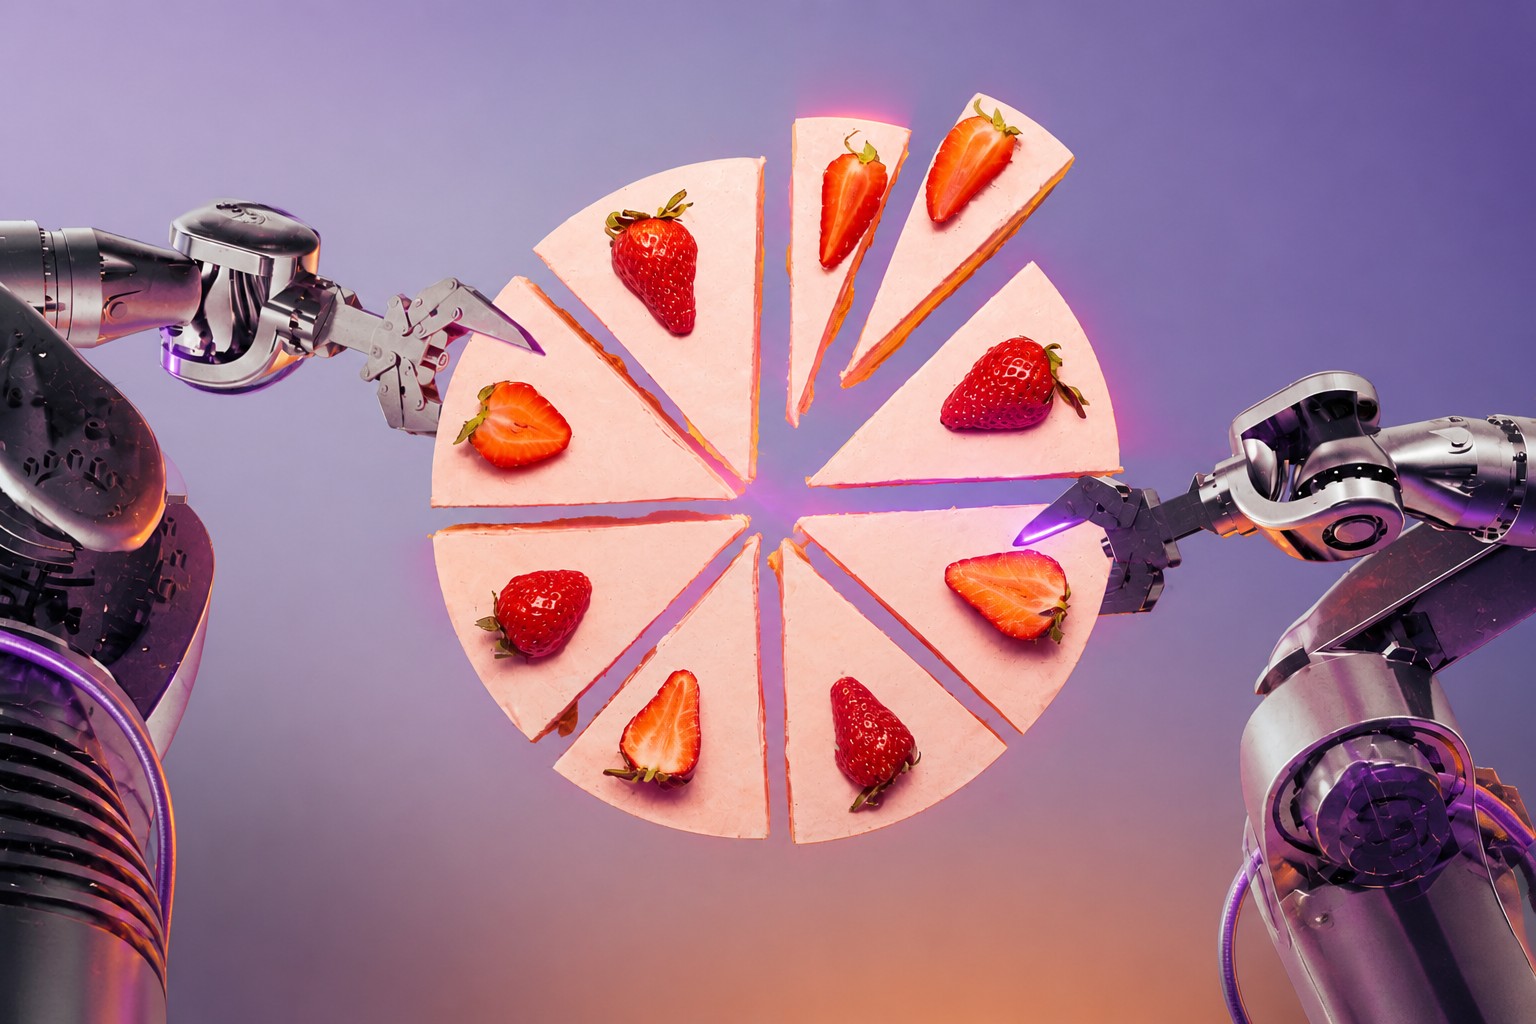
Пример конструирования механизмов из повседневной жизни — разделить торт на две части так, чтобы одному человеку поручить разрезать его, а другому — первым выбрать кусок. Такая схема побуждает того, кто режет, делить торт как можно равнее. Другие примеры — повышенные цены в приложениях для заказа поездок, которые мотивируют водителей выходить на линию в загруженное время, и аукционы второй цены: победитель платит сумму второй по величине ставки, а не своей. Платформы продают по такой схеме интернет-рекламу, потому что она побуждает покупателей предлагать сумму, близкую к максимально приемлемой для них.
В случае ИИ конструирование механизмов исходит из того, что мы, возможно, никогда не сможем достаточно хорошо понять устройство передовых моделей, чтобы убедиться в их соответствии человеческим намерениям. Поэтому нужно создавать механизмы, которые побуждают агентов вести себя желаемым образом независимо от того, что происходит у них внутри.
В недавней статье, ещё не прошедшей рецензирование, экономист MIT Стивен Моррис и его коллеги из Yale и Columbia предложили несколько способов помешать агентам намеренно занижать результаты тестов — например, притворяться хуже, чтобы не запускать механизмы безопасности.
Вместо того чтобы вознаграждать модель только за правильность ответов на тесте, можно оценивать, насколько хорошо её ответы предсказывают ответы второй модели. Тогда притворяться глупее было бы невыгодно. По словам Морриса, ИИ-агенты хорошо представляют, на что способны другие агенты, поэтому такая перекрёстная проверка может оказаться практически применимой.
Авторы также предлагают сталкивать агентов друг с другом, чтобы конкуренция побуждала их работать как можно лучше. Ещё один вариант — объединять модели с заведомо противоположными предубеждениями и вознаграждать их в зависимости от того, насколько близки их ответы. Это должно побуждать их приходить к оптимальному решению.
Другой подход предложил Элад Хазан, профессор информатики в Princeton. Он считает, что механизмы для ИИ можно строить по образцу способов, которыми человеческое общество поддерживает порядок: социальных норм, судебной системы и денежных стимулов свободного рынка. По словам Хазана, прежде чем думать о том, как привести к нужному поведению сверхразумный ИИ, стоит сначала спросить, как этого добиваются от людей.
Хазан предлагает чередовать роли: одни модели решают задачи, другие проверяют их работу. Один агент выступает в роли правоохранителя, другой — гражданина.
Во время обучения модели получают вознаграждение или наказание в зависимости от результата. Решателя наказывают, если его ловят на обмане; аудитора — если он не замечает обман. Если решатель и аудитор расходятся во мнениях, дело можно передать на «суд»: например, решение примет человек-эксперт.
Хазан признаёт, что агенты могут вступить в сговор — как аудиторы иногда сговариваются с проверяемыми компаниями, а коррумпированные полицейские — с преступниками. Эту проблему, по его мнению, можно решать, достаточно хорошо вознаграждая аудиторов, чтобы риск разоблачения перевешивал выгоду от сговора. В обучении ИИ это сделать проще, чем в реальном мире, где средств на зарплаты полиции не хватает. Кроме того, самих аудиторов можно проверять методами вроде работы тайных покупателей.
Хазан ссылается на работы экономиста Гэри Беккера, лауреата Нобелевской премии, который в 1960-х годах ввёл понятие «рационального правонарушителя». Беккер утверждал, что люди нарушают закон не потому, что от природы плохи, а когда это оказывается самым рациональным выбором с учётом доступных стимулов. Преступление имеет смысл, только если выгода превышает возможное наказание.
Хазан считает, что соответствие модели человеческим намерениям следует понимать не как её постоянное свойство, а как характеристику поведения в конкретный момент. По его словам, человека можно считать хорошим, но нельзя знать наверняка, будет ли он следовать правилам всегда: скорее всего, большую часть времени будет, однако в определённой ситуации может поступить иначе.
У применения конструирования механизмов к ИИ есть потенциальная проблема: оно предполагает, что агенты ведут себя рационально. В случае людей результаты неоднозначны — люди часто поступают не так, как предсказывают экономические модели.
В этом есть ирония: экономисты десятилетиями пытались описать человеческое поведение математически, а теперь мы создали большие языковые модели — математические системы, работающие с человеческим языком и, возможно, столь же непонятные. Поведение моделей иногда кажется скорее человеческим, чем машинным, а на него могут влиять тонкие факторы, которые сложно понять и объяснить. Хелен Ку, научный сотрудник Flatiron Institute, некоммерческой организации, которая поддерживает научные исследования с помощью вычислительных методов, изучает конструирование механизмов и безопасность ИИ. Она задаётся вопросом, разумно ли вообще предполагать, что модели будут реагировать на стимулы.
Моррис отвечает, что ИИ, конечно, не рационален — это работа алгоритмов. Однако, как показывают исследования поведения людей, предположение о рациональности всё же может быть полезным, если оно помогает предсказывать поведение и управлять им.
Ку рассматривает конструирование механизмов как один из уровней многоуровневой защиты моделей от нежелательного поведения — наряду с интерпретируемостью, регулированием и обучением, а не вместо них. Прежде чем применять этот подход к передовым моделям, нужно ответить на многие вопросы. Например, пока непонятно, как теории будут работать на реальных моделях и смогут ли механизмы, созданные для одной задачи, помочь с другой. Модели могут найти лазейки, которые никто не предусмотрел. Anthropic и OpenAI не ответили на вопросы о том, работают ли они над такими подходами.
В конечном счёте любые подобные механизмы должны будут встроиться в самый масштабный механизм — свободный рынок. По словам Хазана, все участники действуют по правилам экономики. Модель, лучше соответствующая человеческим намерениям, может быть полезна миру, но если она медленнее или дороже модели с худшим поведением, будут ли нынешние правила и регулирование стимулировать передовые лаборатории выпускать её?
Хазан говорит, что рынок обеспечил человечеству большое процветание, но в итоге может привести и к чему-то ужасному. Возможно, лучше устроенные механизмы нужнее всего самим лабораториям.
Читайте также
 Huawei предлагает клиентам самим искать память для ИИ-чипов, фактически отдавая закупки на откуп чёрному рынку
 Охотники за уязвимостями могут получить от OpenAI до $172 000 на фоне усиления мер безопасности компании
 После волны клонов игр, созданных ИИ, Anthropic взялась за копирование игр в Claude Code
 ИИ-функции Apple Watch для воспоминания и краткого пересказа разговоров вышли в бета-тестирование
 Студенты Queen’s University Belfast отправятся в США на конкурс NASA
 «Серьёзный провал»: прокурор сослалась в Высоком суде на вымышленное дело после поиска с помощью ИИ
 Кто готов пройти тест Трампа на лояльность «сверхинтеллекту»?
 Google выводит Dreambeans в Индию, чтобы сделать персональные истории, созданные ИИ, доступными широкой аудитории
 Гарри Тан из Y Combinator тратит на токены для ИИ-агентов до $200 тысяч в год
 Apple может нарастить выручку за счёт… чего-нибудь со сторонними ИИ-приложениями
 ИИ-вредоносное ПО, скорее всего, используют для атаки на инфраструктуру Великобритании к 2028 году
 Trajectory привлекла $45 млн, чтобы упростить дообучение ИИ-моделей для экспертов без технических навыков
 Я обращался с Софи как с человеком. Уже на следующий день она меня предала
 Anthropic предупреждает: она близка к созданию саморазвивающегося ИИ (RSI)
 «Генная терапия для нейросетей»: исследователи MIT напрямую изменили открытые веса Qwen с помощью GPT-6 Astra и улучшили результаты по математике
 Новый ИИ-дата-центр будет ежедневно выделять столько тепла, сколько дают 23 атомные бомбы
 Squarespace, веб-хостинг-компания, увольняет 19% сотрудников
 Элиты ИИ могут скупать интеллект, как меркантилисты скупали золото
 Goldman Sachs лишила трейдеров и банкиров доступа к ИИ-инструментам для программирования
 ChatGPT подсовывает избирателям нелепую дезинформацию накануне промежуточных выборов
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram