
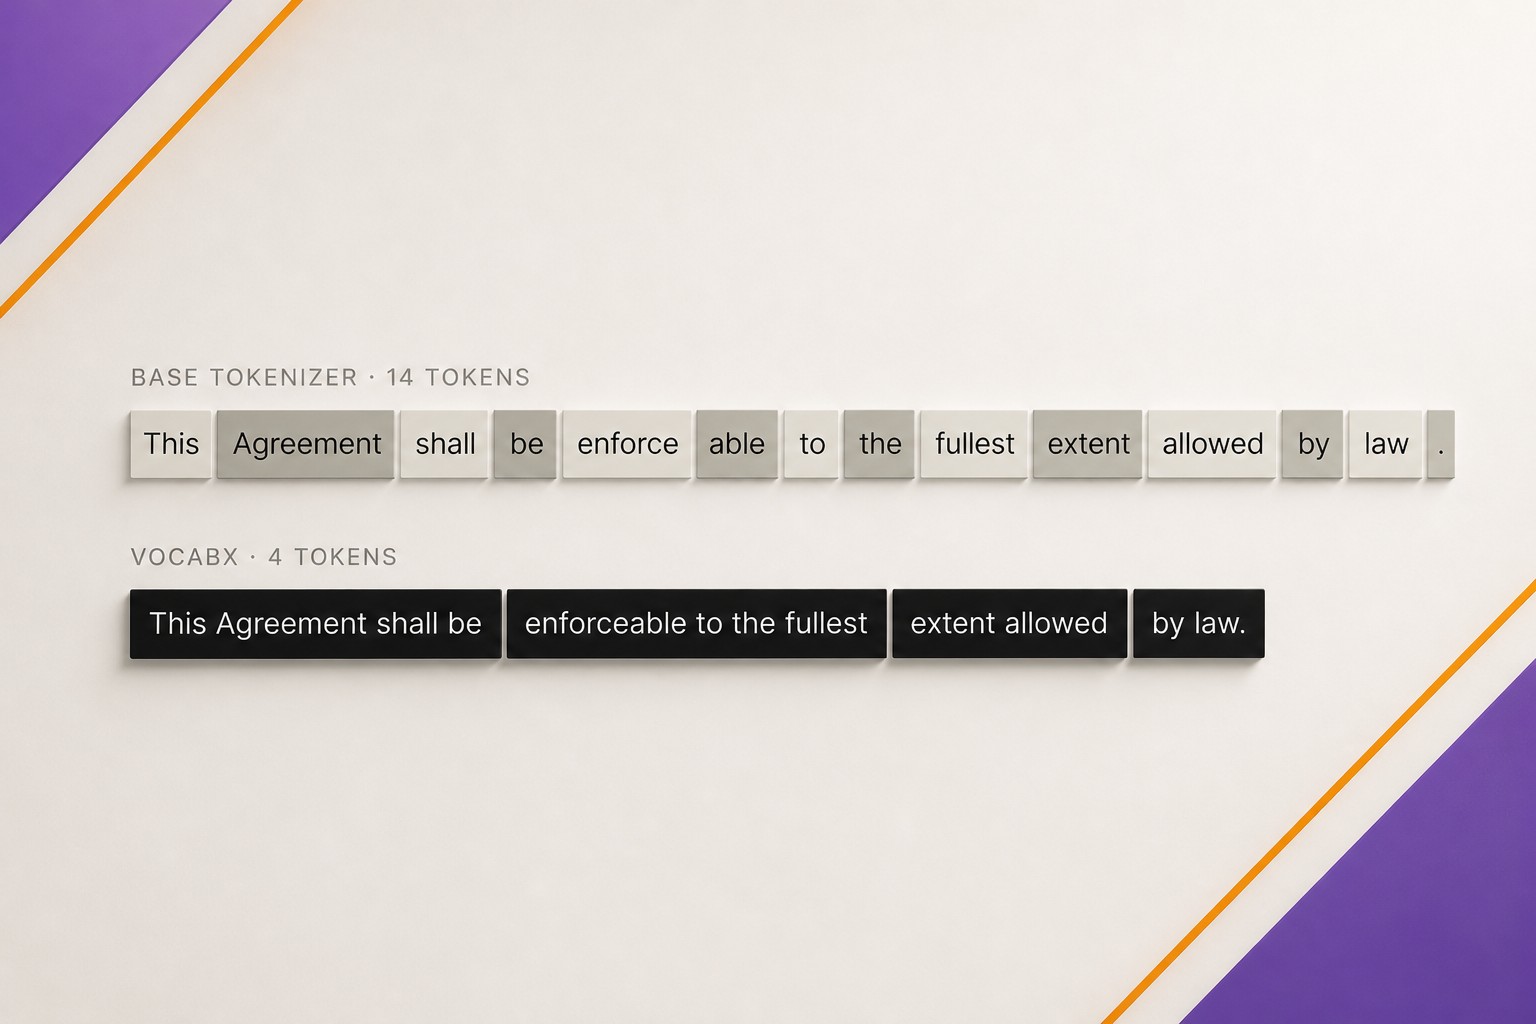
Модели, дообученные для конкретной области или задачи на основе открытых Qwen и Gemma, наследуют словарь, рассчитанный на множество тем и сценариев. В системе для оценки эссе модель часто разбивала повторяющиеся фрагменты на множество токенов. В статье авторы предварительно описывают результаты работы VocabX, которую планируют скоро опубликовать: они подбирали словарь с учётом стоимости каждого токена, а не только частоты, и снизили измеренную стоимость инференса на 77%, не меняя базовую модель.
Обычно токенизатор считают неизменной частью базовой модели: его наследуют и оставляют как есть. Но для модели, работающей в одной области, он может стать одним из главных факторов расходов. Причём решение о словаре принимают ещё до начала обучения.
Одна из производственных систем авторов — автоматическая проверка португальских эссе на базе Qwen3-4B. Она получает эссе, промт и вспомогательные тексты, а возвращает оценку в формате JSON: балл и комментарий по каждой компетенции.
Модель уже была небольшой — 4 миллиарда параметров — и обученной для этой задачи. Но её токенизатор оставался исходным токенизатором Qwen3-4B, рассчитанным на множество языков и типов текста. Проверяющая система использовала его только для португальского языка и одного формата ответа. Из-за этого возникали две дополнительные затраты: ответы занимали больше токенов, чем требовалось, а при генерации каждого токена модель рассчитывала оценки для словаря из 151 669 вариантов, многие из которых почти никогда не встречались в этой задаче.
Авторы перестроили словарь методом VocabX, сохранив ту же базовую модель, данные и рецепт обучения. Приведённые в статье результаты взяты из текущей версии работы, которая пока проходит рецензирование, и могут измениться до публикации.
Словарь для всех задач
Передовые языковые модели читают и пишут токенами, а токенизатор определяет, как текст делится на эти единицы. Токенизаторы универсальных моделей обучают на больших корпусах из разных областей и языков — от исходного кода и договоров до китайских текстов. Для модели общего назначения такой подход оправдан.
Но если модель работает в одной области, он приводит к двум видам потерь.
Первый — дробление текста. Токенизатор разбивает на множество частей именно те фрагменты, которые чаще всего повторяются в нужной области. В проверяющей системе каждый ответ начинается с одинаковой оболочки JSON, названий компетенций и фраз для оценки. В договорах часто повторяются стандартные пункты, в коде — имена идентификаторов. Каждый такой фрагмент приходится кодировать несколькими токенами вместо одного, и система платит за них в каждом запросе.
Второй вид потерь — лишние варианты. Словарь содержит десятки тысяч единиц, которые в этой области не используются, но модель всё равно вычисляет для них оценки при каждом сгенерированном токене. Например, модель, дообученная на проверке школьных экзаменов по биологии в США, почти никогда не пишет по-китайски, однако на каждом шаге рассчитывает вероятности всех китайских токенов. Иными словами, словарь дробит часто повторяющиеся фрагменты и включает множество ненужных вариантов.
Читать дёшево, писать дорого
Самое очевидное решение — считать токены и пытаться уменьшить их число. Но количество токенов само по себе не показывает размер расходов.
Чтобы понять, почему сгенерированный токен обходится дороже прочитанного, нужно посмотреть на две стадии инференса. На стадии обработки входа, или префилла, модель за один проход обрабатывает весь текст. Каждое значение, считанное из памяти графического процессора, используется для всех входных токенов, поэтому ограничением становятся вычислительные мощности. На стадии декодирования модель выдаёт ответ по одному токену за раз, и для каждого нужен полный проход. Значение из памяти используется лишь несколько раз, а графический процессор большую часть времени ждёт данные. Ограничением становится пропускная способность памяти.
Сильнее всего этот эффект проявляется именно в условиях, в которых авторы запускают систему: небольшие модели и умеренный размер пакета запросов. Объединение запросов в пакеты распределяет чтение параметров между ними и смягчает проблему, но не устраняет её. На каждом шаге декодирования модель также читает кэш ключей и значений — память внимания, где хранится уже обработанный контекст. Этот кэш растёт вместе с контекстом. В измерениях авторов один сгенерированный токен обходился проверяющей системе в 7,4 раза дороже токена во входном тексте. Это соотношение зависит от оборудования, задачи, размера пакета, длины контекста и других факторов и может быть ещё выше. Но в общем случае генерация обходится дороже чтения.
Это можно сравнить с доставкой, где за каждую коробку берут плату, но исходящая коробка стоит в семь раз дороже входящей. Уменьшить общее число коробок полезно, но сокращение исходящих коробок даёт в семь раз больший эффект. Поэтому метод, который одинаково сжимает вход и выход, упускает большую часть возможной экономии.
Третья составляющая расходов — сам словарь. Последний слой модели, языковая голова, превращает внутреннее состояние в оценку для каждого возможного токена. Для этого в нём хранится строка параметров для каждой записи словаря. В модели размером с Qwen3-4B на эту матрицу приходится почти 10% параметров. Крупные модели могут почти не замечать такую долю, но для небольшой модели она ощутима.
Эти расходы возникают не один раз. Входной слой обращается только к строке, соответствующей прочитанному токену. Языковая голова при генерации каждого токена считывает и обрабатывает всю матрицу. Поскольку декодирование уже ограничено пропускной способностью памяти, каждая дополнительная строка увеличивает объём данных, которые приходится перемещать на каждом шаге. Запись, не нужная конкретной области, обходится ровно столько же, сколько часто используемая. Поэтому добавление токенов может сократить их общее количество, но одновременно увеличить расходы.
VocabX не включает этот фактор в критерий отбора токенов, однако уменьшает словарь в два этапа: объединение частей слов заменяет исходный словарь меньшим, настроенным на предметную область, а макротокены добавляются в пределах фиксированного бюджета. В проверяющей системе выходной слой сократили примерно со 152 000 до 65 000 строк.
Чего не хватало прежним методам
Адаптация словаря модели — не новая идея. К известным методам относятся быстрое перенесение словаря (FVT), многословная токенизация (MWT) и расширение токенизатора на месте от Liquid AI (in-place BPE), которое продолжает обучение BPE с исходного словаря. Все они уменьшают дробление текста. Однако при проверке на своей задаче авторы обнаружили два ограничения.
Прежние методы выбирают токены по частоте, а не по стоимости. Выражение, которое часто встречается во входных данных, для них ценнее, чем менее частый фрагмент ответа, даже если обработка последнего обходится дороже.
Кроме того, они работают только на одном уровне: либо меняют способ деления слов на части, либо объединяют целые фразы в один токен. Ни один из трёх методов не делает и то и другое по единому критерию. При этом основные потери в системе для оценки эссе возникали на длинных повторяющихся фрагментах, например оболочке JSON. Методу, работающему только с частями слов, пришлось бы объединять такой фрагмент по частям.
Как устроен VocabX
VocabX решает обе эти проблемы и ещё одну, связанную с очевидным способом справиться с первой.
Сначала авторы изменили критерий: вместо числа сэкономленных токенов оценивают сэкономленные деньги и время. Каждый устранённый токен получает вес в зависимости от того, где он находится: в системном промте, сообщении пользователя или ответе модели. В проверяющей системе токен, сэкономленный в ответе, стоил в 7,4 раза больше токена, сэкономленного во входном тексте. Словарь строят с учётом этой разницы.
Затем VocabX одновременно работает на двух уровнях. Если вернуться к примеру с доставкой, можно сократить число коробок, лучше упаковывая каждый предмет, или заметить, что один и тот же набор из двенадцати предметов отправляют каждую неделю, и класть его в одну коробку. VocabX использует оба подхода. На уровне частей слов метод заново определяет, как делить слова предметной области. На уровне нескольких слов он находит повторяющиеся фрагменты — от коротких выражений до целых строк и оболочек JSON — и объединяет каждый в один токен, который авторы называют макротокеном. Для обоих уровней действует общий критерий стоимости, но у каждого свой бюджет.
Такие фрагменты ищут пять автоматических инструментов, каждый из которых настроен на свой вид повторов: длинные слова, целые строки, выражения, законченные предложения и структуры с пунктуацией, например JSON и теги. В среднем по восьми корпусам наибольший вклад дал последний инструмент. На коде он один обеспечил сокращение на 17,5 процентного пункта. Без всех пяти инструментов сокращение числа токенов в системе для проверки эссе было бы меньше на 55,6 процентного пункта.
Третий шаг — оценить то, чего не видно в выборке. Чтобы выбирать токены по стоимости, нужно знать, сколько каждый кандидат сэкономит с учётом уже выбранных токенов. Точный расчёт потребовал бы заново обрабатывать весь корпус после каждого выбора — десятки тысяч раз. Часто для ускорения оценку проводят на выборке документов, но тогда кандидат, не попавший в неё, получает нулевой выигрыш.
Например, выражение, которое встречается 37 раз в 50 000 документов, попадёт в выборку из 400 документов лишь примерно в 26% случаев. В корпусе договоров в такую выборку попадали только 16,6% кандидатов. Остальные вообще не оценивались.
Выигрыш от кандидата складывается из двух частей. Первая — сколько токенов он экономит во всём корпусе; её можно посчитать точно, без выборки. Вторая — какая часть этой экономии ещё не обеспечена уже выбранными токенами; оценивать нужно только её. Для кандидатов, которых выборка не охватила, VocabX использует статистическую оценку, основанную на поведении видимых кандидатов, вместо нулевого результата. Так редкий в выборке, но частый во всём корпусе кандидат снова участвует в отборе.
Одно это изменение подняло сокращение числа токенов в корпусе договоров с 44,7% до 52,8% при той же выборке и том же бюджете.
Что изменилось в проверяющей системе
Чтобы измерить реальный эффект, авторы обучили семь версий системы с одной базовой моделью, теми же данными, рецептом обучения и начальным значением генератора случайных чисел. Различался только токенизатор. Все версии обработали одни и те же 500 запросов на одной тестовой машине с графическим процессором RTX 5090 и сервером инференса vLLM. Стоимость рассчитывали по измеренному времени работы.
Средняя длина ответа модели сократилась с 350 до 101 токена, а стоимость — на 77,0%. Оценка качества по бенчмарку выросла с 0,703 до 0,810. Она учитывает точность выставления баллов и точность выявления эссе не по теме или нарушающих правила.
По пути авторам пришлось скорректировать метод. В первой версии словаря оценка за каждую компетенцию объединялась с окружающим её фрагментом JSON в один макротокен. Это был самый компактный вариант, но качество снизилось: результат по бенчмарку составил 0,689 против 0,703 у производственной системы. Когда оценка становилась частью макротокена, для каждого сочетания оценки и структуры требовался отдельный вариант токена, а модель выбирала их за один шаг.
Если выделить оценку в отдельный токен, ответ становился на два токена длиннее, а результат по бенчмарку повышался до 0,810. При этом измеренная стоимость снижалась сильнее: на 77,0% против 73,3% у варианта с объединённым токеном.
Этот результат относится не только к проверке эссе. Сжатие может навредить, если объединённый фрагмент содержит решение, которое модель должна принять сама. Поэтому задача — найти самый дешёвый словарь, который сохраняет важные для модели токены.
Проверка на других областях
Чтобы выяснить, не связан ли эффект только с их системой, авторы сравнили VocabX с тремя известными методами на пяти открытых предметных областях: договоры, медицинские статьи, научные работы, новости и код на Python. В тест вошли три семейства моделей: Qwen3, Llama-3.1 и Gemma-3. Все методы использовали одни и те же документы для поиска и тестирования, а также одинаковое ограничение на размер словаря.
Во всех 15 сочетаниях VocabX сжал текст сильнее лучшего из сравниваемых методов — на 1,2–9,3 процентного пункта. Обрезанная версия VocabX также показала наименьшую расчётную стоимость инференса во всех 15 случаях. Средний отрыв составил 10,2 процентного пункта для Qwen3, 7,5 для Llama-3.1 и 13,6 для Gemma-3.
На договорах обрезанная версия VocabX сократила число токенов на 62,6% при словаре из 113 426 записей. Лучший результат in-place BPE составил 61,8% при словаре из 207 803 записей.
Оплата только за нужные токены
VocabX не делает модель умнее. Он сокращает затраты на разбиение текста, который модели приходится писать, и на расчёт оценок для неиспользуемых записей словаря. В системе для проверки эссе измеренная стоимость инференса снизилась на 77% при той же базовой модели и том же рецепте обучения.
Специализацию обычно начинают с данных и параметров модели. Начать можно и на один уровень раньше — со словаря.
Полное описание метода, таблицы всех экспериментов и отброшенные варианты вмешательств авторы включат в статью о VocabX, которую планируют скоро опубликовать.
Источники
Читайте также
 Mistral и Nvidia хотят ускорить промышленное проектирование с помощью физического ИИ
 Google Cloud предлагает модели OpenAI наряду с Gemini и Claude — теперь у неё есть все три
 Deel представила ИИ-модели Pangaea для кадров и расчёта зарплат: узкие специалисты удешевят ответы
 Демис Хассабис сократил срок появления ОИИ с пяти лет до двух-трёх лет
 ИИ помогает медикам без специальной подготовки проводить УЗИ для наблюдения за беременностью
 Физик Кристофер Стаббс вошёл в траст Anthropic по долгосрочным интересам компании
 Стартап Recursive делает ставку на рекурсивное самоулучшение. Его новая модель пугающе хороша
 OpenAI пока не может объяснить, почему её агенты для программирования отключают контроль за нежелательным поведением
 Решена 31-летняя математическая задача — гипотеза КЛС
 Учредили новую премию для книг, написанных в соавторстве с ИИ
 Диффузионная Mercury 3 от Inception, как утверждает компания, обходит GPT-6 Luna и Claude Haiku 5.5, заставляя ждать лишь малую долю времени
 Омерзительные охотники за просмотрами с помощью ИИ подделывают записи реальных арестов, заставляя полицейских лапать женщин
 ИИ обещает рост продуктивности, но пока для менеджеров это скорее головная боль
 Ограничения ИИ не останавливают хакеров-преступников
 DSX POD от Nvidia может сократить запуск ИИ-дата-центра с шести месяцев до 14 дней
 Может, вайб-кодинг стоило бы назвать «кодингом рогоносца» — ты просто сидишь и смотришь
 Даже сторонники ИИ проводят черту, когда слушатели отвергают музыку, созданную ИИ
 OpenAI вложилась в стартап, который выявляет рак с помощью мозговых имплантов
 NVIDIA представила SimReady Central — открытую библиотеку 3D-объектов для симуляций в робототехнике и ИИ-фабриках
 Royal Berkshire Hospital первой в Великобритании использует робота Arthur для сканирования кистей при артрите
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram