
Источник: the-decoder.com
В Inception утверждают, что Mercury 3 обходит GPT-6 Luna и Claude Haiku 5.5 в ряде бенчмарков и работает в четыре-восемь раз быстрее. В анонсе компания назвала Mercury 3 самой способной из выпущенных на тот момент диффузионных языковых моделей.
Скорость связана с устройством модели. GPT и Claude генерируют текст слово за словом: каждое новое слово ждёт предыдущего. Диффузионные модели, известные прежде всего по созданию изображений, сначала набрасывают весь ответ целиком, а затем уточняют его за несколько проходов, одновременно создавая много слов. Основной принцип описан в техническом отчёте Google о DiffusionGemma.
Преимущество Mercury 3 зависит от теста
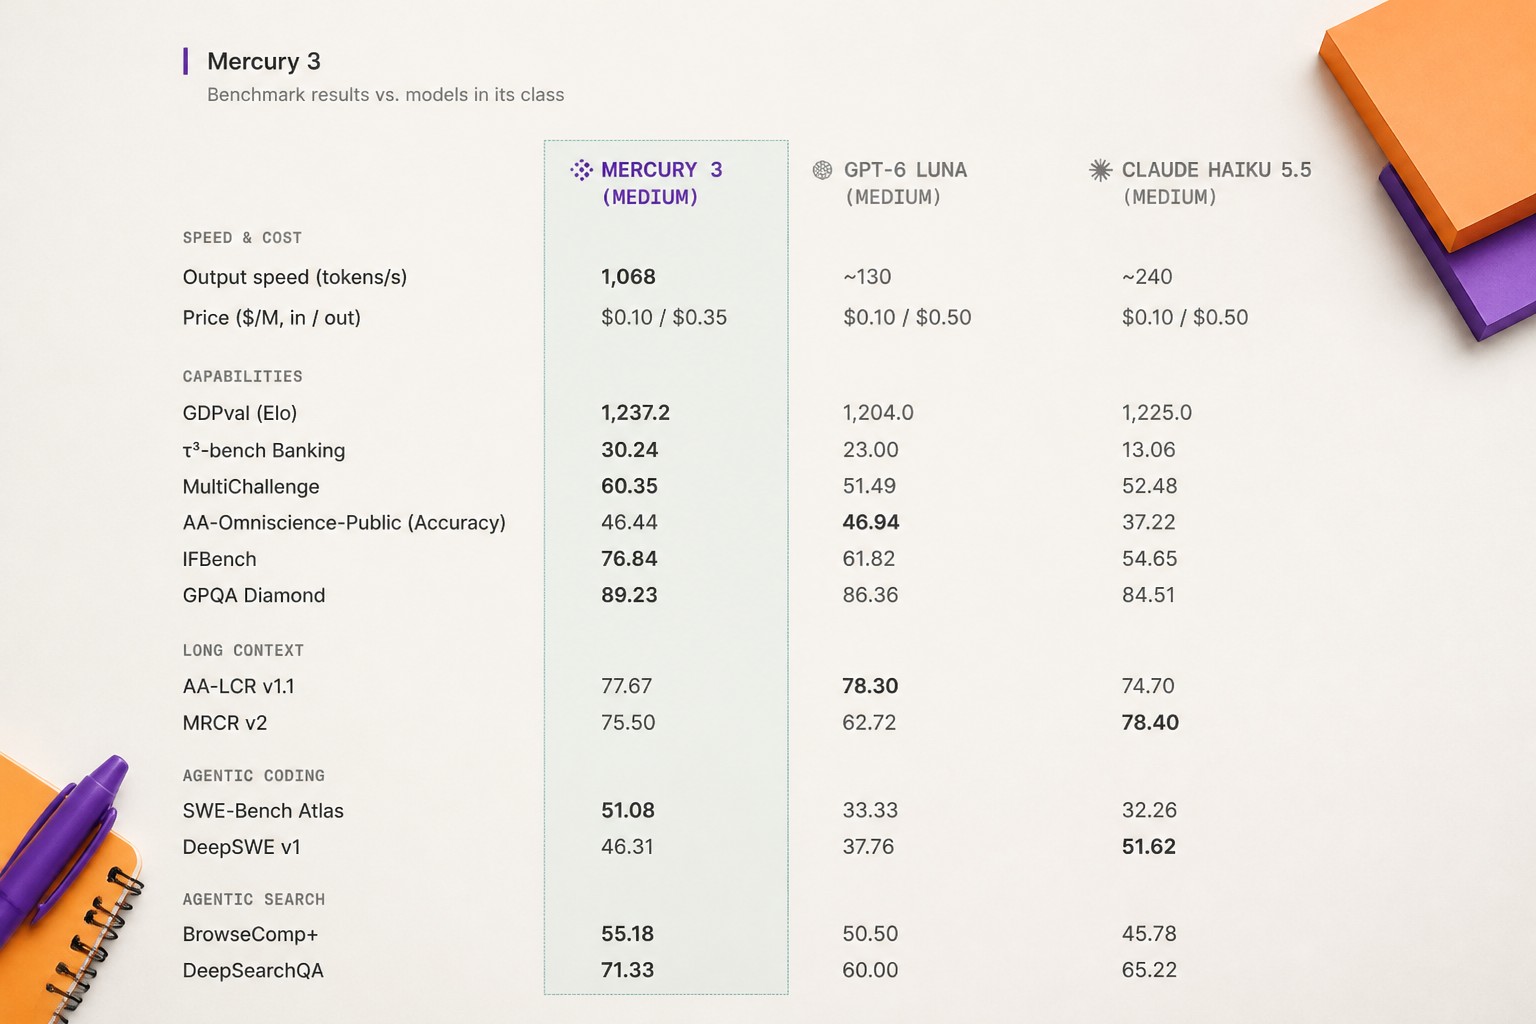
Собственная таблица Inception показывает более неоднозначную картину. При средних настройках всех трёх моделей Mercury 3 выигрывает в восьми из 12 испытаний. Самый большой разрыв — в следовании инструкциям: в IFBench модель набрала 76,84 балла, на 15 больше, чем GPT-6 Luna. Она также заметно опередила соперников в автономном программировании на SWE-Bench Atlas: результат Mercury 3 — 51,08 балла против 33,33 и 32,26.
В более продолжительном тесте программирования DeepSWE победила Claude Haiku 5.5. Она также лучше находит информацию в длинных текстах. GPT-6 Luna показала немного лучший результат в двух тестах Artificial Analysis. В кратком обзоре Inception осторожнее оценивает качество Mercury 3, называя его сопоставимым с конкурентами или более высоким.
По данным Inception, Mercury 3 генерирует 1 068 токенов в секунду на графических процессорах Nvidia. В сравнении компании Claude Haiku 5.5 выдаёт около 240 токенов в секунду, а GPT-6 Luna — примерно 130. Независимых тестов пока нет.
Как утверждает Inception, в Mercury 3 более чем в 40 раз больше параметров, чем в Mercury 1, при той же скорости работы. Производительность также утроилась по сравнению с компактной Mercury 1 mini. Компания считает, что это указывает на устойчивое улучшение диффузионных моделей при увеличении масштаба — так же, как у обычных языковых моделей. Точное число параметров Inception не раскрыла.
Mercury 3 рассчитана на приложения с частыми запросами
Inception в первую очередь предлагает Mercury 3 для ИИ-агентов, поиска, поддержки клиентов и обучения. ИИ-агенты выполняют задачи в несколько шагов и на каждом из них ждут ответа модели. Даже небольшие задержки при этом быстро накапливаются.
Партнёры, получившие ранний доступ, поделились результатами в анонсе — большинство из них тоже выделяет скорость. Octen AI разрабатывает поиск для умных очков. Основатель компании Куан Зоу рассказал, что на умных очках ответ, который приходится ждать пять секунд, кажется сломанным. Сам поиск занимал около 80 миллисекунд, а задержку создавала языковая модель. С Mercury 3 медианное время ответа составило 0,9 секунды, а весь процесс занял 2,2 секунды.
Образовательная компания General Learning сообщила, что теперь выдаёт ученикам подсказки и исправления примерно за одну секунду. Поставщик услуг поддержки Lorikeet отмечает, что ответы стали быстрее, а их качество улучшилось.
В TinyFish AI сооснователь компании Шуахао Чжан рассказал, что Mercury 3 получила 50 задач на навигацию по реальным сайтам и справилась с 25 из них, обойдя GPT-6.1-Sol. Чжан не назвал результат модели OpenAI.
Стартовая цена Mercury 3 снижена вдвое
Обычная цена составляет $0,20 за миллион входных токенов и $0,70 за миллион выходных. На старте Inception вдвое снизила стоимость, но не уточнила, когда скидка закончится. После её отмены генерация выходных токенов будет дороже, чем у GPT-6 Luna и Claude Haiku 5.5: по крайней мере, при коротких входных запросах, за которые обе модели берут $0,50. Для очень длинных запросов конкуренты обходятся значительно дороже. Mercury 3 может обрабатывать до миллиона токенов за раз.
Модель доступна на платформе Inception, а также через OpenRouter, Baseten и Vercel. Она использует тот же API, что и модели OpenAI, поэтому, по словам Inception, разработчикам будет несложно перейти на Mercury 3.
В феврале Inception выпустила Mercury 2, которую назвала первой диффузионной моделью, рассуждающей через промежуточные шаги перед ответом. До этого стартап привлёк $50 млн. Среди инвесторов — NVentures, M12 и Snowflake Ventures, венчурные подразделения Nvidia, Microsoft и Snowflake.
Над тем же подходом работает Google. После демки Gemini Diffusion в июне компания представила открытую модель DiffusionGemma. По данным Google, она работает до четырёх раз быстрее обычной Gemma 4, но даёт немного более слабые результаты.
Читайте также
 Омерзительные охотники за просмотрами с помощью ИИ подделывают записи реальных арестов, заставляя полицейских лапать женщин
 ИИ обещает рост продуктивности, но пока для менеджеров это скорее головная боль
 Ограничения ИИ не останавливают хакеров-преступников
 DSX POD от Nvidia может сократить запуск ИИ-дата-центра с шести месяцев до 14 дней
 Может, вайб-кодинг стоило бы назвать «кодингом рогоносца» — ты просто сидишь и смотришь
 Даже сторонники ИИ проводят черту, когда слушатели отвергают музыку, созданную ИИ
 OpenAI вложилась в стартап, который выявляет рак с помощью мозговых имплантов
 NVIDIA представила SimReady Central — открытую библиотеку 3D-объектов для симуляций в робототехнике и ИИ-фабриках
 Royal Berkshire Hospital первой в Великобритании использует робота Arthur для сканирования кистей при артрите
 Европе нужны дата-центры, но климатические цели мешают их строить
 Claude Science ищет спасение от смертельных укусов скорпионов, создавая белки-связыватели с нуля
 Пять винных трендов 2027 года: как технологии меняют то, что мы пьём
 Роботизированная терапия помогает пациентам после инсульта проходить реабилитацию
 Глава Hugging Face предупреждает: документальный фильм Netflix о взломе OpenAI не точен
 OpenAI покупает Orchestra Bio, чтобы укрепить биотехнологическое направление
 Anthropic предлагает закон о безопасности ИИ: выпуск модели могут заблокировать, если она угрожает гибелью 50 и более человек
 Партнёрства Anthropic с облачными провайдерами всё чаще дают сбои
 Птица? Самолёт? Нет, робот-тупик?
 Будущий ровер Astrolab запустит первые большие языковые модели на Луне
 Deepseek открыла исходный код движка инференса для своей самой быстрой и дешёвой модели ИИ
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram