
Агенты застревают в «бассейнах идей»
Исследователи изучили так называемых «агентов для авторских исследований» — ИИ-системы, которые многократно предлагают решения, оценивают их и дорабатывают с учётом обратной связи. Восемь независимых запусков одного агента на одной задаче вышли на заметно разные уровни: итоговые оценки составили от 68,3 до 100,0. Согласно статье, разрыв сохранялся и при существенном увеличении вычислительного бюджета.
Исследователи нанесли решения всех запусков на двумерную карту, где близкие по смыслу варианты расположены рядом, а затем сравнили результаты. Решения одного запуска почти всегда оставались в небольшой области карты. Авторы назвали такие области «бассейнами идей».
Агенты тратят значительную часть оставшегося вычислительного бюджета на улучшение решений в менее продуктивной области вместо того, чтобы искать подходы, найденные в других запусках. Это сохраняется даже тогда, когда агенты время от времени сжимают историю переписки.
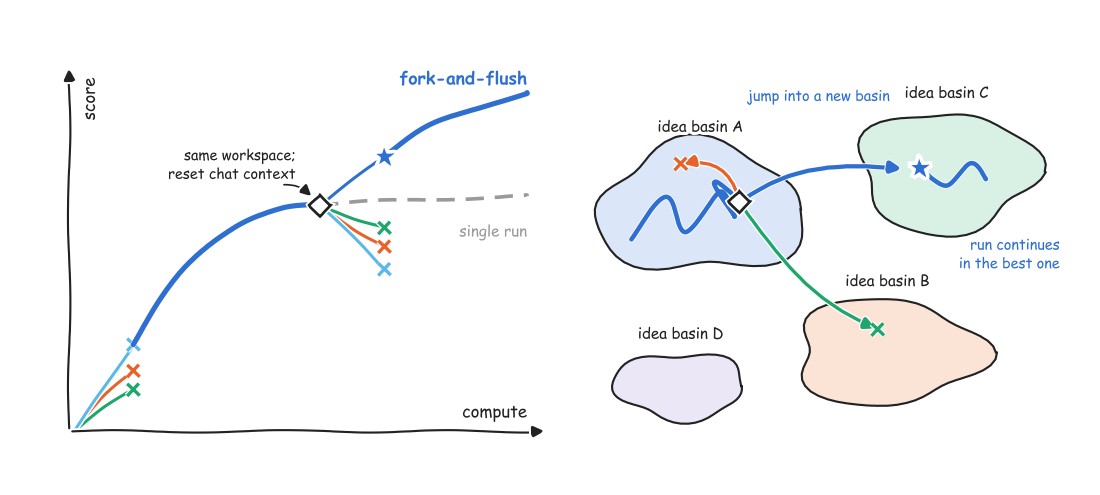
Слева одиночный запуск (серый, пунктирный) продолжает уточнять решения в рамках одного и того же бассейна идей. Fork-and-Flush запускает параллельные ветви с чистыми контекстами чата, сохраняет лучшую ветвь и отбрасывает остальные. Справа ветвь с чистым контекстом переходит в другой бассейн идей и набирает более высокий балл
Источник: the-decoder.com
Очистка истории чата открывает новые подходы
Предложенный метод Fork-and-Flush объединяет два механизма. При «разветвлении» агент запускает K параллельных ветвей, каждая из которых наследует рабочее пространство и все созданные файлы. При «сбросе» ветвь теряет весь контекст чата, но сохраняет рабочее пространство. Так она начинает новую переписку, опираясь на уже сделанную работу.
Ветвь, которой оставили историю чата родительского процесса, обычно возвращается в тот же бассейн идей: прежние рассуждения направляют её следующие шаги. Свежий контекст возвращает разнообразие поиска. История переписки исчезает, но код, файлы и сохранённые результаты остаются в рабочем пространстве.
На 66% выше средний нормализованный результат
Исследователи проверили Fork-and-Flush на 13 длительных задачах, среди которых укладка полиомино, планирование работ на станках и криптоанализ. В набор также вошли сжатие классификатора CIFAR и оптимизация ядра VLIW. Отдельные запуски длились от нескольких часов до более чем 100 часов. Агенты работали с GPT-5.6-terra и GPT-5.5 через интерфейс командной строки GitHub Copilot.
При одинаковом вычислительном бюджете средний результат Fork-and-Flush после нормализации по минимуму и максимуму составил 0,78. Для одиночных запусков он равнялся 0,47, а для варианта с выбором лучшего из четырёх запусков — 0,54. В статье указаны относительные улучшения на 66,0% и 44,4% соответственно. Метод показал наивысший средний результат в 12 из 13 задач.
Результаты Fork-and-Flush оказались и стабильнее: нормализованное стандартное отклонение снизилось до 0,16 против 0,26 у одиночных запусков. Простая очистка контекста чата без разветвления улучшила результаты на 22%.
Более сильным моделям тоже может понадобиться сброс контекста
Чтобы проверить, помогают ли более способные модели избегать бассейнов идей, исследователи изучили задачи MAX-3-SAT на трёх моделях разного размера: Qwen3.5-4B, 9B и 27B. Разброс между запусками следовал перевёрнутой U-образной кривой и достигал пика на задачах у границы возможностей модели — примерно посередине между результатом случайного угадывания и результатом эталонного решателя.
Авторы отмечают, что открытые исследовательские задачи по определению находятся на пределе возможностей моделей. По их ожиданиям, различия между запусками, на которых основан Fork-and-Flush, сохранятся и по мере улучшения моделей — просто граница переместится к более сложным задачам. Результаты показывают, что регулярный сброс контекста может быть полезен и для передовых исследовательских агентов.
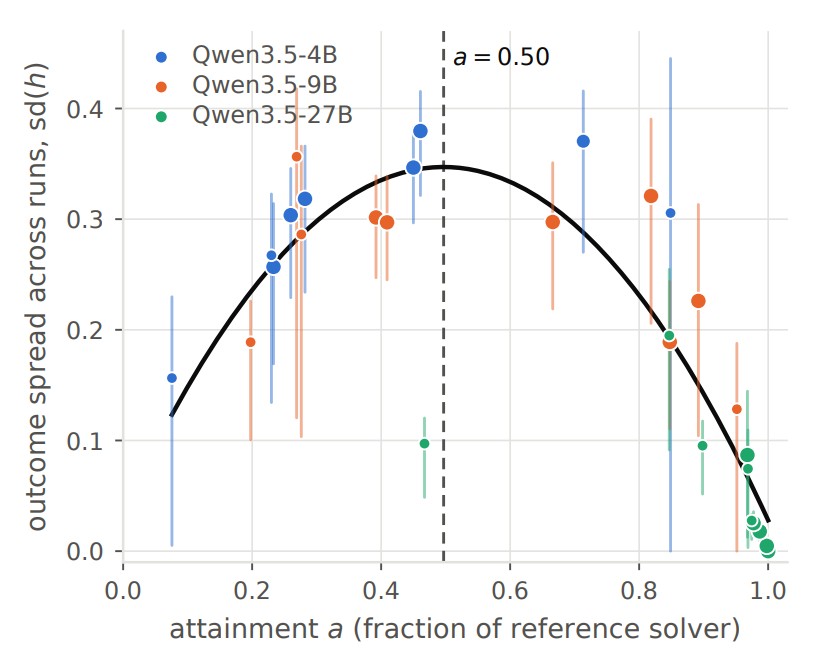
Результаты сильнее всего различаются на задачах, находящихся на грани возможностей модели: одни запуски завершаются успехом, другие значительно уступают. Модели почти всегда справляются с очень лёгкими задачами и терпят неудачу на очень сложных. Эта закономерность наблюдается для всех трёх протестированных размеров модели
Источник: the-decoder.com
Читайте также
 Симулируя обучение учеников, можно улучшить ИИ-тьюторов
 Брэд Смит считает, что Великобритания лучше других подходит для регулирования ИИ
 Microsoft планирует к 2027 году нарастить мощности собственных ИИ-чипов Maia до нескольких гигаватт
 «Антиутопия и унижение»: вот каково было проходить собеседование с ИИ-ассистентом
 Белый дом передумал и вернул британскому Институту безопасности ИИ доступ к передовым моделям
 Бывший руководитель Plaud привлёк $26 млн на ИИ-приложение, которое слушает вас в фоновом режиме
 Один из ключевых ингредиентов безопасности ИИ — демократия
 Одна из основных групп любителей ИИ — педофилы
 Медицинские долги в США растут — для их взыскания всё чаще используют ИИ
 Даже в новых аккаунтах ChatGPT уверяет пользователей, что их интеллект — в высших процентилях
 «Я стала гораздо осторожнее»: шесть родителей о том, как ограничивают детям соцсети и ИИ
 AlphaProof Nexus от Google DeepMind решил десятки открытых математических задач — и прошёл рецензирование
 Великобритания укрепит киберзащиту: министр призовёт ИИ-компании усилить меры безопасности
 ИИ-агенты могут безошибочно выполнять каждый вызов инструмента и всё равно нарушать корпоративные правила
 Бум центров обработки данных для ИИ резко увеличивает число газовых электростанций, загрязняющих воздух
 Сможет ли ИИ-индустрия склонить противников дата-центров на свою сторону, отказавшись от соглашений о неразглашении?
 Исследование: команды ИИ-агентов тратят массу токенов ради почти незаметного роста качества
 Эксперты предупреждают: камеры Flock — лишь начало антиутопической слежки, которая превращает жизнь в ад
 Этот график расходов на дата-центры на фоне всего остального строительства вас ужаснёт
 Эти руководители считают, что голосовой ИИ ещё не пережил свой момент ChatGPT
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram