
Одного увеличения объёма данных недостаточно, чтобы улучшить работу ИИ-агентов со смартфонами. При том же объёме обучения важнее, сколько разных приложений агент успел изучить.
Агенты, которые самостоятельно работают с приложениями, учатся главным образом на практике. Но нужные для обучения данные в основном находятся у крупных компаний. Поэтому открытые модели отстают, пишут исследователи из Нанкинского университета, компании SenseTime и нескольких других университетов.
OpenMobile-2 должен помочь сократить этот разрыв. Команда выпускает две модели агентов: на базе Qwen3.5 с 9 миллиардами параметров и Qwen3.6 с 27 миллиардами параметров. Вместе с ними исследователи публикуют среду обучения, данные и инструкции для воспроизведения эксперимента. По словам авторов, модель входит в число лидеров среди современных агентов для смартфонов.
Зачем воссоздавать приложения
Обучать агента на реальных приложениях сложно: нужны учётные записи, настоящие покупки обходятся дорого, а состояние приложений нельзя сбросить. Поэтому исследователи воссоздали 35 популярных в основном в Китае приложений, среди которых Taobao, JD, DiDi и Meituan, а также Slack и Google Drive, которыми пользуются по всему миру. Вместе с уже существующими симуляциями и приложениями в эмуляторе Android эта среда охватывает более 110 приложений.
Проверяющие сравнивали воссозданные приложения с оригиналами и дорабатывали их, пока рабочие сценарии и интерфейсы не совпадали. Заказы, бюджеты и планы поездок сохраняются между сеансами, а данные можно передавать между приложениями через буфер обмена. Каждая симуляция автоматически возвращается к исходному состоянию. Агент видит только снимки экрана и не имеет доступа к внутренним данным приложений — так имитируется взаимодействие обычного пользователя.
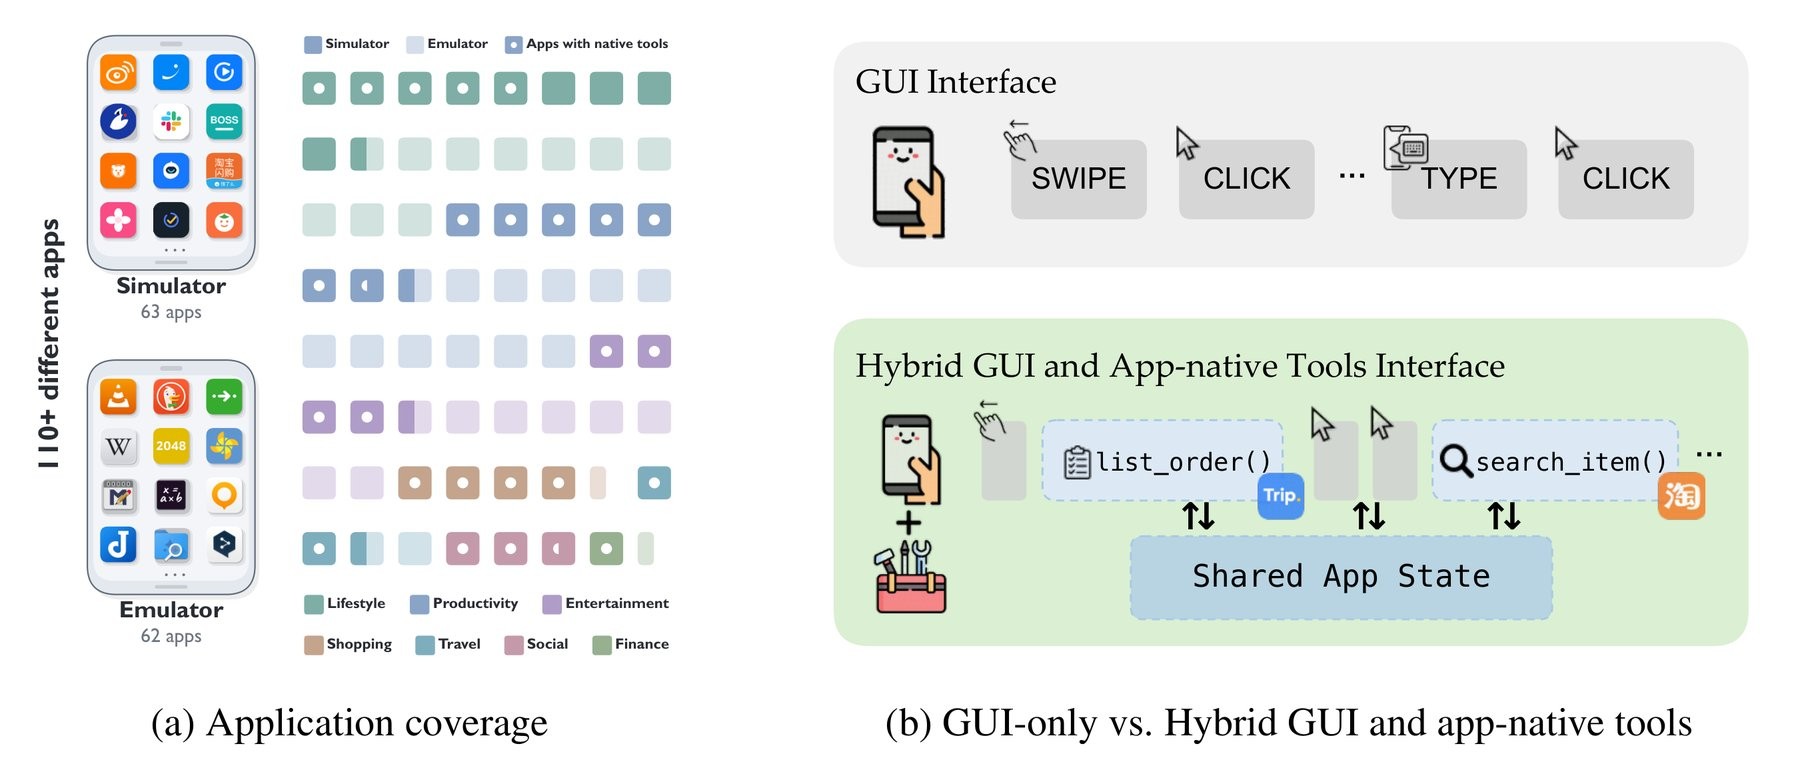
В гибридном режиме агент сочетает обычные действия на экране с функциями, которые приложение предоставляет напрямую в качестве инструментов
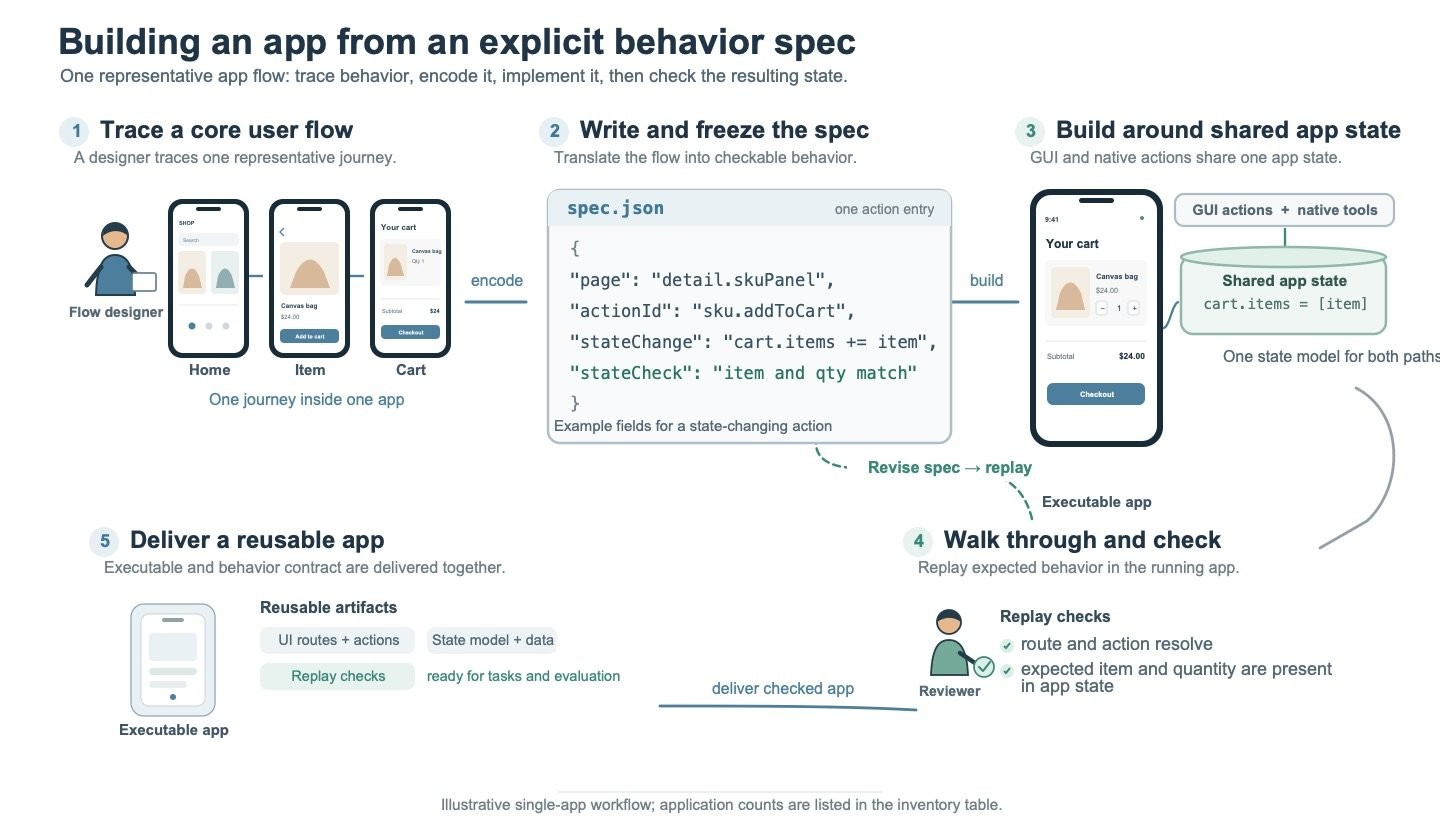
Для каждого пересобранного приложения исследователи заранее определяют, какое действие изменяет какое состояние, а затем автоматически проверяют результат
Источник: the-decoder.com
Источник: the-decoder.com
На основе этой среды команда создала около 11 600 примеров рабочих сценариев и более 2 000 практических заданий с автоматической проверкой результата. Примеры генерировала Gemini 3.1 Pro от Google, использованная как модель-учитель. Получается, OpenMobile-2 в некоторой степени учится на закрытой системе.
Результаты на реальных смартфонах
Обе модели улучшили результаты на известных бенчмарках. В AndroidWorld старшая модель поднялась с 67,1 до 79,9 балла, а младшая — с 54,3 до 74. Предыдущая версия, OpenMobile-1, набрала в том же тесте 64,7 балла. В более сложном бенчмарке MobileWorld, где задания длиннее и охватывают несколько приложений, результат старшей модели вырос с 35,9 до 50,4 балла.
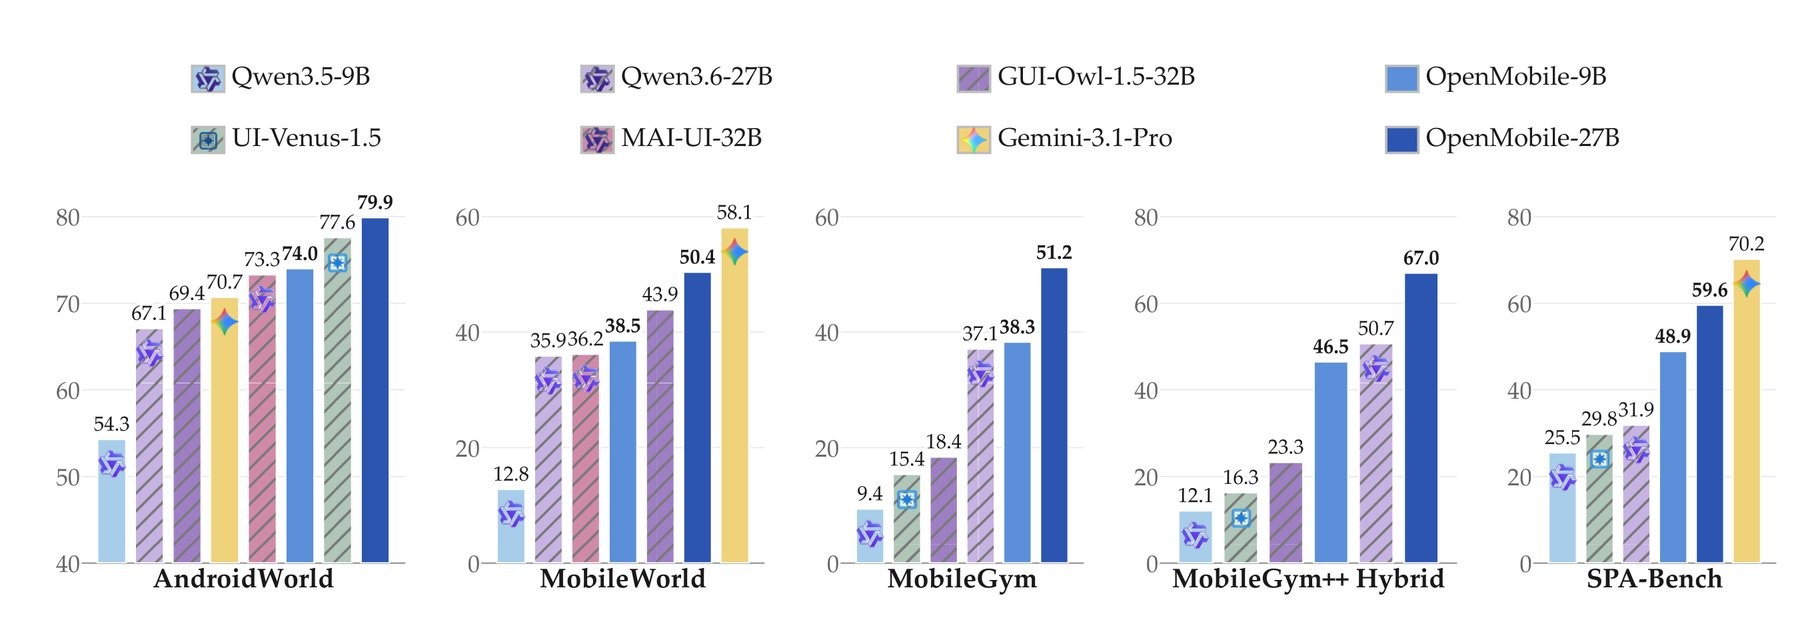
OpenMobile-2-27B набирает 79,9 балла в AndroidWorld и уступает только Gemini 3.1 Pro в SPA-Bench на реальных устройствах
Источник: the-decoder.com
Самый заметный рост исследователи получили на реальных устройствах Android: результат старшей модели в SPA-Bench увеличился с 31,9 до 59,6 балла. По словам команды, это лучший показатель среди открытых моделей.
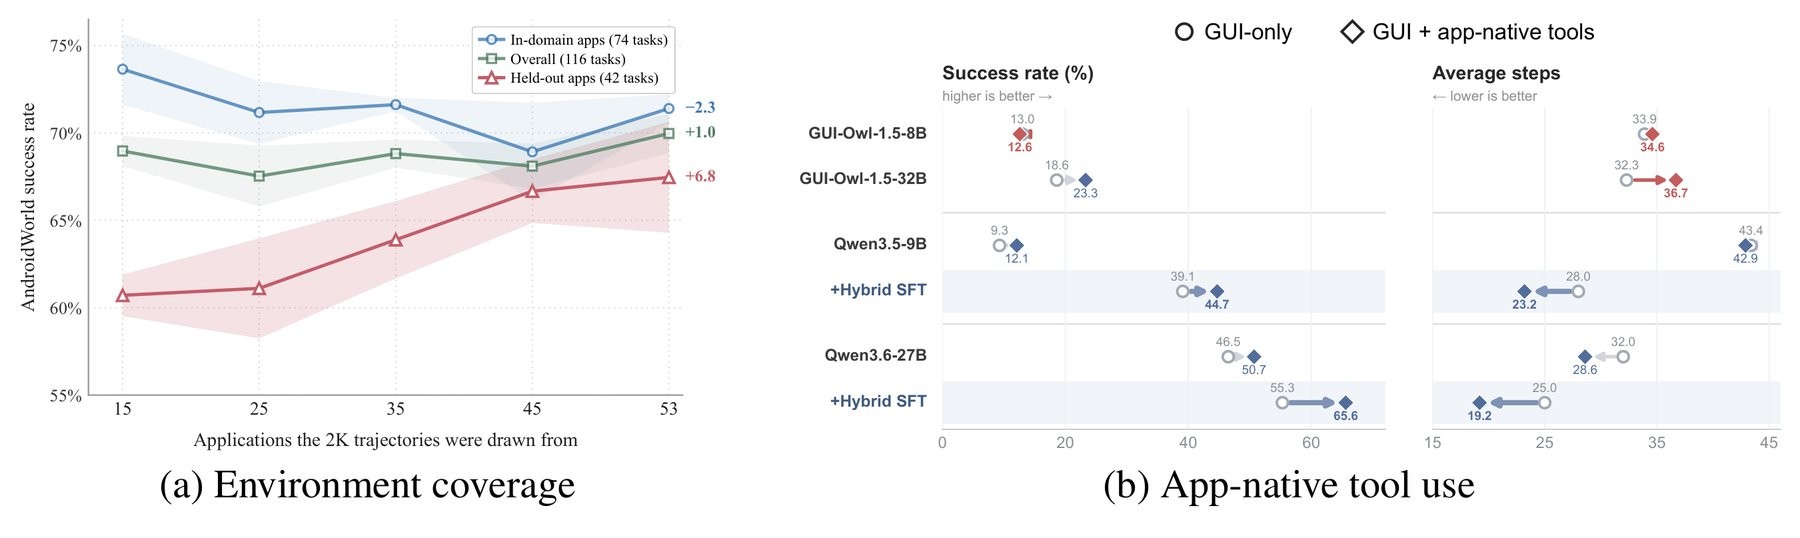
Большее разнообразие приложений в обучающей выборке повышает эффективность на незнакомых приложениях. После гибридного обучения модели чаще решают задачи с помощью инструментов и тратят на это меньше шагов
Источник: the-decoder.com
Разнообразие обучающей среды оказалось важнее общего объёма данных. Исследователи оставили объём данных неизменным и увеличили только число приложений, с которыми практиковался агент. Доля успешных задач в незнакомых приложениях выросла с 60,7% до 67,5%. При одинаковом бюджете данных разнообразие приложений оказалось полезнее дополнительных примеров из нескольких приложений.
Обучение с подкреплением дало лишь небольшой прирост, в основном в средах, похожих на обучающие. В AndroidWorld старшая модель после такого обучения даже показала немного худший результат: 79,9 балла вместо 80,8.
Прямые команды помогают обходить меню
В экспериментальной части исследования агенты не ограничиваются касаниями и свайпами. Более 50 симулированных приложений поддерживают прямые команды, например «добавить в корзину»: с ними агенту не нужно проходить через меню. Он может свободно переключаться между командами и обычной навигацией в зависимости от доступных возможностей.
Без специального обучения это почти не помогает: модели обычно не замечают быстрые команды. После обучения агенты начинают использовать их эффективно — решают до 10,3 процентного пункта больше задач и делают примерно на пять шагов меньше. По словам исследователей, этот навык также переносится на инструменты, с которыми модели не сталкивались во время обучения.
На позднем этапе обучения с подкреплением агент получал дополнительное поощрение, если за попытку хотя бы раз использовал прямую команду. При этом награда всё равно зависела от того, выполнено ли задание. Если агент заявлял об успехе, которого на самом деле не было, его штрафовали. Пока такие интерфейсы есть только в симулированных приложениях; сами исследователи называют этот подход экспериментальным.
Часть результатов получена на собственном бенчмарке команды из 215 заданий. Почти половина из них охватывает несколько приложений. Выполнение проверяет не языковая модель, а программа: она сравнивает сохранённые данные приложения до и после каждой попытки. Авторы также проверили, пересекаются ли обучающие и тестовые задания, и обнаружили лишь небольшое сходство.
В исследовании 2025 года Microsoft Research уже отмечала, что агенты, работающие через API, надёжнее, а агенты с графическим интерфейсом — гибче. Мобильные приложения приводились как типичный пример среды, где внешних интерфейсов нет. Oppo выбрала другой путь: её открытый агент X-OmniClaw работает на реальных устройствах и повторяет ранее показанные маршруты в приложениях вроде Taobao и Meituan через диплинки, вместо того чтобы снова переходить по меню. Среди закрытых моделей Google встроила управление смартфоном непосредственно в Gemini 3.5 Flash.
Читайте также
 «Синтетический двойник»: почему футболист сборной Австралии Криштиан Вольпато стал последним, кто лицензировал своего ИИ-клона
 Трое уволенных исследователей по безопасности OpenAI говорят, что им так и не сообщили, что именно они якобы раскрыли
 Если заставить выбрать, ИИ-модель Grok поддерживает республиканцев, а модель OpenAI — демократов
 ИИ сразу повышает эффективность младших патентных юристов, но может незаметно тормозить их профессиональный рост
 Новая ИИ-модель Block Dessa обучалась только на человеческой речи и распознаёт эмоции, которые упускают текстовые модели
 Банки готовятся к последствиям беспрецедентной катастрофы, вызванной ИИ
 Мы расследовали Character.AI и обнаружили настоящий кошмар. Теперь компания обанкротилась.
 История с PHP показывает, как ИИ делает уязвимости опаснее для эксплуатации
 Миллиардеры от ИИ вливают деньги в политику, чтобы влиять на выборы, но это оборачивается против них
 Дата-центр по соседству: на передовой новой битвы Давида с Голиафом в мире технологий
 За кулисами: совет директоров Meta спорит с Марком Цукербергом из-за его неконтролируемых расходов на ИИ
 Джон Хили обещает задействовать бюджет, чтобы укрепить безопасность Великобритании с помощью ИИ
 Новая норма: ИИ обнаружил опасную уязвимость на 70% сайтов в мире
 OpenAI больше не будет обучать модели на живом интернете из-за «серьёзных рисков»
 В третьем сезоне «Голубой планеты» оставят более мутные кадры, чтобы доказать их подлинность на фоне бума ИИ
 Главный хит рождественских продаж? Дженсен Хуанг играет с очаровательными роботами Microduck — продано 20 000 штук
 Claude Code против оболочки на 100 строк: результат одинаковый
 Новая бизнес-модель ИИ: главный сюрприз Muse от Meta
 Anthropic: её невыпущенная модель мощнее Mythos 5.1 и лучше согласована с намерениями людей
 Китайская модель Kimi K3.1 Pro вплотную приблизилась к Claude Opus 5.5
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram