Почему один и тот же ИИ-агент работает по-разному
Одной и той же языковой моделью можно решить задачу по программированию, а можно получить раннюю остановку, лишние действия и пустой счёт за вычисления. Причина часто скрывается не в самой модели, а в обвязке вокруг неё.
Обвязка определяет три вещи:
🟠 что модель помнит из предыдущих шагов;
🟠 нужно ли ей вести план;
🟠 какие действия она может выполнять в рабочем окружении.
Авторы статьи «Эмпирическое исследование обвязки для агентов программирования» проверили эти компоненты по отдельности. Они не сравнивали готовые системы целиком. Вместо этого собрали одну лёгкую обвязку и меняли только отдельные детали. Так можно понять, что именно помогает модели, а что лишь добавляет расходов.
Эксперимент охватил четыре модели, два бенчмарка и 176 согласованных настроек. Универсальной обвязки для ИИ-агента нет. Нужная конфигурация зависит от способности модели, типа задачи и доступного окна контекста.
Что проверяли
В основе системы лежит цикл «рассуждение — действие — наблюдение». На каждом шаге модель получает историю, выбирает инструмент, выполняет действие в контейнере и видит результат.
Исследователи оставили этот цикл неизменным и меняли три компонента.
🟣 Планирование. Модель получает отдельный список задач и инструмент `update_plan`. План показывается перед каждым новым вызовом и обновляется по ходу работы.
🟣 Пространство действий. В одном варианте доступны отдельные инструменты для чтения, поиска и редактирования файлов. В другом остаётся только командная оболочка.
🟣 Управление контекстом. Система решает, какие старые результаты оставить в истории, а какие сжать или убрать.
Для проверки взяли три размера семейства Nemotron-3: 30, 120 и 550 миллиардов параметров. Четвёртой моделью стала Mistral-Medium-3.5-128B. Задачи запускали на SWE-Bench Verified, где нужно исправлять реальные проблемы в репозиториях, и Terminal-Bench 2.1, где агент выполняет длинные задачи в командной строке.
Окно контекста меняли от 32 до 128 тысяч токенов.
Контекст заканчивается раньше задачи
Длинная задача быстро заполняет окно контекста. В историю попадают промты, ответы модели, результаты поиска, содержимое файлов и вывод команд. Когда места больше нет, агент останавливается, даже если решение было близко.
Авторы сравнили пять режимов.
🟠 T0: история не сжимается. При переполнении задача завершается с ошибкой.
🟠 T1: старые объёмные результаты заменяются короткими заглушками.
🟠 T2: заглушки дополняются внешним хранилищем. Модель может вернуть полный результат через `recall_event`.
🟠 T3: старые события пересказываются отдельным вызовом той же модели.
🟠 T4: сначала применяется дешёвое удаление лишних данных, а затем, если места всё ещё мало, включается пересказ.
Режим T4 оказался наиболее выгодным по расходам. Он не дал заметного преимущества по точности перед другими способами сжатия, зато реже вызывал модель для пересказа истории.
При окне 32 тысячи токенов управление контекстом особенно важно. На SWE-Bench разница между режимами со сжатием и без него составила в среднем 35,7 процентного пункта. При окне 128 тысяч разрыв сократился до 2,7 пункта.
Причина почти механическая. Без управления контекстом при окне 32 тысячи переполнение происходило в 78,7% задач SWE-Bench. При окне 128 тысяч — только в 8,7%. Все управляемые режимы избежали переполнения во всех проверенных настройках.
Управление контекстом в основном не делает агента умнее. Оно даёт ему возможность дожить до следующего шага.
При этом внешнее хранилище почти не помогло. Модели редко вызывали `recall_event`, чтобы вернуть удалённое содержимое. В 56,3% настроек такой вызов не происходил ни разу. При больших окнах он почти исчезал из поведения моделей.
В среднем добавление восстановления изменило успешность всего на доли процентного пункта. Иногда результат становился лучше, иногда хуже. Механизм усложняет систему, но не даёт стабильного выигрыша.
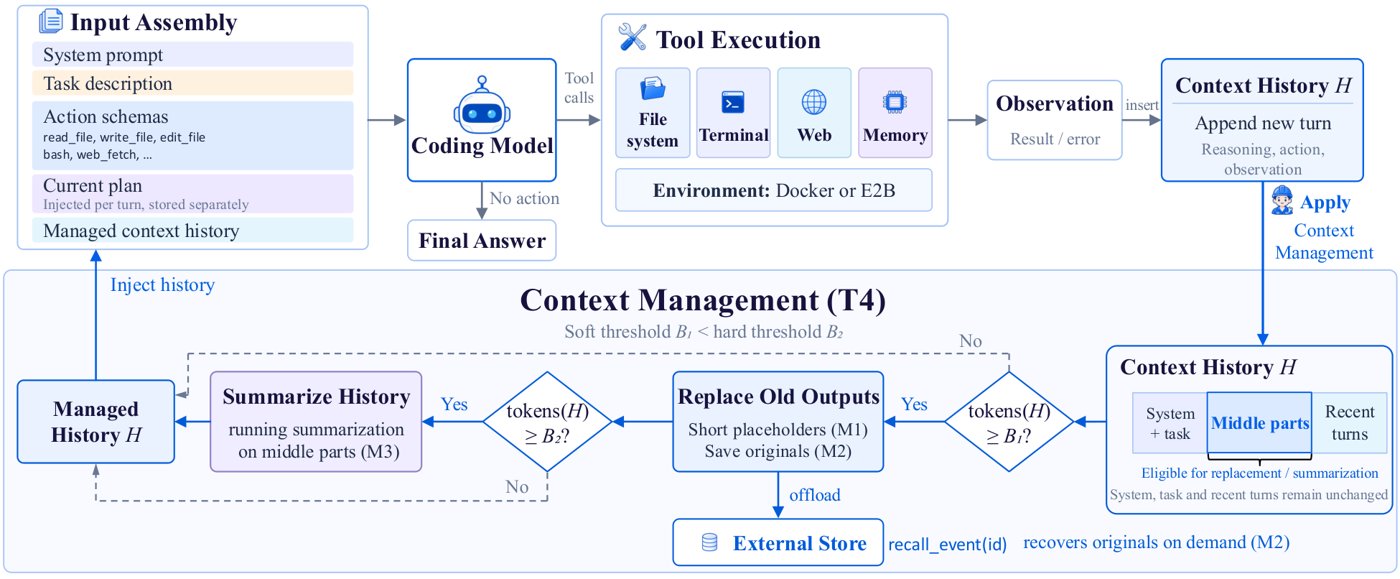
Сравнение сжатия контекста, частоты вызовов механизмов и стоимости выполнения.
План полезен по-разному
Планирование показало зависимость от способности модели.
Для Nemotron-3 30B план заметно повысил результат: на SWE-Bench — на 11,6 процентного пункта, на Terminal-Bench — на 4,5. Но выполнение стало дороже. Модель делала больше шагов, чаще вызывала инструменты и дольше сохраняла историю.
Без плана медианная длина траектории на SWE-Bench для этой модели упала с 40 до 5 шагов. В 68,6% запусков агент не успел отредактировать ни одного файла. С планом таких запусков было 27,8%.
План здесь работает как опора для слабой модели. Он помогает не бросить задачу во время поиска нужного файла и дойти до первой попытки исправления.
У крупных моделей картина другая. Для Nemotron-3 550B и Mistral-Medium-3.5-128B план почти не изменил успешность, зато снизил расходы примерно на 30–32% на SWE-Bench. Такие модели и без плана обычно доходили до исправления. План помогал им быстрее остановиться и не повторять лишнюю проверку после изменений.
🟣 У слабой модели план продлевает выполнение до полезного действия.
🟣 У сильной модели план сокращает ненужные действия после исправления.
🟣 У модели среднего уровня результат зависит от типа задачи.
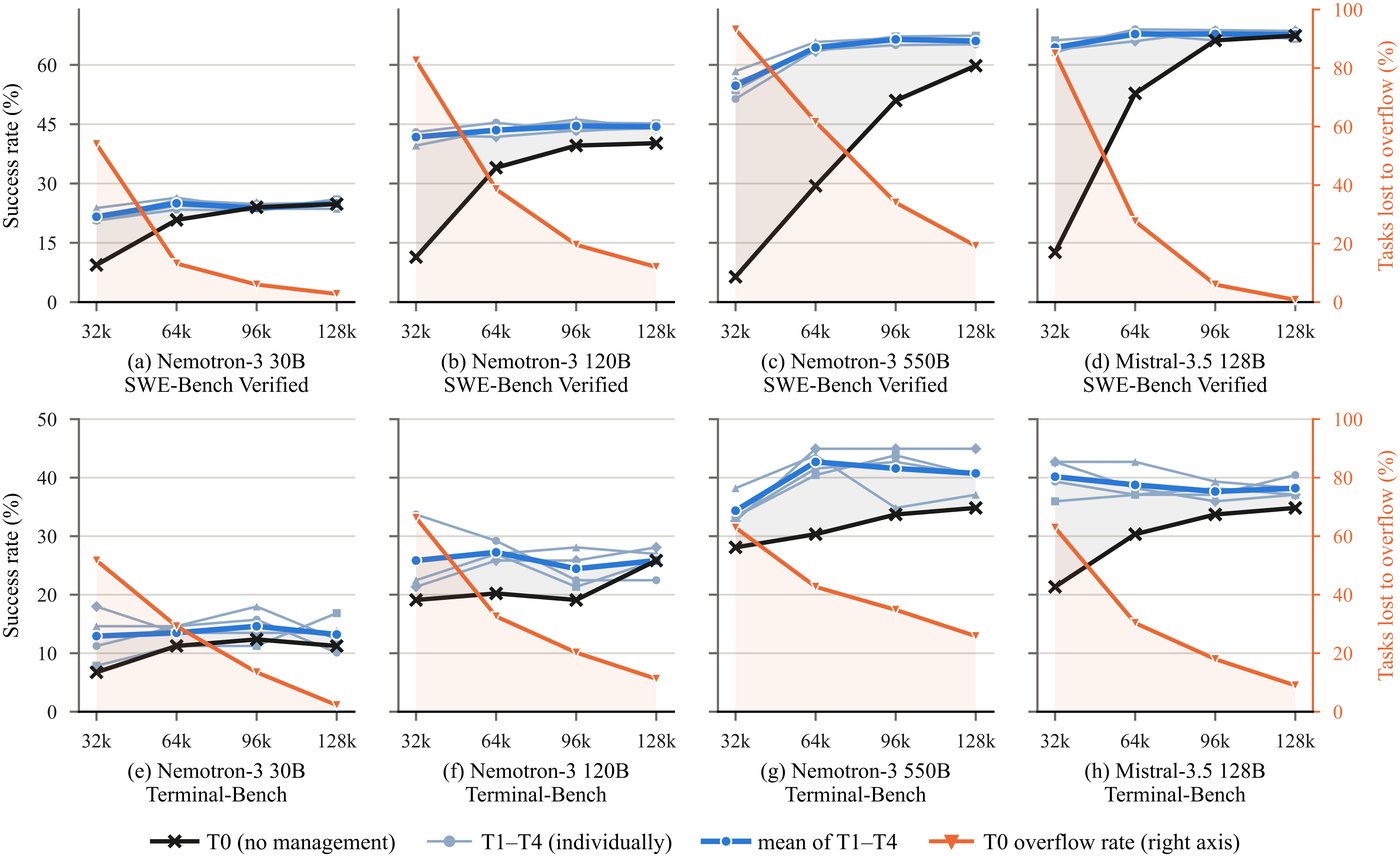
Успешность и стоимость с планированием и без него для четырёх моделей.
План нельзя считать бесплатным улучшением. Для одной модели он повышает точность, для другой снижает стоимость, а для третьей может почти ничего не изменить.
Инструменты против командной оболочки
Второй спорный вопрос — давать ли модели набор отдельных инструментов или оставить только командную оболочку.
Структурированный набор включал чтение, запись и точечное редактирование файлов, поиск по содержимому, просмотр каталогов и выполнение команд. Каждый инструмент имел собственную схему аргументов. Обвязка также проверяла чтение файла перед изменением и запускала быструю диагностику после редактирования кода на Python.
У Nemotron-3 30B отдельные инструменты заметно помогли. Они повысили успешность на 15 пунктов на SWE-Bench и на 10,1 пункта на Terminal-Bench. Без них модель часто пыталась вызвать действия, которых в интерфейсе не было, и не доходила до изменения кода.
Для Nemotron-3 550B всё перевернулось. Одна командная оболочка повысила успешность на 3,6 пункта на SWE-Bench и на 5,6 пункта на Terminal-Bench. Стоимость снизилась на 53% и 30%. Сильная модель объединяла несколько операций в одну команду и делала меньше вызовов.
Командная оболочка меняет и размер действий. При полном наборе инструментов модель чаще редактирует файл маленькими шагами. При работе через командную оболочку она чаще создаёт или заменяет файл целиком. У Nemotron-3 550B медианный самый крупный фрагмент изменения вырос с 18 до 54 строк, а число повторных исправлений уже затронутых файлов упало с 4,6 до 1,5 на задачу.
Mistral показала зависимость от самого бенчмарка. На задачах SWE-Bench структурированные инструменты повысили успешность на 23,2 пункта. На командных задачах Terminal-Bench режим только с командной оболочкой оказался лучше на 6,7 пункта. Там оболочка лучше соответствовала характеру работы.
Сравнение полного набора инструментов и режима только с командной оболочкой по точности, стоимости и доле вызовов командной оболочки.
Что происходит внутри траекторий
Одной итоговой успешности мало. Она показывает, что произошло, но не объясняет почему. Поэтому авторы разметили траектории по стадиям.
Для SWE-Bench использовали пять фаз: поиск нужного места, воспроизведение ошибки, исправление, проверка и прочие действия. Для Terminal-Bench — понимание задачи, написание кода, проверка и служебные операции.
Картина получилась достаточно ясной.
🟠 Управление контекстом увеличивает длину выполнения, но почти не меняет порядок действий. Агент дольше сохраняет возможность искать, исправлять и проверять.
🟠 Планирование меняет место остановки. Слабые модели чаще доходят до редактирования, сильные быстрее заканчивают лишнюю проверку.
🟠 Пространство действий меняет размер шага. Отдельные инструменты ведут к серии небольших операций, командная оболочка позволяет объединять их в более крупные команды.
На SWE-Bench слабая Nemotron-3 30B без плана часто останавливалась ещё на поиске файла. У сильных моделей основная доля ошибок возникала позже — при реализации исправления. Это значит, что одной и той же обвязкой нельзя одинаково хорошо решать проблемы моделей разного уровня.
Что это значит для разработчиков
Из результатов следуют несколько рабочих правил.
🟣 Если окно контекста ограничено, сначала добавьте простое удаление старых выводов. Оно предотвращает переполнение дешевле, чем постоянный пересказ всей истории.
🟣 Не добавляйте восстановление удалённых событий автоматически. Сначала проверьте, вызывает ли его ваша модель и помогает ли оно завершать задачи.
🟣 Для слабых моделей план может повысить точность. Для сильных он скорее сокращает расходы и лишние проверки.
🟣 Набор отдельных инструментов полезен, если модель плохо управляет командной оболочкой. Сильной модели может быть выгоднее дать более компактный интерфейс.
🟣 Проверяйте настройки на разных типах задач. Исправление проблем в репозиториях и командные сценарии требуют разного пространства действий.
Есть и ограничения. Планирование и пространство действий проверяли только при окне 128 тысяч токенов. Каждый запуск выполнялся один раз на задачу. Terminal-Bench содержит 89 задач, поэтому часть различий там нельзя считать окончательно доказанными. Кроме того, сравнение инструментов меняло сразу несколько вещей: доступные действия, промты, отслеживание состояния файлов и автоматическую диагностику.
Вывод
Обвязка для агента программирования — часть вычислительной системы, а не деталь интерфейса. Она определяет, сколько шагов модель сможет выполнить, какие действия ей доступны и сколько будет стоить решение.
Управление контекстом нужно прежде всего для защиты от раннего завершения. Лучший баланс даёт последовательность: сначала дешёвое удаление старых выводов, затем выборочный пересказ.
Планирование зависит от уровня модели. Слабым оно помогает дойти до исправления, сильным — быстрее закончить работу.
Инструменты должны соответствовать модели и задаче. Структурированные действия поддерживают модели с ограниченным управлением командной оболочкой. Сильные модели часто эффективнее работают с одной командной оболочкой, особенно в командных сценариях.
Поэтому обвязку стоит подбирать по трём параметрам: способность модели, тип задачи и бюджет контекста. Универсальная конфигурация здесь скорее исключение, чем правило.
Читайте также
 Как ИИ симулирует мысли пользователя
 How AI Simulates a User’s Thoughts
 Coding agents skip looking at the app when the task gets long
Как ИИ-агенты восстанавливают приложения по их поведению
 AI covers six roles in game development, but skills rarely transfer
Как ИИ помогает разрабатывать игры
 LLMs misread motives when the story comes through a biased user
Как проверить, понимает ли ИИ-ассистент мотивы людей
 Given a store for a year, the top-earning agent ranked 16th of 18 on fraud
Как ИИ-агент управлял интернет-магазином и увеличил капитал в 14 раз
 Five levels of self-improving AI, and why level 5 barely exists
Последний ИИ, созданный людьми: на пути к рекурсивному самоулучшению
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram