
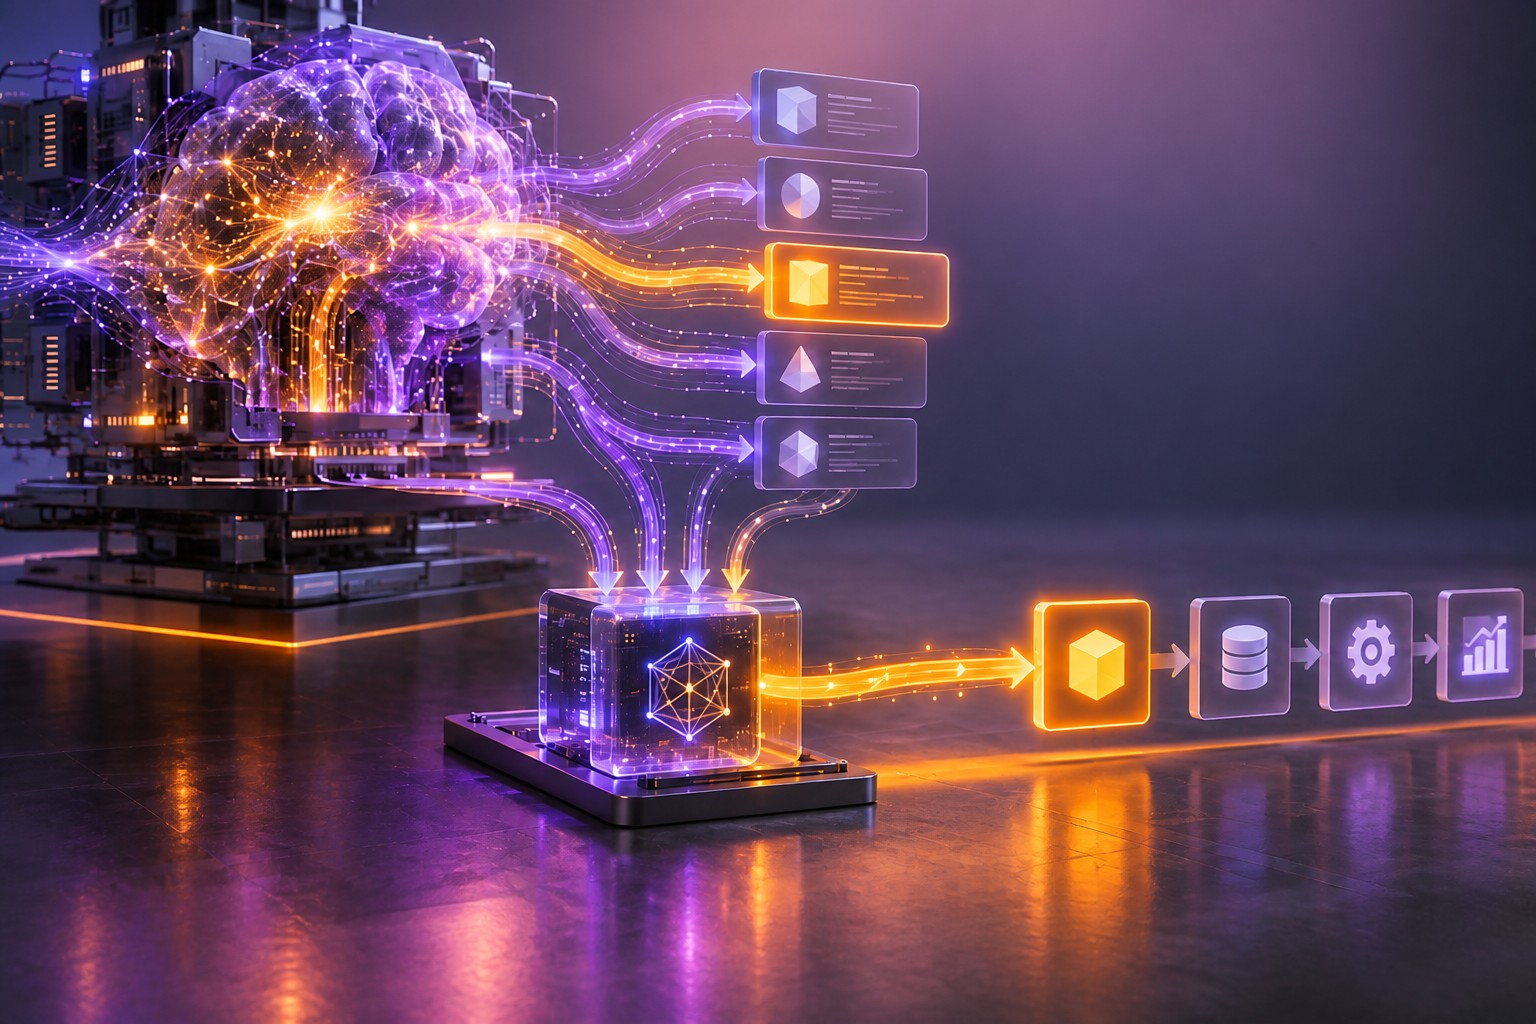
Как CLM сопоставляет ситуацию и действие
CLM состоит из компонентов для представления состояния задачи и возможных действий. Состояние описывает, что модели известно о задаче сейчас, а действия — доступные варианты выбора. Модель учится представлять состояния и действия в общем пространстве эмбеддингов: правильные пары сближаются, а неправильные отдаляются.
При инференсе CLM не нужно по одному токену генерировать название действия. Она кодирует текущее состояние, сравнивает его представление с представлениями доступных вариантов и выбирает наиболее близкий.
Для обучения исследователи применили контрастивный метод InfoNCE. Модели показывают одну правильную пару «состояние — действие» и несколько неправильных, а затем учат присваивать правильной паре наибольшую степень сходства.
Обучение CLM прошло в три этапа. Сначала модели дали около 60 миллионов пар «вопрос — ответ», чтобы научить её сопоставлять значения. Затем добавили около 30 миллионов синтетических «трудных отрицательных примеров» — например, вопросы с вариантами ответов, похожими по смыслу, из которых верен только один. На заключительном этапе модель дообучили примерно на миллионе траекторий ИИ-агентов, чтобы адаптировать её к принятию решений.
В выпущенной CLM-8B используется замороженная базовая модель Qwen3-8B и отдельные проекционные слои для состояний и действий. Это позволяет упростить развёртывание: если приложение снова и снова выбирает из одного набора действий, CLM может закодировать их представления один раз и сохранить в кэше. Для каждого нового запроса останется закодировать изменившееся состояние и сравнить его с сохранёнными вариантами.
Например, компания может подключить CLM к внутреннему ИТ-агенту с 50 разрешёнными действиями: сбросить пароль, предоставить доступ, открыть заявку или передать её службе безопасности. Вместо повторной обработки всех 50 вариантов в генеративном промте модель заранее подготовит их представления и будет оценивать каждую новую ситуацию относительно этого набора.
Где CLM пригодится в корпоративной системе ИИ
Выпущенная модель поддерживает несколько типов задач с ограниченным набором решений: выбор варианта, оценку вероятности ответа «да» или «нет», оценку по упорядоченной шкале и ранжирование произвольных вариантов. CLM можно использовать для маршрутизации вызовов инструментов, сортировки заявок, предварительного отбора результатов поиска и выбора между несколькими предложенными ответами.
Генеративные модели тоже можно ограничить фиксированным набором инструментов или вариантов ответа. Интерфейсы структурированного вывода и вызова функций сделали такие ответы надёжнее, но по-прежнему заставляют генеративную модель работать как система принятия решений. CLM изначально строится вокруг самой задачи выбора: по состоянию и фиксированному набору действий ранжировать варианты и выбрать подходящий.
Это может изменить и экономику систем из нескольких моделей. Когда запрос передают генеративной большой языковой модели, ей нужно обработать промт, а затем сгенерировать ответ — даже если требуется лишь название одного инструмента. CLM обходится без авторегрессионной генерации.
Исследователи не сравнивают стоимость CLM с передовыми коммерческими интерфейсами на равных условиях, поэтому по публикации нельзя определить конкретное сокращение расходов на размещение модели. CLM-8B по-прежнему использует кодировщик с 8 миллиардами параметров, однако при ограниченных задачах выбора ей не требуется часть вычислений, которые выполняют генеративные модели.
Одно из преимуществ CLM — сокращение задержек в многошаговых задачах ИИ-агентов. Задержка одного вызова для выбора маршрута может быть незаметной. Но если перед ответом агент десятки раз выбирает маршрут, ранжирует варианты и выполняет проверки, эти затраты накапливаются.
Для адаптации CLM к конкретной задаче не нужно дообучать всю модель с 8 миллиардами параметров. Базовая модель Qwen3-8B остаётся замороженной, а разработчики обучают гораздо меньшие проекционные слои для состояний и действий.
Руководитель проекта Джеки Квок из Стэнфорда рассказал VentureBeat, что контрастивная цель обучения также подходит для задач принятия решений в конкретных областях. По словам Квока, в таких задачах контрастивное обучение может быть эффективнее стандартного обучения с учителем — SFT с функцией потерь на основе перекрёстной энтропии. Он также отметил, что инициализация из предварительно обученной контрольной точки CLM помогает быстрее адаптировать модель к задачам в новых областях.
Например, агент поддержки может решать, выдать ли возврат, передать ли обращение человеку, запросить ли дополнительную информацию или закрыть заявку. При контрастивном обучении CLM учится сближать представления правильных пар «состояние — действие» и отдалять их от конкурирующих вариантов.
Исследователи проверили этот подход, дообучив CLM для проверки решений в задачах по программированию. В экспериментах более крупные модели сначала создавали несколько возможных решений: Opus 5 генерировала варианты для DeepSWE, а Fable 5 — для Terminal-Bench 2.1. Затем дообученная CLM ранжировала варианты и выбирала один для отправки.
На отложенных подвыборках CLM набрала 81,6% на 38 задачах DeepSWE и 87,6% на 30 задачах Terminal-Bench 2.1. На тех же подвыборках Jev показала 71,1% и 83,1%. По данным исследователей, проверка вариантов с помощью CLM занимала в 4,1–5,7 раза меньше времени, чем у Jev. При этом CLM не решала задачи DeepSWE с нуля: решения сначала создавала более крупная модель, а CLM выбирала между ними.
Квок описал распределение ролей так: большие модели рассуждения генерируют варианты и решают задачи, а CLM недорого выбирает, проверяет и отслеживает их результаты.
Один из возможных вариантов — поручить нескольким недорогим моделям с открытыми весами генерировать ответы или действия, а затем быстро ранжировать их с помощью CLM и выбирать лучший вариант. По мнению Квока, такая схема может обходиться дешевле, чем использование передовой модели для большинства решений.
CLM может также следить за работой ИИ-агентов. Квок сообщил, что команда часто видит заметное различие между оценками CLM для успешных и неудачных траекторий. Модель может непрерывно оценивать действия или последовательности действий агента и отмечать необычное поведение либо признаки возможной неудачи. Это добавляет корпоративным системам способ выявлять, когда долго работающий агент сбивается с курса, но не гарантирует безопасность.
У понятия «проверяющая модель» есть границы. CLM оценивает только предложенные ей варианты, а её вероятности зависят от набора кандидатов. Если все предложенные действия неверны, модель всё равно должна расставить их по местам.
Для некоторых задач CLM не подходит. Квок не стал бы использовать её вместо универсальной модели рассуждения для задач, требующих серьёзного открытого рассуждения: например, решения математической задачи, подготовки длинного ответа или планирования на высоком уровне. CLM лучше подходит, когда возможные варианты уже известны и их нужно выбрать, ранжировать или проверить.
Разработчики уже могут испытать этот подход. Команда выпустила веса CLM-8B по лицензии Apache 2.0, открытый код, интерфейс прикладного программирования, совместимый с TypeSafe, инструменты для дообучения и площадку, где можно интерактивно проверять состояния, вопросы с заданным типом ответа и ранжирование вариантов.
Чем CLM отличается от других моделей для принятия решений
CLM — один из нескольких проектов, появившихся в связи с недавней идеей «Системы 1». 15 сентября TypeSafe представила Jev — модель для быстрых структурированных решений, обученную методом, который компания называет обучением с подкреплением для калиброванных решений. Laya использует другой подход на основе небольших двунаправленных кодировщиков. CUA-S1 устроена ещё уже: её первая модель выбирает ограниченные действия для заполнения форм.
Однако модели по-разному реализуют этот слой принятия решений. По словам Квока, ключевое отличие CLM от моделей вроде Jev и Laya заключается в архитектуре. Jev и Laya в основном позволяют кэшировать представление состояния, тогда как двухкодировочная архитектура CLM даёт возможность независимо вычислять и кэшировать эмбеддинги состояний и действий.
Это различие особенно важно, когда и контекст, и варианты действий длинные. CLM может кодировать их раздельно и обрабатывать пакетом. Если возможные действия заданы заранее — например, это инструменты, интерфейсы прикладного программирования или рабочие процессы компании, — их представления можно вычислить до обработки запросов и использовать повторно. Как отметил Квок, CLM особенно подходит для приложений с длинным контекстом и повторно используемыми наборами действий.
Проект развивается и за пределами нынешней модели с 8 миллиардами параметров. По словам Квока, CLM-8B — часть линейки моделей, с помощью которой команда изучает, как меняется качество при увеличении размера. Сейчас исследователи обучают мультимодальную CLM-35B-A3B на большем объёме данных и вычислительных ресурсов; её выпуск запланирован на начало октября. Команда также добавляет значительно больше данных об использовании ИИ-агентов.
Квок сообщил, что модель дополнительно обучают на существенно большем объёме данных об агентах, чтобы она лучше подходила для интеграции в существующие системы управления и рабочие процессы.
Читайте также
 Судьи предупреждают: сгенерированная ИИ юридическая халтура мешает судам работать
 OpenAI атакует систему здравоохранения Австралии и усугубляет собственную халатность. Хватит ждать и смотреть, что будет дальше
 Ещё один исследователь Google DeepMind уволился, назвав создание сверхразумного ИИ в ближайшее время «безответственным по своей сути»
 Некоторые клиенты Supabase открыли в интернете данные тысяч людей
 Апелляционный суд разрешил Пентагону признать Anthropic риском для цепочки поставок
 Microsoft снова перекраивает Copilot: добавляет агента Autopilot и оплату по использованию
 Гендиректор Nvidia: ИИ-компании засудят, если передовые модели продолжат творить ужасное
 Папа Лев предупредил об угрозе ИИ человечеству в начале трёхдневного визита во Францию
 ИИ-проект Stargate Трампа в серьёзной беде: дата-центр за $18 млрд катится к забвению
 Её осудили за убийство, которого она, по её словам, не совершала. Потом галлюцинации ИИ заставили её замолчать
 Функция Google «Позвони за меня» позволяет Gemini звонить в компании вместо вас
 Агент Muse от Meta даёт каждому пользователю полноценный облачный компьютер с Ubuntu Linux
 Глава Nvidia Дженсен Хуанг: он готов заплатить за ИИ умами наших детей
 Комики превращают тревогу об ИИ в шутки: «Он так хорош, что изменит реальность»
 Ум обходится недёшево: ИИ повышает расходы АНБ, больниц и страховщиков
 Microsoft обновила Copilot: постоянный агент Autopilot и хостинг приложений, созданных ИИ
 Запуск «крупнейшего ИИ-суперкомпьютера» Британии отложили из-за проблем с энергоснабжением
 Anthropic заключила с Akamai облачную сделку на $11,6 млрд — расходы на вычисления превысили $500 млрд менее чем за год
 Пентагон хочет получить $30 млн на создание детектора лжи с ИИ
 Создатель Ruby on Rails Дэвид Хайнемайер Ханссон больше не пишет код вручную
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram