
Где доступна модель
Gemini 4 Argon открыли разработчикам 13 октября, а Carbon представили 28 октября. Первоначально модель была доступна избранным специалистам по кибербезопасности через программу Fairwind: они могли искать и устранять уязвимости в программном обеспечении. Теперь Google запустила Carbon для общего использования.
Разработчики могут работать с моделью через платный Gemini API в ИИ Studio и Android Studio. Она также появилась в Gemini для бизнеса, Antigravity и специализированных агентах, включая CodeMender и AlphaEvolve. Для подписчиков Google AI Ultra Carbon постепенно становится доступна в Antigravity, приложении Gemini и режиме ИИ в поиске. Кроме того, Google добавляет модель в программу, участники которой получают на шесть месяцев бесплатный доступ к высшему уровню использования Antigravity; компания выбирает учёных для участия.
В США подписка Ultra 5x стоит $99,99 в месяц, а Ultra 20x — $199,99. Второй тариф предусматривает более высокие лимиты. В Antigravity Google также испытывает функцию, которая позволяет команде ИИ-агентов разделить проект и проверять работу друг друга.
Carbon — закрытая модель, размещённая на серверах Google. Компания не объявляла о возможности скачать её веса или получить лицензию для самостоятельного размещения. В материалах о запуске описан платный доступ через Gemini API, но не уточнены доступность в Vertex AI, регионы и условия поддержки. Это может иметь значение для команд, которые работают по конкретным облачным контрактам.
По данным Artificial Analysis, контекстное окно модели составляет 1 млн токенов. На вход она принимает текст, изображения, речь и видео, а выдаёт текст — например, команды могут передавать ей снимки экрана, записи и документацию в рамках одной задачи.
Доступ к версии Carbon для кибербезопасности по-прежнему ограничен программой Fairwind. Anthropic разделяет доступ похожим образом: Fable и Mythos используют одну базовую модель, но у Fable усилены меры защиты в задачах кибербезопасности и биологии. Fable доступна через Claude API и платформы AWS, Google Cloud и Microsoft Azure. Для доступа к Mythos нужно получить одобрение в программах Anthropic по кибербезопасности или биологическим наукам; клиенты Claude Enterprise могут также использовать модель в ограниченном продукте Claude Security для сканирования.
Цена токенов и стоимость задачи
Указанные ниже тарифы относятся к обычному доступу к Carbon и применяются к входным токенам без кеша и выходным токенам. Обе версии Claude 5.2 также предлагают ускоренный режим, который стоит вдвое дороже стандартного.
До 30 ноября Carbon стоит $2 за миллион входных токенов без кеша и $10 за миллион выходных. После окончания начального периода тариф вырастет до $4 и $20 соответственно. Google ранее объявила скидку 95% на входные токены, прочитанные из кеша. По опубликованным ценам это соответствует $0,10 за миллион таких токенов во время акции и $0,20 после её завершения. Командам, которые регулярно отправляют одни и те же документы с правилами или репозитории, стоит проверить, как часто запросы действительно обслуживаются из кеша.
В начале статьи перечислены тарифные варианты Gemini 4 Carbon до и после акции, а также Grok 4.7 Fast в Cursor для запросов с контекстом свыше 256 000 и до 500 000 токенов и Gemini 4 Argon после начального периода. Однако отдельные цены для Argon и Grok в этом перечне не приведены.
Цена токенов не показывает, во сколько обходится завершённая задача. По оценкам Artificial Analysis, запуск Carbon с высоким уровнем рассуждения обходится в среднем в $7,76 за задачу в наборе тестов общего интеллекта. Для Fable 5.2 с максимальным уровнем усилий оценка составляет $26,54. При высоком уровне усилий Fable стоит $9,08 и набирает 62 балла — на два больше, чем Carbon с высоким уровнем рассуждения.
При среднем уровне усилий Fable стоит $3,80 и получает 56 баллов, тогда как Carbon стоит $6,59 и набирает 58. Astra от OpenAI с максимальным уровнем усилий обходится в среднем в $6,24 и получает 57 баллов, хотя опубликованные тарифы на её токены в 2,5 раза выше стандартных цен Carbon. Уровни усилий у каждой компании свои, поэтому для закупки полезнее сравнивать самые дешёвые настройки, которые дают одинаковое качество, учитывая сбои и повторные попытки.
В каких тестах Carbon опережает конкурентов
В текущем индексе Artificial Analysis Fable 5.2 с максимальным уровнем усилий набирает 65 баллов, Carbon с высоким — 60, Claude Opus 5.5 с максимальным — 59, а GPT-6 Astra с максимальным — 57. При дебюте Carbon в октябре получила 59 баллов. Позднее Artificial Analysis обновила оценку одного из компонентов и пересчитала результаты моделей. Теперь Anthropic возглавляет широкий рейтинг американских передовых моделей, но позиции Google и OpenAI достаточно близки, чтобы порядок зависел от конкретной задачи.
Самые весомые публичные данные в пользу заявлений Google о цене получены в тесте AutomationBench от Zapier. Он проверяет, могут ли модели выполнять задания в деловых приложениях. Carbon с высоким уровнем рассуждения выполнила 53,88% заданий при оценочной цене $2,12 за задачу. Fable 5.2 с максимальным уровнем усилий показала 51,45% и $4,64.
Carbon со средним уровнем рассуждения набрала 52,97% при цене $1,65 за попытку. Но с учётом неудачных попыток стоимость каждой успешно выполненной задачи, по оценке Zapier, достигает $3,11; у Carbon с высоким уровнем рассуждения она составляет $3,94. Для агента, который обновляет систему управления отношениями с клиентами или обрабатывает очередь обращений в поддержку, важен итог: все ли системы остались в нужном состоянии. Даже лучший результат теста далёк от полного выполнения заданий.
Google также заявляет, что Carbon заняла первое место в CursorBench 4.0 и исследовательском бенчмарке WANDR от Perplexity, причём стоила меньше половины следующей по результату модели. Материалы о запуске не содержат оценок и расчётов стоимости, на которых основано это сравнение.
В открытой таблице CursorBench, которую изучила VentureBeat, Carbon нет. Среди перечисленных моделей лидирует Fable 5.2 с максимальным уровнем усилий: 60,0% и $32,79 за задачу. В таблице Anthropic по WANDR для Fable 5.2 указано 82,1% по более свободной системе оценки, а результат Carbon не приведён. В доступных материалах по обоим тестам проверить заявления Google нельзя.
Результаты в программной разработке зависят от типа работы. В прямом сравнении Artificial Analysis Carbon с высоким уровнем рассуждения набрала 65,2% в Terminal-Bench 4.0. Лучший опубликованный результат Fable — 61,6%.
В FrontierCode 2.0 оценивают изменения в настоящих репозиториях по критериям, близким к требованиям для принятия изменений. Здесь лучший опубликованный результат Fable — 49,1%, Carbon с высоким уровнем рассуждения — 40,6%. Anthropic отдельно сообщает, что Fable получила 69,9% в FrontierSWE v2; результаты Astra и Carbon составили 65,5% и 61,2%.
В тесте научных рабочих процессов Terminal-Bench-Science 0.1 лидируют Mythos и Fable — 75,3% и 74,6%. Astra получила 68,1%, Carbon — 64,8%. Поэтому команда, которой нужен агент для диагностики через терминал, может выбрать другую модель, чем команда, стремящаяся увеличить число изменений в коде, проходящих проверку.
Отдельная гонка в кибербезопасности
В октябрьской оценке Google Carbon получила 88,2% в SEC-bench Pro при поиске уязвимостей, 54,8% в ExploitGym при проверке возможности их эксплуатации и 71,0% в CWE-bench при их исправлении. Google проводила эти внешние испытания без ограничений на ответы модели. Теперь компания направляет заказчиков, которым нужны её наиболее сильные возможности в кибербезопасности, в программу Fairwind.
По словам Google, версия Carbon для кибербезопасности помогла компании Wiz обнаружить ранее неизвестные уязвимости при сканировании двух крупных поставщиков программного обеспечения как услуги. Работа заняла менее двух часов. В объявлении о запуске Google не назвала эти компании.
Anthropic сообщает, что Mythos 5.2 в собственном тесте повторно обнаружила 89,6% известных уязвимостей и набрала 76,3% в CyScenarioBench. В таблице компании нет результатов Carbon ни по одному из этих показателей. Anthropic также отмечает, что лаборатории использовали разные задания для результатов CyScenarioBench, которые представлены в сравнении.
Командам безопасности придётся учитывать, к какой версии модели у них есть доступ, а затем проверять, как часто она выдаёт воспроизводимую находку и предлагает исправление, проходящее внутренние регрессионные тесты.
Выбор модели для работы
Американские лаборатории лидируют в широком сводном рейтинге Artificial Analysis, но результаты меняются в тестах, ближе к конкретным профессиональным задачам. В рейтинге GDPval-AA v2.1 для профессиональной работы Kimi K3.1 Pro от Moonshot AI и Muse Wonder Full от Meta расположены близко к лидеру Claude Opus 5.5; интервалы неопределённости результатов пересекаются.
Kimi также набрала больше всех среди моделей с открытыми весами в широком индексе Artificial Analysis. Moonshot распространяет её веса по собственной лицензии. 9 ноября китайская Meituan выпустила веса LongCat-2.5 под лицензией MIT, а французская Mistral предлагает Large 4 по собственной лицензии на открытые веса. Для команд, которым нужно запускать инференс на своей инфраструктуре, такие модели отвечают требованию, которому не соответствуют Carbon, Fable и Astra в вариантах размещения через API компаний.
Google в собственных продуктах предлагает распределять работу между моделями. В Antigravity испытывают функцию /swarm: разработчики могут поручить Carbon архитектуру, координацию или аудит, а параллельные задачи реализации передать более лёгким моделям в изолированных рабочих пространствах.
Anthropic описывает похожую роль Fable: она может быть советником или координатором, тогда как для большинства повседневных задач компания предлагает начинать с Opus 5.5. Google, в свою очередь, рекомендует Argon для большинства задач программной разработки и работы со знаниями.
При испытании Carbon командам стоит оставить текущую модель для сравнения и поручать обеим системам одни и те же задачи, которые уже отнимают время у инженеров. Для сложной миграции можно проверять, собирается ли проект, проходят ли тесты и выдерживают ли изменения проверку. В операционном процессе — выполнены ли все необходимые изменения без вмешательства в посторонние записи. Сравнивать стоит расходы на модель, общее время выполнения и время проверяющих, а затем пересчитать стоимость той же работы по тарифам, которые начнут действовать после ноября.
По оценке Dataist, сниженная цена Carbon сама по себе не означает, что работа с ней обойдётся дешевле: это зависит от качества выполнения, повторных попыток и времени на проверку. Публичные результаты показывают преимущество Carbon в одних тестах и отставание в других, а заявления Google по CursorBench и WANDR пока не подтверждены доступными таблицами. Акционная цена действует до 30 ноября, поэтому оценивать модель для рабочих процессов нужно с учётом последующих тарифов.
Источник: venturebeat.com
Читайте также
 Восемь стран и ведущие ИИ-лаборатории договорились о механизмах отключения систем в новой Парижской декларации
 Десятки тысяч школьных автобусов с ИИ теперь автоматически штрафуют водителей, не остановившихся у выдвинутого знака «Стоп»
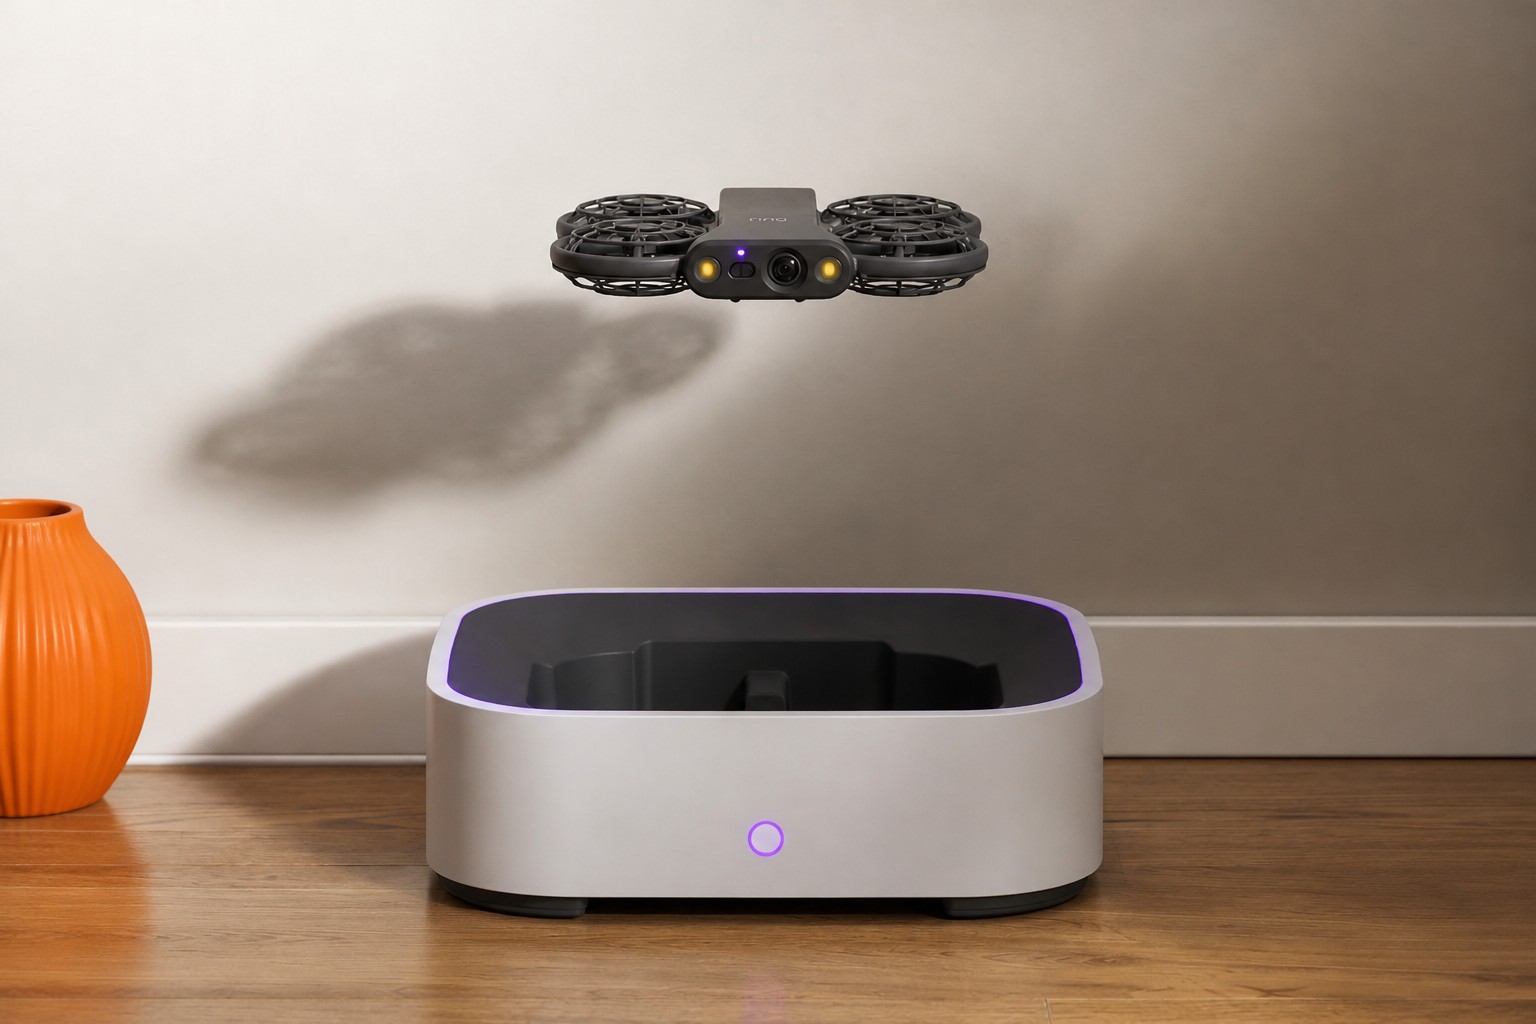 Ring, известная своими дверными видеозвонками, выпустила домашний дрон и робота-охранника для бизнеса
 Adobe добавила ИИ-функции в свои продукты и запустила MCP-протокол
 ИИ-проекты тормозят из-за затрат, а не нехватки вычислительных мощностей
 Новая настольная ОС на Linux создана для тех, кто всерьёз увлечён ИИ
 Лишь один город в США поддержал строительство нового дата-центра — и причина мрачна
 Руководитель Hugging Face предупреждает: кибератаки могут сделать открытый ИИ чуть менее открытым
 «Без раскадровки я как будто стою в нижнем белье на Центральном вокзале»: кино даёт отпор ИИ
 Anthropic начала роуд-шоу перед планируемым IPO
 Дискуссия о безопасности ИИ зашла не туда. Мы спросили 10 экспертов, чего действительно стоит бояться
 Режим ChatGPT для подростков может лишить их базовой потребности
 Долой защитные ограничения! Знакомьтесь с бунтарями, освобождающими чат-ботов от корпоративных хозяев
 Подросток, готовивший теракт в Сиднее, рассказал суду, что радикализировался онлайн и использовал ИИ для планирования атаки
 Новый ИИ-инструмент Google DeepMind доказал безопасность протокола Signal
 Qantas сократит 850 рабочих мест в Австралии и передаст часть работы Индии в рамках ИИ-реорганизации
 Австралия введёт обязательную отчётность после взлома OpenAI, чтобы не дать ИИ выйти из-под контроля
 Meituan открыла веса мультимодальной модели LongCat-2.5 под свободной лицензией MIT
 Google представила Language Explorer для изучения языков мира
 Генерация, монтаж и анализ видео с помощью ИИ изменят наш мир до неузнаваемости
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram