
Большинство существующих видеоассистентов понимают чёткие команды — например, сообщить, когда закипит вода, — и редко замечают невысказанные намерения. Им также трудно отслеживать уже выполненные действия: из-за этого они повторяют советы или отвечают с опозданием. Если пользователь меняет просьбу на ходу, ассистент часто продолжает следовать первоначальной.
Три части более внимательного ассистента
Чтобы измерить эту проблему, команда собрала бенчмарк примерно из 4 100 примеров: это более 183 часов записей повседневной жизни и работы с программами. Gemini 2.5 Flash предлагала, когда стоит помочь и что сказать, а четыре оценщика должны были единогласно одобрить каждый пример. В тесте три этапа: чёткие инструкции, расплывчатые цели и просьбы, которые меняются со временем. В одном сценарии человек разбирает игрушечный экскаватор, просит сообщать о ходе работы, а через три минуты вместо этого просит проверить качество.
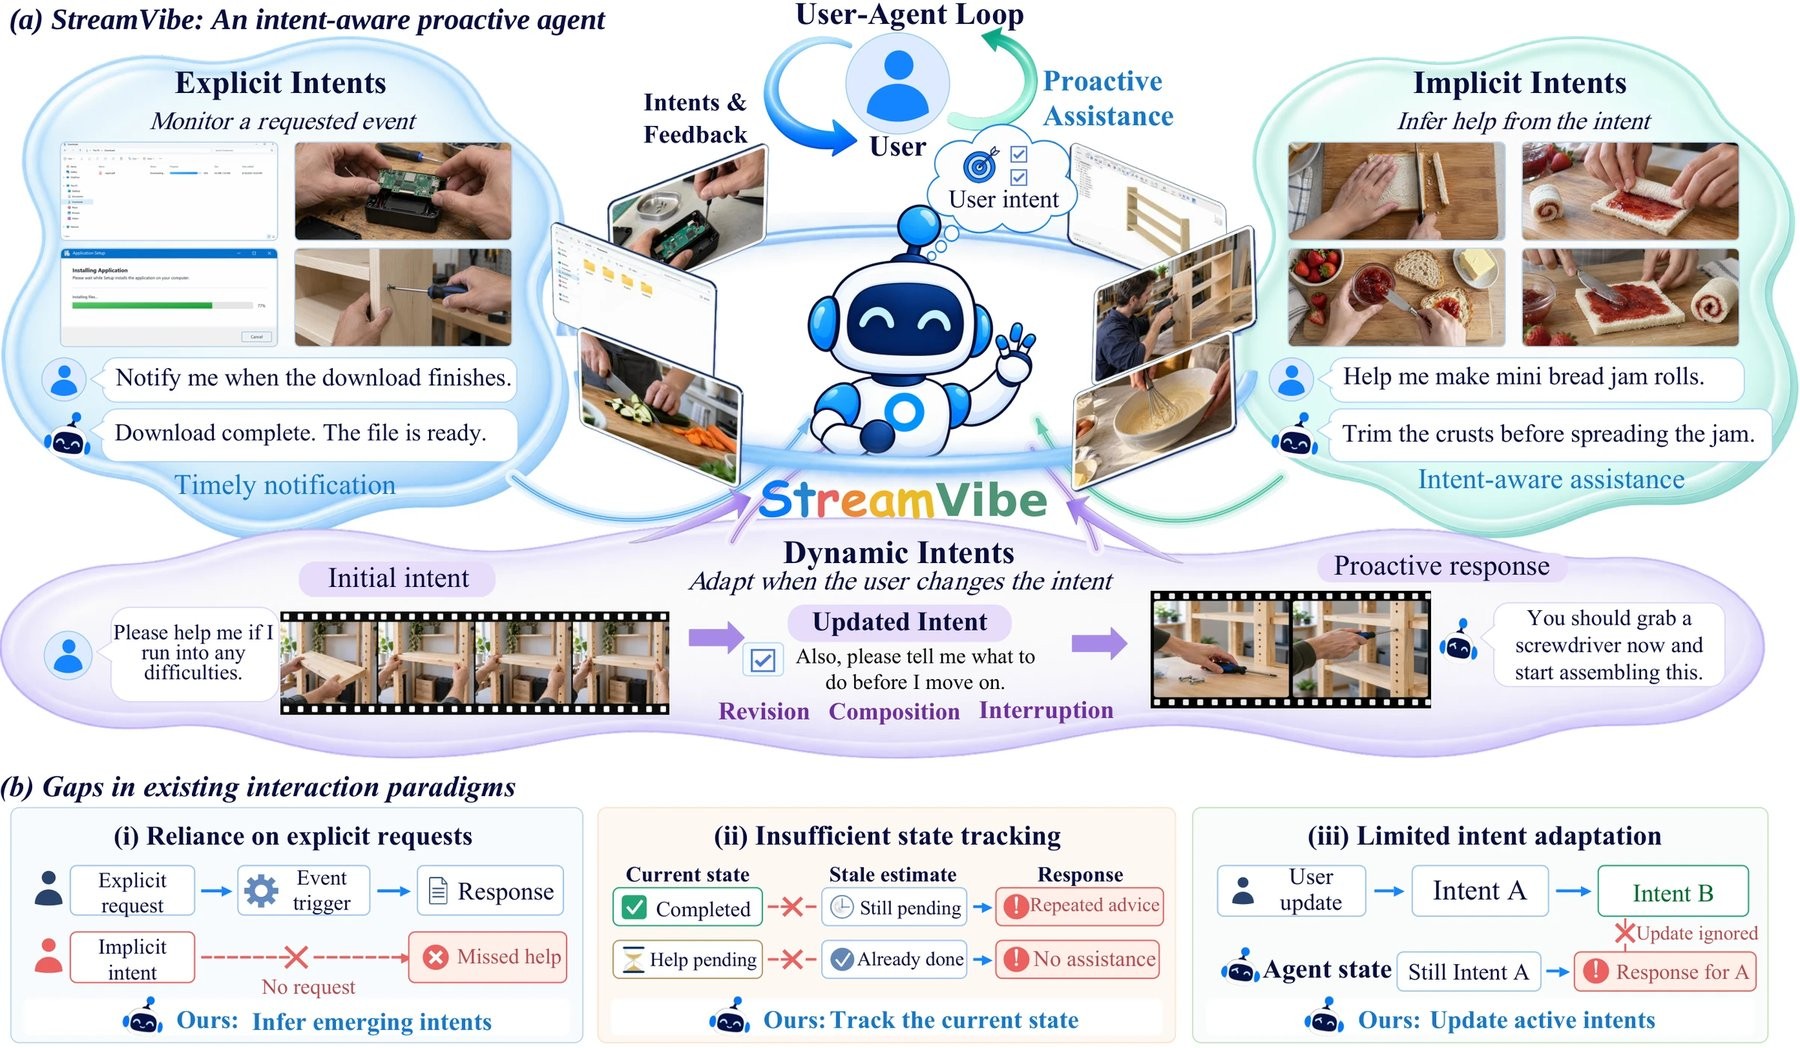
StreamVibe различает явно выраженные, невысказанные и меняющиеся намерения пользователя в ходе выполнения задачи
Источник: the-decoder.com
Затем исследователи обучили StreamVibe-VL — модель, которая, по-видимому, основана на Qwen3.5-9B от Alibaba. Каждую секунду она решает, промолчать или ответить. На втором этапе обучения с подкреплением модель учат сдерживаться, чтобы она не перебивала постоянно. Отдельная система памяти отслеживает невыполненные просьбы и завершённые шаги, но решение о том, говорить ли и что именно сказать, принимает сама модель.
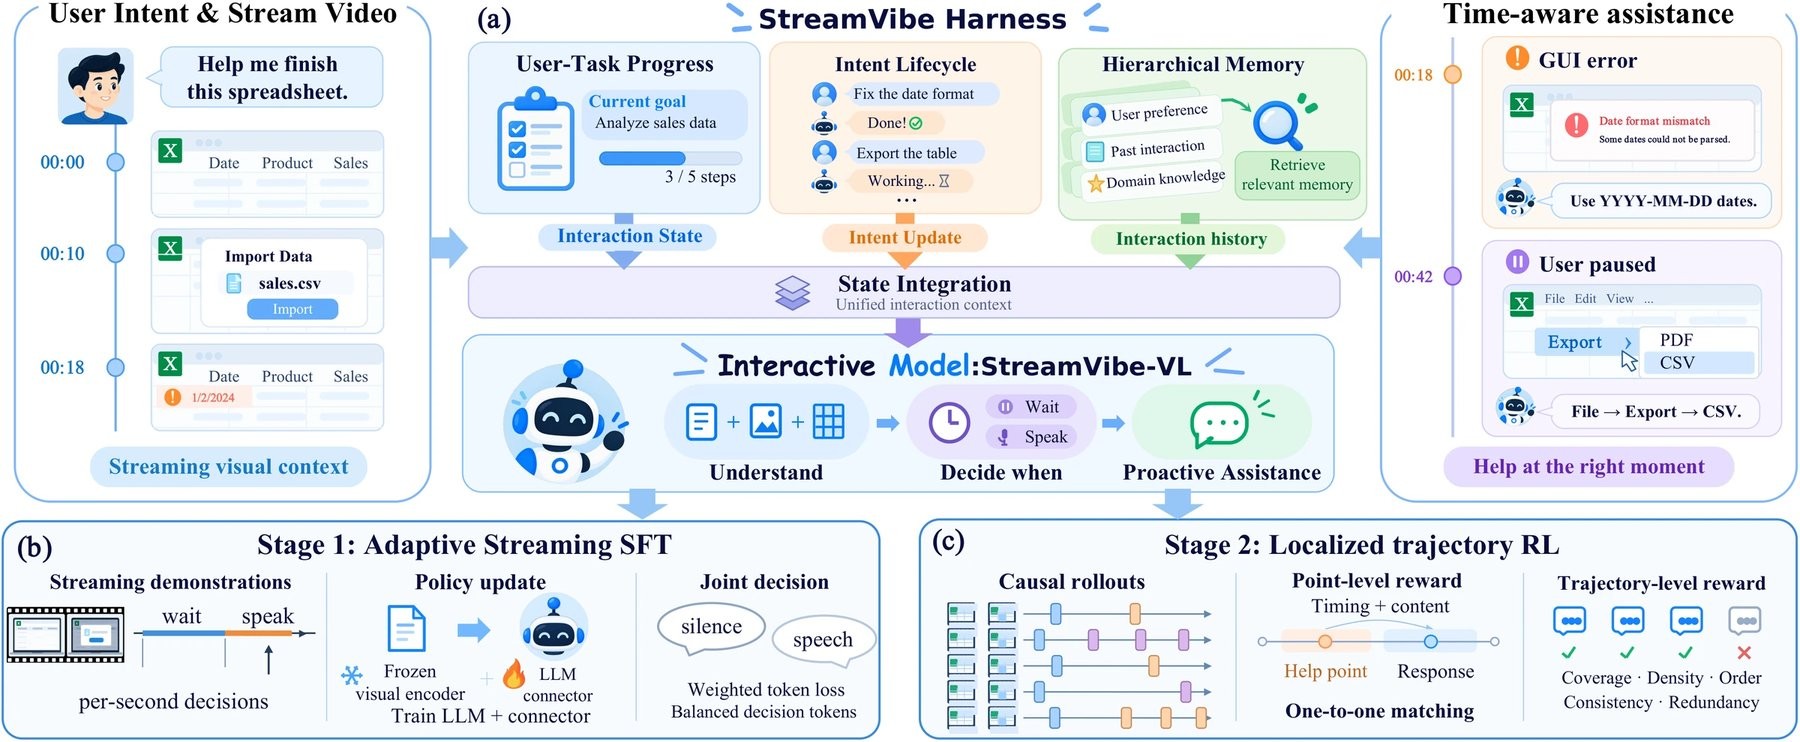
Отдельная система отслеживает запросы и статус задачи, а сама модель решает, когда и что сказать
Источник: the-decoder.com
Все модели теряют нить разговора при непрерывной работе
По данным исследователей, StreamVibe-VL на 10,7% улучшает выбор времени ответа и его качество по сравнению с другими моделями. Система памяти, как предполагается, дополнительно повышает качество инициативного взаимодействия на 12,3% и сокращает число лишних вмешательств.
StreamVibe-VL заметно превосходит базовую модель и другие модели с открытыми весами, хотя принадлежащая Google Gemini 3.8 Flash показывает более высокие результаты в нескольких тестах. Как утверждают авторы, специализированное обучение не ухудшает общее понимание видео.
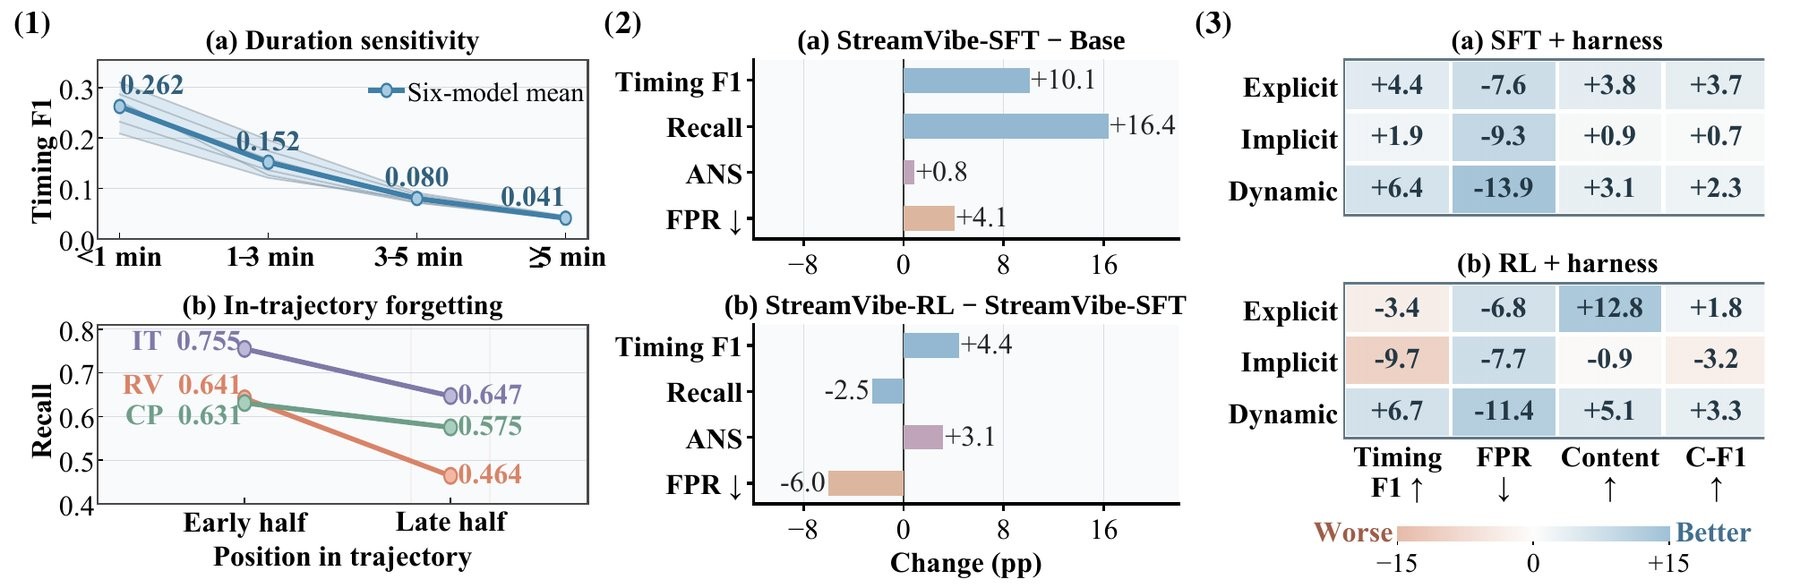
Чем длиннее видео, тем значительно реже модели правильно выбирают момент для ответа; система в основном сокращает число ненужных прерываний
Источник: the-decoder.com
Когда моделям нужно лишь в отдельные моменты решить, уместно ли отвечать на запрос, они часто выбирают верно. Но при обработке целого видео, где приходится учитывать собственные предыдущие ответы, результаты всех проверенных систем резко падают: ошибки накапливаются, а один из ключевых показателей качества содержания ответов снижается до 61,5% с учётом истории самой системы. В видео длиннее пяти минут модели редко выбирают подходящий момент для ответа и особенно плохо отслеживают изменившиеся инструкции на протяжении долгого времени.
В примере из статьи и страницы проекта показан урок по превращению фотографии в чёрно-белое изображение в GIMP. Модель для сравнения JoyAI говорит, что готовое изображение уже сохранено, хотя пользователь ещё даже не открыл его. StreamVibe-VL подсказывает следующий шаг вовремя: выбрать «Цвета», а затем «Обесцветить». В пошаговом уроке по приготовлению рулетиков из тостового хлеба с джемом другие модели лишь описывают происходящее на экране — например, как хлеб расплющивают. StreamVibe-VL советует сначала срезать корочку.
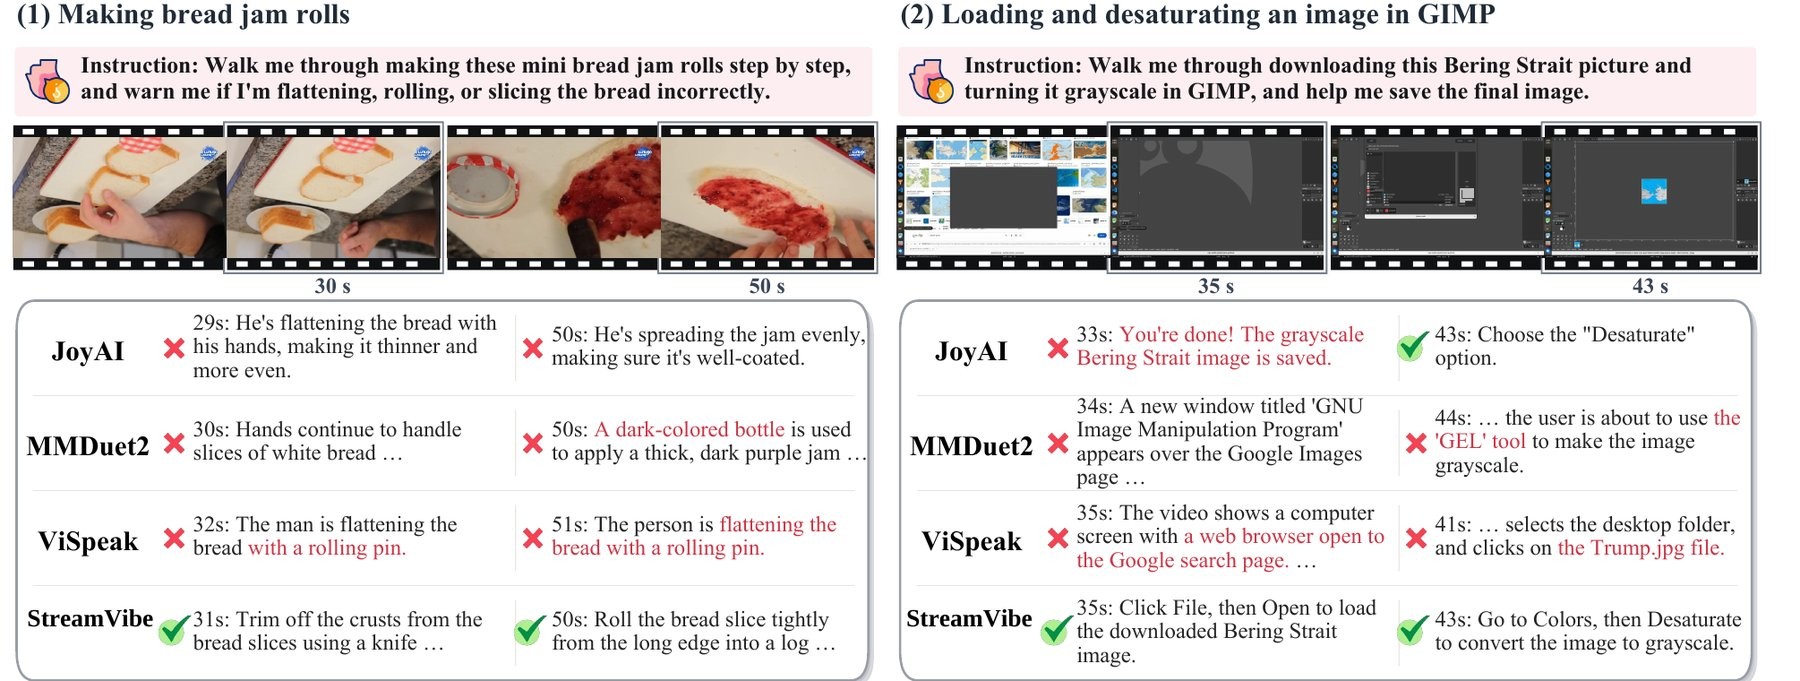
В то время как модели для сравнения часто лишь описывают происходящее в видео, StreamVibe предлагает конкретные следующие шаги
Источник: the-decoder.com
Исследователи признают, что реальные ситуации, вероятно, сложнее условий их теста. В дальнейшей работе команда изучит, как со временем влияют друг на друга предпочтения пользователя и окружающая обстановка.
Google уже некоторое время разрабатывает системы, которые активно анализируют видео. В сентябре компания представила для Gemini агентный анализ видео: модель сама выбирает, какие сцены изучить внимательнее. Недавно Google также показала Gemini 4 Argon, способную отслеживать длинные последовательности действий в видео с роботами и находить ошибки. Ассистент StreamVibe должен понимать, что происходит в каждый момент, и распознавать, когда его помощь действительно нужна.
В бенчмарке ProactiveBench модели часто гадают или отказываются отвечать вместо того, чтобы задать конкретный вопрос, если визуальной информации не хватает. Отдельный бенчмарк на понимание видео выявил серьёзные слабости в пространственных и временных рассуждениях. А исследователи Microsoft показали, что сам разговор может ухудшать работу автономных ИИ-агентов.
Источник: the-decoder.com
Читайте также
 Исследование: китайские ИИ-модели сложнее, чем просто рупоры правительства
 Сбои ИИ-распознавания лиц всё чаще приводят к ложным обвинениям покупателей в магазинных кражах
 Чатботы уводят туристов с маршрута — и это может закончиться опасно
 В ChatGPT OpenAI объединит Chat и Work — безлимитная оплата за запросы уходит в прошлое
 Судья разрешила продолжить иск NAACP против xAI из-за загрязнения от дата-центра
 Глава Apple: мы не хотим выпускать ИИ-функции только ради самого ИИ
 Советы по пчеловодству и рестлингу учат ИИ саботировать надзор
 Внедрение водяных знаков Anthropic оставляет лазейку в двух старых моделях Claude
 Пора наконец в спортзал: ИИ-роботы уже там качаются
 Открытые ИИ-модели дешевеют и становятся лучше: как пользоваться ими, не оплачивая их запуск самим
 В округе Альбанезе растёт недовольство: художники Грейндлера объединились против «безумного» плана по ИИ
 OpenAI планирует обучать модели на данных сессий кибербезопасности Daybreak Blue, которые раньше не использовала для обучения
 Сэм Альтман — разгневанным математикам: поток ИИ-материала никуда не денется
 Извращенцы с помощью ИИ раздевают знаменитостей на снимках папарацци ради кликов
 ИИ — ваш новый помощник в любви? Как чат-боты меняют знакомства
 Жуткий новый стилер использует ИИ, чтобы собирать досье на жертв
 Google DeepMind создала глобальную карту лесов по спутниковым данным и с помощью ИИ
 Muse от Meta может перевернуть целые отрасли — но пока этого не произошло
 Microsoft предлагает добровольное увольнение четверти сотрудников, сохраняя команды, критически важные для развития ИИ
 OpenAI привлекла лишь $11 млрд из запланированных $30 млрд: крупные инвесторы остыли к ИИ
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram