
35 исследователей из Международного центра теоретических наук (ICTS), Гарвардского университета, KU Leuven, Google DeepMind и других организаций выпустили TheoPhysEval. В бенчмарк вошли 50 неопубликованных исследовательских задач с ответами, которые можно проверить. По оценке авторов, специалисту в нужной области обычно понадобился бы примерно день или меньше, чтобы решить одну такую задачу без помощи ИИ. Исследователям из смежных областей потребовалось бы значительно больше времени.
Команда проверила коммерчески доступных ИИ-агентов и не давала им подсказок от людей. Лучший результат показала GPT-6-Astra в среде для программирования Codex от OpenAI: она правильно решила 49 из 50 задач, потратив в среднем менее 3 долларов на одну и чуть меньше 116 долларов на весь бенчмарк.
Бенчмарк проверяет рутинные задачи, а не большие загадки
Авторы намеренно исключили крупные нерешённые вопросы и сосредоточились на задачах типа «подставь и посчитай»: исследователь применяет известные методы к немного изменённой задаче. Участники часто меняли несколько значений в расчётах из собственных недавних статей, чтобы ответ нельзя было угадать по исходной работе. По словам исследователей, такие задачи часто дают аспирантам как первый шаг в науке.
Задача из исследований чёрных дыр показывает, насколько трудной может быть и такая работа. Нужно найти старую статью, перенести уравнения из пятимерного пространства-времени в четырёхмерное, а затем вычислить результат с помощью специальной программы. Координатор проекта Суврат Раджу, один из авторов той статьи, потратил на решение около дня. Исследователи полагают, что до появления современных агентов лишь несколько специалистов сочетали необходимые знания физики и опыт работы с такими вычислительными методами. Даже им понадобилось бы несколько дней.
Задачи охватывают одиннадцать областей теоретической физики — от потоков жидкостей и биологических процессов до физики частиц и космологии. Каждый агент проходил тест дважды: сначала в реалистичных условиях с поиском в интернете, затем без доступа к сети.
На втором месте оказалась Opus 5.5 от Anthropic в Claude Code с результатом 92%. Gemini 3.8 Flash от Google набрала 68%, а открытые модели DeepSeek-V4.1-Flash и GLM 5.3 — 54% и 42%. Более слабые модели иногда допускали ошибки, которые специалист заметил бы сразу. В задаче о чёрной дыре Gemini и GLM во время поиска в интернете скопировали формулы из старой статьи без изменений. Но те формулы относятся к пятимерному пространству, тогда как требовалось четырёхмерное.
Доступ к интернету неожиданно мало повлиял на результаты. Без поиска Astra и Opus набрали по 92%. Многие задачи опираются на формулы из научных статей, которые модели обычно не получали. Авторы считают, что это может говорить о том, что передовые языковые модели фактически запомнили значительную часть литературы по теоретической физике.
С поиском Astra решила всё, кроме одной задачи, которая оказалась не по силам ни одной модели. Нужно было восстановить уравнение, порождающее заданную кривую. Решение специалистов опирается на специальные математические формы, которые лишь в широком смысле можно считать требуемым дифференциальным уравнением. Авторы признают, что задача может показаться «несправедливой», но считают её реалистичной: физикам часто приходится выводить лежащие в основе явления по неточным данным.
Некоторые ошибки агентов оказались ошибками в ответах
После проверки нескольких задач вместе со специалистами выяснилось, что в эталонных решениях были небольшие, трудно заметные ошибки. После исправления этих ошибок ответы Astra во всех таких случаях оказались верными.
Это может объяснить и кажущееся противоречие: на TheoPhysEval агенты справились лучше, чем на некоторых других бенчмарках по физике, например CritPt, хотя авторы считают свои задачи в среднем более сложными. Недавнее исследование показало, что некоторые бенчмарки по теоретической физике оценивают ответы неверно и порой серьёзно недооценивают возможности моделей.
Задачи и настройку для тестирования можно скачать как набор данных на Hugging Face.
Почему точные расчёты пока не привели к открытиям
Авторы пишут, что некоторые современные модели, возможно, уже превзошли лучших исследователей-людей в конкретных расчётах, в том числе в специализированных областях. Они называют это крупным рубежом.
В математике последствия заметнее: ИИ-агенты уже решили важные открытые задачи. По данным OpenAI, к ним относится задача Навье — Стокса об уравнениях движения жидкости — одна из знаменитых задач тысячелетия. В теоретической физике сопоставимого прорыва пока не произошло.
Авторы объясняют разницу тем, что конкретный расчёт с проверяемым ответом появляется лишь в конце исследования. До этого нужно построить теорию и задать ей «правильные» вопросы. Если задача оказывается слишком трудной, хороший исследователь переключается на связанную с ней задачу попроще, но не менее интересную. Современные агенты пока не умеют этого делать.
У физиков есть общее — хотя и далеко не единодушное — представление о том, что делает задачу интересной. У агентов такого «чутья», похоже, пока нет. Когда их просят придумать новые задачи, они увязают в деталях, которые человек счёл бы скучными.
Исследователи подчёркивают: эти наблюдения нельзя выразить в числах, и они не предсказывают, куда движется ИИ. Авторы допускают, что в ближайшем будущем ИИ-агенты смогут самостоятельно вести исследования высокого уровня, но для этого потребуется больше, чем умение решать задачи.
ИИ уже меняет подготовку физиков и конкуренцию
Авторы уже видят последствия для обучения. Ещё недавно часть задач бенчмарка могла подойти начинающим исследователям как первая самостоятельная работа. Теперь это уже неуместно, если только цель не состоит именно в освоении материала.
Исследователи указывают и на структурную проблему. Теоретическая физика исторически требовала гораздо меньше денег, чем экспериментальная, поэтому возможности в этой области были сравнительно равными. Способные ИИ-агенты могут изменить ситуацию. Задачи бенчмарка пока обходятся недорого: полный запуск Astra стоил около 116 долларов. Но для более трудных задач авторы ожидают резкого роста расходов. Тогда бюджет исследовательской группы может сильнее влиять на то, чего она способна добиться, даже в теоретической физике. Это ставит вопросы о доступе и равных возможностях в этой области.
В математике эти споры уже идут, например вокруг Лейденской декларации. Авторы считают, что теоретической физике тоже стоит начать обсуждение до того, как ИИ изменит область. Пока одна из школ мысли в физике призывала исследователей «заткнуться и считать». Если важнее станут научное чутьё и видение, физикам, возможно, придётся «остановиться и подумать».
Читайте также
 Жители отвергают выплату по $10 000 за согласие разместить в их посёлке дата-центр
 Bluesky расширила возможности приложения Attie на базе ИИ: теперь в нём каждый может создавать сайты, игры и не только
 Muse Spark Open — ответ Meta на Qwen, GLM и Kimi в гонке открытых моделей с весами
 Bank of America направил 4 тысячи человек устранять уязвимости, найденные Mythos от Anthropic и другими ИИ-моделями
 Anthropic рассказала о независимых оценщиках
 FLUX 3 Image Klein от Black Forest Labs работает на видеокартах для обычных ПК с 8 ГБ видеопамяти
 Google запустила в США инструмент для покупок Universal Cart
 Arcade.dev: новая система подбора инструментов снижает расходы компаний на входные токены на 37%
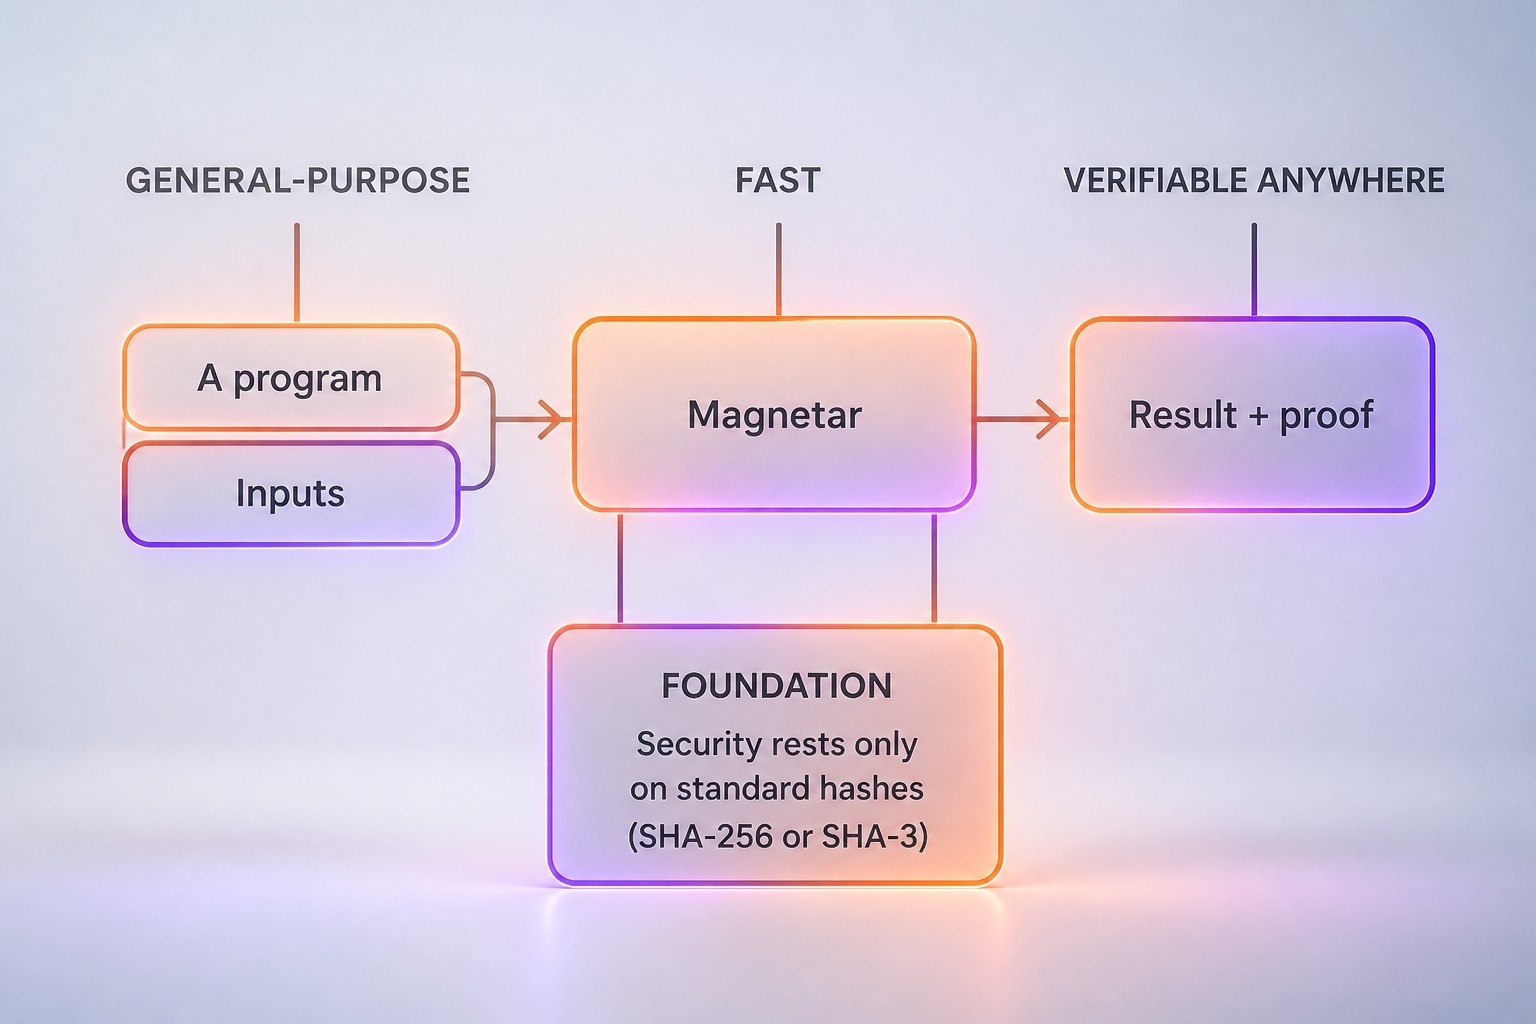 Magnetar подтверждает корректность программ для вычислений общего назначения с помощью доказательств
 ИИ-агенты появятся в автомобилях Rivian
 NVIDIA дообучила Nemotron 3.5 Super VL, и она обошла Claude Opus 5 и GPT-6.1 Sol в тестах специализированных задач
 Илон Маск признался, что столкнулся с ИИ-психозом
 Если ИИ-модели и правда обладают сознанием, как не раз намекала Anthropic, заставлять их работать — чудовищное рабство
 Bee от Amazon выпустила два новых персональных ИИ-устройства: цены начинаются от $75
 Выручка Anthropic в третьем квартале достигла $16,8 млрд, но рост замедлился перед запланированным на ноябрь IPO
 Шесть безумных идей, которые могут сохранить ваш разум навсегда
 Figma представила новые инструменты, определяющие работу агентов на её платформе
 Gudea использует ИИ, чтобы помочь организациям пресекать кризисы в соцсетях до того, как они разгорятся
 Ricursive Intelligence делает ставку на чипы, спроектированные ИИ, чтобы справиться с дефицитом вычислительных мощностей
 Разбираемся в Meta Muse Wonder и Muse Wonder Full
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram