
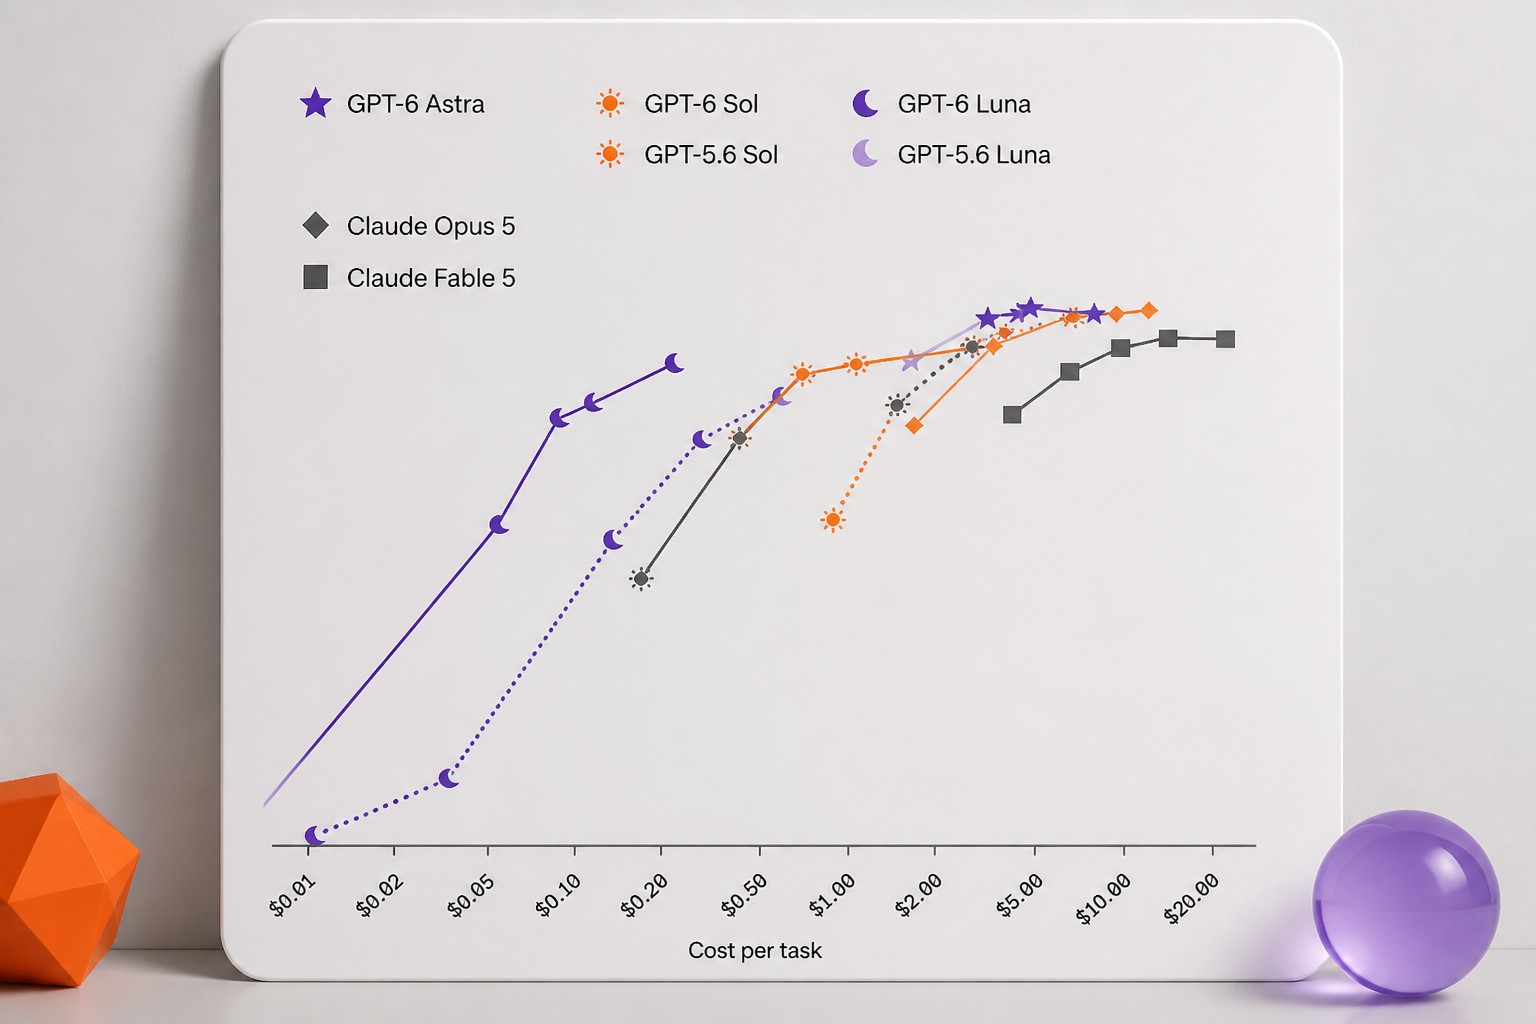
Снижение цены составило 50% относительно GPT-5.6 Sol и Luna. GPT-6 Sol стоит $2 за миллион входных токенов и $10 за миллион выходных. Для Luna эти тарифы составляют $0,10 и $0,50 соответственно.
OpenAI объясняет удешевление улучшениями в кэшировании и инференсе и утверждает, что полностью передаёт экономию пользователям. Теперь цены моделей находятся примерно на уровне более дешёвых моделей с открытыми весами. Terra, которая раньше была самой доступной моделью в линейке, больше недоступна.
Sol предназначена для регулярно повторяющихся сложных задач:
Luna рассчитана на большие объёмы чётко определённых операций по низкой цене:
OpenAI также улучшила кэширование промтов в GPT-6: скидка на кэшированные входные токены достигает 90%. Новый дашборд кэширования и инструмент диагностики должны помочь разработчикам эффективнее использовать кэш. Теперь они могут менять уровень рассуждения и доступность инструментов, не сбрасывая кэш.
На старте обе модели доступны в ChatGPT Work и Codex подписчикам Plus, Pro, Business, Enterprise и Edu. Пользователи Free и Go получают доступ к Luna через настольное приложение, но ни одна из моделей изначально не работает в обычном чате. В API они представлены под именами gpt-6-sol и gpt-6-luna, а в ChatGPT доступ разворачивается постепенно.
Преимущество GPT-6 — в цене
OpenAI продвигает новые модели прежде всего через соотношение цены и производительности в сравнении с линейкой Claude.
В OSWorld 2.0, где проверяется управление компьютером, OpenAI заявляет, что GPT-6 показывает результаты, близкие к Claude Opus 5, при стоимости примерно на 80% ниже. При этом Astra по-прежнему лидирует в этой категории.
AutomationBench оценивает выполнение рабочих процессов с использованием 47 инструментов. На максимальном уровне рассуждения GPT-6 Sol, по данным OpenAI, опережает Claude Opus 5 на максимальном уровне. Стоимость одной задачи для Sol составляет лишь 9% от цены задачи для Opus.
Luna улучшила результат предшественницы на 5,4 процентного пункта, снизив стоимость на 58%.
Для задач по программированию OpenAI приводит результаты двух бенчмарков. FrontierCode 1.1 проверяет, создают ли агенты для программирования код, который можно встроить в существующий проект. В тесте учитываются качество тестов, стиль кода и соответствие требованиям.
GPT-6 Sol на максимальном уровне рассуждения набрала 49,3% при стоимости $2,14 за задачу. Это примерно соответствует результату Claude Fable 5.1 — 50,3%, но Fable стоит в шесть раз дороже: $12,83 за задачу.
Claude Opus 5 получила 53,4% при цене $4,31 за задачу на среднем уровне рассуждения. Именно этот уровень дал модели лучший результат в данном тесте.
Уровни рассуждения GPT-6
В DeepSWE v1.1, бенчмарке для сложных задач программной инженерии в настоящих кодовых базах, GPT-6 Sol показала 68,8% на максимальном уровне рассуждения. Это на 1,1 процентного пункта меньше лучшего результата Claude Fable 5 — 69,9% на уровне «xhigh». На уровне «max» Fable набрала 69,7% при стоимости $21,63 за задачу.
Sol при этом не претендует на лидерство в тесте. Claude Opus 5 получила 73,7% на максимальном уровне рассуждения при цене $11,84 за задачу, а собственная модель OpenAI GPT-5.6 Sol — 72,7% при стоимости $6,46.
Задача GPT-6 Sol — приблизиться к этим результатам за небольшую долю цены. На уровне «xhigh» модель набрала 66,6% при стоимости $1 за задачу. Luna обходится ещё дешевле: она показывает такой же результат на максимальном уровне рассуждения всего за $0,22.
OpenAI утверждает, что результат Luna сопоставим с Claude Opus 5 и Claude Fable 5 на среднем уровне рассуждения. При этом Luna дешевле Opus на 93%, а Fable — на 96%.
Результаты DeepSWE усложняют выбор даже между моделями OpenAI. Luna на максимальном уровне рассуждения показывает тот же результат, что Sol на уровне «xhigh», но стоит на 78% дешевле. Если поднять Sol до максимального уровня, результат вырастет лишь до 68,8% — всего на 2,2 процентного пункта выше показателя Luna.
В опубликованный набор тестов OpenAI вошли не все привычные метрики. В нём нет GDPval для интеллектуальной работы и Terminal-Bench 4.0 для задач с ИИ-агентами. Кроме того, OpenAI, похоже, не учла запуск Opus 5.5 — этой модели может требоваться на 40% меньше затрат, чем Opus 5, при заметно более высокой производительности.
Независимый анализ не видит заметного прогресса
По данным Artificial Analysis, GPT-6 Sol и Luna вдвое снизили стоимость отдельных задач по сравнению с предшественницами, но по показателям «интеллекта» остались на уровне GPT-5.6: в одних оценках появились улучшения, в других — ухудшения. В индексе агентов для программирования Sol прибавила 2 балла, а Luna потеряла 2 балла.
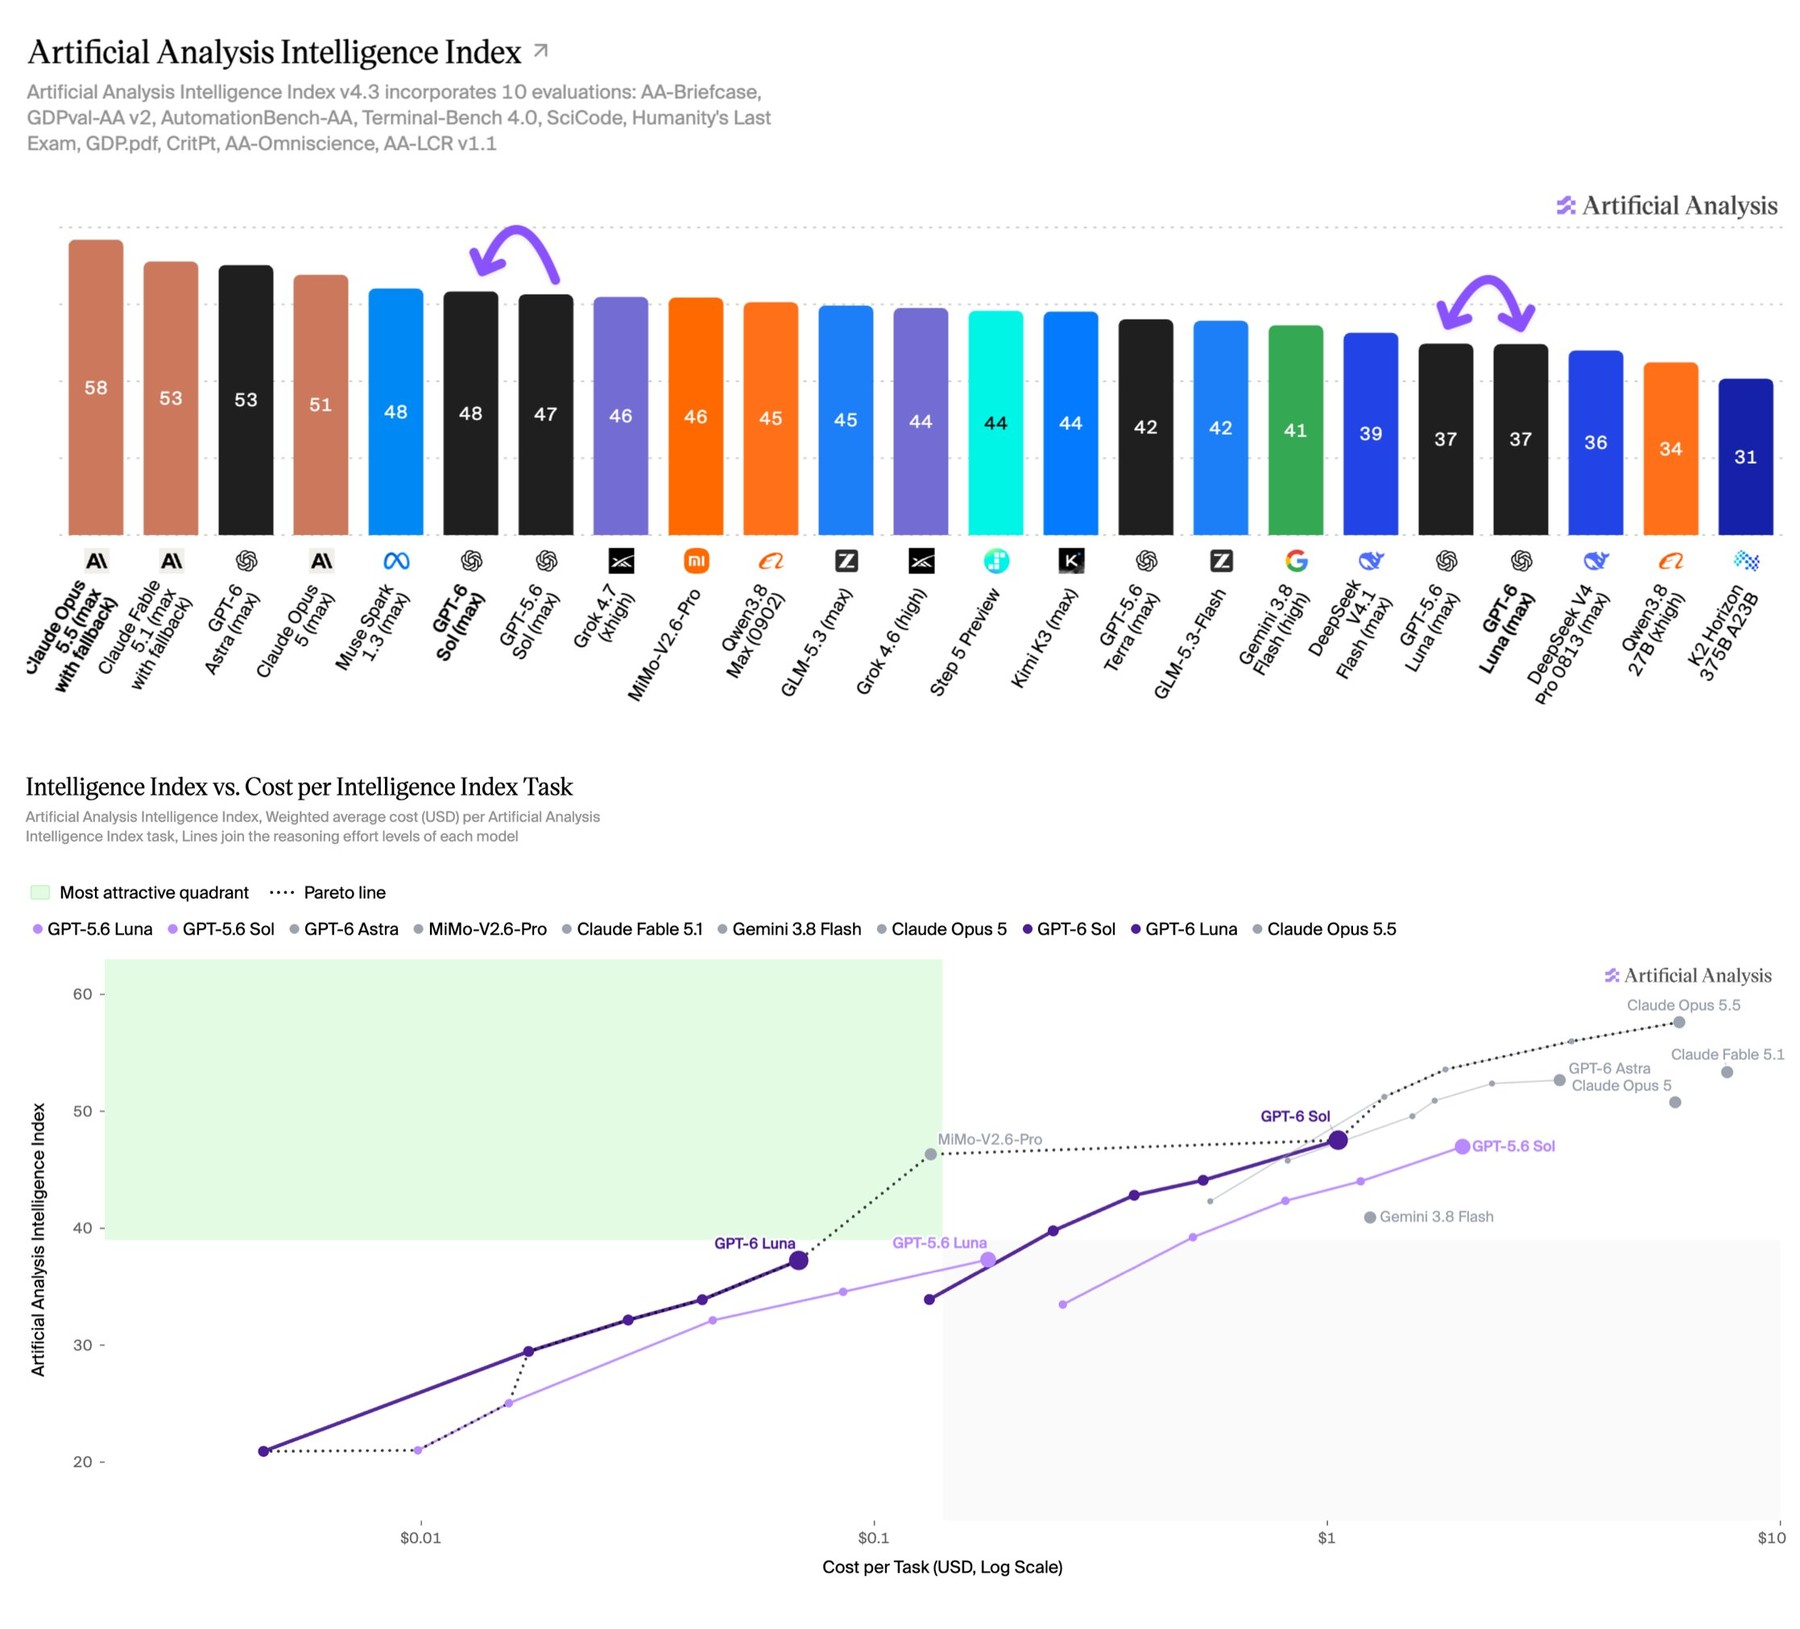
В индексе Intelligence Index от Artificial Analysis GPT-6 Sol поднялся с 47 до 48 баллов по сравнению с предшественником, тогда как Luna осталась на уровне 37. Реальная разница — в гораздо более низкой стоимости одной задачи, как показывает нижняя диаграмма
Источник: the-decoder.com
Artificial Analysis также обнаружила ухудшение результатов в двух ключевых бенчмарках интеллектуальной работы. GDPval-AA v2.1 проверяет работу с компьютером в 44 профессиональных областях. В нём Sol потеряла около 100 баллов Эло, а Luna — примерно 75. Ручная проверка показала, что откат в основном связан с более низким качеством презентации и неполными результатами.
Ранее Artificial Analysis уже критиковали за слишком низкую оценку модели Astra из-за устаревших бенчмарков. После этого обновили два теста, и Astra снова заняла первое место. Что произойдёт с оценками GPT-6, пока неизвестно.
OpenAI явно делает ставку на цену GPT-6 Sol и Luna. Теперь моделям предстоит показать себя в повседневной работе, поскольку бенчмарки отражают лишь часть возможностей. Этим, возможно, объясняется отсутствие некоторых тестов в опубликованных результатах. Разные уровни рассуждения и показатели, иногда похожие на оптимизацию под бенчмарки, намеренную или нет, делают сравнение моделей всё более запутанным.
Читайте также
 OpenAI представила GPT-6 Sol и Luna — с более низкой ценой и меньшим числом ошибок
 Почему все говорят о Jev — ИИ, который не ведёт диалогов
 Anthropic: Claude Opus 5.5 обошла Fable 5.1 в агентных тестах при API на 60% дешевле
 Как получить свою долю в компенсации Apple на $250 млн по делу Siri
 Говорить необязательно: Jev показывает ценность моделей принятия решений
 Насколько безопасно жить рядом с дата-центром? Возможные риски
 Tokenmaxxing: опасный новый тренд, который бизнесу пора остановить
 Оптический проект MIT подстёгивает ловкость роботов
 Не дайте блеску генеративного ИИ заслонить лёгкие победы предсказательного ИИ
 От дашбордов к решениям: ИИ меняет правила игры в SaaS
 ИИ помогает метаосознанности следить за осознанностью и сдерживать бездумность
 Грузовик-робот уверяет: его ИИ ездит по шоссе без предварительного обучения
 Агентный ИИ может найти свой идеальный полигон в женском спорте
 Дочь Робина Уильямса в ужасе от ИИ-роликов о нём с теориями заговора спустя годы после смерти
 Claude Opus 5.5 не уступает Fable 5.1, дешевле и обещает меньше «клау́довского» текста
 DraftKings использует ИИ, чтобы выявлять зависимых игроков и подсаживать их
 Как UK AISI и EvalEval делают результаты бенчмарков воспроизводимыми
 AstroForge передаёт ИИ управление своим следующим космическим аппаратом
 Джордж Осборн из OpenAI: противники дата-центров тормозят развитие Британии
 Rabbit возвращается — теперь с приложением ИИ-агента
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram