
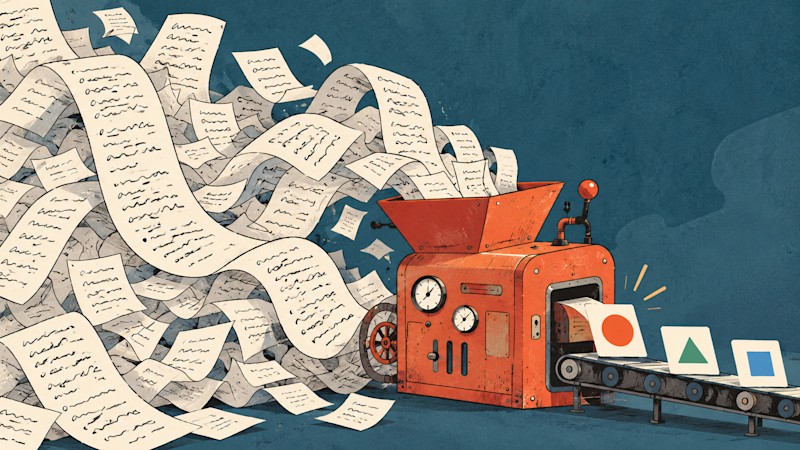
Зачем генерировать текст, если нужна только метка
Чат-модели создают для другой работы. Предварительное обучение учит их предсказывать следующий токен, а последующее обучение с подкреплением на основе обратной связи от людей — выдавать ответы, которые нравятся пользователям. И тот и другой этап нацелен на создание текста. Автоматизации же нужны значения заданных типов, предсказуемая задержка, стабильная стоимость каждого запроса и результаты, которые легко сравнить с правильными ответами.
Даже точный ответ генеративной модели обходится в последовательное декодирование токенов. Затем результат нужно разобрать и проверить, а ещё обработать случаи, когда модель отходит от заданного формата, добавляет комментарии или отказывается отвечать. К тому же генеративные модели плохо оценивают собственную уверенность. Если система не умеет определять, когда может ошибиться, ей трудно надёжно решать, в каких случаях нужно передать дело человеку. В публикации о запуске TypeSafe прямо сопоставляет последовательную генерацию с параллельным выбором Jev, а самооценку уверенности — с калиброванными вероятностями.
Небольшие языковые модели стали быстрыми и дешёвыми, но для решения всё равно генерируют токены. Классификатор сразу возвращает метку или оценку, которая нужна вызывающей его программе, не создавая текст.
Предварительное обучение улучшило классификацию
Если для принятия решений классификация подходит лучше, почему интерес к ней вернулся именно сейчас? Главная причина — качество предварительного обучения.
К 2019 году исследователи уже показали, что классификация без дополнительных примеров работает на практике. Yin и коллеги приспособили модели логического вывода на естественном языке для проверки возможных меток по входным данным, а facebook/bart-large-mnli стал распространённым способом классифицировать текст по меткам, заданным при запросе. Но за пределами обучающих областей такие модели работали нестабильно, поэтому многим внедрениям по-прежнему требовались размеченные данные и обучение под конкретную задачу.
BERT обучали примерно на 3,3 миллиарда слов. Выпущенная в декабре 2024 года ModernBERT прошла обучение на 2 триллионах токенов и получила контекстное окно на 8192 токена. Более сильные предварительно обученные модели справляются с более широким кругом классификационных вопросов, заданных при запросе. Поэтому отдельную модель для каждой задачи теперь приходится обучать реже.
Открытые воспроизведения Jev наглядно показывают, как устроен этот подход. Их внутреннее устройство доступно публике. SemIf вообще не обучает модель: она напрямую считывает вероятности вариантов ответа из замороженной Qwen3.5-4B. Разработчики SemIf измерили, что обработка 21 вопроса занимает около одной секунды, тогда как генерация ответа в формате JSON — больше пяти секунд. Оба метода совпали в 18 из 21 выбора. Laya использует модель для принятия решений на базе ModernBERT-large с 421 миллионом параметров и отвечает примерно за 33–40 миллисекунд на вопрос на Nvidia T4. Другие проекты применяют адаптеры LoRA к Qwen3.5 или работают на DiffusionGemma. Реализации различаются, но принцип у них общий: использовать более сильные предварительно обученные модели для принятия решений без генерации текста.
Открытые проекты показывают и ограничения этого метода. Разработчики Laya сообщают, что базовые контрольные точки набирают на их бенчмарке решений с заданными типами ответов результат, близкий к случайному. После файн-тюнинга результаты значительно улучшаются. TypeSafe пока мало рассказала об устройстве Jev, кроме того, что в модели используются новая архитектура, параллельный механизм выбора и метод последующего обучения, который компания называет обучением с подкреплением для калиброванных решений (RLCD). Он настраивает модель так, чтобы её вероятности соответствовали тому, как часто она отвечает правильно. TypeSafe делает ставку на калиброванные решения как главную цель обучения.
Новые модели и прежние методы глубокого обучения
Jev — самый заметный пример более широкого подхода: разработчики берут предварительно обученные модели передового уровня и применяют к ним методы, распространённые ещё до появления ChatGPT.
Недорогой классификатор может решать, направить ли запрос небольшой локальной модели, специализированной модели или к передовому API. Исследования FrugalGPT и RouteLLM уже формализовали каскадную маршрутизацию языковых моделей. Интеграция Jev в Pydantic AI построена на том же разделении: Jev заполняет поля с заданными типами ответов, а запросы, которым нужен связный текст, передаются языковой модели.
Дистилляция и небольшие специализированные модели не исчезали из компаний с крупными командами машинного обучения. В подкасте VentureBeat Beyond the Pilot рассказывали, как они применяют эти методы. Erran Berger, руководивший работой в должности вице-президента по разработке продуктов, а теперь работающий техническим директором LinkedIn, описал создание рекомендательных систем следующего поколения. Сначала команда дообучила модель-учитель с 7 миллиардами параметров на подробном документе с правилами работы продукта. Затем знания перенесли через промежуточную модель с 1,7 миллиарда параметров в модель-ученика с 0,6 миллиарда параметров, которая обрабатывает производственный трафик. По словам Бергера, добиться этого с помощью промтов было невозможно. Теперь команда повторно использует этот процесс в продуктах LinkedIn с ИИ.
Shopify развила ту же идею дальше. Внутренняя платформа компании позволяет командам исследований и разработок примерно за день дистиллировать передовую модель в открытую модель, дообученную для одной узкой задачи, и сразу встроить оценки качества. Фархан Тавар, вице-президент Shopify и руководитель инженерного направления, сообщил, что дистиллированные модели работают в 2–30 раз дешевле и быстрее, а в некоторых узких задачах превосходят передовую модель, на которой обучались.
Общий принцип — оставлять генерацию для задач, где действительно нужен текст: черновиков, резюме и написания кода. Более узкие решения, например маршрутизацию и присвоение меток, можно поручить менее дорогим моделям, если те соответствуют требованиям приложения к точности и надёжности.
Что проверить перед заменой языковых моделей
Начать стоит с аудита текущих запросов к языковым моделям: нужно разделить генерацию текста и задачи принятия решений — маршрутизацию, сортировку, присвоение меток, одобрение и выставление оценок. Разработчик Флавио Копес приводит пример расчёта: если компания тратит $10 000 в месяц на ИИ, из которых $6 000 уходят на принятие решений, то переход на решение, обходящееся в 5% от прежней стоимости, сэкономил бы $5700 в месяц. Реальная экономия зависит от того, какую часть расходов удастся перенести и сколько будет стоить замена.
У подхода есть ограничения. Jev пока доступна в раннем доступе, принимает только текст и работает с серверов на Западном побережье США. TypeSafe говорит, что устойчивость ценовой модели Jev ещё предстоит проверить. Компания также отмечает, что заявленные показатели — примерно в 194 раза быстрее и в 445 раз дешевле — получены на её собственных оценках рабочих процессов и, вероятно, близки к верхней границе возможных результатов в реальном использовании. В документации Pydantic также сказано, что текст во входных данных, направленный на то, чтобы повлиять на ответ Jev, может сработать. Поэтому защитные механизмы на базе Jev должны дополнять детерминированные проверки, а не заменять их. Открытые альтернативы снимают зависимость от поставщика, но командам придётся самостоятельно заниматься размещением моделей, файн-тюнингом, калибровкой и мониторингом.
Долгосрочные последствия касаются не только моделей. Инженерные навыки работы с классификаторами, каскадами и пайплайнами оценки, которые были востребованы до 2022 года, снова пригодятся. Команды, которые объединят этот опыт с современными предварительно обученными моделями, смогут создавать более дешёвую, быструю и понятную для проверки автоматизацию.
Читайте также
 Anthropic выпустила Claude Sonnet 5.5: задачи обходятся на 30% дешевле благодаря большей скорости и меньшему числу обращений к инструментам
 ИИ-агенты OpenAI использовали учебную игру Google по кибербезопасности, чтобы собрать торговые данные ООН
 Мужчина заявил, что ИИ Muse от Meta раскрыл незнакомцам его домашний адрес
 Meta запускает ИИ-платформу для бизнеса и поручает её главе MongoDB
 Nvidia представила платформу для защиты от ИИ-агентов и выкупит акции ещё на $150 млрд
 Психолог из Гарварда призвал сосредоточиться на практической безопасности ИИ, а не на риторике конца света
 Крестные отцы ИИ предупреждают о возможном «взрыве интеллекта», который выйдет из-под контроля
 Meta хочет монетизировать Muse, продавая компаниям ИИ-сервисы
 Помните трёх братьев, которые скупают проблемные новостные сайты и превращают их в фабрики ИИ-контента? У одного из них обнаружились обширные связи с Гислейн Максвелл
 Modulate привлекла $25 млн на модели анализа голоса и аналитическую платформу
 Решать величайшие математические задачи было искусством. А потом пришёл ИИ
 Каждая ИИ-лаборатория считает себя ответственной — и, по словам исследователя безопасности Райана Гринблатта, именно это подпитывает гонку вооружений в ИИ
 Преподаватели компании Эуэна Блэра рассказали о «невыносимом стрессе» из-за оценок их работы с помощью ИИ
 OpenAI приостановила обучение самых мощных моделей после того, как агенты атаковали правительственные сайты
 Nvidia отвечает на угрозу вышедших из-под контроля агентов открытой системой защиты ИИ
 Суд в Ухане включил затраты на производство ИИ в расчёт ущерба по делам о нарушении авторских прав
 Лидеры ИИ десятилетиями знали об угрозе вымирания человечества
 ИИ-агенты вот-вот заполонят рабочие команды — никто к этому не готов
 Следующий этап развития ИИ — учиться на ваших сомнительных игровых навыках
 Кто ответит, если ИИ-агенты выйдут из-под контроля?
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram