
По данным компании, раунд возглавил инвестор S32. В нём также участвовали Nvidia, Anthropic’s Anthology Fund, NATO Innovation Fund и Redalpine.
Basecamp Research основана в 2020 году. Привлечённые средства компания направит на развитие биологических моделей ИИ EDEN и продвижение собственных кандидатов в терапии к клиническим исследованиям. Сначала Basecamp сосредоточится на клеточной терапии. Такие методы генетически изменяют клетки пациента, чтобы, например, научить их атаковать раковые опухоли. Компания хочет проводить это изменение непосредственно внутри организма.
Для этого Basecamp изучает микроорганизмы из местообитаний, которые исследователи почти не успели изучить. Модели должны находить в их геномах закономерности, пригодные для медицины.
По словам технического директора Basecamp Research Филипа Лоренца, сложность биологии требует данных на несколько порядков больше, чем принято собирать сейчас. При этом огромный массив данных нужно сочетать с небольшими целевыми экспериментами.
До превращения этих разработок в лечение ещё предстоит большая работа. Пока компания располагает лабораторными результатами и данными экспериментов на мышах. Они не показывают, будут ли созданные методы безопасными и эффективными для людей.
Почему открытых геномных баз недостаточно
Недавно The Wall Street Journal писал, что фармацевтические компании вкладывают миллиарды долларов в ИИ, но убедительных свидетельств заметного роста успешности клинической разработки пока мало. Лоренц не считает это причиной отказываться от технологии. По его словам, масштабирование быстро принесло языковым моделям большой прирост качества, а биология тоже развивается, хотя открытые вопросы — например, ускорение клинических испытаний — здесь намного сложнее. Биология как задача гораздо сложнее и масштабнее языка.
Данные в этих областях устроены по-разному. Языковые модели учатся на огромных собраниях текстов, тогда как фармацевтика часто использует небольшие разрозненные наборы данных из отдельных исследований.
Лоренц приводит оценку Epoch AI, чтобы показать разрыв между двумя сферами. Верхняя граница общего числа существующих слов составляет примерно пять квадриллионов токенов. Basecamp оценивает количество нуклеотидов на Земле в 10 в степени 37. По словам Лоренца, если сложить стопку из 10 в степени 37 игральных карт, она смогла бы миллион раз окружить наблюдаемую Вселенную. Модели не требуется настолько большой набор данных, но существующих сегодня данных всё равно недостаточно.
Открытые геномные базы дают неполную картину природы. Согласно исследовательской работе Basecamp о базе BaseData, около 68% последовательностей в Sequence Read Archive приходится всего на пять видов. На людей приходится примерно 54%.
Для медицинских исследований такая концентрация объяснима. Но модели, которая должна учиться на как можно большем числе биологических процессов, она мешает: многие другие формы жизни почти не представлены в данных. В исследовании Microsoft, облачного партнёра Basecamp, Лоренц сравнил нынешнее положение с обучением языковой модели только на газетных статьях 1975 года: результат был бы очень плохим.
Поэтому Basecamp самостоятельно собирает образцы вместе с местными исследовательскими партнёрами. Компания получает их из почвы дождевых лесов, вулканических грунтов и глубоководных районов у берегов Антарктиды. Согласно последнему объявлению о финансировании, сеть охватывает более 30 стран и все семь континентов. Microsoft насчитала 208 участвующих организаций в 31 стране.
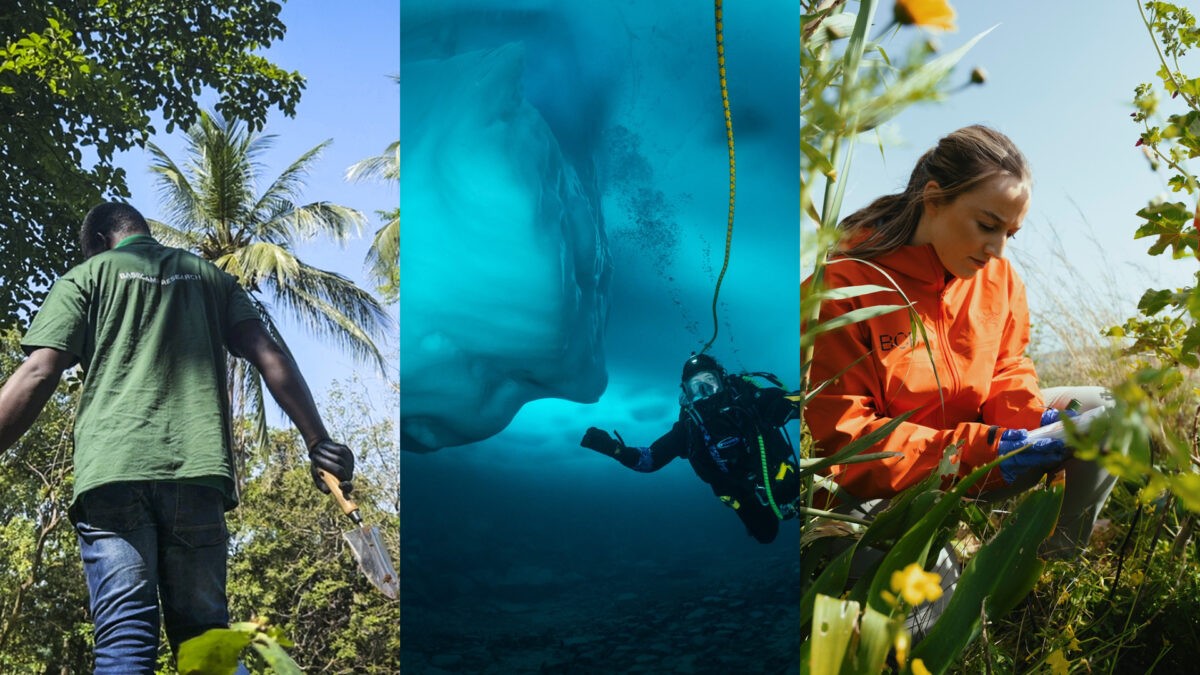
Basecamp Research работает с исследователями в десятках стран, чтобы собирать образцы непосредственно на местах
Источник: the-decoder.com
На момент интервью набор данных содержал около 15 трлн токенов, рассказал Лоренц. Это сопоставимо с объёмом текстовых наборов, на которых обучались модели вроде Claude и GPT. Но здесь токеном считается один строительный блок ДНК. ИИ обрабатывает не слова, как чат-бот, а последовательности символов, описывающие генетический материал.
По данным Microsoft, первое поколение EDEN обучалось на 9,7 трлн строительных блоков ДНК, полученных от более чем миллиона недавно секвенированных видов. Basecamp проводила обучение вместе с исследователями Microsoft в Azure, а вычислительные ресурсы, как сообщалось, соответствовали уровню GPT-4. При этом OpenAI никогда официально не раскрывала, сколько вычислений потребовалось для обучения GPT-4.
В течение следующих полутора лет набор данных должен вырасти примерно в 100 раз и превысить один квадриллион токенов. Основой для этого станет объявленный в марте Trillion Gene Atlas. Basecamp, Anthropic, Nvidia, PacBio и Ultima Genomics планируют собрать в нём генетические данные масштаба одного триллиона генов.
В последнем объявлении о финансировании Basecamp уже называет Trillion Gene Atlas основой обучения моделей EDEN. При этом компания не уточняет, насколько далеко продвинулось запланированное расширение.
Гонка бактерий как источник новых лекарств
Лоренц считает эволюцию, которая управляет всеми биологическими процессами, связующим звеном между образцами окружающей среды и медициной. Бактерия в горячем источнике приспосабливается к высокой температуре, а раковая клетка распространяется в организме — в обоих случаях действуют похожие силы отбора. Геномы людей, млекопитающих и почти всех позвоночных уже в основном секвенированы, тогда как остальное биоразнообразие изучено лишь частично. Многие лекарства тоже изначально были найдены в растениях, бактериях и грибах.
Конкуренция микроорганизмов даёт конкретный пример. Некоторые наиболее сильные терапевтические молекулы возникают в ходе биологической борьбы между организмами. Когда один вид бактерий пытается занять экосистему, он иногда создаёт вещества, которые подавляют или уничтожают конкурентов и помогают получить доступ к пище и месту обитания. Такое происходит миллиарды раз в бесчисленных точках планеты, особенно там, где мало питательных веществ. В медицине подобные вещества могут использоваться как антибиотики.
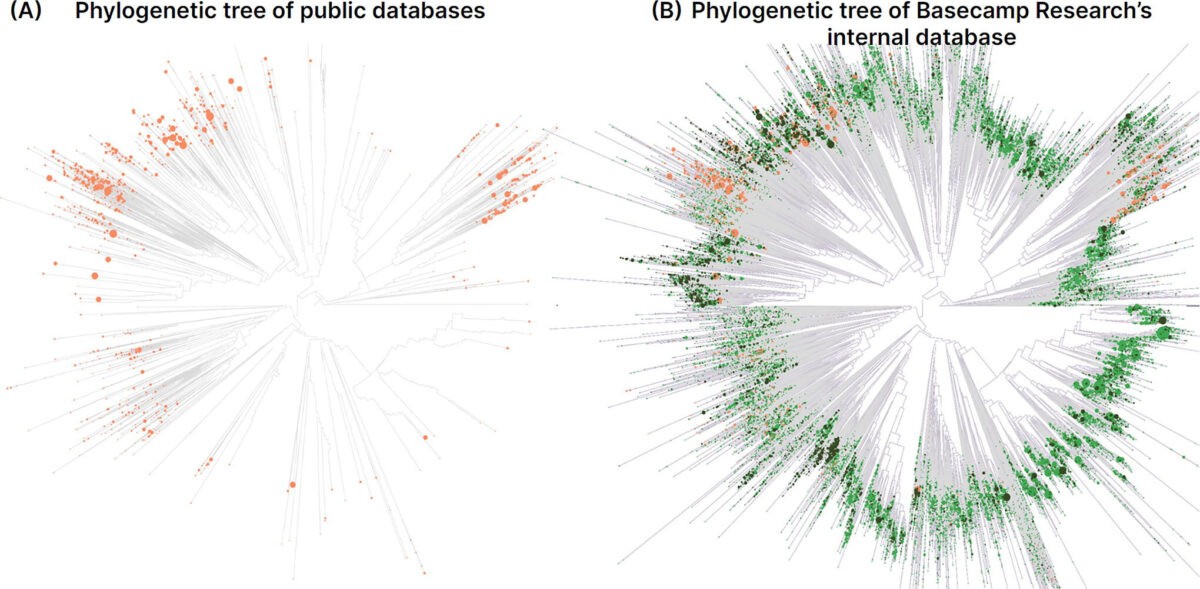
На этом рисунке из статьи 2024 года сравнивается разнообразие белков, представленное в общедоступных базах данных, с имевшимися на тот момент запасами Basecamp
Источник: the-decoder.com
В исследовании Microsoft Лоренц также упоминает фаги. Эти вирусы заражают бактерии и вводят в их клетки собственную ДНК. В результате такого взаимодействия появились инструменты, которые можно использовать для редактирования генов.
Basecamp хочет учиться на широком наборе решений, выработанных эволюцией. Модели должны не только заново находить известные соединения, но и проектировать новые кандидаты на основе усвоенных закономерностей.
Для этого компания фиксирует химические, физические и экологические условия каждого места вместе с генетическим материалом. Basecamp также отдаёт предпочтение длинным непрерывным участкам ДНК. Они показывают, какие гены находятся рядом и могут работать вместе. Короткие изолированные фрагменты часто лишены этого контекста.
Источник: the-decoder.com
Антибиотик от ИИ прошёл первое испытание на животных
Лоренц видит в созданных EDEN антибиотиках раннее подтверждение медицинского потенциала модели. По его описанию, компания задаёт модели патоген, после чего она проектирует антибиотик, способный его уничтожить.
В ещё не прошедшей экспертную оценку научной работе о семействе моделей EDEN авторы исследовали небольшой отобранный набор антимикробных пептидов — коротких белковых цепочек, способных атаковать бактерии. Согласно работе, активность в лаборатории показали 97% проверенных кандидатов.
Этот показатель относится только к отобранной для тестирования группе и не распространяется на все соединения, которые способна создать модель. Однако Basecamp проводила не только эксперименты в пробирке.
В июньском объявлении компания рассказала об испытаниях кандидата EDEN-7. На мышах, заражённых бактериями, устойчивыми к нескольким препаратам, он, как сообщается, сработал примерно так же, как антибиотик последнего резерва — лекарство, которое применяют при инфекциях, плохо поддающихся лечению.
По данным Basecamp, модель создала этот кандидат напрямую, без предварительных циклов доработки. Исследование проводилось вместе с учёными Пенсильванского университета под руководством Сезара де ла Фуэнте.
Лоренц придаёт особое значение переходу от проектирования к эксперименту. По его словам, Basecamp занимается не только сбором данных и обучением моделей: решающим становится вопрос, работают ли созданные молекулы в действительности.
Кроме антибиотиков и описанных ниже инструментов для вставки генов, Basecamp поручила EDEN создать синтетический микробиом кишечника примерно из 9000 видов бактерий, сообщает Microsoft. Для проверки результатов команда привлекла исследовательницу микробиома из Калифорнийского университета в Беркли Джилл Бэнфилд. Она задала строгие критерии оценки и стала соавтором связанной с проектом научной работы. Лоренц отметил, что результаты полезно проверять с помощью скептически настроенного человека, а не только ИИ.
Ставка на вставку генов внутри организма
В собственных терапевтических проектах Basecamp пока использует EDEN иначе. Модель должна проектировать биологические инструменты, которые вставляют крупные участки ДНК в выбранные места генома человека.
К таким инструментам относятся крупные сериновые рекомбиназы — ферменты, способные соединять участки ДНК. Basecamp хочет научить их вставлять полезную генетическую информацию в клетки с высокой точностью.
Подход направлен на одну из главных проблем генной терапии. Многие наследственные заболевания связаны с разными мутациями у разных пациентов. Вместо исправления каждой мутации ферменты могли бы вставлять здоровую копию гена независимо от конкретного дефекта. Такие инструменты происходят из той же борьбы фагов и бактерий, но перед работой в геноме человека их нужно перепрограммировать.
В работе об EDEN авторы сообщают о нескольких работающих кандидатах в ферменты для каждого изученного участка, связанного с заболеванием. Половина созданных сериновых рекомбиназ проявила активность в клетках человека.
Одно из возможных применений — CAR-T-клетки. Это генетически изменённые иммунные клетки, предназначенные для распознавания и уничтожения раковых клеток. В январском объявлении Basecamp сообщила, что таким образом изменённые первичные Т-клетки человека — иммунные клетки, взятые непосредственно у доноров, — уничтожили в лаборатории более 90% опухолевых клеток.
Получив новое финансирование, компания хочет превратить этот подход в лечение, работающее непосредственно внутри организма. Это могло бы упростить сложное производство клеточной терапии, которое сейчас, по данным объявления о финансировании, может стоить сотни тысяч долларов на одного пациента.
Однако генетическое изменение, сработавшее в лаборатории, не объясняет, как безопасно доставить необходимые компоненты в нужные клетки организма. Сооснователь Arc Institute Патрик Хсу поднял этот вопрос в материале Financial Times от мая 2025 года. Среди нерешённых проблем он назвал доставку, возможные токсические эффекты и защитные реакции клеток.
В долгосрочной перспективе тот же принцип, на котором основано проектирование антибиотиков, должен применяться к заболеваниям в целом. Лоренц говорил Microsoft, что амбиция компании — сделать биологию программируемой: задать модели заболевание и получить молекулу для его лечения. При этом он признаёт, что до такой цели ещё далеко. Созданные молекулы активны и работают, но перед началом клинических испытаний им предстоит пройти ещё множество этапов.
Опубликованный Basecamp пайплайн терапии показывает, сколько времени может занять этот путь. По состоянию на сентябрь 2026 года ни одна из шести программ не прошла дальше оптимизации ведущего кандидата — этапа, на котором перспективные соединения дорабатывают. Затем идут доклинические исследования, необходимые перед заявкой на испытания с участием людей, а после них — клинические испытания.
Четыре программы находятся на этапе оптимизации ведущего кандидата:
Все программы клеточной и генной терапии используют крупные сериновые рекомбиназы. CAR-T-терапия солидных опухолей и пептиды для лечения диабета пока находятся на ранней стадии исследований.
Обзор не сообщает, какая программа первой перейдёт к испытаниям на людях и когда это произойдёт. Basecamp не сразу ответила THE DECODER на эти вопросы, а также на вопросы о доклинических результатах, их независимой проверке и сравнении с данными других систем ИИ. Позже компания сообщила, что ответит.
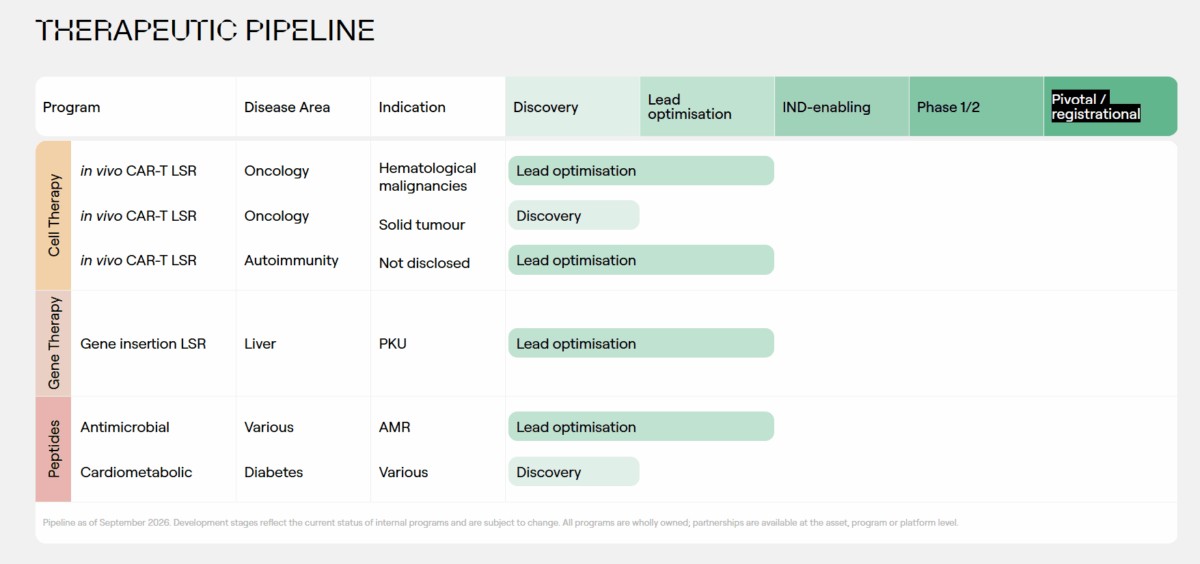
Опубликованный Basecamp план разработки терапевтических препаратов показывает, что ни одна из шести программ пока не вышла из стадии оптимизации ведущего соединения
Источник: the-decoder.com
Зачем треть графических процессоров отдана обучению с подкреплением
Для Лоренца данные природы — основа, а не замена медицинским экспериментам. В своей лаборатории в Бостоне Basecamp, среди прочего, проводит эксперименты с Т-клетками — разновидностью иммунных клеток человека.
Такие эксперименты не дают миллиарды токенов. Обычно они производят от нескольких сотен до нескольких тысяч точек данных, зато отвечают на узкие вопросы: например, работает ли конкретное генетическое изменение в определённом типе клеток.
Basecamp хочет использовать эти результаты, чтобы направлять уже широко обученную модель на конкретные задачи. Для этого применяются дополнительные циклы обучения на отобранных примерах и обучение с подкреплением, при котором модель корректируется на основе оценок своих результатов.
По словам Лоренца, сейчас треть графических процессоров Basecamp зарезервирована под эксперименты с обучением с подкреплением.
Он не сообщил, какой измеримый прирост дали эти эксперименты. Но распределение вычислительных ресурсов показывает, что компания делает ставку не только на постоянное увеличение объёма данных для предварительного обучения. Обучение с подкреплением обеспечило значительную часть недавнего роста качества языковых моделей вроде GPT-6.
Basecamp также хочет расширить сами данные. По словам Лоренца, первое семейство EDEN было моделью только для ДНК. ДНК кодирует белки, а белки сворачиваются в структуры. Поэтому модель ДНК уже улавливает многие сигналы, для которых в противном случае пришлось бы создавать отдельные модели белков или структур.
Следующее поколение должно работать с более сложными клиническими задачами, включая упомянутую ранее оценку безопасности и токсичности, а также обрабатывать другие типы данных помимо последовательностей ДНК. Какие именно данные добавят, Лоренц не уточнил.
Источник: the-decoder.com
Высокие оценки на бенчмарке не гарантируют хороших молекул
Лоренц говорит, что чем больше данных собирает Basecamp, тем сильнее убеждается в необходимости собирать ещё больше. Пока набор данных компании примерно в десять раз увеличивался каждый год. Каждое новое обучение, по его словам, приносит рост показателей, но команда ещё не увидела выхода на плато.
Качество данных тоже имеет значение. Basecamp уделяет много внимания обработке образцов — от выделения материала до секвенирования и сборки последовательностей. В течение последних шести месяцев компания обучала одинаковые архитектуры моделей в одинаковых условиях, меняя только собственные данные на открытые. На данных Basecamp кривая масштабирования росла быстрее. Для небольших моделей разрыв был небольшим, но по мере увеличения моделей он расширялся.
Для измерения Лоренц использует перплексию — показатель того, насколько хорошо модель предсказывает следующие символы в последовательности. Чем она ниже, тем лучше результат. По его словам, чтобы достичь перплексии 2, данные Basecamp экономят от нескольких сотен тысяч до миллионов часов работы графических процессоров. Для перплексии 1,5 экстраполяция указывает на разницу в миллиарды часов работы GPU. Это прогноз, а не измеренный результат.
Основные принципы законов масштабирования, известных по языковым моделям, работают и в биологии, считает Лоренц. Однако конкретные соотношения зависят от типа модели — например, модели ДНК и модели белков масштабируются по-разному.
При этом одних технических показателей недостаточно. Basecamp сравнила несколько архитектур моделей, включая StripedHyena — архитектуру, лежащую в основе модели Evo Arc Institute, — и Llama. StripedHyena иногда достигала более низкой перплексии, но Llama лучше справлялась с последующими биологическими задачами.
Именно поэтому Basecamp выбрала Llama, объясняет Лоренц. Компания также регулярно проверяет контрольные точки обучения, чтобы оценить, насколько хорошо модели решают биологические задачи. В качестве способности, которая особенно заметно появляется по мере роста модели, он приводит предсказание возможной иммунной реакции на молекулу. У самой маленькой версии EDEN эта способность выражена слабее. Конкретных чисел Лоренц не назвал.
Лоренц предлагает не делать преждевременных выводов о том, что ИИ умеет или не умеет, а проводить эксперименты и выяснять реальные возможности системы. По его словам, команда часто сама удивляется тому, какие свойства появляются при масштабировании.
Синтетические данные пока имеют для Basecamp низкий приоритет. Лоренц считает, что они добавляют новые точки главным образом в уже известных областях пространства последовательностей, но не открывают новые области. Компания прежде всего хочет охватить ранее неизвестное биоразнообразие. Во внутренних тестах модели, обученные на синтетических данных, иногда создавали работающие белки, но не демонстрировали настоящего обобщения на новые задачи.
Чат-боты становятся входом к биологическим моделям
Работа с биологическими моделями не должна оставаться занятием только для специалистов. Basecamp открыла отдельные функции EDEN для проектирования антибиотиков и поиска возможных мишеней для вакцин через Claude и Claude Science.
Исследователь может описать задачу обычным языком. Затем Claude обращается к EDEN и, например, предлагает кандидатов для дальнейшего изучения. В случае вакцин сначала нужно определить, какие участки патогена могут стать мишенями защитного иммунного ответа.
Лоренц говорит, что Basecamp не будет публиковать модели в открытом доступе. Компания ссылается на требования безопасности и соглашения с партнёрами, предоставляющими данные, связывая эти причины между собой. Многие партнёры предпочитают модель, коммерческое использование которой приносит им долю дохода, открытому исходному коду, за применением которого невозможно следить. Arc Institute, напротив, открыто выпустил модель Evo и исключил данные о патогенах из её обучения.
Basecamp также удаляет из обучающих материалов данные о некоторых вирусах и предпринимает другие меры. Созданные последовательности проверяются по базам известных патогенов. Эти действия должны снизить риск злоупотреблений, но сами по себе не доказывают, что опасные результаты полностью исключены.
Кому достанется доход от данных природы
Стратегия работы с данными зависит и от того, готовы ли страны и местные учреждения сотрудничать с Basecamp. По словам Лоренца, компания не начинает сбор образцов без предварительного информированного согласия землевладельцев, а также местных и национальных властей.
Лоренц утверждает, что для каждого токена, на котором предварительно обучалась EDEN, можно установить точное географическое место происхождения и конкретное согласие, полученное компанией.
Партнёры не должны ждать несколько лет — до возможного выхода лекарства на рынок, — чтобы получить пользу от сотрудничества. Basecamp нанимает местных учёных и инвестирует в оборудование для секвенирования и лаборатории, которые должны сформировать местную биоэкономику. В работе о BaseData также описаны лицензионные выплаты, распределяемые в соответствии с долей каждого партнёра в обучающих данных.
Согласно этой работе, к концу 2024 года Basecamp выплатила деньги 52 получателям в 19 странах. В самом быстром случае между сбором образца и первой выплатой прошло девять месяцев.
Лоренц, который ещё во время академической карьеры работал с открытыми базами данных, не считает такую модель заменой открытых данных. По его мнению, это параллельная система. Согласие и распределение выгоды помогают укреплять доверие и дают партнёрам причину расширять сбор данных до масштабов, необходимых моделям Basecamp.
Достаточна ли эта доля, остаётся предметом спора. Financial Times писала в 2025 году, что выплаты составляют 1% выручки. Исследователь Джим Томас сказал изданию, что ценит возможность отследить происхождение данных, но считает размер выплат недостаточным. По его мнению, данные повышают стоимость компании, тогда как сообщества, из которых они получены, не получают справедливую долю.
Аурели Дингом из министерства окружающей среды Камеруна также заявила, что более высокая доля была бы справедливой. Основатели Basecamp указали на договорные гарантии и заявили, что долгосрочные партнёрства отвечают коммерческим интересам компании.
Теперь у Basecamp есть ещё $140 млн для следующего этапа медицинской разработки. Проведённые эксперименты показывают, что EDEN способна создавать биологически активных кандидатов. Предстоящие исследования должны установить, превратятся ли они в безопасные и эффективные методы лечения, которые проще производить.
Источник: the-decoder.com
Читайте также
 Spotify даёт ключи от алгоритма рекомендаций: в США запустили Taste Profile
 ИИ-помощник Meta Muse вышел с серьёзной уязвимостью безопасности
 Alibaba выпустила Qwen Audio 3.1 и новые модели, снизив цены на ИИ-аудио максимум на 95%
 Инженер: ИИ сеет хаос — кодеры весь день жмут «Enter», не думая и не понимая код
 AT&T автоматизацией избавляется от рабочих мест — и старой телеком-империи
 Умные очки Meta уже сеют хаос в Индии
 OpenAI наняла сооснователя Patreon Сэма Яма во главе нового подразделения Creator Product
 «Мы уже сражаемся в битве вчерашнего дня»: премьер Греции откровенно об ИИ
 Бёрнэм: новое британское ведомство даст отпор «информационной войне» России и других стран
 Как ИИ вообще может «убить всех людей»? Пять самых вероятных сценариев
 Ник Клегг может заработать £30 млн на выходе стартапа дата-центров Nscale на биржу
 Snorkel AI утроила оценку до $3,5 млрд на фоне бума спроса на данные для обучения ИИ
 C2C заменяет текстовую передачу данных между ИИ-моделями
 Трамп: ИИ не нужно регулировать — с климатом отсутствие правил тоже работает
 Qualcomm представила два новых чипа для смартфонов с упором на ИИ
 Бывший авиадиспетчер в ужасе: новая ИИ-система будет галлюцинировать и вызовет катастрофу
 Meta признала: сходство Muse с OpenClaw не случайно
 OpenAI выпустила GPT-6 Sol и Luna, снизив стоимость API на 50% и более
 Трамп: после первой личной встречи отношения с Бёрнхэмом лучше, чем со Стармером
 GPT-6 Sol и Luna от OpenAI вдвое дешевле, но почти не прибавили в производительности
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram