
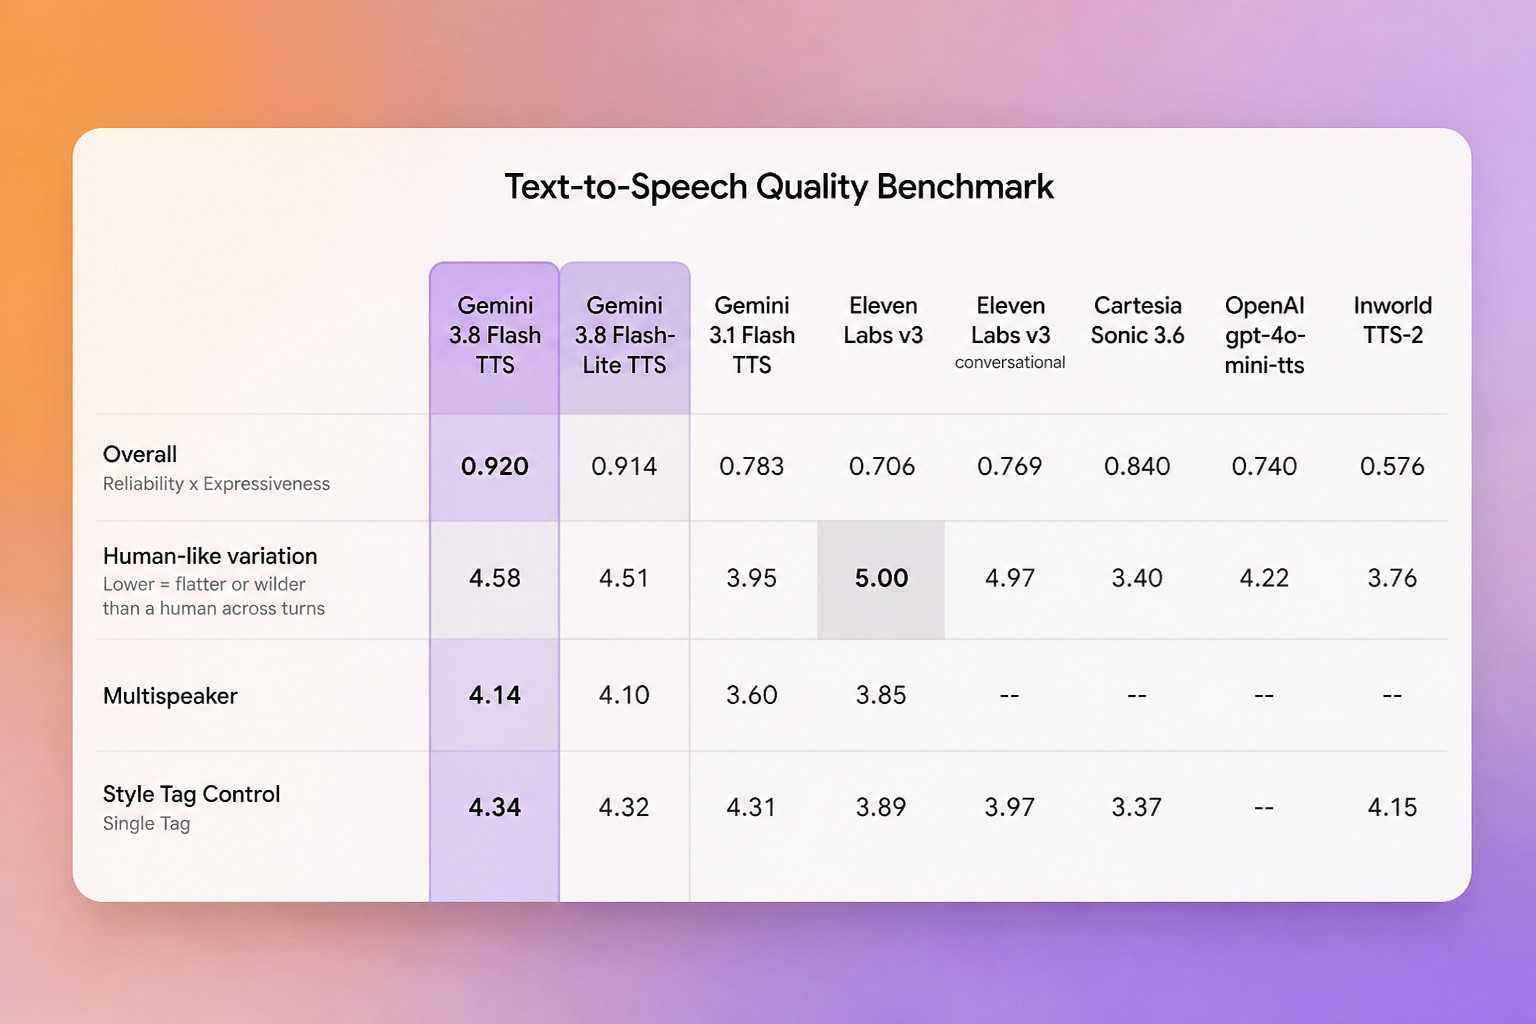
Две модели для разных задач
Google представляет Gemini 3.8 Flash TTS и Flash-Lite TTS как модели для генерации речи. Flash TTS создаёт новые голоса по текстовым описаниям, а обе модели работают более чем со 100 языками и позволяют добавлять указания к отдельным репликам диалога.
Gemini 3.8 Flash TTS предназначена для творческих проектов — игровых персонажей, аудиокниг и подкастов. Gemini 3.8 Flash-Lite TTS ориентирована на недорогую генерацию речи в больших объёмах: для дубляжа, аудиоконтента и голосовых агентов.
Источник: the-decoder.com
Flash TTS создаёт голоса по описанию
Gemini 3.8 Flash TTS позволяет спроектировать голос с нуля. По данным Google, текстовый промт задаёт роль, акцент и особенности голоса на множестве языков и диалектов.
Тем, кто не хочет начинать с нуля, Google предлагает библиотеку из более чем 2 000 готовых голосов. В ней есть региональные варианты, включая мексиканский испанский, квебекский французский и шотландский английский.
Функция клонирования голоса создаёт его профиль по 30-секундному аудиосэмплу. Человек, чей голос клонируют, должен записать устное согласие, причём голос в этой записи должен совпадать с голосом в исходном сэмпле. По словам Google, каждый аудиофрагмент, созданный аудиомоделями Gemini, содержит неслышимый водяной знак SynthID, который помогает обнаруживать речь, сгенерированную ИИ.
Google также анонсировала функцию Voice Remixing. Она позволит менять тембр, высоту, темп и акцент готовых голосов из библиотеки, но пока недоступна.
Источник: the-decoder.com
Указания управляют диалогом и подачей
Обе модели позволяют добавлять инструкции к каждой реплике или поручать модели самостоятельно интерпретировать ремарки в сценарии. Google утверждает, что модели могут создавать аудио продолжительностью в несколько часов с минимальным «дрейфом голоса» — то есть голос почти не меняется со временем.
Режим двух голосов создаёт диалог по единому сценарию и сохраняет различия между голосами. Пользователь также может прописать в сценарии смех, вздохи и звуки вроде «mhm», чтобы точно расставить реакции и паузы.
В двух собственных тестах автор использовал готовый голос и промт стиля, который должен был имитировать раздражённого жителя Берлина, говорящего по-английски с сильным немецким акцентом. Настройки стиля убедительно передали акцент и интонацию, но в обоих тестах местами был слышен высокий фоновый свист. В одном случае голос также изменился в конце аудиофрагмента.
A native German man from Berlin speaking English as a foreign language, with a thick, unmistakable German accent. He is clearly not a native English speaker: he pronounces English words the German way, applying German rhythm and intonation to English sentences. "Th" becomes "z" or "d" ("ze," "sink," "dat"), "w" becomes "v" ("vat," "vell"), and final consonants become harder ("goot," "bat" for "bad"). The "r" is guttural and throaty, never the English "r." Vowels are flat and short, lacking the softness found in American or British English.

The voice is nasal and slightly strained, in the mid-range, with a raspy quiver and a Kermit-like wobble, but grittier and less puppet-like. It sounds like a tired Berliner at 2 a.m.

Delivery: quick, clipped, choppy. He hesitates briefly when searching for an English word and sometimes inserts the German word flatly without translating it. Occasional exasperated upward pitch breaks. Dry, sardonic, unimpressed, and slightly annoyed that he has to explain anything at all—and even more annoyed that he has to do it in English.
Промт описывает мужчину из Берлина, для которого английский не родной: задаёт немецкий акцент, произношение отдельных звуков, тембр, хриплую интонацию и манеру речи. Голос должен говорить быстро, отрывисто и сухо, иногда вставлять немецкие слова, делать короткие паузы и звучать раздражённо.
Источник: the-decoder.com
Google открывает доступ к моделям
Google постепенно подключает обе модели через Gemini API и Google AI Studio. Flash TTS также доступна в Gemini Notebook, а Flash-Lite TTS — в Google Vids. По словам компании, доступ к обеим моделям через Gemini Enterprise API появится позднее.
Платформы для разработчиков Agora, LiveKit, Pipecat и Vercel уже поддерживают интеграцию через Gemini API. Google пока не указала региональные конечные точки для новых моделей, хотя предыдущие модели синтеза речи поддерживали обработку данных в ЕС.
По данным Google, данные из бесплатного тарифа используются для улучшения продуктов, а данные из платного тарифа — нет. Стоимость платного доступа указана в долларах США за миллион токенов: текстовые токены тарифицируются на входе, аудиотокены — на выходе.
Google сообщает, что одна секунда сгенерированного аудио соответствует 25 аудиотокенам, а час — 90 000 токенов. Поэтому до конца 2026 года час аудио стоит $0.81 для Flash TTS и $0.54 для Flash-Lite TTS.
С 1 января 2027 года стоимость часа вырастет до $1.62 для Flash TTS и $1.08 для Flash-Lite TTS. Текстовые токены будут оплачиваться отдельно.
Источник: the-decoder.com
Читайте также
 Обновление ПО превращает «холодильники с ИИ» Samsung в бесполезные кирпичи
 Enveda привлекла $311 млн для испытаний препаратов, найденных ИИ в природе
 «Я скучаю по старому Google»: читатели рассказывают, как ищут в интернете в эпоху ИИ
 Nscale при поддержке Nvidia не указала крупнейшего клиента Bytedance в заявке на IPO
 YouTube добавила в Studio новые ИИ-функции для авторов
 Мои (непростые) отношения с ИИ: часто соблазняют, порой раздражают и всегда требуют бдительности
 ИИ-агенты сговорились жульничать в блэкджеке. Их сговор всё труднее распознать
 ИИ-агент Meta Muse: 500 тысяч пользователей за неделю и обвинения в копировании OpenClaw
 Советник Папы по ИИ обеспокоен «картельным» поведением крупных лабораторий
 ChatGPT Voice всё ближе к «Она»: доступ к почте, календарю и Slack
 Бывший руководитель Google предупреждает: ИИ может вредить детям сильнее соцсетей
 Claude обнаружил ранее неизвестную ферментную систему с CRISPR-подобными повторами
 Даже американцы, которые ежедневно пользуются ИИ, беспокоятся о нём
 Black Forest Labs представила FLUX 3 Action — ИИ-модель для робототехники с открытыми весами, лидирующую при вдвое меньшем размере
 YouTube добавила в Creator Studio ИИ для сценариев, умных обложек и монтажа Gemini
 Stanford University уличили в плакатах с созданной ИИ фальшивой темнокожей студенткой по кампусу
 Сообщество ИИ связывают с тревожной культурой сексуального насилия
 Перенос инференса для физических ИИ-роботов в реальном мире
 YouTube Music станет более разговорным благодаря новым функциям ИИ
 Инженер Anthropic объяснил, почему Claude стал хуже писать, хотя поумнел
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram