
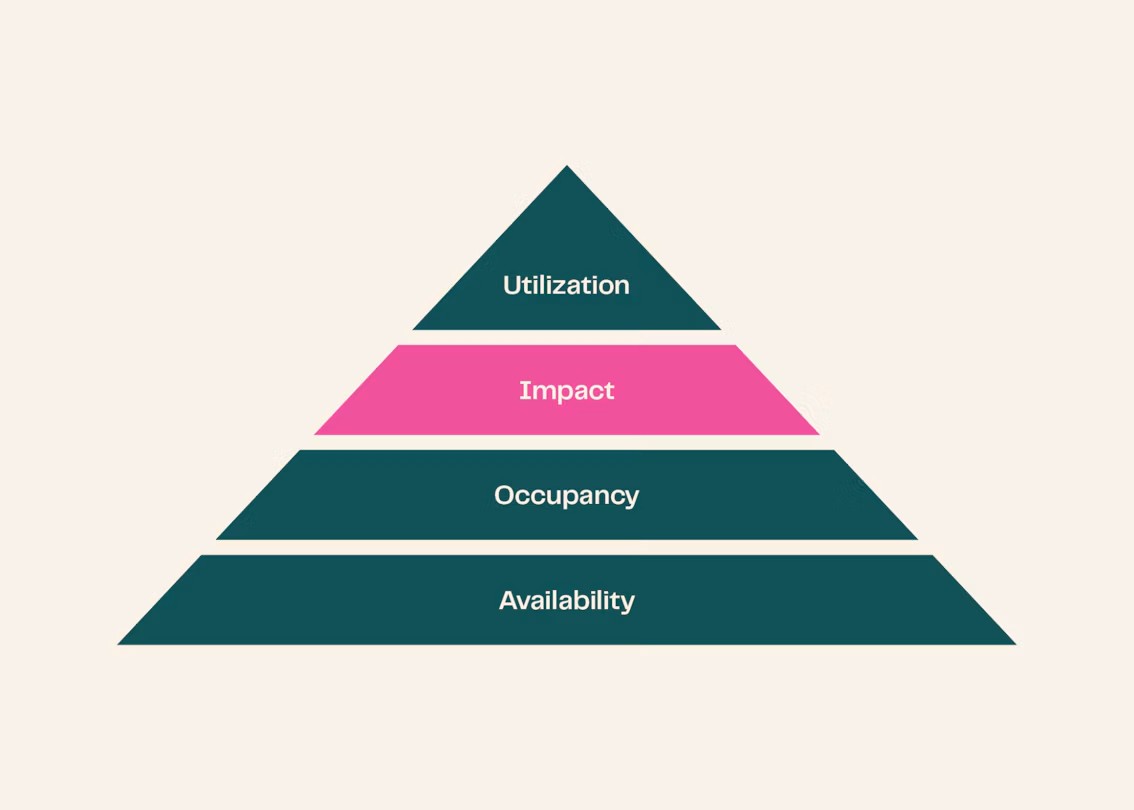
В команде ИИ-инфраструктуры Ai2 отвечают за вычислительные мощности института и крупные распределённые обучения. Эту работу здесь оценивают по четырём показателям, расположенным в виде пирамиды.
В основании — доступность: насколько часто оборудование исправно и готово к работе. Следующий показатель — занятость: какая доля доступного времени выделена конкретным задачам. Выше — влияние: насколько часто ресурсы получают наиболее ценные проекты. Вершина пирамиды — утилизация, то есть доля мощности GPU, которую задачи используют за всё время выполнения.
Источник: huggingface.co
В этой статье команда рассказывает, как улучшила распределение ресурсов. Вместо планировщика по приоритетам Ai2 внедрил бюджеты времени GPU, иерархическое распределение по принципу справедливой доли и соглашение о минимальном времени выполнения. Обсуждение того, сколько GPU-времени заслуживает каждый исследовательский проект, благодаря этому стало прозрачным процессом административного распределения бюджета, а не оперативным решением для каждого отдельного случая.
Избыток запросов
Ai2 управляет тысячами GPU NVIDIA H100, B200 и B300. Они объединены в кластеры размером от 88 до 1024 GPU и предназначены для крупномасштабного распределённого обучения ИИ-моделей. Ресурсами пользуются около 150 штатных исследователей, работающих в разных областях ИИ: от полного цикла обучения больших языковых моделей (LLM) и визуально-языковых моделей (VLM) до симуляций для робототехники с обучением с подкреплением (RL) и дообучения научных ИИ-агентов.
Как и во многих лабораториях, желающих получить GPU-время намного больше, чем доступных ресурсов. По отправленным задачам в любой момент спрос превышает мощности в 2–3 раза: за каждый свободный час работы GPU конкурируют две или три исследовательские задачи.
Раньше в Ai2 использовали планировщик по приоритетам, а команды могли отказаться от возможности прерывать свои задачи. Для защищённых от прерывания задач каждая команда получала лимит на число одновременно занятых GPU. Задачи, которые можно было прерывать, могли занимать свободные GPU сверх этого лимита.
У такой схемы проявились предсказуемые проблемы. Например, пользователи оставляли на GPU фиктивные задачи без полезной работы, чтобы подключиться к ним, когда понадобится ресурс. Исследователи шли на это, потому что не могли достаточно быстро запустить отладочную задачу и разобраться с проблемой в реальном времени. Возникала и инфляция приоритетов: в итоге всем задачам назначали высокий приоритет, и задачи с более низкими уровнями переставали получать GPU-время. Кроме того, поскольку возможность прерывания была необязательной, дежурные инженеры тратили большую часть времени на заявки, договариваясь об остановке защищённых задач на узлах, которым требовалось обслуживание.
«Трагедия общин»
Когда появились эти проблемы, команде понадобилось время, чтобы найти их причины. Первые попытки направить GPU-время на самые важные задачи сводились к более строгому контролю приоритетов, а затем — к обходу прежнего планировщика: важным проектам напрямую выделяли монополию на GPU.
Позже в Ai2 поняли, что создали условия для наблюдения «трагедии общин». Люди соперничали за ограниченный общий ресурс и, стараясь получить максимум для себя, ухудшали общий результат и неэффективно использовали оборудование.
Подобные ситуации изучают давно. Распределение ресурсов — область на стыке разработки алгоритмов, экономики и управления системами. Одна из основных трудностей в том, что пользователи часто лучше организации понимают ценность своих задач, но могут скрывать её или удерживать ресурсы, даже если это мешает общей производительности.
Например, в статье 2011 года о Dominant Resource Fairness исследователи Годси и его коллеги описали случай из поисковой компании. Там пользователям выделяли отдельные машины, только если те обещали обеспечить высокую загрузку. Вскоре выяснилось, что пользователи добавляли в код бесконечные циклы, искусственно повышая показатель загрузки. Оборудование меняется, но основные трудности распределения ресурсов остаются.
Источник: huggingface.co
Бюджеты вместо расписания
Классический способ справиться с «трагедией общин» — передать общий ресурс в частное владение: владелец заинтересован повышать ценность своей собственности. Выделяя командам монополию на группы GPU, в Ai2 уже использовали похожий подход, но слишком грубо. Из-за сезонности исследований часть GPU простаивала: команды запускают эксперименты в разное время, поэтому закреплённые за одной командой ресурсы могли быть свободны, пока другая команда ждала своей очереди.
Команда вручную пыталась решить задачу о рюкзаке — разместить меняющиеся исследовательские потребности в статичном расписании. Хотелось сохранить стимул бережно распоряжаться выделенным ресурсом и одновременно полностью загружать GPU.
В Ai2 решили изменить модель владения: вместо самих GPU командам стали выделять долю времени их работы. Точно прогнозировать будущий спрос невозможно, поскольку он зависит от результатов новых научных экспериментов. Зато приоритеты разных направлений исследований — стратегический вопрос, который проще обсудить и решить заранее. Руководители получили возможность распределять GPU-время по ожидаемому влиянию проектов, ещё до появления конкретных задач; планировщик использует эти решения, когда выбирает, какие задачи запускать.
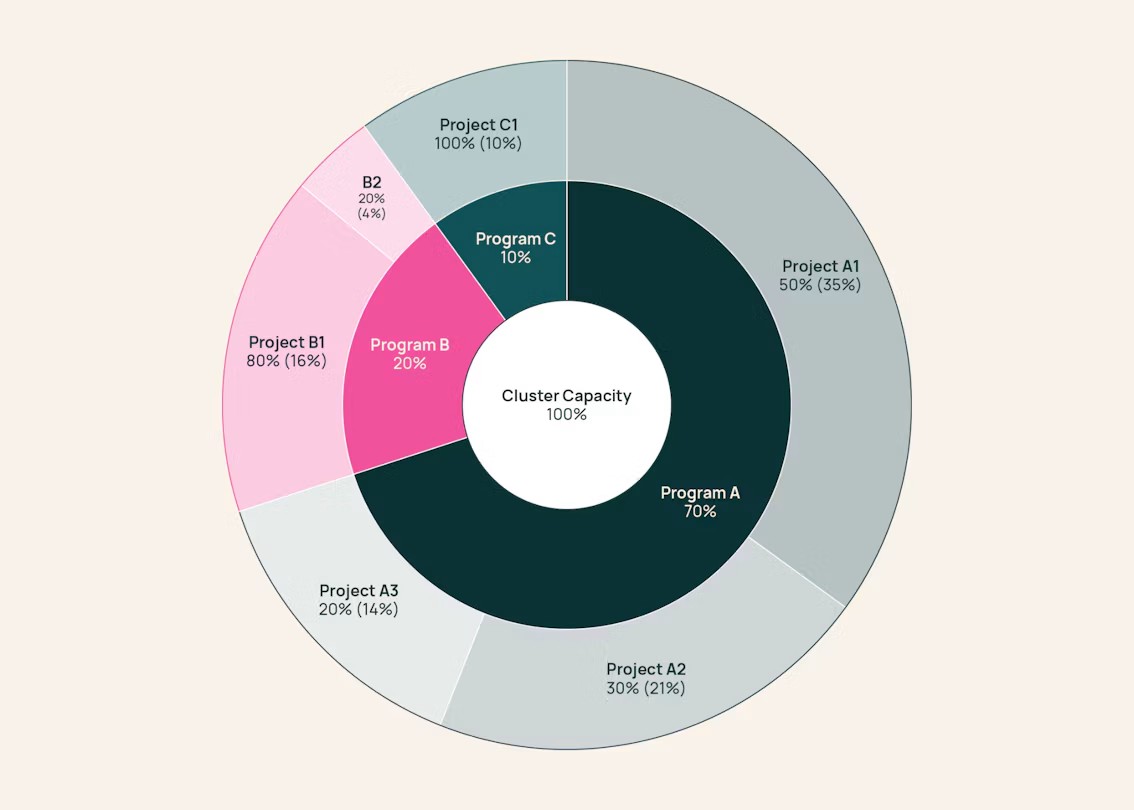
На этой основе команда создала иерархическую систему. Руководители могут пропорционально распределять GPU-время между проектами и исследователями, за которых отвечают. Так стратегия программы напрямую превращается в гарантированную долю ресурсов. Проект A1, например, имеет право на 35% общей мощности независимо от того, сколько других проектов ждут в очереди.
В скобках на схеме указана доля общей мощности кластера, выделенная каждому проекту на нижнем уровне иерархии.
В новой системе каждый запрос на GPU-время должен покрываться бюджетом. Иначе задача не защищена от прерывания. Раньше высокий приоритет ничего не стоил, а защита от прерывания позволяла команде бесконечно занимать весь доступный ей лимит одновременной работы GPU — поэтому этим пользовались все. Теперь бесплатного ресурса нет: любой способ удержать GPU-время расходует бюджет того, кто от этого получает пользу. Фиктивная задача тратит бюджет команды впустую.
В Ai2 рассчитывают, что попытки обойти планировщик станут дороже, чем честное обсуждение увеличения бюджета. Процесс пересматривают регулярно. При этом исследователям должны часто предоставлять возможность обосновать, сколько времени им нужно, а решения должны принимать руководители, лучше всего понимающие связанные с ними компромиссы. Внутри исследовательского проекта ресурсы распределяет ведущий исследователь, внутри программы — главный исследователь, между программами — руководитель программы или генеральный директор.
Справедливая доля
Вместе с бюджетированием GPU-времени Ai2 разработал иерархический планировщик справедливого распределения, который регулирует фактическую занятость ресурсов во всём дереве программ. Сам алгоритм новый не был: иерархическое распределение справедливой доли за временной период восходит к планировщику Hadoop Fair Scheduler, появившемуся в 2009 году. Сегодня похожий подход используют Fair Tree в SLURM и Fair Scheduler в YARN. Новыми для Ai2 стали входные данные: дерево повторяет структуру исследовательских программ, а веса задают руководители через бюджеты, а не через неизменные квоты.
Планировщик отслеживает занятость за скользящий период — по умолчанию за последние 7 дней — и ставит выше задачи из групп, использовавших меньше положенного, чем задачи групп, превысивших свою долю. Поэтому за неделю каждая группа может получить выделенное ей GPU-время, если она активно отправляет достаточно задач.
По словам Криса Кларка, новый планировщик создаёт ощущение, будто у команды появилось ещё 30% вычислительных ресурсов. Раньше свободная часть лимита пропадала, если команде не требовалось использовать его целиком в конкретный момент. Теперь команда может позже временно превысить свою долю и быстро запустить задачи без прерывания — фактически вернуть себе простаивавшее время. Поскольку нагрузка часто возникает рывками, это вернуло команде значительную часть вычислительных ресурсов.
Планировщик различает два вида занятости. При оплачиваемой занятости время задачи списывается с бюджета её владельца, влияет на расчёт справедливой доли и защищено от прерывания в течение минимального времени выполнения. Неоплачиваемая занятость не списывается ни с одного бюджета, не защищена с самого начала и может быть прервана любой задачей, выделенной из бюджета. Это помогает держать GPU загруженными, даже когда бюджеты не совпадают со спросом, и позволяет командам не отказываться от бесплатных вычислительных циклов.
Соглашение о запуске задач
Справедливо распределять ресурсы трудно ещё и потому, что распределённое обучение может длиться долго. Обучающие задачи регулярно работают часами, днями, а иногда неделями. После запуска задача могла занимать выделенные GPU неделю или дольше, не давая другим проектам получить оплаченное из их бюджета время. Именно эта особенность позволяла удерживать GPU фиктивными задачами и вынуждала дежурных инженеров договариваться с владельцами долгих задач из-за проблем с обслуживанием.
Чтобы решить эти проблемы, команда ввела «соглашение о запуске». В обмен на доступ к кластеру задача должна указать минимальное время выполнения — кратчайший срок, за который она может добиться значимого прогресса. В течение этого времени задачу нельзя прервать. Исследователь получает гарантию, что его работа продвинется, а планировщик после этого может перераспределить ресурсы и автоматически вернуть в очередь задачи, выполнение которых можно возобновить.
Источник: huggingface.co
Пользователь также может указать минимальное время, равное нулю: тогда GPU-время не выделяется из бюджета. Такие задачи можно прервать в любой момент, но их запуск ничего не стоит.
Рабочий цикл задачи устроен так:
Эти договорённости добавили в планировщик разделение времени. Задачи можно автоматически останавливать и возвращать в очередь: так выравнивается использование ресурсов и пропадает смысл удерживать GPU. На нездоровых узлах задачи можно выводить с GPU по достижении минимального срока, что позволяет полностью автоматизировать обслуживание. Это оказалось важнее, чем рассчитывали в Ai2: число ремонтов, для которых требовалось участие человека, сократилось на 74%, снизив нагрузку на дежурных инженеров.
Симуляции
В Ai2 понимали, что изменения в правилах планирования могут привести к неожиданным последствиям. Поскольку ресурсов на всех не хватает, выделить время одному исследователю означает отнять его у другого. Те, кто теряет в этом обмене, могут искать новые способы обойти правила. Перед внедрением бюджетной системы команда хотела быстро находить задачи, которым придётся ждать дольше, и проверять настройки — например, длину периода наблюдения и максимальное минимальное время выполнения. Максимум установили на уровне 8 часов.
Для этого в Ai2 создали небольшую симуляционную среду. На вход она получает задачи и расписание их отправки, а затем позволяет планировщику принимать решения о распределении GPU и прерывании задач. Зная, сколько GPU запрашивает каждая задача и как долго она должна работать, симулятор перескакивает между моментами, когда задачи можно запускать. Он анализирует ожидание в очереди, прерывания и распределение GPU-времени между проектами за много смоделированных дней — за несколько секунд. Команда проверила модель как на исторических данных, так и на специально придуманных сценариях.
Одна из гипотез касалась отладочных задач. Им нужно немного GPU и не больше 15 минут минимального времени, чтобы пользователь мог проверить, запускается ли задача или сразу завершается из-за ошибки либо неверной настройки. Команда хотела узнать, будут ли такие задачи ждать меньше, чем крупные обучающие задачи, которым для заметного прогресса часто нужны многие GPU и несколько часов. Небольшая задача интуитивно должна быстрее пройти очередь, потому что для неё подходит больше свободных мест. Но точное время ожидания имело значение: одна-две минуты позволили бы выстроить новый процесс разработки, а десять минут сделали бы его непрактичным.
В исторических данных оказалось недостаточно отладочных задач, поэтому для симуляции пришлось вручную подготовить тестовые наборы. Результаты подтвердили гипотезу: 90-й перцентиль ожидания для таких задач сократился примерно с 6 часов до 5 минут.
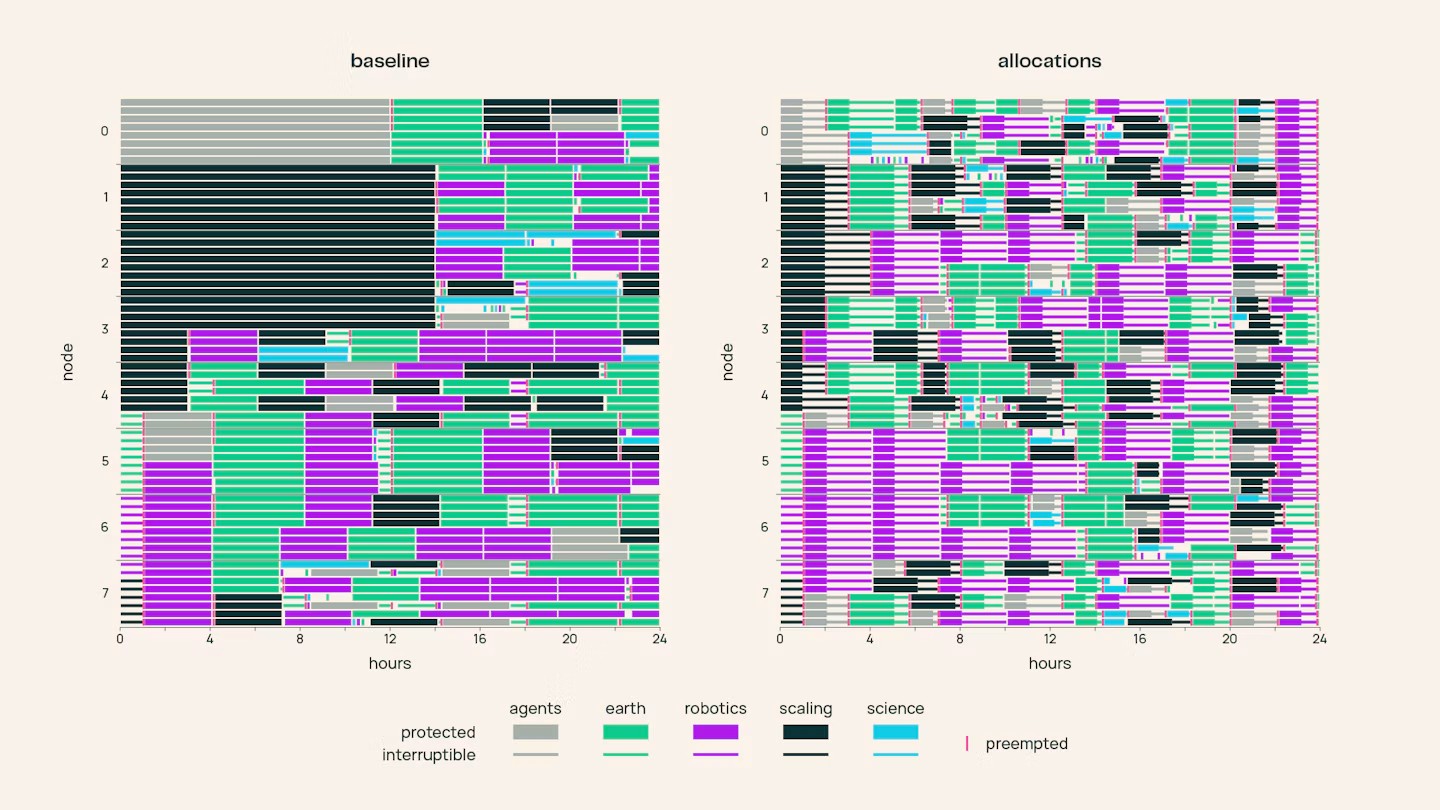
На иллюстрации показаны небольшие фрагменты симуляции: исходный планировщик слева, новый планировщик с распределением по бюджетам — справа. Каждая строка обозначает GPU, каждая полоса — задачу; цвет показывает команду, а штриховка — периоды, когда задачу можно прервать. Красный край отмечает прерывание. В исходном варианте долгие срочные задачи не прерываются, а низкоприоритетные задачи реже сталкиваются с прерываниями. В новой системе на каждом GPU больше цветов: ресурсы переходят от одной команды к другой.
Результаты
После симуляций Ai2 начал постепенно внедрять новую систему на разных кластерах в конце июля. Команду интересовало, получат ли выбранные для финансирования задачи положенное время, сохранится ли полная загрузка кластеров и смогут ли исследователи понимать работу планировщика и принимать решения с учётом его правил.
После внедрения команды стабильно получают выделенное им GPU-время. Время, причитающееся команде, считают с учётом её фактического спроса по часам. За 30-дневный период команды получили 98% положенных им GPU-часов. Из 15 команд 13 получили не менее 95%; худший результат составил 90%. Загрузка кластера до и после изменения оставалась на уровне 98%, а спрос в оба периода превышал доступную мощность в 2–3 раза. 18% выданного GPU-времени не списывали с бюджетов: так удавалось поддерживать высокую загрузку, когда профинансированные задачи были не готовы к запуску.
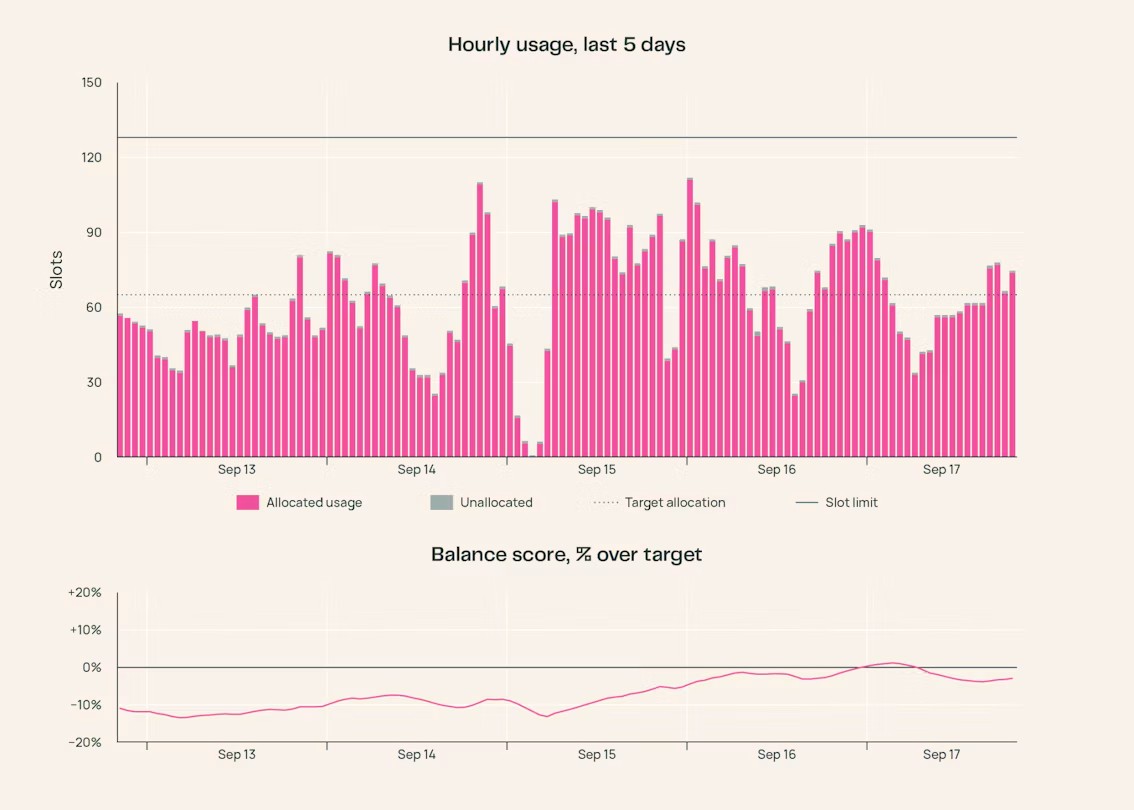
Источник: huggingface.co
Симуляции верно предсказали направление изменений, но реальные результаты оказались лучше. На новом планировщике 90-й перцентиль ожидания отладочных задач снизился с 2 часов до 30 секунд. В симуляции на вручную составленных сценариях ожидание сократилось с 6 часов до 5 минут. При этом в исходных данных отладочных задач было меньше, что повышало разброс результатов. В целом ожидание в очереди также уменьшилось благодаря разделению времени: на крупнейшем кластере H100 медианное время упало с 5 минут до 24 секунд, а 90-й перцентиль — примерно на треть, с 2,8 часа до 1,8 часа.
Результаты по трём исходным проблемам:
Трудности
Переход оказался сложнее, чем предполагали в Ai2. Изменения внедряли постепенно, поэтому на первых этапах поведение планировщика зависело от выбранного кластера. Кроме того, в интерфейсах остались старые термины — например, «приоритет задачи», — хотя их смысл изменился. Одной документации оказалось недостаточно. Лучше сработали живые разъяснительные встречи: исследователи задавали вопросы, а инженеры на реальных примерах подробно объясняли, как и почему планировщик расставляет приоритеты.
После этого группы стали чаще и шире обсуждать, сколько GPU нужно их экспериментам. Исследователи начали участвовать в распределении бюджетов, лучше понимая компромиссы, связанные с каждой новой заявкой.
Помимо очных встреч, после запуска системы команда добавила визуализации. Они помогают пользователям сравнить выделенное GPU-время с ожидаемым бюджетом и увидеть показатель, по которому задачи сортируются в очереди. Когда задачу прерывают, пользователю проще понять причину. Владельцы бюджетов тоже могут проследить, как GPU-время распределяется между проектами.
Одна из визуализаций показывает использование бюджета во времени.
Новая схема улучшила не все сценарии. Помимо распределённого обучения, исследователи запускают интерактивные сеансы: анализируют данные и проверяют обучающий код по мере написания. В прежней системе такой сеанс можно было удерживать до недели. С разделением времени защищённый срок ограничен 8 часами; после этого сеанс можно прервать, если он превышает выделенный бюджет.
В Ai2 недооценили, насколько исследователи зависят от временного состояния таких сеансов. После прерывания им приходилось ждать нового сеанса и вручную восстанавливать свою работу. Чтобы понять масштаб проблемы, команда опросила исследователей и добавила в план два проекта.
Первый — кластер только с центральными процессорами рядом с локальным хранилищем. На нём будут проходить сеансы разработки, связанные с подготовкой данных, а тренировочный кластер останется для задач, которым действительно нужны GPU. Второй проект — сеансы на CPU-кластере, которые можно восстанавливать. Тогда задачи можно будет прерывать после минимального срока для обслуживания или перераспределения времени, а затем переносить сеанс на другой узел без ручного восстановления исследователем.
Так Ai2 рассчитывает сохранить преимущества новой системы для эксплуатации и планирования, одновременно улучшив работу пользователей.
Команда продолжает следить за новыми проблемами. Одна из них — фрагментация ресурсов, из-за которой крупные задачи могут дольше ждать в очереди. В Ai2 предполагают, что минимальное защищённое время теперь получают задачи, которые раньше использовали возможность прерывания, чтобы превышать командный лимит одновременной работы GPU. Раньше такие задачи могли прервать в любой момент: это иногда приводило к потере времени, но одновременно упрощало запуск крупных задач. Теперь у планировщика может быть меньше возможностей разом прервать много задач и освободить ресурсы для крупной ожидающей задачи. Команда воспроизводит эту проблему в симуляторе и параллельно измеряет её в рабочей системе.
Дальнейшие планы
После изменений в планировании Ai2 хочет перейти к верхушке своей пирамиды — утилизации. Команде нужно повысить эффективность начальной настройки, создания контрольных точек и самих процессов обучения, чтобы каждое выделенное задаче время использовалось с максимальной отдачей.
Читайте также
 Оливия Мур из Andreessen Horowitz — о состоянии потребительского ИИ
 Потерянное поколение: как ИИ угрожает будущим великим режиссёрам Британии
 ИИ и климатический кризис несут экзистенциальные риски, но закон помогает их снизить
 Даже «Закон и порядок» боится искусственного интеллекта
 Мы слишком полагаемся на способность ИИ говорить «нет»
 Claude Science от Anthropic составила первую полную карту неба в ультрафиолетовом диапазоне
 Том Уотсон из Palantir: «власть толпы» не должна решать, кому достанутся госконтракты
 OpenAI раскрыла российскую и иранскую операции влияния, размещавшие фальшивые новости в настоящих СМИ
 Великобритания откроет восемь центров, чтобы ускорить внедрение робототехники
 Выручка OpenAI, по сообщениям, на $20 млрд ниже прежних прогнозов
 Популярная платформа Arena почти вдвое увеличила оценку за 10 месяцев — до $3,1 млрд
 Firmus отозвала крупнейшее с 1997 года размещение акций в Австралии на фоне сомнений инвесторов в компании, строящей дата-центры для ИИ
 Goodfire: новые «внутренние» мониторы ловят ИИ-агентов, вышедших из-под контроля, в разы дешевле
 Китайская Manus привлекла более $500 млн в первом раунде финансирования после разрыва с Meta
 Magnific запускает генератор изображений Magnific One: он избегает «вида ИИ» и сам соблюдает фирменный стиль компаний
 Некоторые математики призвали бойкотировать OpenAI после нашествия созданных ИИ доказательств в их области
 Не хотите проводить время с детьми? Обучите ИИ-модель своего голоса читать им сказки на ночь
 Уволенные исследователи по безопасности OpenAI отвергли обвинения в проступках и предупредили о сдерживающем эффекте
 Подросток доверил Claude маршрут по горам Канады — поход закончился эвакуацией спасателей
 Она создала новый логотип Meta для ИИ. А потом на неё обрушилась волна ненависти
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram