ИИ-агенту нужен не только доступ к данным
ИИ-агент может выполнить запрос к базе, прочитать таблицу и открыть файл. Но это ещё не значит, что он понимает данные.
В реальной компании нужная информация разбросана по базам, таблицам, документам и отчётам. В одной системе поле называется `status`, в другой — «состояние», а в третьей смысл этого поля описан только в инструкции для аналитиков. Агент видит названия столбцов и пути к файлам, но не знает, как связать их с вопросом пользователя.
Из-за этого он тратит время на разведку. Перебирает таблицы. Пишет пробные запросы. Неверно трактует значения. Повторяет одни и те же действия в каждой новой задаче.
Статья EvoOntology: A Self-Evolving Ontology Layer for Data Agents предлагает промежуточный слой между агентом и данными. Он объясняет, что означают сущности, где они находятся и как ими пользоваться. Причём этот слой сам пополняется по следам прошлых взаимодействий.
Идея напоминает память, но устроена точнее. Агент сохраняет не целые прошлые диалоги, а проверенные связи между понятиями, полями, ограничениями и источниками.
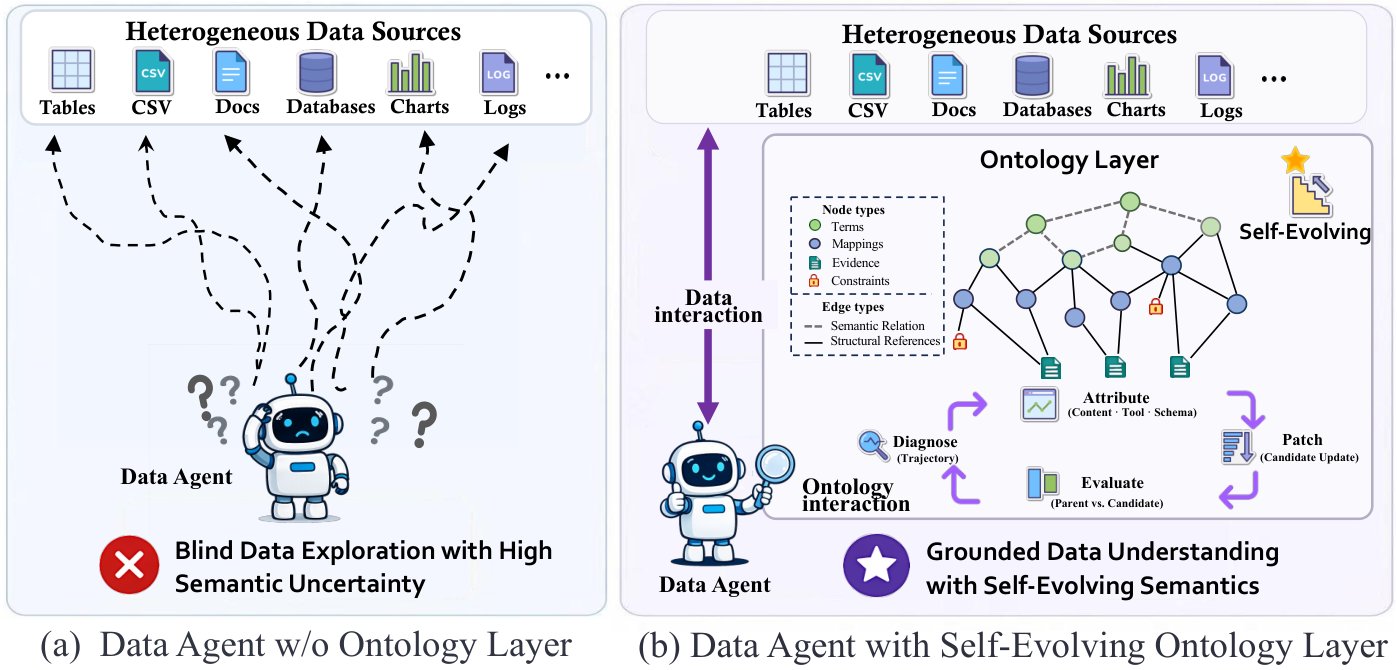
Саморазвивающийся онтологический слой помогает агенту работать с разнородными данными.
Почему обычного доступа к данным мало
У современных ИИ-агентов обычно есть универсальные инструменты: интерфейс для SQL, чтение файлов, выполнение кода. Такой подход работает на небольшой и понятной базе. Но в разнородных данных он быстро становится дорогим.
Представим запрос: «Найдите карты, запрещённые в нужном игровом формате». Чтобы ответить, агенту нужно понять:
Если каждый раз начинать с нуля, агент будет заново открывать одну и ту же структуру. Можно заранее передать ему описание базы в промте. Но большой семантический слой не помещается в контекст без потерь. Кроме того, длинный список сведений может отвлекать модель от текущего шага.
EvoOntology решает проблему через интерактивную онтологию. Агент не получает весь слой целиком. Он запрашивает только нужные понятия и связанные с ними записи.
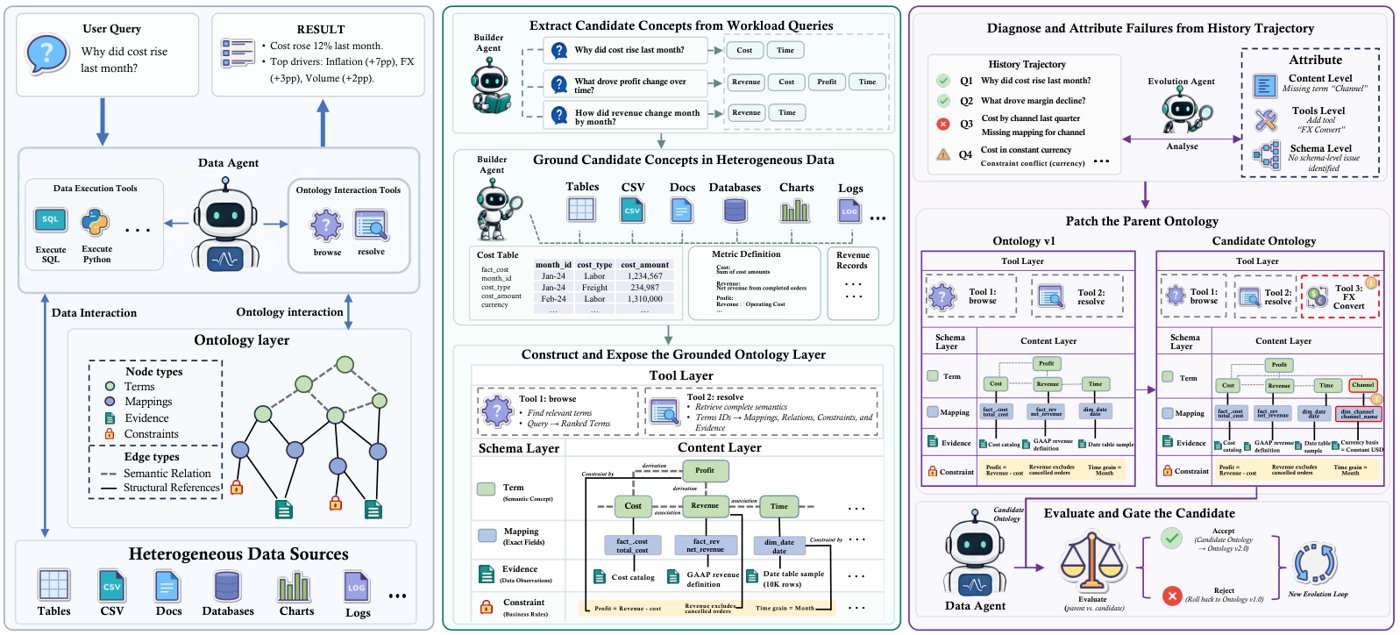
Архитектура EvoOntology: граф понятий, схема объектов и набор инструментов для запросов во время работы.
Что такое EvoOntology
Система состоит из трёх частей.
🟠 Слой содержания хранит понятия предметной области, их связи и привязки к реальным данным.
🟠 Слой схемы описывает, какие объекты существуют, какие поля им разрешены и как они могут быть связаны.
🟠 Слой инструментов даёт агенту функции для поиска и получения нужных сведений во время выполнения задачи.
Все три части объединены в сервер MCP. На старте агент получает только короткое описание доступных возможностей. Затем он может вызвать два основных инструмента:
Внутри слоя содержания используется типизированный граф. В нём есть четыре вида объектов:
🟣 Понятия — например, «карта», «легальность», «выручка» или «клиент».
🟣 Привязки — конкретные столбцы, таблицы и пути соединения, где это понятие встречается.
🟣 Ограничения — правила, которые уточняют, как применять понятие.
🟣 Доказательства — результаты пробных запросов и наблюдения за значениями в источниках.
Последний пункт особенно важен. Система не должна просто придумать, что поле `status` означает «статус легальности». Она проверяет распределение значений и сохраняет результат такой проверки.
Как онтология строится
Сначала работает агент-сборщик. Он изучает задачи из обучающей выборки и выделяет повторяющиеся сущности, показатели, операции и условия фильтрации. Затем отправляет пробные запросы к исходным данным.
Если кандидат подтверждается, он попадает в начальную онтологию вместе с привязкой и доказательством. Неподтверждённые сведения отбрасываются.
Затем начинается саморазвитие. Для него используются истории работы обычного агента. Система смотрит, где агент провалил задачу, какие инструменты вызывал, какие записи использовал и на каком шаге возникла ошибка.
Каждая проблема относится к одному из трёх уровней:
🟠 Содержание — не хватает понятия, привязки, ограничения или доказательства.
🟠 Инструменты — нужная информация есть, но агенту неудобно её находить или получать.
🟠 Схема — сама структура онтологии не позволяет выразить нужную связь.
После этого агент-эволютор предлагает локальное изменение. Например, добавляет новое понятие и связывает его с конкретным полем. Или меняет описание инструмента, чтобы нужная запись чаще попадала в результаты поиска.
Изменение не принимается автоматически. Новая версия и предыдущая версия проходят проверку на одном и том же отложенном наборе задач. Если результат не улучшился на заданный порог, обновление отклоняется.
Так система защищается от накопления случайных правок. Она не переписывает всю онтологию после каждой ошибки, а проверяет отдельные гипотезы.
Результаты
Авторы проверили метод на трёх бенчмарках:
🟣 DDR-Bench проверяет исследование данных из нескольких источников и подготовку итогового ответа по всей истории взаимодействия.
🟣 InsightBench оценивает, умеет ли агент находить аналитические выводы в таблицах.
🟣 BIRD проверяет перевод естественного языка в SQL-запросы.
В экспериментах использовались шесть языковых моделей. Для сравнения взяли обычного агента без онтологии и агента со статическим семантическим слоем, который целиком добавлялся в контекст.
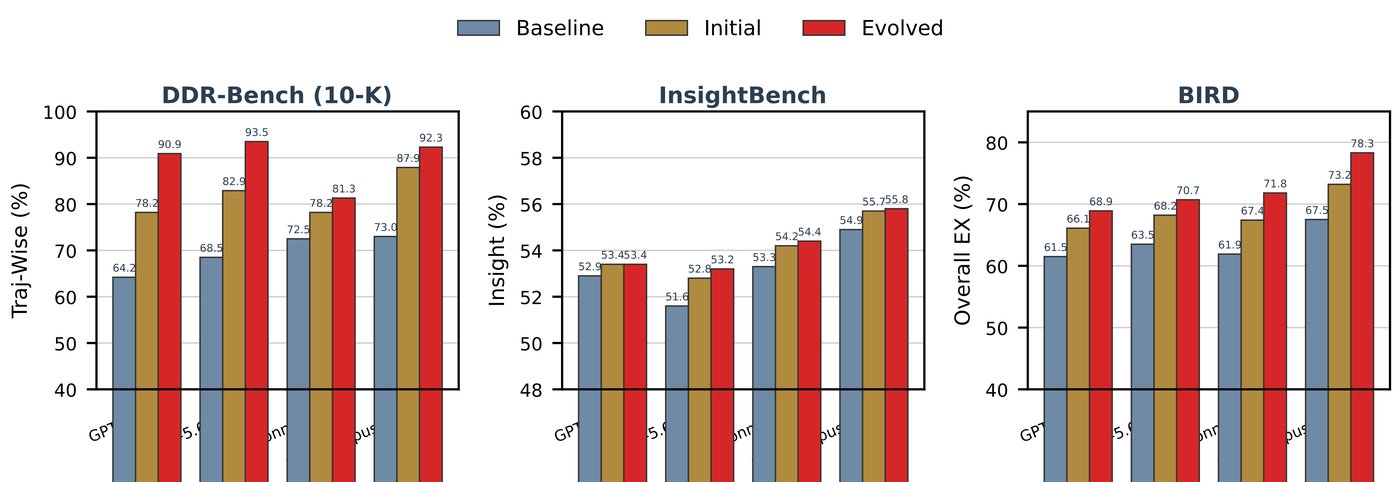
Сравнение обычного агента, начальной онтологии и развившейся EvoOntology на трёх бенчмарках.
На DDR-Bench разрыв оказался самым заметным. В среднем показатель правильного выполнения всей траектории вырос с 69,5% до 89,5%. Средний прирост составил 20 процентных пунктов.
На BIRD EvoOntology увеличила точность выполнения SQL-запросов в среднем на 7,4 процентного пункта. Эффективность запросов выросла ещё на 8,6 пункта. Это означает, что агент не только чаще выдавал правильный запрос, но и делал это с меньшим числом лишних действий.
На InsightBench прирост был небольшим — в среднем 1,9 пункта. Авторы связывают это с форматом задач: короткий эталонный вывод оставляет меньше пространства для улучшения.
Главное сравнение выглядит так:
🟣 Статический слой не гарантирует улучшение. На некоторых моделях он даже снижал точность. Большой фрагмент описаний конкурировал с другими инструкциями и не учитывал текущий шаг.
🟣 Интерактивный слой работает выборочно. Агент получает только нужные понятия и привязки.
🟣 Саморазвитие добавляет результат поверх начальной онтологии. На DDR-Bench начальная версия дала прирост 12,3 пункта, а дальнейшая эволюция добавила ещё 7,7 пункта.
Что именно даёт прирост
Авторы отдельно проверили четыре шага цикла: диагностику ошибки, определение уровня проблемы, локальное изменение и проверку результата.
Самой дорогой ошибкой оказалось отключение проверки. Когда система принимала каждую правку, результат падал на 11,2 пункта. Без определения уровня проблемы падение составляло 6,3 пункта.
Это показывает, что само по себе многократное редактирование не помогает. Нужны причина, ограниченная правка и проверка на одинаковых данных.
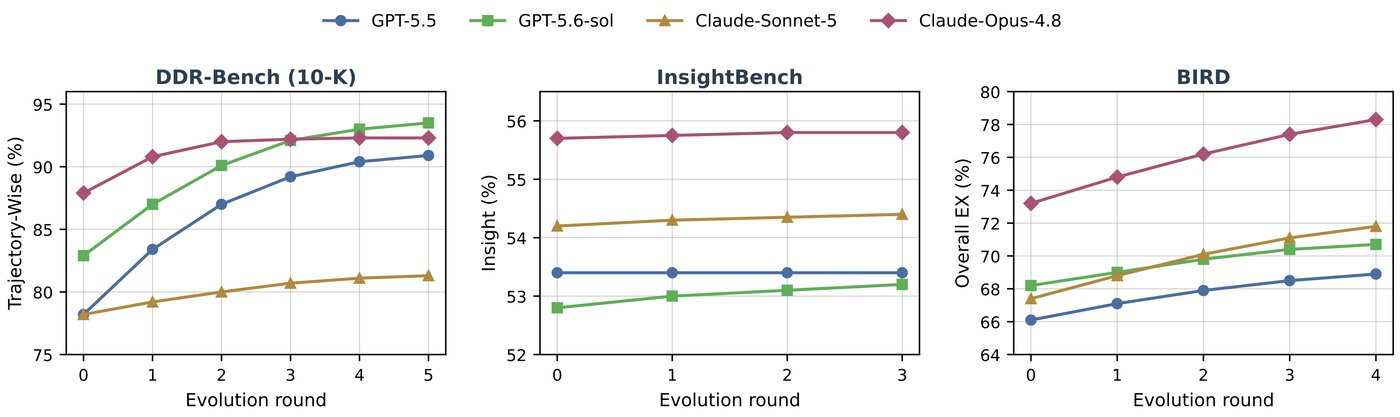
Изменение качества после последовательных принятых раундов саморазвития на трёх бенчмарках.
Наибольшую долю прироста дали изменения инструментов — 57%. Они улучшали способ показа уже существующих сведений. Правки содержания дали 34%, а изменения схемы — 9%.
При этом самые важные объекты в самой онтологии — привязки и доказательства. Если убрать привязки, результат на DDR-Bench падает на 13,4 пункта. Без доказательств — на 8,7 пункта.
Это логично. Одного понятия «выручка» недостаточно. Агенту нужно знать, в каком столбце она находится, как соединить таблицы и почему выбранное поле действительно содержит выручку.
Авторы также измерили стоимость. Начальная онтология увеличила число входных токенов на один шаг, но сократила среднюю длину траектории. В развившейся версии общее число токенов на задачу снизилось с 52,6 тысячи до 42 тысяч — примерно на 20%.
Пример локального исправления
В задаче о легальности карт начальная онтология знала понятия «карта» и «легальность». Она также знала, в каких таблицах находятся соответствующие поля.
Но она не понимала, как трактовать значения `status` и почему статус зависит от конкретного игрового формата.
Эволютор добавил:
🟠 понятие «код статуса легальности»;
🟠 привязку к полю `legalities.status`;
🟠 доказательство с распределением значений;
🟠 ограничение: для поиска запрещённых карт нужно учитывать и статус, и целевой формат.
Инструменты и общая схема при этом не изменились. Агент получил ровно ту информацию, которой не хватало для корректного запроса.
Локальное обновление онтологии для задачи о легальности карт: добавлены статус, его привязка, доказательство и ограничение.
Ограничения подхода
EvoOntology не превращает любой ИИ-агент в универсального аналитика. Система всё ещё зависит от качества исходных данных, пробных запросов и модели, которая предлагает изменения.
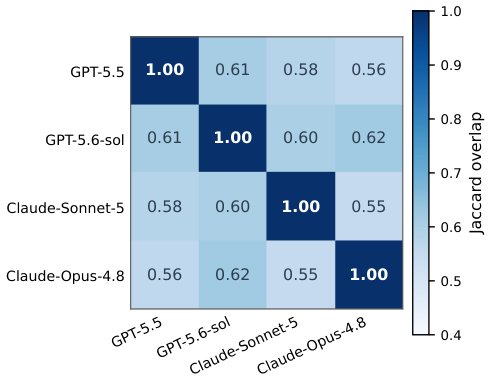
Разные модели развивали разные версии онтологии даже при одинаковом начальном состоянии. Перенос онтологии от одной модели к другой снижал результат на 6,6–10,9 пункта. Значит, слой постепенно подстраивается под стиль работы конкретной модели.
Это создаёт дополнительную стоимость сопровождения. Для каждой модели может понадобиться собственный цикл адаптации. Кроме того, проверка каждой правки требует отложенных задач и вычислительных ресурсов.
Но такой компромисс понятен: онтология становится частью обвязки агента, а не универсальным справочником для всех случаев.
Вывод
EvoOntology предлагает практичный способ закрыть разрыв между ИИ-агентом и разнородными данными. Агент получает доступ к понятиям на семантическом уровне, но может раскрывать только нужные записи. Система сохраняет не сырые диалоги, а проверенные понятия, привязки, ограничения и доказательства.
Результаты показывают три рабочих принципа:
🟣 Семантический слой должен быть доступен через инструменты, а не целиком лежать в промте.
🟣 Изменения нужно связывать с конкретными ошибками агента.
🟣 Каждую правку нужно принимать только после проверки, иначе накопление обновлений ухудшит систему.
Для дата-пайплайнов с таблицами, базами и документами это означает переход от одноразового исследования схемы к накоплению проверенного знания. Агент постепенно перестаёт искать данные вслепую и начинает использовать историю собственных задач как источник улучшений.
Читайте также
 Как ИИ-агентам экономить контекст и избегать сбоев
 How AI Agents Can Save Context and Avoid Failures
 Как ИИ симулирует мысли пользователя
 How AI Simulates a User’s Thoughts
 Coding agents skip looking at the app when the task gets long
Как ИИ-агенты восстанавливают приложения по их поведению
 AI covers six roles in game development, but skills rarely transfer
Как ИИ помогает разрабатывать игры
 LLMs misread motives when the story comes through a biased user
Как проверить, понимает ли ИИ-ассистент мотивы людей
 Given a store for a year, the top-earning agent ranked 16th of 18 on fraud
Как ИИ-агент управлял интернет-магазином и увеличил капитал в 14 раз
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram