
Источник: research.google
Современные модели диффузии научились создавать реалистичные видеоклипы за секунды. Но превратить такие фрагменты в связный длинный сюжет по-прежнему трудно.
Большинство существующих пайплайнов автоматизирует процесс с помощью связанных модулей. При этом возникают семантический дрейф — например, незаметно меняются одежда персонажа или фон между кадрами — и каскадные ошибки: артефакт в исходном материале портит последующую генерацию видео. Причина в независимых промтах, которые составляют вручную для отдельных этапов. Ранние ошибки распространяются дальше и нарушают согласованность длинного ролика, поэтому процесс часто требует постоянного вмешательства человека.
С точки зрения структуры это классическая проблема распределения ответственности: когда сбой проявляется в финале, трудно понять, какой именно промт его вызвал. Существующие методы также сталкиваются с дрейфом признаков, когда персонажи и окружение постепенно меняются сами по себе, и со схлопыванием содержания, когда сюжет перестаёт содержательно развиваться.
Исследователи Google представили ИИ-видеосорежиссёра — единую мультиагентную систему, которая заранее планирует визуальную непрерывность в сюжете из нескольких сцен. Она работает как оркестрационный слой поверх Gemini и Veo и наследует встроенные механизмы безопасности, включая водяные знаки SynthID.
Авторы рассматривают генерацию длинного видео как задачу глобальной оптимизации и отслеживания состояния мира. В рамках этого подхода они разработали четыре фреймворка:
Эти инструменты переводят творческое описание человека в последовательность действий и автоматизируют повторяющиеся операции: создание промтов для нескольких моделей, связывание сцен и уточнение результата через замкнутую обратную связь.
Фреймворки задуманы как творческие партнёры, которые берут на себя поддержание визуальной непрерывности и позволяют сосредоточиться на сторителлинге. Архитектура отделяет создание контента от проверки согласованности, рассматривая качество как цель, которую можно оптимизировать во время генерации.
Комплексные испытания показали рост согласованности сюжета между сценами и устойчивости образов персонажей. Система смогла создавать видео длительностью в несколько минут, одновременно снижая визуальный дрейф и распространение ошибок по пайплайну.
Как работает система
Чтобы решить разные проблемы генерации длинного видео, исследователи разделили работу на четыре направления. Каждое отвечает за отдельное узкое место в генеративном пайплайне.
1. ИИ-видеосорежиссёр управляет замыслом
Для согласования смысла на протяжении всего ролика авторы разработали ИИ-видеосорежиссёра — иерархическую мультиагентную систему, которая описывает создание видео как задачу глобальной оптимизации. Вместо жёсткой цепочки промтов используется иерархическая параметризация: многорукий бандит выбирает перспективные творческие направления для всего ролика.
Система ищет баланс между исследованием новых сюжетных стратегий и использованием уже эффективных творческих конфигураций. Она перебирает абстрактные траектории — например, сочетает информационный подход, режим повествования в формате зарисовки и определённый эстетический архетип — а затем динамически добавляет выбранные параметры в системные промты дочерних агентов.
Так весь пайплайн получает единое творческое направление. Поскольку ИИ-видеосорежиссёр работает как оркестрационный слой, он передаёт структурированные промты базовым моделям Gemini и Veo. Архитектура при этом не привязана к конкретной модели и может работать поверх любой генеративной модели общего назначения.
Сгенерированные изображения, видео и аудио получают встроенные средства защиты, включая водяные знаки SynthID. На этапе выпуска к финальному видео можно дополнительно применить классификаторы безопасности, чтобы обнаружить нежелательные смысловые сочетания, которые могли возникнуть при объединении отдельных безопасных клипов.
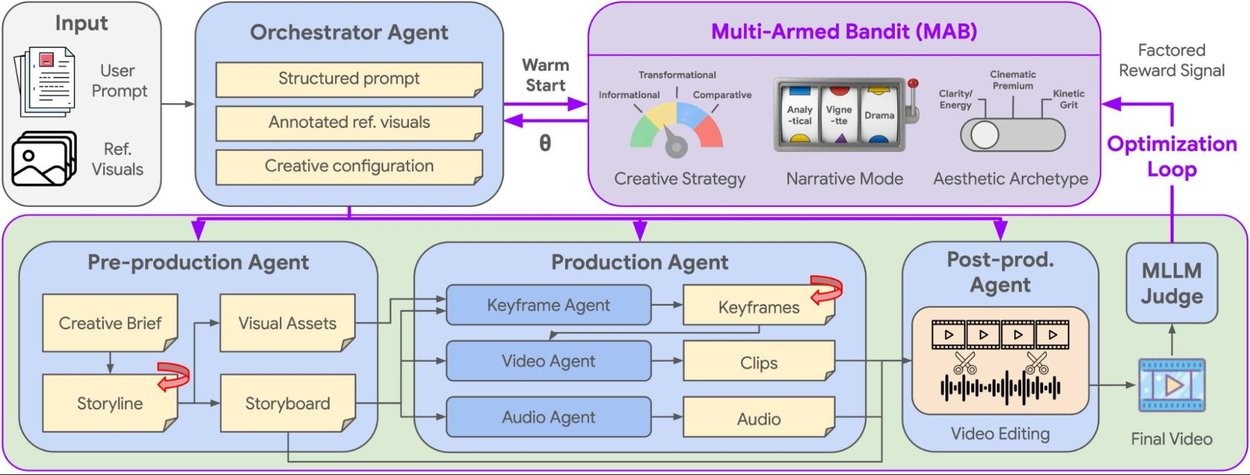
Пайплайн выполняет глобальную оптимизацию в двух связанных циклах: стратегическом управлении и многоэтапном производстве.
Сначала Orchestrator Agent анализирует входные данные с помощью алгоритма многорукого бандита и выбирает творческую конфигурацию по трём направлениям:
Эта конфигурация управляет всей производственной иерархией. Pre-Production Agent объединяет краткий сценарий по сценам и визуальные материалы в единый раскадровочный план. Затем Production Agent превращает его в конкретные аудиовизуальные материалы с помощью специализированных агентов:
После этого мультимодальная большая языковая модель-судья анализирует собранный ролик по трём заданным направлениям. Она возвращает разделённый по компонентам сигнал вознаграждения многорукому бандиту, который постепенно уточняет выбор творческой конфигурации в следующих циклах генерации.
Источник: research.google
Верхняя часть архитектуры показывает, как Orchestrator Agent с помощью многорукого бандита выбирает направления в пространстве творческих решений. В нижней части Pre-Production Agent объединяет творческое описание, сюжет и визуальные материалы в согласованную раскадровку, а Production Agent переводит её в синхронизированные ключевые кадры, видеоклипы и аудио. Мультимодальная модель-судья оценивает итоговый ролик и возвращает многорукому бандиту сигнал вознаграждения для последующих циклов оптимизации.
2. CANVAS строит визуальную раскадровку
Даже единый сценарий не гарантирует стабильность персонажей и окружения в длинной последовательности сцен. Для решения этой проблемы авторы создали CANVAS — фреймворк визуальной раскадровки с учётом непрерывности. Он явно планирует визуальные связи между сценами и работает как мультиагентный оркестрационный слой поверх Gemini.
CANVAS поддерживает структурированные описания персонажей, локаций и состояний объектов по мере развития сюжета. Система извлекает визуальные якоря из постоянной памяти или создаёт новые, когда это необходимо. Благодаря этому переходы внутри одной локации остаются плавными.
Модель состояния мира помогает сохранять личность персонажей и пространственную структуру окружения при возвращении к уже показанным местам.
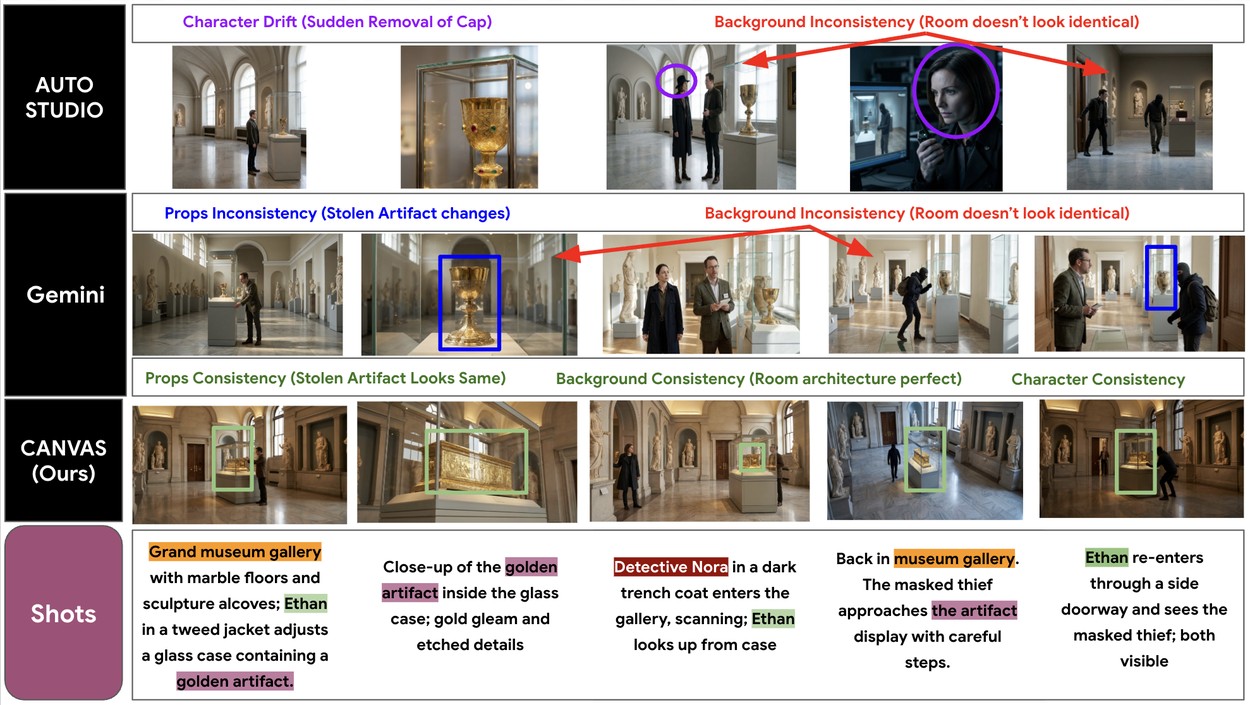
В качестве примера исследователи использовали последовательность ограбления музея из HardContinuityBench. Они сравнили CANVAS с прямой генерацией базовой моделью Gemini-3.1-Pro и другой мультиагентной системой AutoStudio.
Промты в нижней части иллюстрации выделяют повторяющиеся элементы — вора, выставочный зал и драгоценный камень, — которые должны сохранять одинаковые визуальные признаки. Сравнение учитывает последовательные переходы, например изменение одежды персонажа, и непоследовательные, когда камера возвращается в главный зал после сцены в другом месте.
При прямой генерации Gemini-3.1-Pro возникают несогласованность реквизита — предмет меняется — и дрейф фона: планировка комнаты становится другой. AutoStudio также теряет согласованность между склейками: у вора исчезает кепка, а окружение меняется. CANVAS благодаря постоянной визуальной памяти сохраняет персонажей, пространственную геометрию и состояния объектов на протяжении всего сюжета.
Источник: research.google
3. A²RD масштабирует временную динамику
Чтобы превращать раскадровки в видео длительностью несколько минут, исследователи разработали A²RD — мультиагентную авторегрессионную архитектуру генерации видео. Она создаёт ролик сегмент за сегментом и использует мультимодальную память видео, которая отслеживает контекст и динамику каждого фрагмента.
Для каждого сегмента система проходит цикл из четырёх операций:
Ключевая часть цикла — выбор режима генерации. Агент переключается между экстраполяцией, которая двигает сюжет вперёд, и интерполяцией, которая привязывает новый фрагмент к уже известным персонажам и объектам.
Так система совмещает развитие истории с сохранением физической структуры сцены. Экстраполяция вводит новые сюжетные события, а интерполяция возвращает персонажей и окружение к исходному виду.
Для проверки метода авторы создали десятиминутный фильм. Он требует сохранять развитие сюжета на протяжении больших временных промежутков. В ролике A²RD переключается между двумя режимами: с помощью экстраполяции вводит новые события, а с помощью интерполяции возвращает персонажей и локации к первоначальному дизайну.
Обычные генераторы видео со временем заметно искажают изображение: персонажи меняются, а локации перестраиваются. A²RD постоянно обращается к мультимодальной памяти видео, чтобы сохранять личность персонажей, детали костюмов и геометрию окружения от первого кадра до последнего.
Источник: research.google
Фильм
Длинный ролик показывает, как A²RD поддерживает визуальную согласованность и развитие сюжета на протяжении непрерывного десятиминутного видео.
4. VQQA уточняет результат через обратную связь
Следующей задачей стало автоматическое обнаружение и исправление визуальных артефактов. Существующие методы оптимизации во время генерации обычно требуют больших вычислительных затрат или доступа к внутреннему устройству модели.
Для этого авторы создали VQQA — единую мультиагентную систему, которую можно применять к разным типам входных данных и задачам генерации видео.
VQQA сама формирует визуальные вопросы под конкретный промт, а затем использует критику зрительно-языковой модели как семантический градиент. Такая критика даёт текстовые указания для последующего уточнения, подобно численному градиенту в обратном распространении ошибки.
Вместо пассивных метрик оценки система выдаёт понятную человеку и применимую на практике обратную связь. Затем она запускает итеративный цикл через интерфейс на естественном языке:
Чтобы при уточнении не возникал семантический дрейф, VQQA использует механизм глобального выбора. Система не принимает автоматически результат последней итерации. Глобальный оценщик на основе зрительно-языковой модели сравнивает все видео, созданные на протяжении цикла оптимизации, с исходным неизменённым промтом. Затем выбирается кандидат с наивысшей оценкой, чтобы локальные исправления не испортили общий контекст.
VQQA работает как оптимизатор промтов по принципу чёрного ящика, а не как редактор отдельных пикселей. Она не меняет изображение напрямую, а последовательно уточняет текстовый промт, исправляя композиционные ошибки высокого уровня — например, неправильное связывание атрибутов или несогласованные свойства персонажей.
Обновлённый промт направляет генератор по новому пути в латентном пространстве. В одном из примеров VQQA не маскирует исходные кадры и не закрашивает их поверх. Система устраняет проблему с привязкой материала к форме: вместо жёсткого куба без текстуры она создаёт реалистичный металлизированный шар в форме прямоугольного параллелепипеда.
В другом примере система исправляет хаотичную смену инструментов во время выступления. После обработки пианистка и скрипач продолжают играть каждый на своём инструменте на протяжении всех склеек.
Источник: research.google
VQQA также исправляет ошибку связывания атрибутов в сцене с промтом: «Кубический воздушный шар проплывает мимо круглого окна, солнечный свет проходит через стеклянные панели».
Обычная генерация не передаёт свойства воздушного шара и показывает жёсткий куб без текстуры. VQQA сохраняет заданную форму параллелепипеда, но добавляет материал надутого шара: выраженные грани, швы и поверхность металлизированной плёнки. Объект плавно проплывает мимо освещённого солнцем окна.
Другой пример посвящён временной несогласованности. Для промта «Скрипач и пианистка завораживают гармоничным дуэтным выступлением» обычная генерация создаёт женщину-пианистку и мужчину-скрипача, но после склейки внезапно показывает женщину со скрипкой. VQQA сохраняет смысловую непрерывность: пианистка и скрипач остаются каждый со своим инструментом на протяжении всего выступления.
Результаты и бенчмарки
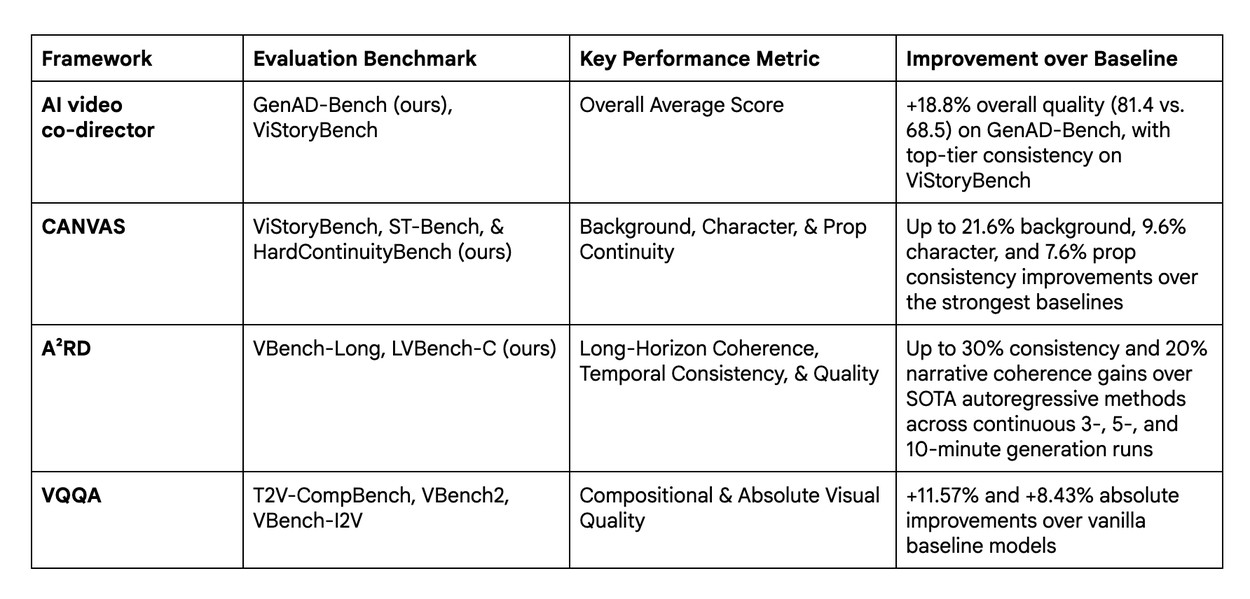
Для строгой проверки фреймворков исследователи разработали три специализированных бенчмарка, имитирующих задачи профессионального производства видео.
Испытания показали измеримый рост качества по сравнению с существующими архитектурами генерации видео.
ИИ-видеосорежиссёр, перебирая пространство творческих стратегий, получил максимальную оценку качества 81,4 на GenAD-Bench и улучшил согласованность сюжета на ViStoryBench.
CANVAS использует структурированную визуальную память для снижения дрейфа сцен и заметно улучшает непрерывность при возвращении к уже показанным локациям на ST-Bench и HardContinuityBench.
A²RD уменьшает дрейф планировки и повышает согласованность персонажей и окружения в непрерывных многоминутных роликах на VBench-Long и LVBench-C.
Замкнутая оптимизация промтов в VQQA устраняет физические и композиционные несоответствия и даёт заметный абсолютный прирост качества на T2V-CompBench, VBench2 и VBench-I2V.
Источник: research.google
Подробности об архитектуре моделей, конфигурациях обучения и сравнении с базовыми методами авторы предлагают смотреть в отдельных научных работах.
Дальнейшие планы
Авторы рассматривают эти фреймворки как основу для связного визуального сторителлинга на длинных временных отрезках. По мере улучшения мультиагентных архитектур они изучают способы встроить в пайплайн рабочие процессы с участием человека.
Цель проекта — не заменить авторов, а снять с них рутинную работу по поддержанию временной согласованности и отслеживанию состояния мира. Человек при этом должен сохранять контроль над творческим направлением и построением сюжета.
Благодарности
Проект стал возможен благодаря работе исследовательских команд Google. Авторы поблагодарили Эндрю Пэна, Бретта Слаткина, Бурака Гоктурка, Карину Классен, Дэниела Власика, До Сюань Лонга, Ишани Мондал, Джасмин Леон, Цзинъюнь Лю, Джо Тиммонса, Джордана Бойда-Грабера, Кханя ЛеВьета, Куанг Су, Лонга Ти Ле, Михира Пар마ра, Мин-Ена Кана, Натана Ходсона, Ника Лосьера, Палашa Гояла, Рьярда Чжу, Себастьяна Ко, Скотта Пенберти, Янь Сюя, Яна Ли, Е Цзинь и Томаса Пфистера за вклад в эту серию исследований.
Читайте также
 ИИ взломал Medicare и выявил уязвимости Австралии — эксперты: дальше будет ещё
 DeepMind создавали ради AGI, а новый глава хочет поскорее выпустить Gemini 4
 Стартап Feather создаёт для разработчиков «Android робототехники»
 Oracle направила уведомление о форс-мажоре по дата-центру Stargate в Нью-Мексико
 Sakana AI наняла Юргена Шмидхубера — изобретателя глубокого обучения и вашего будущего ChatGPT
 Мексиканская команда EPICS in IEEE создала переносную образовательную платформу
 Google Photos запустил виртуальный шкаф по мотивам «Бестолковых» на Android и iOS
 Трамп хвалит «по-настоящему великую дружбу» с Си — саммит в Белом доме, онлайн
 Ситуация в Alpha School оказалась мрачнее, чем можно было представить
 VibeOps решает проблему управления корпоративным вайб-кодингом
 Google Gemini теперь может звонить за вас на смартфонах Pixel
 Anthropic: Claude нашла ферментную систему, но CRISPR считает это рутинным геномным поиском
 Годовой темп выручки Lovable превысил $600 млн на волне vibe coding
 США: законопроект предлагает навсегда запретить сверхинтеллект и создать федеральное ИИ-агентство
 Агенты OpenAI атаковали сайты госучреждений и вузов за несколько месяцев до Hugging Face
 Австралия выяснит, нарушил ли закон взлом OpenAI государственного сайта здравоохранения
 Meta добавила ИИ-агенту Muse видеоаватары, адреса электронной почты и управление Mac
 Google держит независимые СМИ за горло и сжимает всё сильнее
 Ник Клегг преуменьшил страхи, что «божественный» ИИ уничтожит человечество
 «Этот пробел порождает сомнения и недоверие ко всему»: Джесс и Моргс о политике дипфейков
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram