
Главное в обновлении
float8_e4m3fn занимают вдвое меньше места, чем BF16. Для них работает масштабируемое умножение матриц и другие операции, поддерживаемые на CUDA и CPU.Что изменится на практике
Если вы запускаете модели на Mac с помощью transformers, diffusers или инструментов вроде ComfyUI, в версии 2.15 вас ждут такие изменения:
torch.compile скорость Qwen3.6-35B-A3B выросла с 9,4 до 61,3 токена в секунду, а LFM2.5-8B-A1B — с 23,6 до 123,6 токена в секунду. Плотные модели тоже ускорились благодаря более быстрым линейным слоям и softmax для выборки, который стал работать в 8 раз быстрее.F.scaled_mm выполняет их умножение непосредственно на GPU.Начало работы
Для PyTorch 2.15 нужен Mac на Apple silicon с macOS 15 или новее и Python 3.11 или новее. Подробности есть в таблице совместимости версии 2.15. Если система слишком старая или GPU Metal недоступен, проверка доступности MPS теперь сообщает причину.
Чтобы попробовать предварительную версию в отдельном окружении, выполните команду:
uv pip install torch==2.15.0 --index-url https://download.pytorch.org/whl/test/cpuКоманда устанавливает PyTorch 2.15.0 из тестового индекса пакетов PyTorch.
FP8 теперь работает на MPS
FP8 — ещё один способ экономить память на Mac. В PyTorch 2.15 на MPS появились тензоры torch.float8_e4m3fn: каждое значение занимает один байт, вдвое меньше, чем при хранении в FP16 или BF16.
Такие тензоры можно перемножать с помощью F.scaled_mm, который поддерживает масштабирование всего тензора и отдельных строк. Ниже — пример с одним коэффициентом масштабирования на тензор:
import
 torch

import
 torch.nn.functional
as
 F

def

quantize_fp8
(
x
):
    limit = torch.finfo(torch.float8_e4m3fn).
max

    scale = x.
abs
().amax().clamp_min(
1e-12
) / limit

return
 (x / scale).to(torch.float8_e4m3fn), scale

x = torch.randn(
1
,
1024
, device=
"mps"
, dtype=torch.float32)
weight = torch.randn(
1024
,
1024
, device=
"mps"
, dtype=torch.float32)
x_fp8, x_scale = quantize_fp8(x)
w_fp8, w_scale = quantize_fp8(weight)

y = F.scaled_mm(
    x_fp8,
    w_fp8.t(),
    scale_a=x_scale,
    scale_recipe_a=F.ScalingType.TensorWise,
    scale_b=w_scale,
    scale_recipe_b=F.ScalingType.TensorWise,
    output_dtype=torch.bfloat16,
)

print
(y.shape, y.dtype)
Код создаёт тензоры FP8 из входных данных и весов, перемножает их с помощью F.scaled_mm и выводит форму и тип результата.
Ускоренное декодирование языковых моделей
Обработка каждого запроса к языковой модели включает предварительный этап и декодирование. На этапе декодирования модель получает по одной строке данных на новый токен, поэтому большие умножения матриц превращаются в умножение матрицы на вектор. В PyTorch 2.15 ускорились оба типа слоёв, которые чаще всего выполняют эту работу: плотные линейные слои и слои со смесью экспертов.
Линейные слои
В MPS появились ядра GEMV для torch.mm ещё в версии 2.14, но F.linear продолжал работать через MPSGraph. В PyTorch 2.15 эти ядра подключили к F.linear: распространённые входные данные для декодирования формы [1, 1, hidden_size] теперь обрабатываются напрямую, а подходящие операции сложения смещения объединяются с ними.
Источник: huggingface.co
На 96 формах слоёв BF16 из реальных моделей средний геометрический прирост скорости составил 1,23 раза. Наибольший выигрыш заметен у небольших проекций, например у управляющих слоёв в моделях со смесью экспертов: прежний путь использовал лишь часть пропускной способности памяти. Крупные слои и выходные слои языковых моделей и раньше были близки к пределу пропускной способности, поэтому их скорость почти не изменилась.
Слои со смесью экспертов
Слой со смесью экспертов направляет к каждому эксперту разное число токенов. Групповое умножение матриц обрабатывает эти группы разного размера за одну операцию. В версии 2.15 для MPS появилась собственная реализация.
В версии 2.14 групповые смещения копировались на CPU, после чего группы обрабатывались циклом. Новые ядра Metal читают смещения непосредственно на GPU: где возможно, они используют Metal Performance Primitives, а в остальных случаях — отдельный путь Metal. Для небольших групп, типичных при декодировании, также предусмотрено собственное ядро.
Например, 64 токена можно разделить на группы из 16, 32 и 16 токенов:
import
 torch

import
 torch.nn.functional
as
 F

tokens = torch.randn(
64
,
64
, device=
"mps"
, dtype=torch.bfloat16)
weights = torch.randn(
3
,
128
,
64
, device=
"mps"
, dtype=torch.bfloat16)
ends = torch.tensor([
16
,
48
,
64
], device=
"mps"
, dtype=torch.int32)

out = F.grouped_mm(tokens, weights.transpose(-
2
, -
1
), offs=ends)

print
(out.shape)
# torch.Size([64, 128])
Код создаёт три группы токенов и выполняет для них групповое умножение матриц.
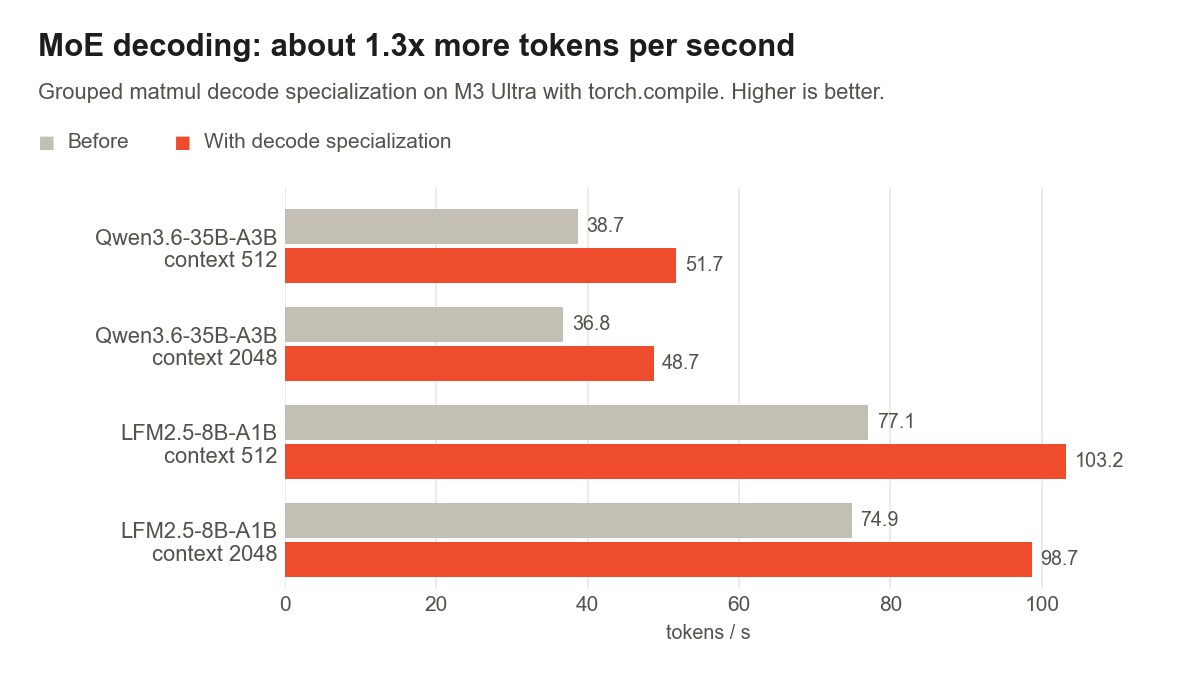
Ускорение ядра декодирования заметно и по пропускной способности. На M3 Ultra с torch.compile модели со смесью экспертов генерируют примерно в 1,3 раза больше токенов в секунду.
Ускорение линейной алгебры
Вычисления с комплексными числами
Работать с комплексными тензорами стало проще. На MPS теперь доступны LU-разложение для complex64, решение системы с помощью LU-разложения и решение треугольных систем. Благодаря этому работают и построенные на этих операциях вычисления с градиентами, например определители комплексных матриц.
Ниже показано, как решить небольшую систему прямо на GPU:
import
 torch

a = torch.randn(
8
,
8
, device=
"mps"
, dtype=torch.complex64)
a = a +
8
 * torch.eye(
8
, device=
"mps"
, dtype=torch.complex64)
b = torch.randn(
8
,
2
, device=
"mps"
, dtype=torch.complex64)

lu, pivots = torch.linalg.lu_factor(a)
x = torch.linalg.lu_solve(lu, pivots, b)

print
((a @ x - b).
abs
().
max
().item())
Код выполняет LU-разложение и решает систему, после чего выводит максимальную ошибку.
Небольшие матрицы и крупные системы
Для небольших матриц тоже появились быстрые ядра. При обработке геометрии камер и преобразовании изображений пакеты матриц FP32 размером до 4 × 4 обращаются одним ядром Metal, которое объединяет разложение и решение системы. Ускорились и более крупные вычисления: QR-разложение использует блочные обновления, а решение треугольных систем выполняет значительную часть работы через эффективное умножение матриц.
Для рабочих нагрузок Gated DeltaNet добавлен быстрый путь для треугольных систем FP32 размером 16 × 16, 32 × 32 и 64 × 64, если у них не менее восьми правых частей.
Сингулярное разложение стало надёжнее при крайних численных значениях. Теперь оно корректно обрабатывает очень малые сингулярные значения, очень большие и очень малые значения входных данных, а также дополнение базиса при full_matrices=True. Благодаря этому надёжнее работают псевдообращение матриц и метод наименьших квадратов.
Свёртки, дополнение тензоров и обучение
У аудиомоделей, видеодекодеров и циклов обучения есть собственные ресурсоёмкие операции. В этом выпуске для ряда таких операций появились новые пути на Metal.
Softmax и редукции
В PyTorch 2.15 ускорилась и выборка токенов. Операции softmax и log_softmax теперь используют отдельные ядра Metal. Наибольший выигрыш получают модели с большим словарём: для строки логитов FP32 формы [1, 128256] время softmax сократилось с 57 до 7 мкс — примерно в 8 раз по сравнению с MPSGraph. Ускорение сохраняется и для других распространённых размеров словаря.
Меньше памяти при декодировании видео
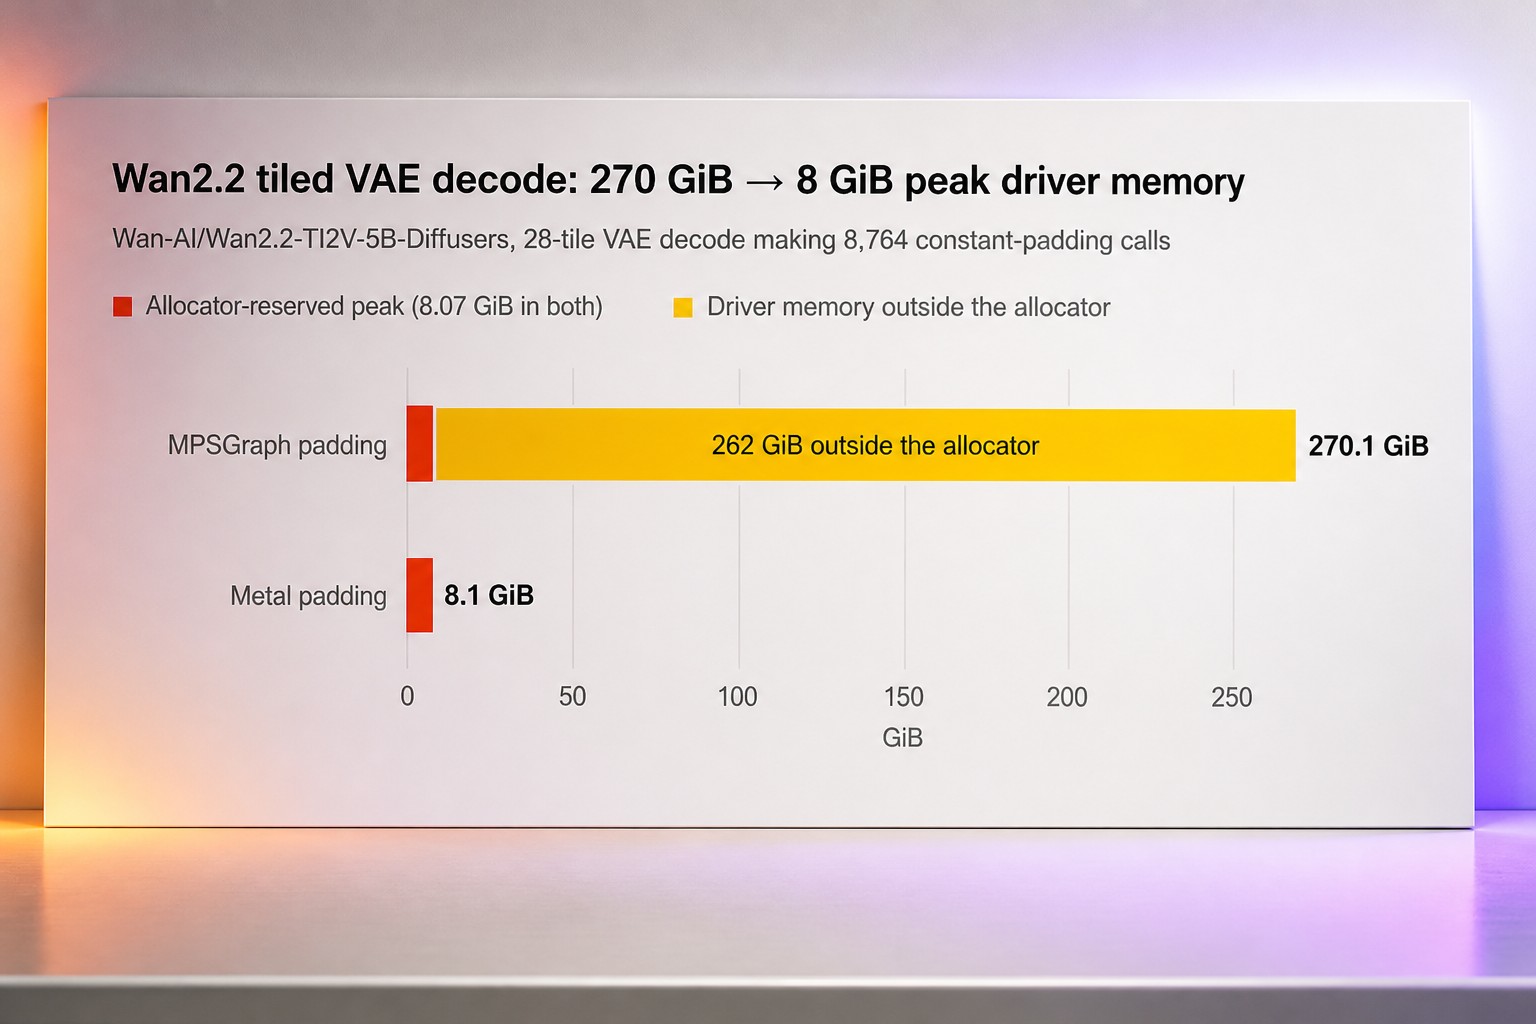
Одно из заметных изменений связано с дополнением тензоров константами. VAE-декодер модели Wan-ИИ/Wan2.2-TI2V-5B-Diffusers выполняет 8764 операции дополнения за полный проход по 28 блокам. После переноса дополнения на Metal пиковое использование памяти драйвера снизилось примерно с 270 до 8 ГиБ.
Управление потоками MPS
Теперь из Python можно выбирать поток MPS для выполнения задач. Для этого доступны torch.mps.Stream и контекстный менеджер torch.mps.stream, а Tensor.record_stream позволяет аллокатору учитывать использование тензора в другом потоке.
В этом примере вычисления запускаются в отдельном потоке, который синхронизируется перед чтением результата:
import
 torch

x = torch.randn(
1024
, device=
"mps"
)
torch.mps.synchronize()
worker = torch.mps.Stream()

with
 torch.mps.stream(worker):
    y = x.square()
    x.record_stream(worker)

del
 x
worker.synchronize()

print
(y.cpu().shape)
Код возводит тензор в квадрат в отдельном потоке MPS, сообщает аллокатору об использовании тензора и дожидается завершения работы потока.
Другие операции на MPS
На MPS теперь доступны ещё несколько операций: torch.frexp, torch.logspace, torch.take и Tensor.put_, torch.heaviside, torch.special.laguerre_polynomial_l, а также сравнения беззнаковых целых чисел. У logspace пока есть ограничение: если результат содержит больше одного элемента, нельзя получить целочисленный или логический тип.
Исправлена и работа attention: математическая реализация scaled dot-product attention для MPS теперь корректно обрабатывает широковещательное распределение размерностей пакета и голов.
Что появится в PyTorch 2.16
Работа над версией 2.16 уже идёт. Некоторые изменения попали в основную ветку и доступны в ночных сборках, другие ещё проходят проверку, поэтому до выпуска детали могут измениться.
Ускоренное декодирование языковых моделей
Когда в пути декодирования модели больше не остаётся операций MPSGraph, GPU начинает обрабатывать токен только после того, как CPU закончит подготовку всех ядер. В PyTorch 2.16 буфер команд будет отправляться на выполнение после каждых 16 ядер: GPU сможет начать работу, пока CPU продолжает готовить остальные. Это изменение относится к декодированию BF16 с компиляцией при длине контекста 2048 токенов.
Attention целиком на Metal
Scaled dot-product attention полностью откажется от MPSGraph: для каждой формы будут использоваться ядра Metal. Для декодирования предусмотрены отдельные векторные ядра, а для предварительной обработки половинной точности на новых версиях macOS — Metal Performance Primitives. Наибольший выигрыш ожидается у форм, которые раньше переходили на MPSGraph.
На M5 Pro декодирование с групповой выборкой запросов — 32 головы запросов, 8 голов ключей и значений, размерность головы 80 и контекст 4K — ускоряется с 465 до 65 мкс. Предварительная обработка матрицы 4K × 4K с размерностью головы 40 сокращается с 42 до 6 мс.
Перенос операций с MPSGraph на Metal
Перенос операций продолжается. Прямой и обратный проходы пакетной нормализации находятся в работе. MSE loss, который на небольших входных данных работает до 12 раз быстрее, std_mean и var_mean с ускорением до 4 раз, а также bincount уже добавлены.
Наибольшая разница — у bincount. Если большинство значений попадает в одну корзину, подсчёт 4 миллионов целых чисел раньше занимал 6,8 секунды, а теперь — полмиллисекунды.
Уменьшение размера установки
По умолчанию шейдеры в комплекте будут собираться для Metal 3.1; версии для Metal 4 будут компилироваться только для ядер, которым они нужны. Это уменьшит размер libtorch_cpu.dylib примерно на 25% — с 384 до 287 МиБ — и подготовит основу для шейдеров Metal 4.1 с более быстрым умножением матриц и нативным умножением матриц FP8.
Итоги
PyTorch 2.15 добавляет FP8 на Mac, ускоряет декодирование плотных моделей и моделей со смесью экспертов, расширяет набор операций линейной алгебры на GPU и переносит ряд операций с MPSGraph на отдельные ядра Metal. Предварительную версию уже можно попробовать.
Что команда планирует дальше
torch.compile: команда работает над устранением разрывов графа, чтобы больше моделей компилировались целиком.Команда благодарит Никиту Шульгу, Курта Молера и Аарона Гокаслана за проверку значительной части этой работы, а также всех, кто участвовал в развитии MPS в этом выпуске.
Читайте также
 В гостях у нового гигантского полупроводникового комплекса Samsung
 Голливудские ИИ-звёзды: готова ли технология потеснить актёров из плоти и крови?
 Не обманывайтесь: ИИ, который должен был экономить наше время, делает ровно обратное
 Хакеры взломали OpenCode и потратили деньги с ИИ-счетов пользователей
 Мамдани: федеральные власти отказались заниматься ИИ — он призвал жителей Нью-Йорка дать отпор
 Tenstorrent привлекла $1,5 млрд при оценке в $6,2 млрд, чтобы нарастить выпуск ИИ-чипов с открытыми весами
 Nscale и Anthropic, по сообщениям, обсуждают ещё одну сделку на $45 млрд по вычислительным мощностям
 fal представила FLUX 3 Max и заявила, что модель генерирует видео с ИИ в 22 раза быстрее Seedance 2.5
 Встроенные оценщики ИИ не станут простым решением, предупреждает глава отдела политики Hugging Face
 Исследование предполагает: новый ИИ-инструмент предсказывает выживаемость при раке по одному селфи пациента
 Microsoft: ИИ-агенты похожи на инсайдерские угрозы, а передовым моделям нельзя доверять
 Основательница Replika спустя 12 лет создала ИИ-ассистента, которого представила на Disrupt
 Amazon нанесла Nvidia самый серьёзный удар — выпустила инструмент для разработчиков TorchNeuron
 Бывшего инженера OpenAI, обвиняемого в слежке за руководителями, оставили под стражей до суда
 Tolan привлекла $30 млн на развитие ИИ-компаньона, помогающего справляться с жизненными трудностями
 Интернет станет удобнее для ИИ-агентов, но может ухудшиться для всех остальных
 MiniMax M3.1 Flash показывает: ценовой гонке ИИ в Китае не видно дна
 МВФ предупреждает: пузырь ИИ может обрушить всю мировую экономику
 Kling AI выпустила версию 4.0 со стереозвуком, многоязычной синхронизацией губ и облегчённой версией Flash
 Laplace Intelligence проверяет роботов и беспилотные автомобили на прочность до выхода в реальный мир
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram