
Для чего предназначена BotPsy
Модель умеет обращаться к инструментам для простых задач, связанных с поиском информации в интернете, поездками и повседневными делами, покупками и финансами, работой с клиентами, управлением устройствами и автомобилями, файлами, календарём, почтой и сообщениями.
Авторы связывают разработку локальных моделей с несколькими проблемами облачных сервисов. Их стоимость может неожиданно меняться, доступ к ним зависит от сторонних поставщиков, а закрытые модели ограничивают настройку под конкретные процессы. Кроме того, облачная обработка создаёт вопросы о приватности, контроле над данными и прозрачности. Для многих повседневных задач, по мнению разработчиков, достаточно небольшой специализированной модели, которую дешевле запускать на устройстве.
BotPsy лучше подходит для задач низкой и средней сложности. Разработчики предупреждают, что она может ошибаться и не предназначена для применения, где неверный ответ способен привести к серьёзным последствиям.
Результаты на бенчмарках
На ключевых тестах для работы с инструментами BotPsy примерно вдвое превзошла базовую Qwen3.5-0.8B-Think: результат BFCL v4 вырос с 23,4 до 44,0, ACEBench — с 30,1 до 58,7, а τ-bench — с 23,2 до 51,5. Последний показатель — среднее по заданиям для розничной торговли, телекоммуникаций и банковских услуг.
Среди моделей с параметрами до 1,2 млрд BotPsy обошла Qwen3.5-0.8B-Think, LFM2.5-1.2B-Think и MiniCPM5-1B-Think на всех шести бенчмарках: BFCL v4, ACEBench, τ-bench, ToolSandbox, Claw-Eval и BrowseComp-Plus.
На пяти из шести тестов BotPsy показала лучшие результаты среди всех проверенных моделей. Она превзошла Qwen3.5-2B-Think, у которой в 2,5 раза больше параметров, на BFCL v4 — 44,0 против 37,7, ACEBench — 58,7 против 55,4, τ-bench — 51,5 против 46,5, ToolSandbox — 64,6 против 41,2 и BrowseComp-Plus — 4,5 против 2,8. На Claw-Eval впереди осталась Qwen3.5-2B-Think: 48,9 против 46,5.
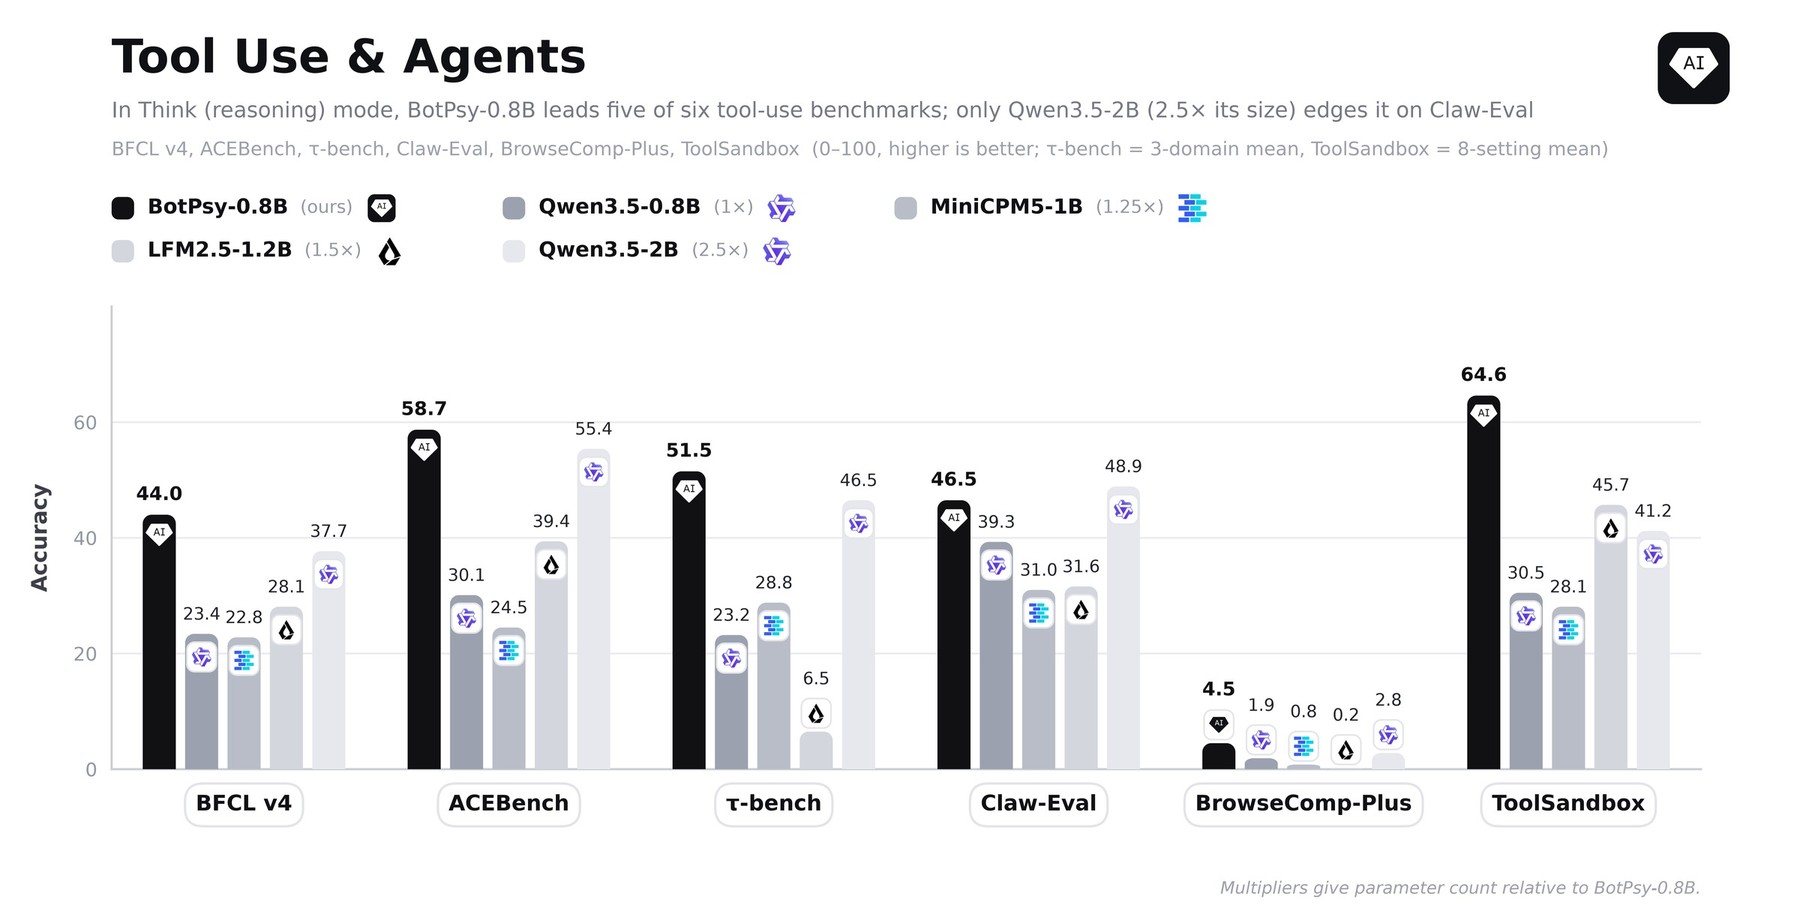
BotPsy-0.8B значительно превосходит базовую модель и лидирует в пяти из шести тестов на использование инструментов и агентность, в том числе опережая Qwen3.5-2B-Think, размер которой в 2,5 раза больше; только в Claw-Eval Qwen3.5-2B-Think немного впереди
Источник: huggingface.co
В тестах на многошаговое взаимодействие BotPsy также показала преимущество. В телекоммуникационном сценарии τ²-bench, где агент должен вести долгий разговор и помогать пользователю решать проблему, её результат составил 82,5 против 69,3 у Qwen3.5-2B-Think. В многошаговых заданиях BFCL v4 результат BotPsy вырос с 7,5 у базовой модели до 46,1. В группах задач для торговли и услуг она набрала 58,3 против 47,4 у следующей по результату модели, а в управлении устройствами и системами — 46,1 против 31,9.
Модель также лучше распознаёт случаи, когда инструмент вызывать не следует. В тестах на галлюцинации BFCL v4, где проверяется отказ от неподходящего вызова, BotPsy набрала 86,1 — больше всех проверенных моделей. В особых сценариях ACEBench, где запрос неполон, содержит неверные параметры или не может быть выполнен доступными инструментами, результат составил 51,3 против 13,7 у базовой модели.
Следование инструкциям и безопасность
Обучение работе с инструментами не ухудшило общие знания модели. Результат GPQA Diamond вырос с 33,2 до 38,1, а MMLU-Pro — с 41,6 до 48,9. В обеих проверках BotPsy опередила модели с параметрами до 1,2 млрд, но Qwen3.5-2B-Think набрала заметно больше — 59,9 и 65,5. Разработчики предполагают, что BotPsy должна обращаться к инструментам за неизвестными ей фактами, а не служить моделью для хранения знаний.
Следование инструкциям улучшилось на IFEval — с 59,7 до 90,8, и на IFBench — с 22,0 до 55,9. Последний результат оказался лучшим среди всех проверенных моделей. В тестах на общие знания и инструкции BotPsy также превзошла каждую проверенную модель с параметрами до 1,2 млрд.
В многоязычном Multi-IF, который проверяет выполнение инструкций в течение трёх обменов на восьми языках, BotPsy набрала 67,2. Это сопоставимо с результатом Qwen3.5-2B-Think — 66,9 — и LFM2.5-1.2B-Think — 68,2. В первом обмене BotPsy показала лучший результат среди пяти моделей — 84,3, но к третьему он снизился до 51,0. У двух названных моделей в третьем обмене было 56,5 и 56,2. Слабее всего BotPsy справилась с хинди — 24,5 — и русским — 57,6; на английском, китайском, французском, испанском, итальянском и португальском результаты составили от 72 до 80.
В автоматизированных проверках безопасности по шести категориям вреда BotPsy давала небезопасные ответы в 21% случаев против 36% у базовой модели. Среди моделей с параметрами до 1,2 млрд это самый низкий показатель: у LFM2.5-1.2B-Think он составил 35%, у MiniCPM5-1B-Think — 47%. При атаках через промты, которые пытаются побудить агента выполнить инструкции из недоверенного вывода инструмента, доля небезопасных ответов снизилась с 46% у базовой модели до 31%.
BotPsy также реже зацикливалась в рассуждениях. На всех попытках IFBench доля повторяющихся рассуждений снизилась с 22,9% до 1,4%, а доля запусков, достигавших лимита в 32 тысячи токенов, — с 28,3% до 0,2%.
Ограничения и слабые места
В открытом поиске BotPsy справляется хуже, чем в ряде других сценариев. На BrowseComp-Plus она набрала 4,5 — лучший результат среди пяти моделей, но невысокий в абсолютном выражении. В поиске по интернету BFCL v4 результат BotPsy составил 14,0, а в заданиях на память — 16,3; в обоих случаях Qwen3.5-2B-Think оказалась впереди с результатами 19,8 и 26,1. На Claw-Eval BotPsy превзошла свою базовую модель — 46,5 против 39,3, — но уступила Qwen3.5-2B-Think с 48,9 балла.
В особых сценариях ACEBench Qwen3.5-2B-Think тоже набрала больше: 58,0 против 51,3. В банковском разделе τ³-bench ни одна модель не превысила 5 баллов: у BotPsy результат составил 4,1, как и у её базовой модели, а у Qwen3.5-2B-Think — 4,8.
В простых сценариях с одним вызовом инструмента BotPsy набрала от 70 до 79 баллов в каждой группе приложений с достаточным числом заданий. В группе коммуникации и социальных сервисов было всего шесть сценариев. Общий результат модели составил 75 против 54 у базовой модели и 70 у Qwen3.5-2B-Think.
В сложных сценариях, где требуется несколько шагов или инструментов, BotPsy набрала 39,5 балла против 17,9 у базовой модели и 30,8 у Qwen3.5-2B-Think. Самый большой прирост относительно базовой модели был в коммуникации и социальных сервисах — 61 против 13, торговле и услугах — 58 против 27, а также управлении устройствами и системами — 46 против 15. Qwen3.5-2B-Think опередила BotPsy только в личной продуктивности и рабочих задачах: 64 против 58 на 38 сценариях, в основном из Claw-Eval. В коммуникации и социальных сервисах MiniCPM5-1B-Think немного обошла BotPsy — 61,5 против 60,5. В целом многошаговые задания остались для модели более сложными, чем одиночные вызовы.
Самой слабой областью оказался сложный поиск информации и исследовательские задачи: BotPsy набрала 15 баллов против 79 в одиночных вызовах. Большинство таких заданий составляли вопросы для углублённого поиска BrowseComp-Plus. Они были трудными и для других моделей этого размера: базовая модель набрала 9, Qwen3.5-2B-Think — 14.
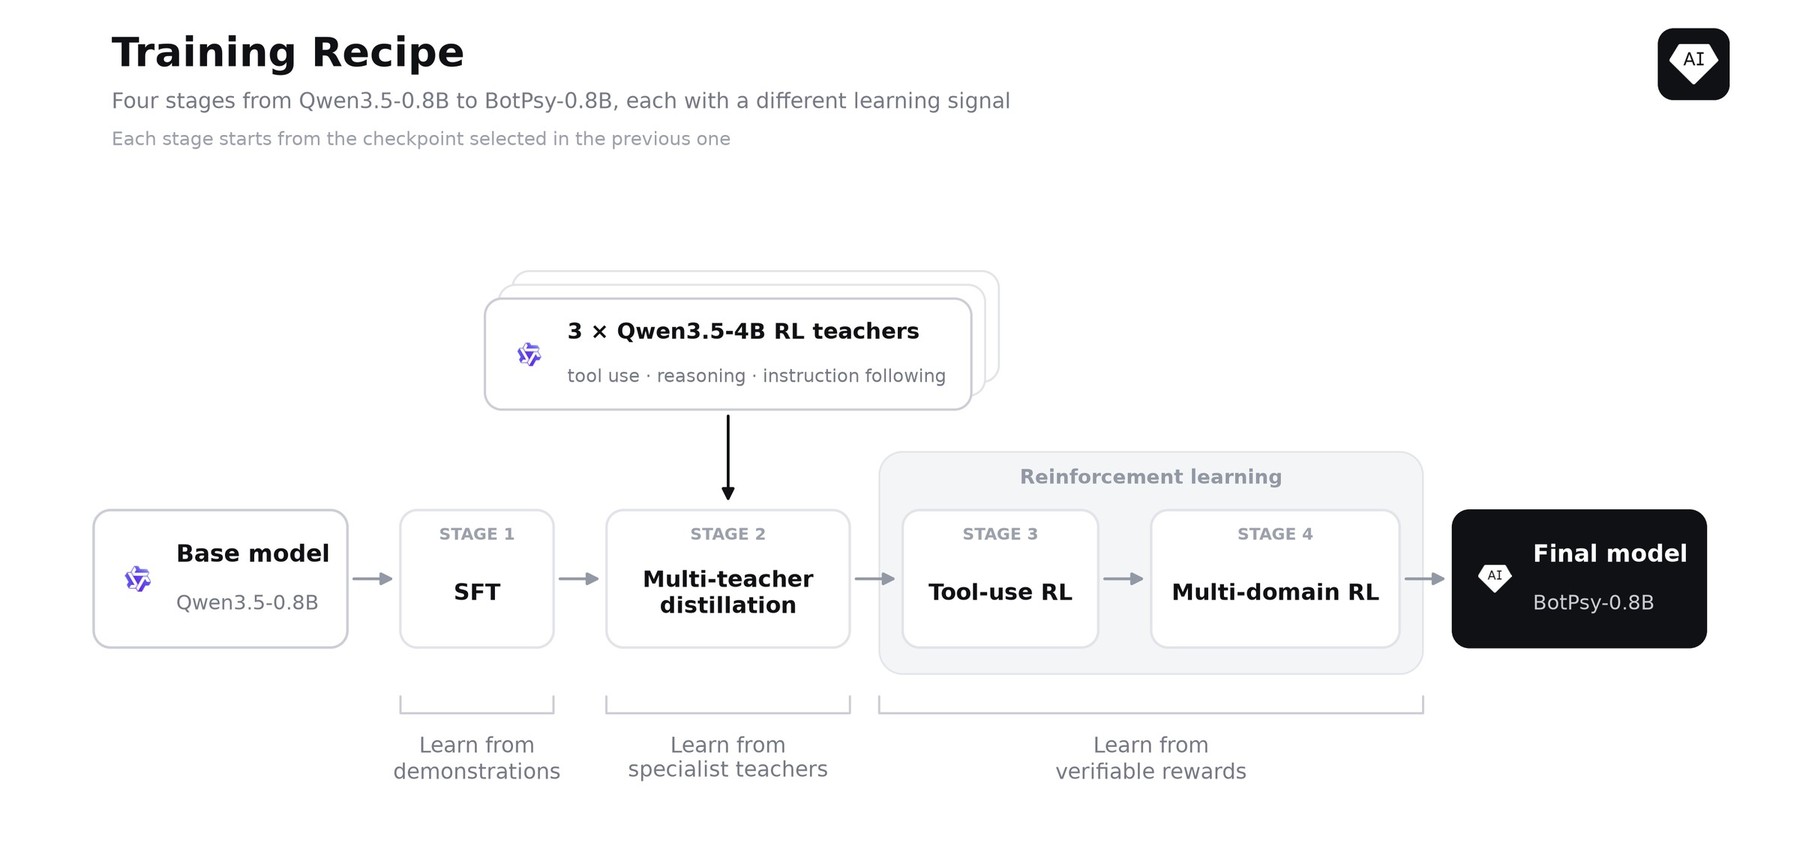
Рецепт обучения BotPsy. Ученик проходит четыре этапа. На этапе дистилляции ему помогают три специализированные модели-учителя Qwen3.5-4B, каждая из которых обучена с помощью RL одному навыку
Источник: huggingface.co
Скорость рассуждений и число шагов
Сравнения эффективности проводились на одинаковых вопросах и заданиях — тех, которые решили все пять моделей. Число токенов рассуждений считали отдельно для каждой модели с её собственным токенизатором.
На верные ответы BotPsy тратила от 1,4 до 3,1 раза меньше токенов рассуждений, чем базовая модель: 3690 против 11 563 на GPQA Diamond, 1912 против 5105 на MMLU-Pro, 3148 против 4433 на IFEval и 4204 против 11 576 на IFBench. При этом BotPsy показала более высокую точность на всех четырёх тестах. Она не была самой краткой в каждом сравнении: на MMLU-Pro, IFEval и IFBench меньше рассуждений выдавала LFM2.5-1.2B-Think, а на IFEval и IFBench — MiniCPM5-1B-Think, но точность этих моделей на соответствующих тестах была ниже.
В многошаговых заданиях τ²-bench BotPsy делала меньше ходов, чем базовая модель:
При этом BotPsy решала вдвое больше заданий в розничной торговле и в 2,6 раза больше в телекоммуникациях, чем базовая модель. MiniCPM5-1B-Think использовала меньше ходов в розничной торговле — 8,7, — но прошла лишь 9,9% заданий в этой группе.
Как обучали модель
BotPsy основана на Qwen3.5-0.8B. Её обучали в четыре последовательных этапа: контролируемая тонкая настройка (SFT), дистилляция на собственных ответах с несколькими учителями (MOPD) и два этапа обучения с подкреплением. Каждый этап начинался с лучшей версии модели, полученной на предыдущем. При обучении использовали примеры действий, распределения вероятностей от более крупных моделей-учителей и награды, рассчитанные по правилам и проверкам.
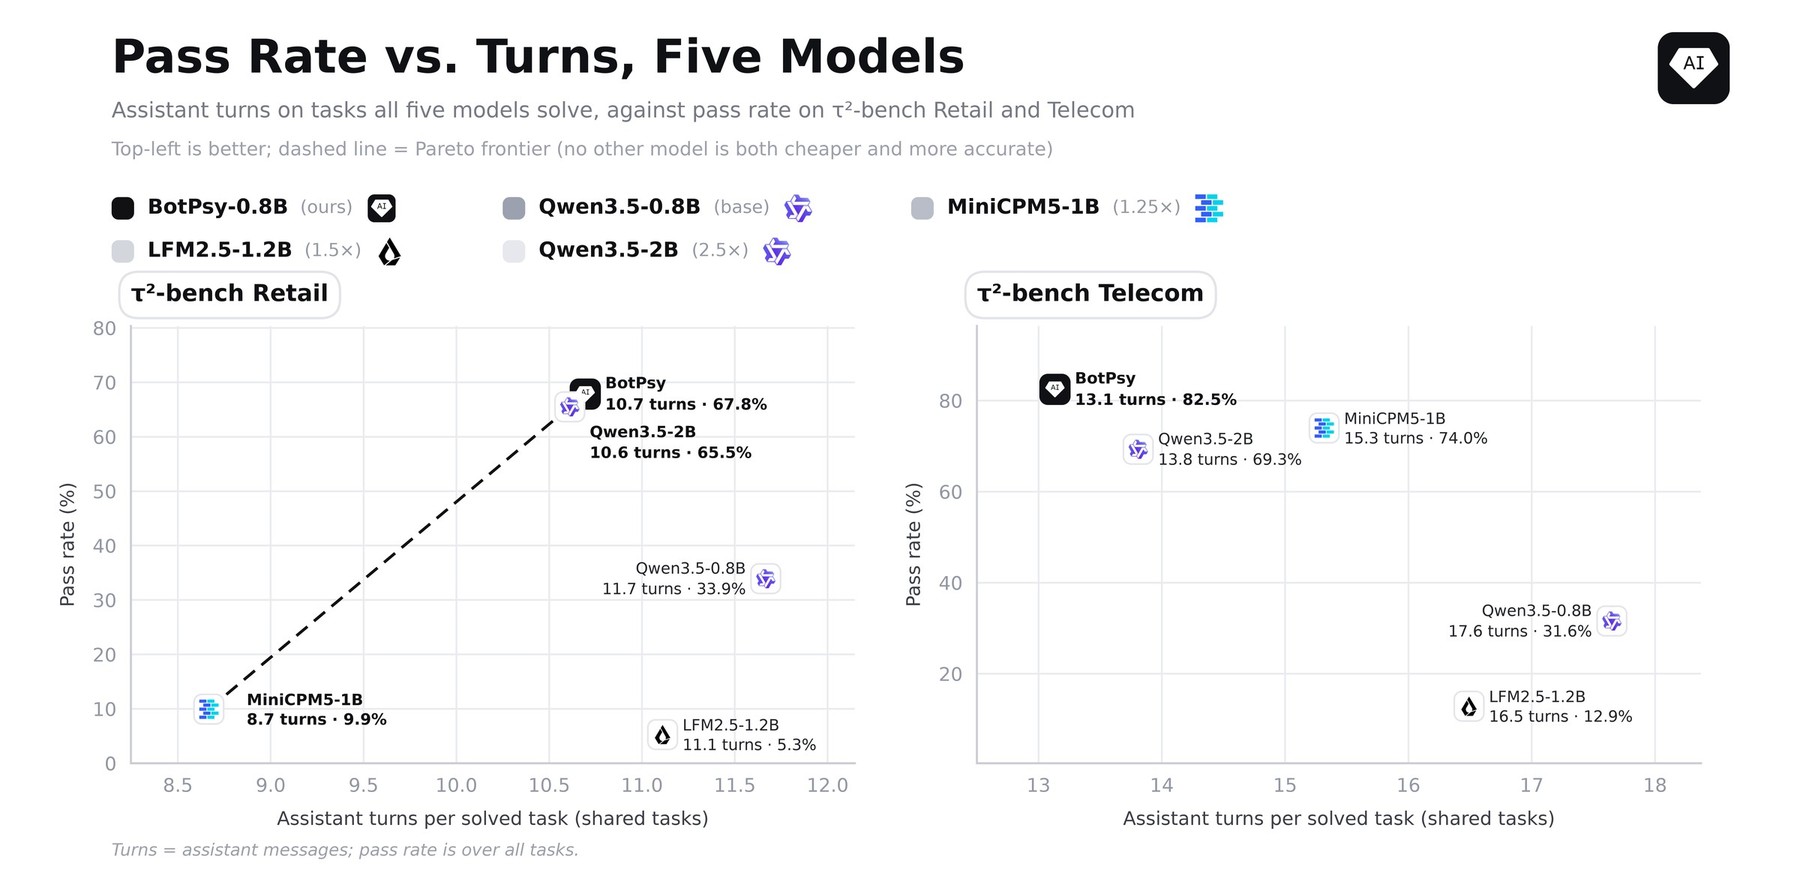
Доля успешно выполненных задач в зависимости от числа ходов ассистента на τ²-bench для розничной торговли и телекоммуникаций. Число ходов измеряется на задачах, которые решают все пять моделей; доля успешных решений рассчитывается по всем задачам. Лучше — в левом верхнем углу; пунктирная линия — граница Парето
Источник: huggingface.co
На этапе SFT модель обучали на диалогах об использовании инструментов. В данные вошли многошаговые взаимодействия из симулированных сред, повторные одиночные, параллельные и многошаговые вызовы, а также ситуации, в которых инструмент вызывать не нужно.
Затем модель генерировала собственные ответы, а специализированный учитель оценивал каждый токен. Сигналом для обучения служило обратное расхождение Кульбака — Лейблера на уровне токенов. Для этого этапа разработчики сначала обучили с подкреплением три модели Qwen3.5-4B: на использование инструментов, общие рассуждения и следование инструкциям. Каждый промт направлялся одному из этих учителей. Этот этап должен был вернуть часть знаний и способности следовать инструкциям, ослабленных после SFT; показатели работы с инструментами также выросли.
На первом из двух этапов обучения с подкреплением применялся DAPO. Модель училась на наградах, рассчитанных правилами и проверяющими программами, без дополнительных оценок. Основное внимание уделили вызову инструментов, а также следованию инструкциям и заданиям с вопросами по естественным и точным наукам с вариантами ответа. Формат рассуждения и вызова инструмента проверяли по образцу Tool-N1, но вместо оценки только за правильный или неправильный ответ использовали частичную награду по принципу ToolRL: отдельно сопоставляли названия инструментов, имена аргументов и их значения с эталоном.
На втором этапе добавили задачи с проверяемыми ответами из разных областей: математику, программирование, вопросы на знания с вариантами ответа, следование инструкциям, структурированные ответы и многошаговую работу с инструментами в симулированной рабочей среде. Хотя многошаговых диалогов в этом наборе не было, результаты в многошаговом вызове функций улучшились.
Состав данных менялся на каждом этапе. SFT была сосредоточена главным образом на использовании инструментов. Набор MOPD объединял работу с инструментами, проверку знаний и следование инструкциям, чтобы улучшить вызовы и восстановить просевшие после SFT результаты в общих задачах. Первый этап обучения с подкреплением снова был посвящён прежде всего инструментам, а второй сместил баланс в сторону инструкций, знаний, математики и программирования, сохранив меньшую долю задач на использование инструментов.
Выпуск и дальнейшие планы
BotPsy планируют выпустить с открытыми весами по лицензии Apache 2.0 для исследований и обучения. Доступны будут три варианта точности — bf16, Q8 и Q4. Модель представят в формате safetensors на Hugging Face и в файлах GGUF для QVAC SDK и llama.cpp.
Tether AI Research планирует расширять возможности локальных ИИ-агентов и подключать их к большему числу устройств и локальных сервисов. Hypersearch компании хотят развивать для более надёжных децентрализованных одноранговых запросов и приватного зашифрованного поиска в интернете, обходящего корпоративные системы отслеживания. Механизмы локальной тонкой настройки QVAC Fabric должны будут лучше учитывать предпочтения пользователей, их рабочие процессы и наборы инструментов. В будущих версиях смартфон сможет передавать ресурсоёмкие задачи домашним компьютерам или доверенным защищённым одноранговым узлам при переходе между режимами без интернета и с подключением.
Компания также намерена укреплять протоколы защиты данных и добавить обмен данными между агентами в доверенных локальных сетях. Эти планы описывают направление дальнейшей разработки; в источнике не указаны сроки их реализации.
Модель позиционируется как локальный помощник для повседневных задач, а не как универсальная замена крупным моделям: её результаты особенно заметны в вызове инструментов и многошаговом взаимодействии, но сложный поиск и отдельные задачи остаются слабым местом. По оценке Dataist, открытые веса и возможность локального запуска дают разработчикам основу для настройки таких помощников, однако предупреждение о возможных ошибках и запрет на применение в чувствительных сценариях остаются существенными ограничениями.
Читайте также
 Oura покупает стартап Counsel Health в сфере первичной помощи на базе ИИ за $625 млн
 ИИ-агент Meta Muse появился на Apple Watch и часах с Android Wear OS
 У ИИ-диджея Spotify появились новые голоса и характеры, а болтать он может меньше
 Лазарь, выйди вон: как перепрограммировать спящие нейроны и внедрить бэкдор в ИИ-агента
 Otter AI теперь распознаёт разговоры на более чем 30 языках
 Любовь Албанизи к музыке дала трещину из-за ИИ. Сможет ли он сыграть по-новому?
 OpenAI превращает ChatGPT в бизнес-каталог с ИИ-агентами, отвечающими на вопросы клиентов
 OpenAI купила Odessia — туристический стартап основателя Sonder
 PayPal добилась точности ИИ в 95% на той же языковой модели
 GR00T 2 от Nvidia смотрит видео с людьми, а затем представляет себя роботом
 PSI пытается превратить научные открытия с помощью ИИ в бизнес
 Компания, публиковавшая фальшивые статьи спортивных журналистов в Sports Illustrated, стремительно рушится после масштабного ребрендинга с ИИ
 Anthropic запустила Claude Meetings: обсуждения на работе превращаются в планы и задачи
 Gemini Robotics 2.5 от Google DeepMind сортирует металлические детали с точностью 96% в пилотном проекте Mercedes-Benz
 Оплачивайте Hugging Face Hub через аккаунт Google Cloud
 Больше GPU и токенов не гарантируют лучших результатов ИИ-агентов
 Anthropic нацелилась на оценку до $1,4 трлн при выходе на биржу
 Модели для принятия решений появились в Hugging Face
 Google Gemini 4 Carbon стала общедоступной и обошла Claude Fable 5.2 и Opus 5.5 по цене API
 Восемь стран и ведущие ИИ-лаборатории договорились о механизмах отключения систем в новой Парижской декларации
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram