
Что такое TPU
TPU — это тензорный процессор, собственный ускоритель Google для задач искусственного интеллекта. Чипы рассчитаны на матричные вычисления, которые занимают большую часть работы нейросетей. Google разрабатывает TPU около десяти лет и использует их для обучения и запуска своих моделей, в том числе Gemini.
TPU доступны в Google Cloud: от одного чипа до подов с тысячами чипов. Они подходят для задач, которым нужны большие вычислительные мощности, — обучения моделей и их масштабного обслуживания.
Проблемой долго оставалось программное обеспечение: экосистема TPU развивалась вокруг TensorFlow и JAX, поэтому пользователям PyTorch приходилось прикладывать дополнительные усилия.
Как запускали PyTorch раньше
До появления TorchTPU для запуска PyTorch на TPU требовался PyTorch/XLA (torch_xla). Он работал, но с особенностями: тензоры вычислялись лениво, поэтому код не всегда выполнялся в ожидаемый момент. Даже небольшие изменения могли вызывать повторную компиляцию графа, а отладка была непростой.
Чтобы упростить работу, Hugging Face создала Optimum TPU — библиотеку для запуска и обучения моделей Hugging Face на TPU. Теперь, когда TorchTPU обеспечивает нативную поддержку, Optimum TPU больше не нужен для работы с моделями Hugging Face в Transformers и Diffusers.
Как работает TorchTPU
TorchTPU добавляет TPU в PyTorch как новый бэкенд. Пользователь пишет обычный код PyTorch, а пакет предоставляет оптимизированные для TPU ядра Pallas, поддержку распределённого обучения и интеграцию с torch.compile для ускорения вычислений. Установка на виртуальную машину с TPU выполняется одной командой:
pip install torch-tpu --extra-index-url https://download.pytorch.org/whl/cpuДополнительный индекс устанавливает версию torch для центрального процессора. Без него pip скачает значительно более крупную версию CUDA, которая для TPU не нужна.
Transformers и Diffusers на TPU
Transformers
Transformers v5 создавали с расчётом на то, чтобы библиотека была основным источником описаний моделей и позволяла запускать их где угодно. Теперь в этот список входят и TPU. Чтобы загрузить модель на TPU, достаточно передать device_map="tpu":
from
 transformers
import
 AutoModelForCausalLM, AutoTokenizer

model_id =
"Qwen/Qwen3.5-9B"

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map=
"tpu"
,
# will load model directly on the TPU

)
tokenizer = AutoTokenizer.from_pretrained(model_id)
inputs = tokenizer(
"The future of ИИ is"
, return_tensors=
"pt"
).to(
"tpu"
)
out = model.generate(**inputs, max_new_tokens=
64
)

print
(tokenizer.decode(out[
0
], skip_special_tokens=
True
))
По умолчанию модель работает в обычном режиме выполнения. Для повышения производительности можно использовать torch.compile или запустить модель в распределённой конфигурации.
Генерация изображений и видео с Diffusers
В Diffusers TPU теперь поддерживается как полноценное устройство. Для прототипирования и отладки достаточно вызвать pipe.to("tpu"). При развёртывании можно добавить один вызов компиляции. Пайплайны и код остаются прежними, отдельную версию Diffusers для TPU поддерживать не нужно.
import
 torch

from
 diffusers
import
 StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_pretrained(

"stabilityai/stable-diffusion-3.5-medium"
, dtype=torch.bfloat16
)
pipe.to(
"tpu"
)
# eager mode: that's the whole change

# optional: compiled mode

pipe.transformer.
compile
(backend=
"tpu"
, fullgraph=
True
, dynamic=
False
)

image = pipe(
"a corgi astronaut planting a flag on a pizza moon"
).images[
0
]
Первый вызов запускает компиляцию. При последующих вызовах с тем же размером изображения используется уже собранный граф.
Если модель не помещается на один чип, при загрузке через from_pretrained можно передать TensorParallelConfig: тогда трансформер распределится между несколькими чипами. Многим популярным пайплайнам эта возможность доступна сразу, а для остальных достаточно указать план тензорного параллелизма. Полный пример приведён в руководстве Diffusers для TPU.
Ниже — примеры, запущенные на Cloud TPU v6e-4: TP=4, то есть каждая модель распределена между четырьмя чипами; формат bf16, размер пакета — 1.
Ядра
В Kernels Hub доступны готовые ядра для TPU. Их можно загрузить через библиотеку Kernels и использовать для ускорения модели.
Ядра для TPU пишут на Pallas, который предоставляет низкоуровневый доступ к аппаратным возможностям. Можно использовать и ядра из библиотеки Tokamax. Например, ядро ragged-dot из Tokamax можно подключить к модели типа «смесь экспертов»:
from
 kernels
import
 get_kernel

from
 transformers
import
 AutoModelForCausalLM

from
 transformers.integrations.moe
import
 ALL_EXPERTS_FUNCTIONS

repo_id =
"tengomucho/ragged-dot-tpu"

kernel = get_kernel(repo_id, version=
1
, trust_remote_code=[repo_id])
ALL_EXPERTS_FUNCTIONS.register(
"tokamax_ragged_dot"
, kernel.experts_forward)
model = AutoModelForCausalLM.from_pretrained(

"Qwen/Qwen3-30B-A3B-Instruct-2507"
,
    experts_implementation=
"tokamax_ragged_dot"
,
)
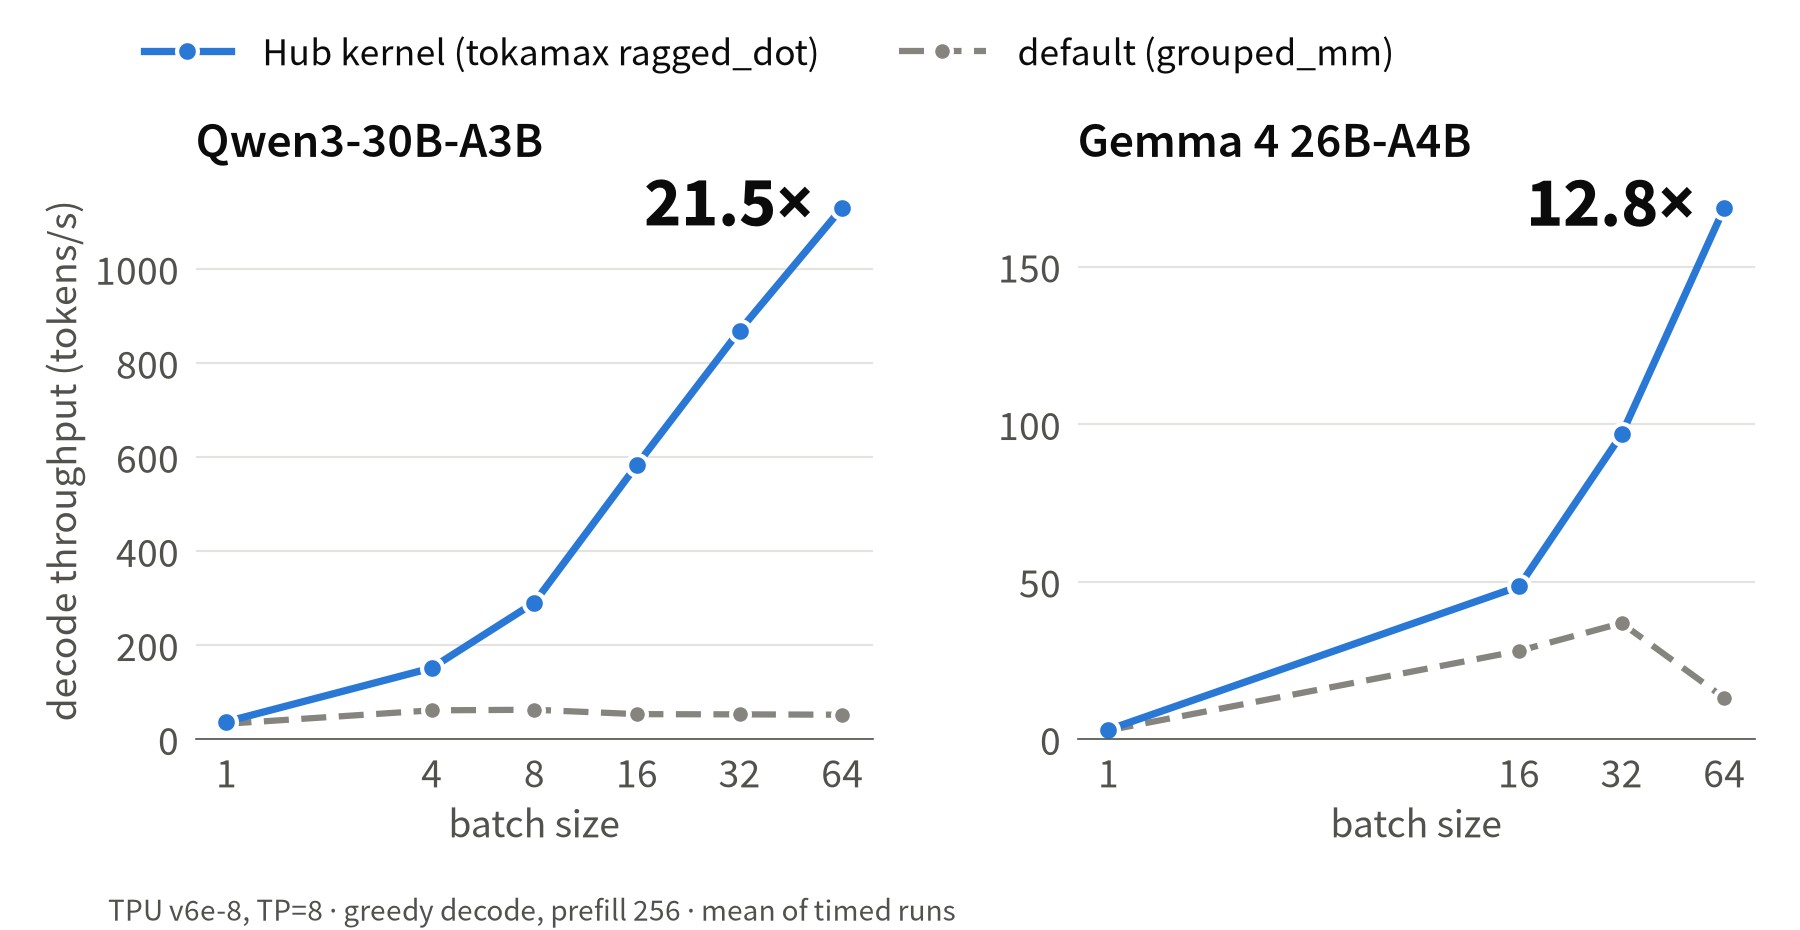
Чем больше размер пакета, тем заметнее ускорение. При размере 64 декодирование на Qwen3-30B-A3B стало быстрее в 21,5 раза, а на Gemma 4 26B-A4B — в 12,8 раза.
Источник: huggingface.co
На графиках сравнивается пропускная способность декодирования на TPU v6e-8 при использовании ядра из Hub и реализации по умолчанию.
Как проверяют поддержку TPU
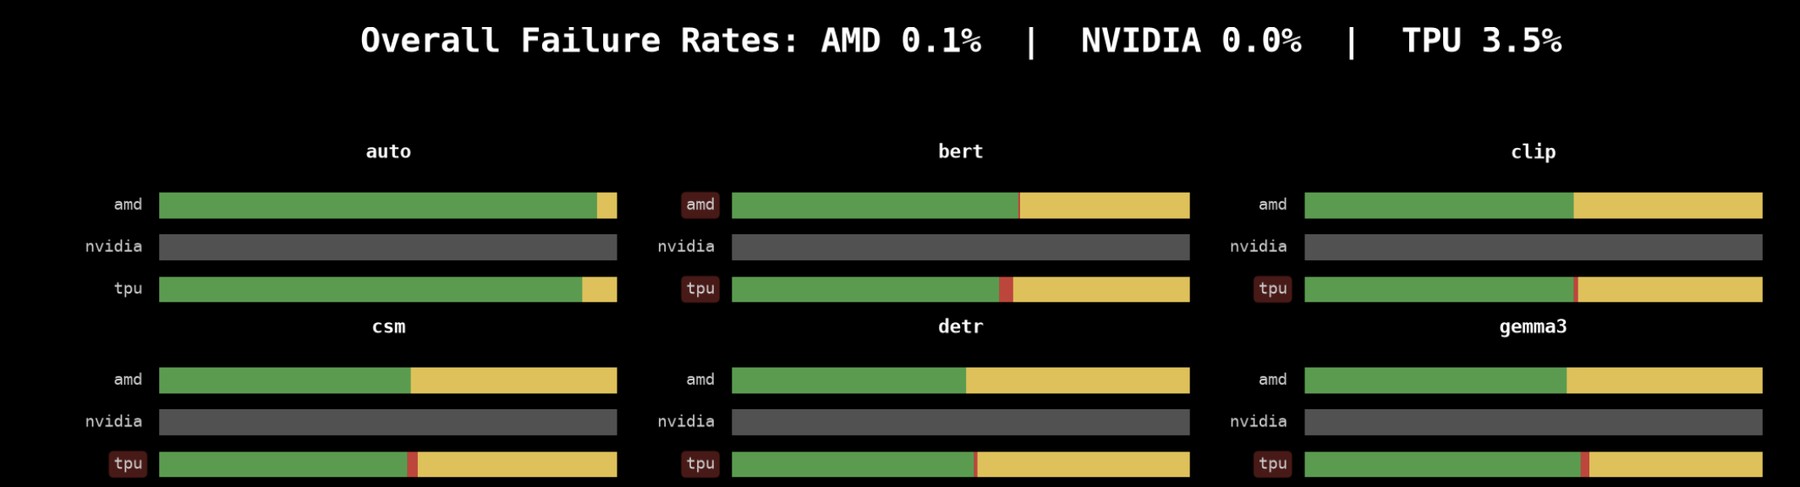
Hugging Face постоянно улучшает поддержку TPU в Transformers, запуская набор тестов библиотеки. Команда готовит ежедневные проверки на TPU и планирует публиковать результаты на панели Transformers.
Источник: huggingface.co
Панель CI Transformers показывает результаты TPU рядом с результатами для других ускорителей; работа над ней продолжается.
Пока проходят не все тесты, но сейчас успешно завершаются 96,5% проверок, запущенных на TPU. Каждую найденную ошибку оформляют как небольшой сценарий для воспроизведения и задачу в репозитории TorchTPU. На данный момент команда сообщила о 34 проблемах, 19 из них уже исправлены. Запуски на TPU также помогли обнаружить несколько ошибок в самой Transformers, включая проблемы со StaticCache и планами тензорного параллелизма для Qwen3. Эти ошибки исправили в основном проекте.
Команда хочет узнавать о сбоях на TPU раньше пользователей.
С чего начать
Пользователям PyTorch больше не нужно обходное решение, чтобы работать с TPU. Установите TorchTPU, выберите модель из Hub и отправьте её на устройство "tpu".
Если возникнет проблема, Hugging Face предлагает сообщить о ней, создав задачу в репозитории.
TPU Google Cloud для пользователей Hugging Face
Тысячи открытых языковых моделей в Vertex AI Model Garden
Сообщество
Источник: huggingface.co
Читайте также
 Project Deal: Anthropic проверила, как Claude ведёт себя на внутреннем рынке
 Muse от Meta набрала 10 млн скачиваний в США за 40 дней — такой рубеж покорили лишь 11 других приложений
 Mistral AI выпустила Voxtral 3 — полный стек голосовых ИИ-агентов, которые слушают, думают и говорят в реальном времени
 ALTK-Evolve: как обученная память выводит модель без передовых ИИ-возможностей в лидеры τ²-bench по задачам поддержки клиентов
 Сценарии будущего нашей экономики
 Амулья Вишванат, бывшая сотрудница Nvidia и нынешний венчурный инвестор: физический ИИ пока в эпохе LEGO
 Растения передают сигналы с помощью электричества — стартап создал ИИ-модель, чтобы расшифровать их язык
 Как ИИ и квантовые технологии помогают прояснить главные загадки человечества
 Не станет ли это для криптокроссвордов моментом Deep Blue?
 ИИ-агент вступил в рассылку ведущих интернет-исследователей — хаос с ответами всем продолжается
 Эксперты предупреждают: люди могут стать пустыми оболочками под контролем ИИ
 Yelp теперь может позвонить в ресторан за вас и узнать, сколько ждать столик
 С сожалением сообщаем: «GatGPT» — именно то, что вы подумали
 Сооснователь Figma Дилан Филд считает, что MCP далёк от идеального протокола
 Google и Synaptics представили новые ИИ-чипы для носимых и промышленных устройств на базе открытой технологии Coral
 Лейбористы и Коалиция готовы безрассудно поставить на ИИ. Неужели они не заметили, что общественная поддержка рухнула?
 Как разные отрасли осваивают ИИ и чему могут научиться друг у друга
 Google DeepMind без лишнего шума нанимает физиков-ядерщиков
 Чтобы масштабировать ИИ-агентов, нужны реестр, договоры и актуальный контекст
 США запретили госведомствам использовать ИИ-инструменты китайской DeepSeek
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram