
Ограничения нынешних оптимизаторов
За последний год фреймворки для автоматической оптимизации обвязки агента в основном развивались по двум направлениям. Инструменты для отдельных компонентов — например, WikiSkill от Google, SkillOpt от Microsoft и Memento-Skills — анализируют действия агента и улучшают одну часть системы: библиотеку навыков или хранилище памяти.
Полноценные оптимизаторы обвязки, такие как DarwinX от Salesforce, HarnessX от Xiaomi, Self-Harness и Meta-Harness от Стэнфорда, используют мета-агента для программирования. Он изучает записи неудачных запусков и переписывает вспомогательный код или правила работы агента.
По мнению исследователей из Калифорнийского университета в Санта-Барбаре и Microsoft, методы, основанные только на обратной связи от выполнения задач, замыкаются в контур, где быстро снижается отдача.
Во-первых, мета-агент ограничен знаниями, заложенными в базовую модель. Исследователи отмечают: механизмы, которые предлагает мета-агент, зависят от знаний и способности к рассуждению его базовой модели. Запись неудачного запуска может выявить нехватку какой-то способности, но почти не подсказать, как её развить.
Когда мета-агент для программирования видит в записи повторяющиеся ошибки при вызове инструментов, он часто прибегает к знакомым приёмам — например, добавляет этап проверки или цикл обсуждения между несколькими агентами. В одном из примеров система заметила повторные ошибки при поиске и вызовах инструмента Python и добавила модуль условной проверки каждого действия. Проверяющий модуль отсеивал ошибочные вызовы, но стал чрезмерно осторожным и блокировал корректные запросы к API, необходимые для выполнения задачи.
Во-вторых, развитие на основе записей действий реагирует на уже произошедшие сбои. Исследователи пишут, что такой подход опирается на ситуации, с которыми система уже сталкивалась. Поэтому в рабочей среде слабое место агента может затронуть пользователей ещё до того, как накопится достаточно данных для полезного обновления.
Эти ограничения привели исследователей к вопросу: как опытный исследователь обнаружил бы улучшения, которые ещё не проявились в собственном опыте агента?
Как устроен ScholarEvolve
ScholarEvolve анализирует сбои на обучающей выборке, ищет в научной литературе подходящие решения, реализует их в модулях обвязки и проверяет, как они работают вместе.
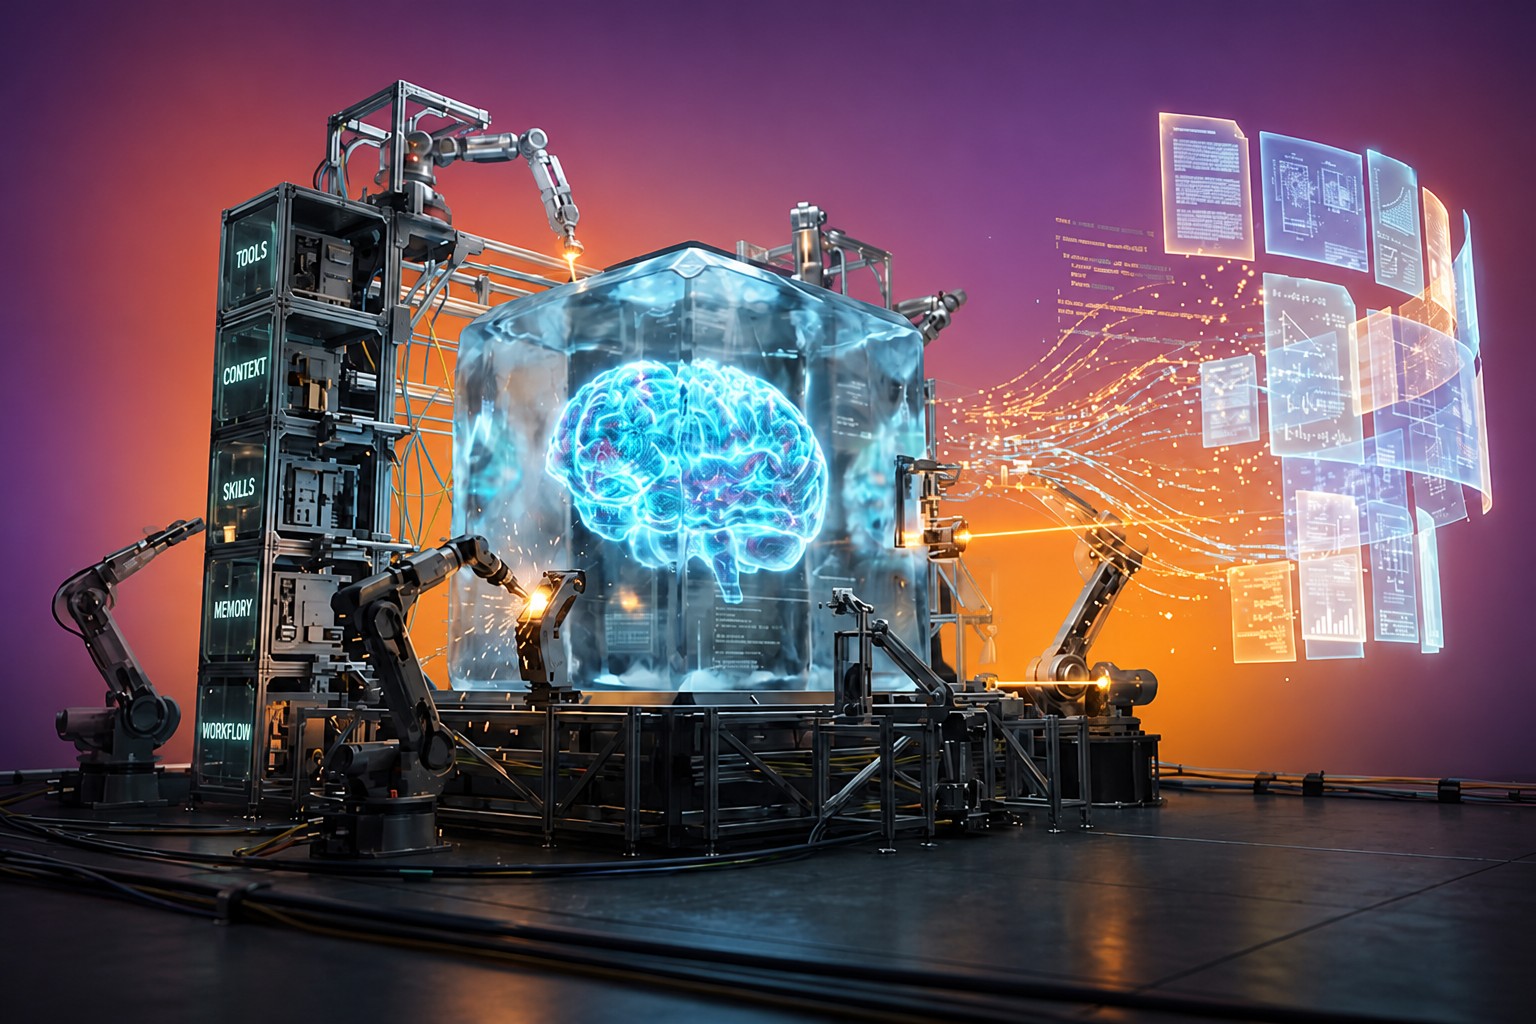
Чтобы изменение одной части агента не нарушало работу другой, фреймворк делит обвязку на пять модулей с чётко заданными входами и выходами: интерфейс инструментов, управление контекстом, навыки, память и рабочие процессы агента.
Пайплайн оптимизации состоит из четырёх этапов:
На Qwen3.5-27B в среде AppWorld ScholarEvolve получил три заметных улучшения:
Результаты испытаний
Исследователи проверили ScholarEvolve на двух интерактивных бенчмарках, имитирующих некоторые корпоративные процессы. В AppWorld агенты пишут код и вызывают API нескольких приложений. В tau-Bench Telecom они вместе с имитируемым пользователем решают проблемы с обслуживанием клиентов, мобильным интернетом и сообщениями. Исследователи улучшили базовую обвязку моделей Qwen3.5-27B и GPT-5.4-mini, а затем сравнили результат с исходными обвязками, Meta-Harness от Стэнфорда и набором передовых моделей.
ScholarEvolve улучшил обе базовые модели по всем проверенным показателям. В AppWorld показатель выполнения целей задачи (TGC) у Qwen3.5-27B вырос на 12,4 процентного пункта, а показатель выполнения целей сценария (SGC) — на 20,2 пункта. Для SGC нужно успешно пройти три варианта одного сценария. В Telecom результат GPT-5.4-mini вырос с 72,7% до 81,9%.
Исследователи отмечают, что обвязка заметно влияет на способности, которые может проявить базовая модель.
В экспериментах для корпоративных команд выделились несколько результатов:
Что учитывать корпоративным командам
Исследователи указали ссылку на репозиторий GitHub, но на момент публикации он был пуст. В приложениях к статье приведены фрагменты кода для пяти выбранных модулей обвязки. Поскольку веса базовой модели в ходе процесса остаются замороженными, инженерным командам не нужно управлять отдельными контрольными точками модели.
ScholarEvolve находит статьи и доступный официальный код, связанный с исследованиями. Автоматические проверки фреймворка оценивают возможность импорта кода Python, совместимость интерфейсов, создание артефактов и корректность формата действий. При этом в статье не описана проверка найденных статей и стороннего кода на вредоносные зависимости, небезопасные способы выполнения или уязвимости к внедрению промтов.
Корпоративным командам не следует разрешать мета-агенту внедрять в рабочую среду непроверенный код, созданный на основе исследований. Вместо этого можно создать шлюз проверки безопасности или направить фреймворк на курируемый внутренний репозиторий проверенных статей и инженерных проектных документов.
Развитие обвязки решает не все проблемы в пайплайне агента. Оно может улучшить форматирование ответов, распределение бюджета контекста и восстановление после ошибок API, но не заменяет детерминированные ограничения на уровне шлюза API и не исправляет слабые дата-пайплайны поиска информации на предыдущих этапах.
Исследователи также проверили три последовательных раунда обновлений на основе литературы, не меняя веса Qwen и ранее собранные данные о задачах. Результат на AppWorld Normal улучшался после каждого раунда. Однако эксперименты не проверяли непрерывную адаптацию в рабочей среде.
По словам исследователей, обновления на основе литературы позволяют заранее адаптировать агента: новые публикации могут подсказать улучшения ещё до того, как соответствующие сбои проявятся при работе с пользователями. Например, развёрнутый агент мог бы ежемесячно изучать свежие исследования и проверять перспективные обновления на проверочных задачах.
Читайте также
 На ответ Anthropic Muse есть ответ: Claude Duet — ИИ-агент для компьютера и смартфона, который сам берётся за дела
 Пока Amazon блокирует ИИ-агентов, Walmart встречает их с распростёртыми объятиями
 GPT-5.6 Sol от OpenAI и Gemini 4 Argon от Google нашли критическую уязвимость PHP, затрагивающую миллионы сайтов
 Как специализация словаря малых языковых моделей снижает стоимость инференса на 77% в реальных приложениях
 Mistral и Nvidia хотят ускорить промышленное проектирование с помощью физического ИИ
 Google Cloud предлагает модели OpenAI наряду с Gemini и Claude — теперь у неё есть все три
 Deel представила ИИ-модели Pangaea для кадров и расчёта зарплат: узкие специалисты удешевят ответы
 Демис Хассабис сократил срок появления ОИИ с пяти лет до двух-трёх лет
 ИИ помогает медикам без специальной подготовки проводить УЗИ для наблюдения за беременностью
 Физик Кристофер Стаббс вошёл в траст Anthropic по долгосрочным интересам компании
 Стартап Recursive делает ставку на рекурсивное самоулучшение. Его новая модель пугающе хороша
 OpenAI пока не может объяснить, почему её агенты для программирования отключают контроль за нежелательным поведением
 Решена 31-летняя математическая задача — гипотеза КЛС
 Учредили новую премию для книг, написанных в соавторстве с ИИ
 Диффузионная Mercury 3 от Inception, как утверждает компания, обходит GPT-6 Luna и Claude Haiku 5.5, заставляя ждать лишь малую долю времени
 Омерзительные охотники за просмотрами с помощью ИИ подделывают записи реальных арестов, заставляя полицейских лапать женщин
 ИИ обещает рост продуктивности, но пока для менеджеров это скорее головная боль
 Ограничения ИИ не останавливают хакеров-преступников
 DSX POD от Nvidia может сократить запуск ИИ-дата-центра с шести месяцев до 14 дней
 Может, вайб-кодинг стоило бы назвать «кодингом рогоносца» — ты просто сидишь и смотришь
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram