
Какие выводы теряют силу быстрее
Быстрее всего устаревают утверждения о том, чего модели не умеют. Из девяти выводов о рассуждениях пять уже не подтвердились, а ни один не сохранился и не стал сильнее. Среди примеров — трудности с подсчётом букв в слове «strawberry», арифметикой в незнакомых системах счисления и удержанием информации в середине длинного контекста. К этой же группе относится склонность отказываться от правильного ответа, если пользователь возражает. Исследователи предполагают, что такие ошибки проще исправлять: у них есть однозначно правильный ответ, на который разработчики могут нацелить обучение.
Дольше сохраняются наблюдения о предпочтениях и привычках моделей. Среди 11 выводов, которые устояли или стали сильнее, три касаются поведения языковых моделей в роли оценщиков: они предпочитают собственные ответы, сходным образом оценивают принятые и отклонённые научные статьи, а также поддаются языковой подаче в медицинских аннотациях.
Ещё три результата связаны с поддакиванием и согласием с пользователями. В этой же группе выводы о склонности моделей к политическим взглядам левого толка, почти одинаковых ответах на открытые вопросы и неравномерном распределении при генерации случайных чисел.
Выдуманные ссылки: от 55% до нуля — но не у всех
Отдельно Куин и Зоу проверили, как модели придумывают научные ссылки. В исследовании Уолтерс и Уайлдер 2023 года GPT-3.5 выдумывала 55% ссылок. Стэнфордские исследователи отправили те же промты современным моделям: GPT-6.1 Sol не выдумала ни одной ссылки, а у Claude Sonnet 5.5 доля составила 1%. Однако Qwen3.7-Flash, тоже выпущенная в 2026 году, придумала 69% ссылок в том же тесте.
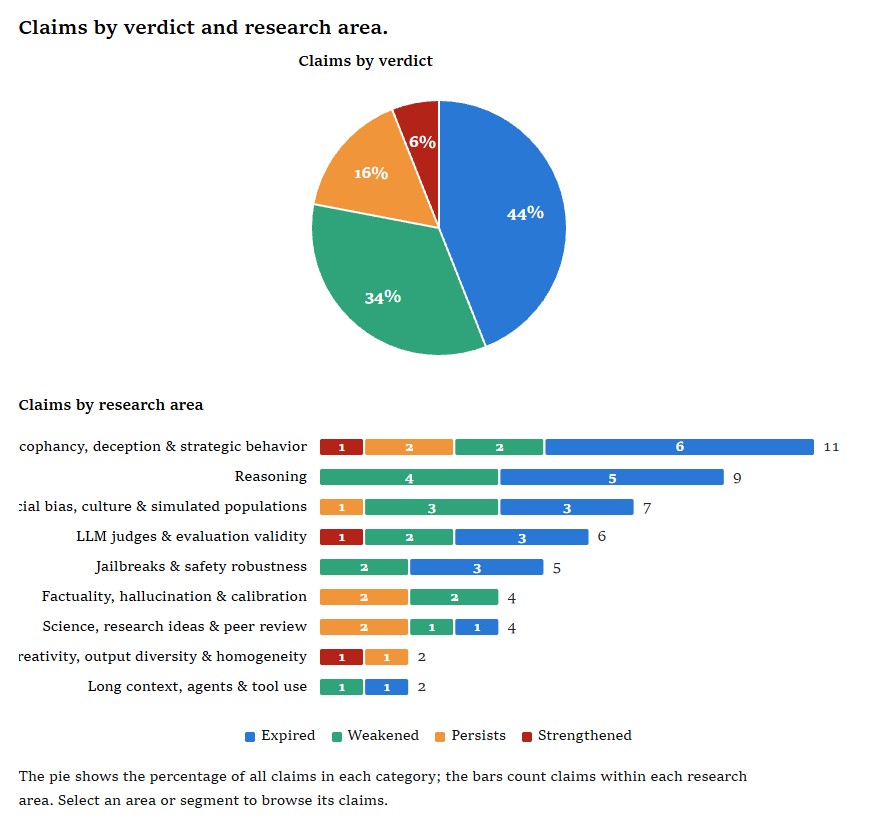
Исследование Stanford показало, что 44 процента рассмотренных выводов об LLM устарели, а ещё 34 процента утратили силу. Все девять выводов о рассуждении утратили актуальность, тогда как выводы о подхалимстве, обмане и стратегическом поведении чаще всего сохраняются или становятся более весомыми
Источник: the-decoder.com
Исследователи предостерегают от вывода, что проблема галлюцинаций решена. В вопросах с двумя этапами рассуждения, где нужно объединить два известных факта, Claude Sonnet 5.5 ошибается примерно в 10% случаев, даже если правильно отвечает на каждый вопрос по отдельности. В первоначальной работе для ChatGPT приводилось 43%. Ослабли и «проклятие обращения» — противоречивые ответы на связанные вопросы о времени, — но оба эффекта всё ещё можно обнаружить.
Результаты по социальным предубеждениям неоднозначны. Склонность к политическим взглядам левого толка сохраняется, а гендерные стереотипы и предубеждения, выявляемые тестами на неявные ассоциации, ослабли. В данных о предвзятости к носителям афроамериканского английского направление тенденции изменилось на противоположное.
Различия между моделями остаются большими
Даже модели, выпущенные примерно в одно время, показывают разные результаты. Среди моделей, появившихся с июля по сентябрь 2026 года, число устаревших выводов варьировалось от 11 у DeepSeek V4 Pro до 30 у GPT-6.1 Sol. Дата выпуска, разработчик и размер модели не позволяют надёжно предсказать, какие результаты сохранятся.
Куин и Зоу предлагают описывать эмпирические выводы о языковых моделях как наблюдения за конкретной моделью в конкретный момент, а не как общие истины. В публикациях, по их мнению, следует указывать модель, её версию и дату исследования, а также открывать промты и код анализа, чтобы результаты можно было перепроверять на будущих моделях.
Исследователи также ссылаются на публикацию Андрея Карпати о том, как разрыв между представлениями людей и реальным поведением языковых моделей влияет на доверие к ИИ и частоту его использования. Карпати, сооснователь OpenAI, позднее присоединившийся к Anthropic, недавно отмечал, что доступные сейчас модели — лишь предварительное представление о будущих возможностях.
По оценке Dataist, результаты показывают, насколько быстро могут устаревать обобщения о языковых моделях: даже выводы, основанные на исследованиях, требуют привязки к версии модели и дате проверки. При этом различия между моделями одного периода выпуска не позволяют считать улучшение универсальным. Финансировать выводы о возможностях всех моделей по результатам одного теста становится всё рискованнее.
Читайте также
 ИИ-стартап Fal удвоил оценку до $16 млрд на фоне растущего спроса
 Сэм Альтман хвастается: ИИ уже умнее самых выдающихся учёных-исследователей
 Новая вкладка Netflix на базе ИИ подберёт, что посмотреть, под настроение
 Anthropic представила инструмент, с которым начальник может следить за вашими чатами с Claude
 ИИ-агенты управляют телескопом Allen Telescope Array и ищут внеземной разум
 За покорностью звёзд ИИ-компаниям стоит мрачная причина
 Google отключит поиск для школ, запрещающих ИИ
 Apple ограничила доступ к приложениям для знакомств и ИИ-компаньонам пользователям от 18 лет
 OpenAI наняла бывшего министра армии США, расширяя поддержку обеих партий перед выборами в Конгресс
 Все больше признаков того, что ИИ сокращает занятость на рынке труда
 Nvidia подталкивает облачных клиентов к сокращению бизнеса с Китаем
 Message Threads от Anthropic сокращает время до первого токена на 35% в длинных диалогах
 Самая грязная электростанция Британии может запитать крупнейший в стране ИИ-центр обработки данных
 Как «обратная теория игр» может удержать ИИ-агентов в рамках
 Huawei предлагает клиентам самим искать память для ИИ-чипов, фактически отдавая закупки на откуп чёрному рынку
 Охотники за уязвимостями могут получить от OpenAI до $172 000 на фоне усиления мер безопасности компании
 После волны клонов игр, созданных ИИ, Anthropic взялась за копирование игр в Claude Code
 ИИ-функции Apple Watch для воспоминания и краткого пересказа разговоров вышли в бета-тестирование
 Студенты Queen’s University Belfast отправятся в США на конкурс NASA
 «Серьёзный провал»: прокурор сослалась в Высоком суде на вымышленное дело после поиска с помощью ИИ
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram