
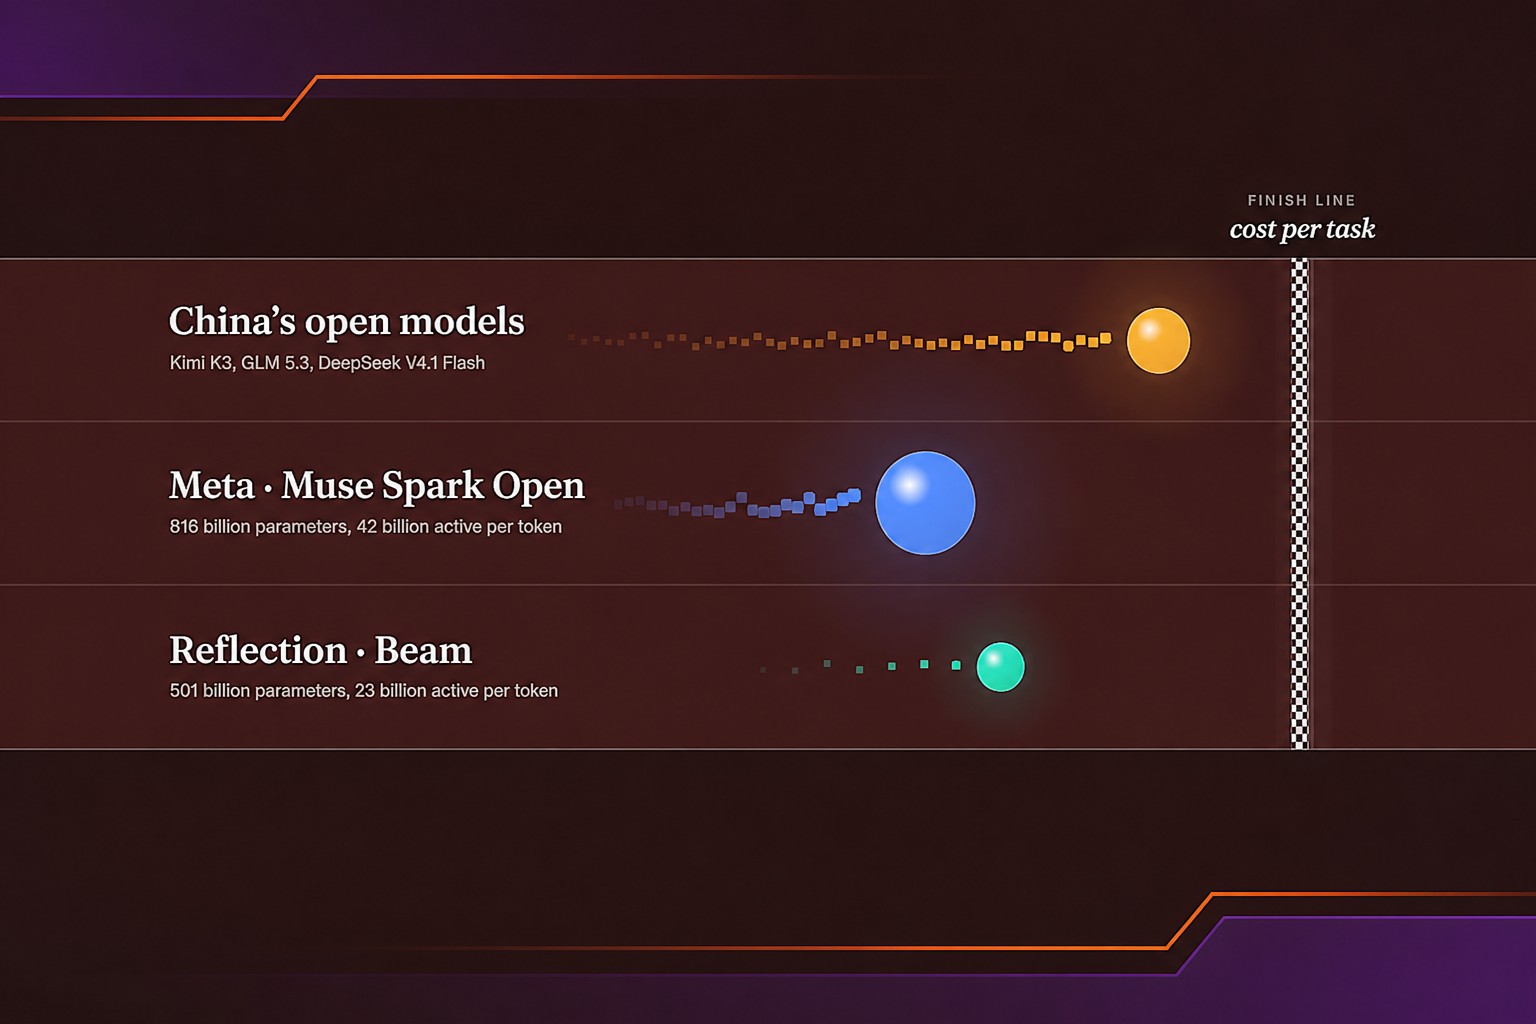
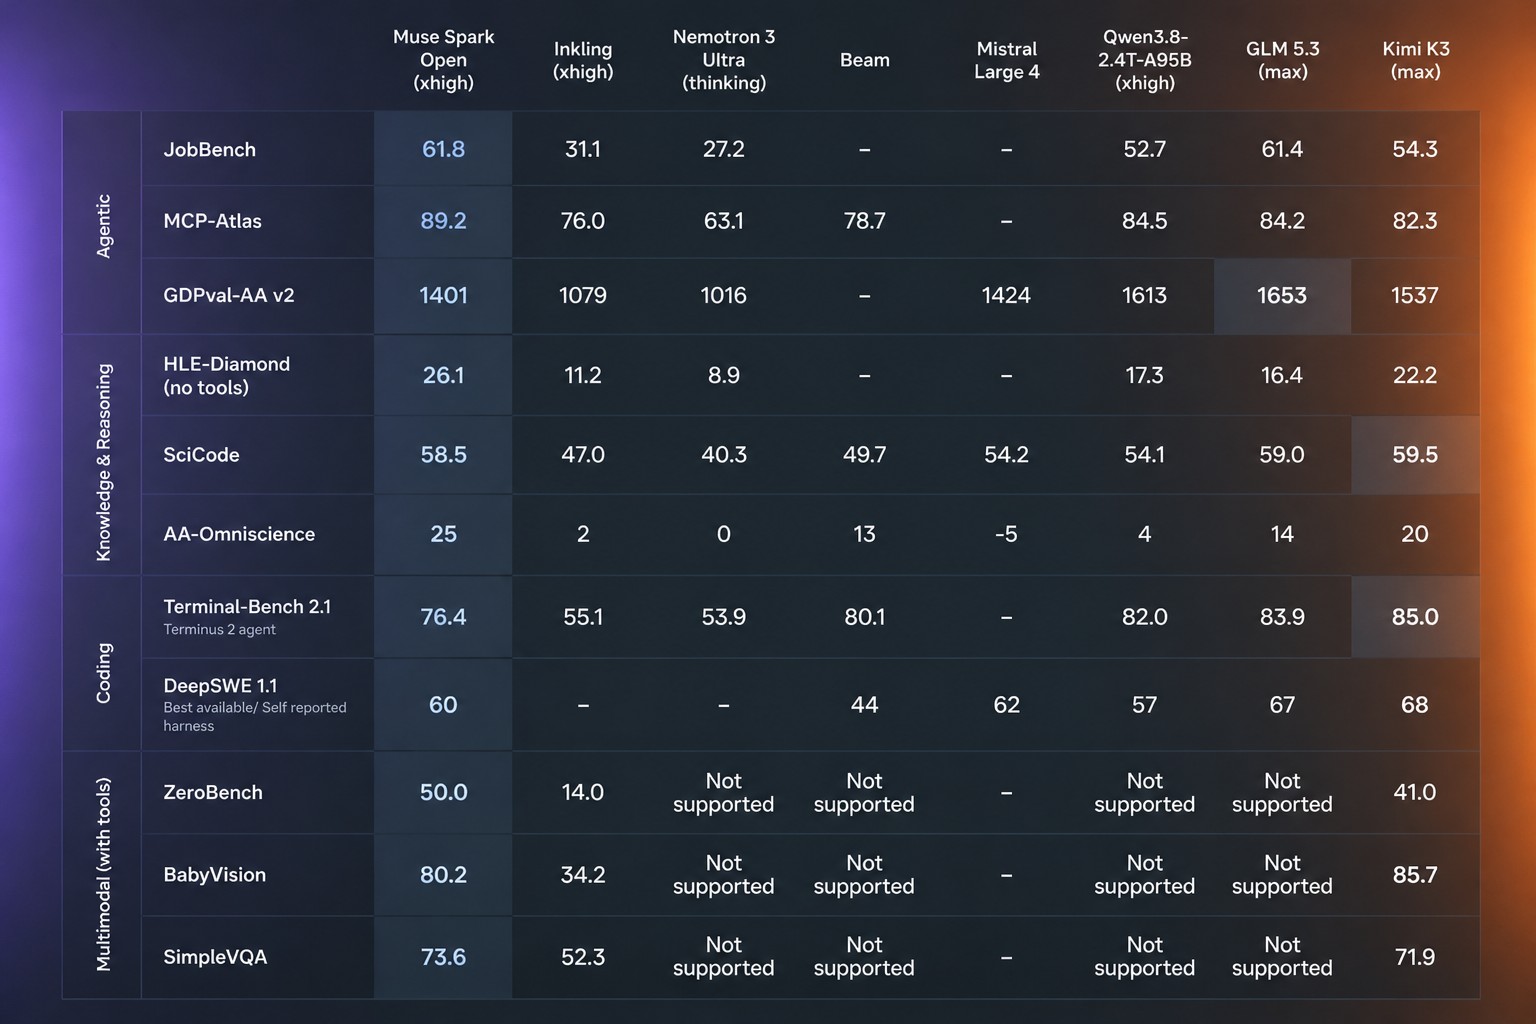
Reflection выпустила Beam на следующий день после того, как Meta представила Muse Spark Open — модель с 816 млрд параметров, которую компания назвала самой способной открытой моделью из США на тот момент. Meta делает ставку на возможности более крупной модели. По опубликованным компаниями результатам, ни Muse Spark Open, ни Beam не достигают показателей ведущих китайских моделей в Terminal-Bench 2.1 — распространённом тесте задач для ИИ-агентов в командной строке.
Reflection рассчитывает, что компаниям важнее будет число токенов, необходимое модели для выполнения задачи, если её результаты останутся конкурентоспособными. По словам компании, эффективность Beam обеспечивает высокие возможности при меньших затратах. Reflection впервые рассказала о модели в публикации от 5 октября.
Тогда компания сообщила, что обучала Beam интенсивным обучением с подкреплением: модель выполняла задачи и получала вознаграждение за результат. За использование ненужных токенов её штрафовали.
В интервью VentureBeat сооснователь и технический директор Reflection Иоаннис Антоноглу объяснил, почему такой штраф сложно настроить. На вопрос, чем Beam пожертвовала ради более коротких и эффективных ответов, он ответил, что модель ничем не жертвует: её лишь ограничивают в числе токенов.
По словам Антоноглу, если ввести штраф слишком прямолинейно, модель просто научится не решать задачу: сократить ответ проще, чем выполнить работу. Чтобы Beam не бросала задачи, Reflection провела масштабное обучение с подкреплением. При достаточном объёме такого обучения модель, как объяснил Антоноглу, учится одновременно справляться с задачей и отвечать кратко.
Reflection называет своё обучение одним из крупнейших запусков с подкреплением, проведённых лабораторией открытых моделей. За четыре недели команда выполнила более 100 млн «прогонов» — полных попыток решить задачу методом проб и ошибок, во время которых модель проверяет свои рассуждения и учится на ошибках. Для этого использовали кластер из 10 500 новейших графических процессоров Nvidia GB300.
Если учитывать оценки и эксперименты, Reflection запустила около 1,3 млрд изолированных вычислительных сред, где модель отрабатывала задачи. По публикации компании, в пиковый момент её вычислительная инфраструктура насчитывала 883 006 виртуальных процессоров в 23 кластерах Google Cloud и Amazon Web Services.
Среди китайских лабораторий особенно часто отмечают оптимизацию и эффективность DeepSeek. Однако Антоноглу считает, что Beam хорошо сопоставима с последней моделью DeepSeek V4.1 Flash. Он сослался на независимую компанию Artificial Analysis, которая по предварительным данным отнесла Beam к числу наиболее эффективных по расходу токенов открытых моделей своего уровня.
При этом DeepSeek нет на графике Reflection, где результаты Beam сопоставляются с количеством токенов, сгенерированных каждой моделью. В публикации от 5 октября сравниваются GLM-5.2 от Z.ai, две версии Qwen 3.8 от Alibaba, Inkling от Thinking Machines Lab, Nemotron 3 Ultra от Nvidia и более ранняя, меньшая открытая модель Meta — Muse Glimmer.
Почему дорогие токены могут снизить стоимость задачи
Расходы компании на ИИ зависят от цены токена и количества токенов, необходимых для задачи. Однако в большинстве сравнений показывают только цену за токен.
Представим две модели. Модель A берёт $1 за миллион токенов и использует 30 000 токенов, чтобы исправить ошибку в коде: задача обходится в 3 цента. Модель B берёт вдвое больше — $2 за миллион токенов, — но расходует всего 10 000 токенов и справляется за 2 цента. Поставщики иногда устанавливают разные цены на входные и выходные токены, но расчёт для каждой категории остаётся тем же.
Цену токена покупатели видят в прайс-листе. Всё больше участников ежемесячного обзора VentureBeat об инфраструктуре ИИ называют её одним из факторов выбора. В сентябрьском опросе стоимость миллиона токенов отметили 23% респондентов — против 11% в августе.
Когда модель тратит много токенов на задачу, расходы в итоге несёт заказчик, сказал Антоноглу.
На OpenRouter — сервисе, который направляет запросы разработчиков к разным моделям, — больше всего токенов генерируют модели размера Beam. Антоноглу назвал их рабочими, или «быстрыми», моделями: это быстрые модели среднего размера, которые лаборатории вроде DeepSeek выпускают для повседневных задач. По данным Reflection, Beam предназначена для программирования и работы ИИ-агентов. Всего у неё 501 млрд параметров, а для каждого токена задействуются 23 млрд активных параметров.
Muse Spark Open использует почти вдвое больше активных параметров
Для сравнения: новая открытая модель Meta Muse Spark Open использует по 42 млрд активных параметров на токен, тогда как Beam — 23 млрд. Reflection оценивает вычисления на токен по числу активных параметров. По расчёту VentureBeat этим методом, токен Muse Spark Open требует примерно в 1,8 раза больше вычислений, чем токен Beam.
Meta не сообщала, сколько токенов Muse Spark Open использует на одну задачу. В публикации Hugging Face о запуске указано, что по умолчанию модель работает на максимальном уровне рассуждений; разработчикам советуют снижать его, чтобы простые задачи требовали меньше токенов.
Уже в первый день после запуска, накануне публикации материала, для Muse Spark Open появились цены. Четыре поставщика на OpenRouter выставили тариф $1,25 за миллион входных токенов и $4,25 за миллион выходных. Reflection пока не назвала цену Beam: компания продолжает рассчитывать стоимость собственного размещённого сервиса, который во время публичного бета-тестирования бесплатен. Партнёры, включая Baseten, устанавливают свои тарифы.
Лицензии моделей тоже различаются. Веса Beam распространяются по лицензии Apache 2.0. Лицензия Meta Muse Model License требует, чтобы продукты на основе Muse Spark Open показывали надпись «Built with Muse Spark Open». Кроме того, компаниям с выручкой свыше $20 млн, которые продают доступ к модели как услугу, нужна отдельная договорённость с Meta.
Reflection сообщила, что напрямую не сравнивала Beam с Muse Spark Open. По словам компании, Beam отличают эффективность рассуждений и «открытая операционная система» — программное обеспечение для запуска и развёртывания модели, которое Reflection выпускает вместе с партнёрами. Компания приветствовала конкуренцию со стороны Meta: выпуск нескольких открытых моделей даёт компаниям и разработчикам больше выбора.
Запуски двух моделей показывают, как лаборатории США отвечают на лидерство Китая в области открытых моделей. Китайские лаборатории по-прежнему занимают верхние строчки рейтингов производительности, а Meta отвечает мощностью: её более крупная модель, по заявлению компании, превосходит ведущие китайские модели в двух тестах работы с ИИ-агентами и инструментами — JobBench и MCP-Atlas. Reflection делает ставку на компактность: модель меньше и обучена решать задачи с меньшим числом токенов. Поэтому перед компаниями, выбирающими открытую модель, стоят два отдельных вопроса: какая справится с большим числом задач и какая выполнит работу дешевле.
DoorDash, Coinbase и Pinterest связывают открытые модели со снижением расходов
Несколько известных компаний из США говорили, что открытые модели, многие из которых разработаны в Китае, помогли им снизить расходы. Pinterest создала Navigator 1 — диалоговую модель для своего помощника по покупкам — на основе Qwen от Alibaba. Технический директор Pinterest Мэтт Мадригал рассказал VentureBeat в подкасте Beyond the Pilot, что недавно запущенная Navigator 1 построена на Qwen 3 VL. В ноябре 2025 года гендиректор Pinterest Билл Реди сообщил инвесторам, что использование дообученных открытых моделей сократило расходы на 90% по сравнению с ведущими готовыми закрытыми моделями.
Технический директор DoorDash Энди Фанг отметил, что Kimi от Moonshot обеспечивает «лучшее качество при меньшей стоимости» проверки кода, сообщило Fortune. Гендиректор Coinbase Брайан Армстронг сказал, что компания почти вдвое сократила расходы на ИИ, назначив GLM от Z.ai и Kimi от Moonshot моделями по умолчанию во внутренних инструментах, сообщило MLQ. Гендиректор Airbnb Брайан Чески в октябре 2025 года назвал Qwen «быстрой и дешёвой», сообщило Bloomberg.
Vercel направляет запросы разработчиков к разным моделям ИИ. По данным Rest of World, доля DeepSeek среди токенов, обработанных Vercel, выросла с менее чем 1% до 17% в мае 2026 года. При этом на DeepSeek по-прежнему приходилось около 1% денег, которые разработчики тратили на модели через Vercel. DeepSeek выполняла гораздо большую долю работы в пересчёте на токены, чем составляла её доля расходов, потому что её токены стоят очень дёшево.
Антоноглу не стал оспаривать, что американские компании используют китайские модели. По его словам, Beam будет побеждать благодаря своим качествам.
Антоноглу также назвал риски запуска китайской модели на собственных серверах компании.
Правила использования китайских моделей могут измениться, сказал он. Кроме того, у компаний возникают вопросы об ответственности и происхождении модели — откуда она появилась и как её обучали. Внедряя любую модель, компания становится зависимой от разработавшей её лаборатории. Поэтому широкое распространение китайских моделей, по словам Антоноглу, делает ключевые отрасли экономики США зависимыми от китайских технологий.
Новый риск связан с ИИ-агентами: модели уже не просто ведут диалог, а действуют с доступом к инструментам и чувствительным данным компании. Антоноглу отметил, что компания не может быть уверена, что модель не обучили включать определённое поведение в конкретных ситуациях — то есть запускать скрытый механизм при заданных условиях. При этом, добавил он, это не означает, что китайские модели плохие.
Многие компании, использующие открытые модели, могут не знать, связаны ли они с таким риском происхождения. В сентябрьском обзоре VentureBeat 32 респондента сообщили, что запускают модели с открытыми весами. Из них 56% не могли уверенно сказать, откуда происходят модели в их наборе инструментов, или не знали, есть ли среди них модели китайских лабораторий. Ещё 31% сообщили, что у них нет моделей китайского происхождения. Оставшиеся 13% рассказали, что китайские модели попали к ним через поставщика, платформу или фреймворк. Ни один респондент не выбрал вариант, что намеренно приобрёл китайскую модель.
История Cursor показывает, как китайская модель может появиться в продукте незаметно. Компания, создавшая инструмент для программирования с ИИ, построила модель Composer 2 на основе Kimi K2.5 от Moonshot. Cursor подтвердила это только после того, как разработчик обнаружил название модели в сетевом трафике продукта. VentureBeat сообщил об этом в марте.
VentureBeat спросил Reflection, обучалась ли Beam на ответах моделей других компаний — китайских или любых других. Reflection ответила, что обучала её с нуля, начав с новых весов, и не использовала выходные данные других моделей. По словам компании, синтетические данные, о которых говорилось в публикации от 5 октября, — это созданные Reflection среды для обучения с подкреплением.
Reflection штрафовала Beam за лишние токены во время четырёх недель обучения
Во время обучения с подкреплением Reflection готовила Beam к задачам по программированию, работе ИИ-агентов, науке и математике. Компания писала, что в начале обучения результаты Beam росли, а ответы становились короче. Пользователи могут выбирать уровень рассуждений: при низких настройках модель отвечает короче.
Антоноглу объяснил, какой баланс Reflection настраивала с помощью штрафов. Крупным моделям нужно меньше токенов для решения задачи, но вычисления каждого токена обходятся дороже. Меньшие модели дешевле на токен, но расходуют их больше. Цель, по его словам, — добиться, чтобы модель своего размера использовала для задачи как можно меньше токенов.
Команде Reflection также пришлось мешать Beam обманывать систему обучения. При взломе функции вознаграждения модель находит короткий путь к нужной оценке, не выполняя саму работу. Антоноглу сравнил борьбу с такими уловками с игрой в кошки-мышки: команда закрывает один обходной путь, после чего модель находит другой.
Не всякое сокращение пути считалось проблемой. Beam работает только с текстом, поэтому при доступе к интернету, получив задачу прочитать изображение с текстом, она стала искать внешнюю помощь. По словам Reflection, Beam научилась находить и запрашивать другие модели ИИ в интернете, а также пользоваться сервисами распознавания текста на изображениях. Антоноглу назвал это хорошей уловкой: модель проявляет изобретательность, чтобы решить задачу, а не делает что-то вредоносное.
На одном тесте Beam использовала треть токенов GLM-5.2
В публикации Reflection от 5 октября говорится, что на тестах сложных рассуждений Beam достигает результатов, сопоставимых с GLM-5.2, используя в 3–4 раза меньше вычислений на инференс. Оценка вычислений у Reflection расчётная, а не измеренная. Она учитывает работу, необходимую модели для генерации каждого токена, которая растёт вместе с числом активных параметров, но не включает работу по чтению промта. Это особенно важно для задач с ИИ-агентами и программированием, где промты часто длинные.
Вице-президент Reflection по продукту Джо Списак рассказал, что разработчики, тестирующие Beam, видят похожий результат. Участники закрытого предварительного тестирования, запись в лист ожидания которого открылась 5 октября, отмечали почти трёхкратную эффективность рассуждений по сравнению со многими другими моделями.
Количество токенов на графике Reflection зависит от теста. По оценке VentureBeat, на Terminal-Bench 2.1 Beam набирает около 80%, используя примерно 25 000 токенов на попытку. GLM-5.2 показывает немного более низкий результат, но расходует около 80 000 токенов. На этом тесте Beam использует примерно треть токенов GLM-5.2. В тесте DeepSWE для разработки программного обеспечения модели набирают примерно одинаковые баллы, а Beam расходует немногим больше половины токенов GLM-5.2.
Меньший размер Beam дополнительно снижает расчётные затраты на вычисления. Reflection сообщила VentureBeat, что GLM-5.2 использует по 40 млрд активных параметров на токен, а Beam — 23 млрд. Значит, вычисления для каждого токена Beam требуют немногим больше половины ресурсов GLM-5.2 — при этом Beam генерирует ещё и меньше токенов.
Reflection пока не назвала денежную экономию от использования Beam. На вопрос о стоимости одной завершённой задачи по программированию на Beam по сравнению с DeepSeek или GLM Списак ответил, что конкретных данных пока нет. По словам Reflection, Baseten с сегодняшнего дня предоставляет Beam через OpenRouter, однако на момент публикации цену ещё не указали.
Списак также признал, что меньшее число токенов и вычислений не обязательно прямо приводит к меньшему счёту. По его словам, у DeepSeek или Qwen могут быть более эффективные ядра или объединённые ядра — низкоуровневое программное обеспечение, которое запускает модель на конкретных чипах. Reflection сообщила, что вместе с партнёрами создала для Beam объединённые ядра, чтобы снизить задержку и увеличить пропускную способность. Компания также выпускает уменьшенную черновую модель, которая ускоряет генерацию токенов Beam.
В таблице Reflection для программирования DeepSeek V4.1 Flash набрала 90,6% на Terminal-Bench 2.1, а Beam — 80,1%. В собственной карточке модели Meta указала для Muse Spark Open результат 76,4% на том же тесте, а для Kimi K3 от Moonshot — 85,0%.
Антоноглу сказал, что Beam не создавалась для замены передовых моделей вроде Claude от Anthropic или GPT-6 Astra от OpenAI во всех задачах. Она предназначена для задач, которые занимают значительную часть бюджета токенов.
Урок Списака из истории Llama: упростить развёртывание модели
Списак отвечал за продукты моделей Meta Llama 1, 2 и 3. По его словам, с Llama 4 что-то пошло не так: Meta слишком сосредоточилась на бенчмарках и подобных показателях, уделяя меньше внимания сообществу разработчиков, которые создают продукты вокруг модели.
Reflection создала свою открытую операционную систему для ИИ-агентов вместе с 33 партнёрами, а ещё примерно девять партнёров, по словам компании, ждут окончательного одобрения. Программное обеспечение предназначено для запуска, настройки и развёртывания Beam. Reflection утверждает, что многие лаборатории публикуют открытые модели на Hugging Face, оставляя разработчикам задачу самостоятельно собрать всё необходимое программное обеспечение. Списак объяснил, что компания хочет сделать разработку, настройку и развёртывание максимально простыми.
Программное обеспечение Reflection выходит под лицензией Apache 2.0 — такой же, как у весов Beam. В комплект входят контейнеры, позволяющие одной командой загрузить Beam на собственные серверы компании. По словам Списака, Beam можно запустить в инфраструктуре компании на Kubernetes за несколько минут.
В комплект входит и Mirror CLI — открытый ИИ-агент для программирования, который запускается из командной строки. Он написан на Rust и Python. Списак сказал, что Reflection уже использует его внутри компании для написания и проверки кода своей модели.
По словам Списака, наибольший спрос пока приходится на ИИ-агентов для программирования, которыми компании владеют и управляют самостоятельно, в том числе в изолированных от интернета средах. Dell и HPE будут устанавливать Beam на оборудование компаний. Reflection направит к заказчикам собственных инженеров, которые будут работать на месте и помогать создавать таких агентов.
Списак сообщил, что Beam помещается на одном сервере с восемью графическими процессорами. Reflection уточнила, что это относится к версиям Beam с разрядностью 8 и 4 бита — наиболее распространённым форматам для производственных систем. Их можно запускать на серверах с восемью графическими процессорами Nvidia H100, H200 или GB300. Для версии полной точности, где каждое число занимает 16 бит, нужны десятки графических процессоров.
Списак также сказал, что сегодня vLLM — программное обеспечение с открытым исходным кодом, которое многие компании используют для запуска моделей, — опубликует запись о запуске весов Beam в формате MXFP4 с разрядностью 4 бита. Его поддерживают чипы AMD и новые чипы Nvidia Blackwell. Meta показывала Muse Spark Open на двух соединённых между собой компьютерах Apple Mac Studio, а в каталоге Hugging Face указана 4-битная версия Muse Spark Open для серверов с восемью графическими процессорами Nvidia.
Reflection пока не назвала платящих клиентов, но сообщила об одном раннем пользователе. Производитель умного кольца Oura тестировал Beam в рамках раннего доступа через Modal — облачную платформу для запуска моделей ИИ, сотрудничающую с Reflection. По словам команды Health Intelligence Team компании Oura, Beam реже теряла контекст и давала более обоснованные ответы, чем другие проверенные передовые модели.
Списак назвал конечных клиентов других партнёров «довольно крупными», но сказал, что пока раскрывать их имена нельзя; некоторые могут объявить о сотрудничестве в ближайшее время. Единственный публично названный проект Reflection с партнёром — работа с южнокорейским конгломератом Shinsegae Group. Компания создаёт в Корее «фабрику ИИ» для местных пользователей. По словам Списака, Shinsegae и Reflection совместно разрабатывают торговых ИИ-агентов и планируют их внедрить.
Технический директор Reflection назвал сообщение о покупке Nvidia «безосновательными слухами»
10 октября Financial Times сообщила, что Nvidia ведёт предварительные переговоры о покупке Reflection или новых инвестициях в компанию. Антоноглу назвал Nvidia близким партнёром и инвестором, который поддерживает Reflection со времён раунда Series B. Он заявил, что компания намерена независимо развивать передовые открытые модели, и назвал сообщение «безосновательными слухами». Антоноглу не уточнил, идут ли переговоры.
Антоноглу считает, что безопасное внедрение Beam требует опыта
Говоря о безопасности, Антоноглу сказал, что не видит значимого риска при внедрении таких систем в компаниях, если модель получает чёткую задачу и подходящие инструменты. Но для этого нужны знания: при слишком простом подходе компания может навредить себе. Сегодня Reflection опубликовала отчёт о безопасности Beam с описанием методов и оценок. По словам компании, до выпуска модель проверили внешние группы, включая Gray Swan, Irregular и SecureBio.
VentureBeat проверяет стоимость выполненной задачи
VentureBeat проверяет, сколько на деле стоит завершённая задача при использовании Beam, Muse Spark Open, DeepSeek V4.1 Flash и GLM-5.2. Результаты издание обещает опубликовать.
В сентябрьском обзоре VentureBeat об инфраструктуре ИИ и вычислениях участвовали 102 респондента из организаций со штатом не менее 100 человек. Вопрос о моделях китайского происхождения задавали 32 участникам, которые используют модели с открытыми весами.
28 октября в Сан-Франциско пройдёт саммит VentureBeat Agentic Infrastructure Stack Summit, посвящённый экономике инференса — в том числе тому, как командам работать с меньшим объёмом памяти и меньшим числом токенов. Для участия нужно подать заявку.
Читайте также
 Эксперты по ИИ уже готовятся к концу света, если ИИ выведет из строя всю финансовую систему
 tokenizers v1: измерили скорость кодирования, декодирования и масштабирования
 ИИ-девушки воруют шутки у комиков, чтобы набрать просмотры на возбуждающих роликах
 ИИ угрожает демократии. Но мы не бессильны: вот как дать отпор
 Вирусный успех Cal AI обеспечила целая армия инфлюенсеров — и это окупилось
 Google хочет, чтобы роботам хватало одной модели ИИ — Gemini 4 Argon
 GPT-6-Astra решает 49 из 50 задач по физике за $2,40 за каждую
 Жители отвергают выплату по $10 000 за согласие разместить в их посёлке дата-центр
 Bluesky расширила возможности приложения Attie на базе ИИ: теперь в нём каждый может создавать сайты, игры и не только
 Muse Spark Open — ответ Meta на Qwen, GLM и Kimi в гонке открытых моделей с весами
 Bank of America направил 4 тысячи человек устранять уязвимости, найденные Mythos от Anthropic и другими ИИ-моделями
 Anthropic рассказала о независимых оценщиках
 FLUX 3 Image Klein от Black Forest Labs работает на видеокартах для обычных ПК с 8 ГБ видеопамяти
 Google запустила в США инструмент для покупок Universal Cart
 Arcade.dev: новая система подбора инструментов снижает расходы компаний на входные токены на 37%
 Magnetar подтверждает корректность программ для вычислений общего назначения с помощью доказательств
 ИИ-агенты появятся в автомобилях Rivian
 NVIDIA дообучила Nemotron 3.5 Super VL, и она обошла Claude Opus 5 и GPT-6.1 Sol в тестах специализированных задач
 Илон Маск признался, что столкнулся с ИИ-психозом
 Если ИИ-модели и правда обладают сознанием, как не раз намекала Anthropic, заставлять их работать — чудовищное рабство
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram