
Чем инференс отличается от обучения
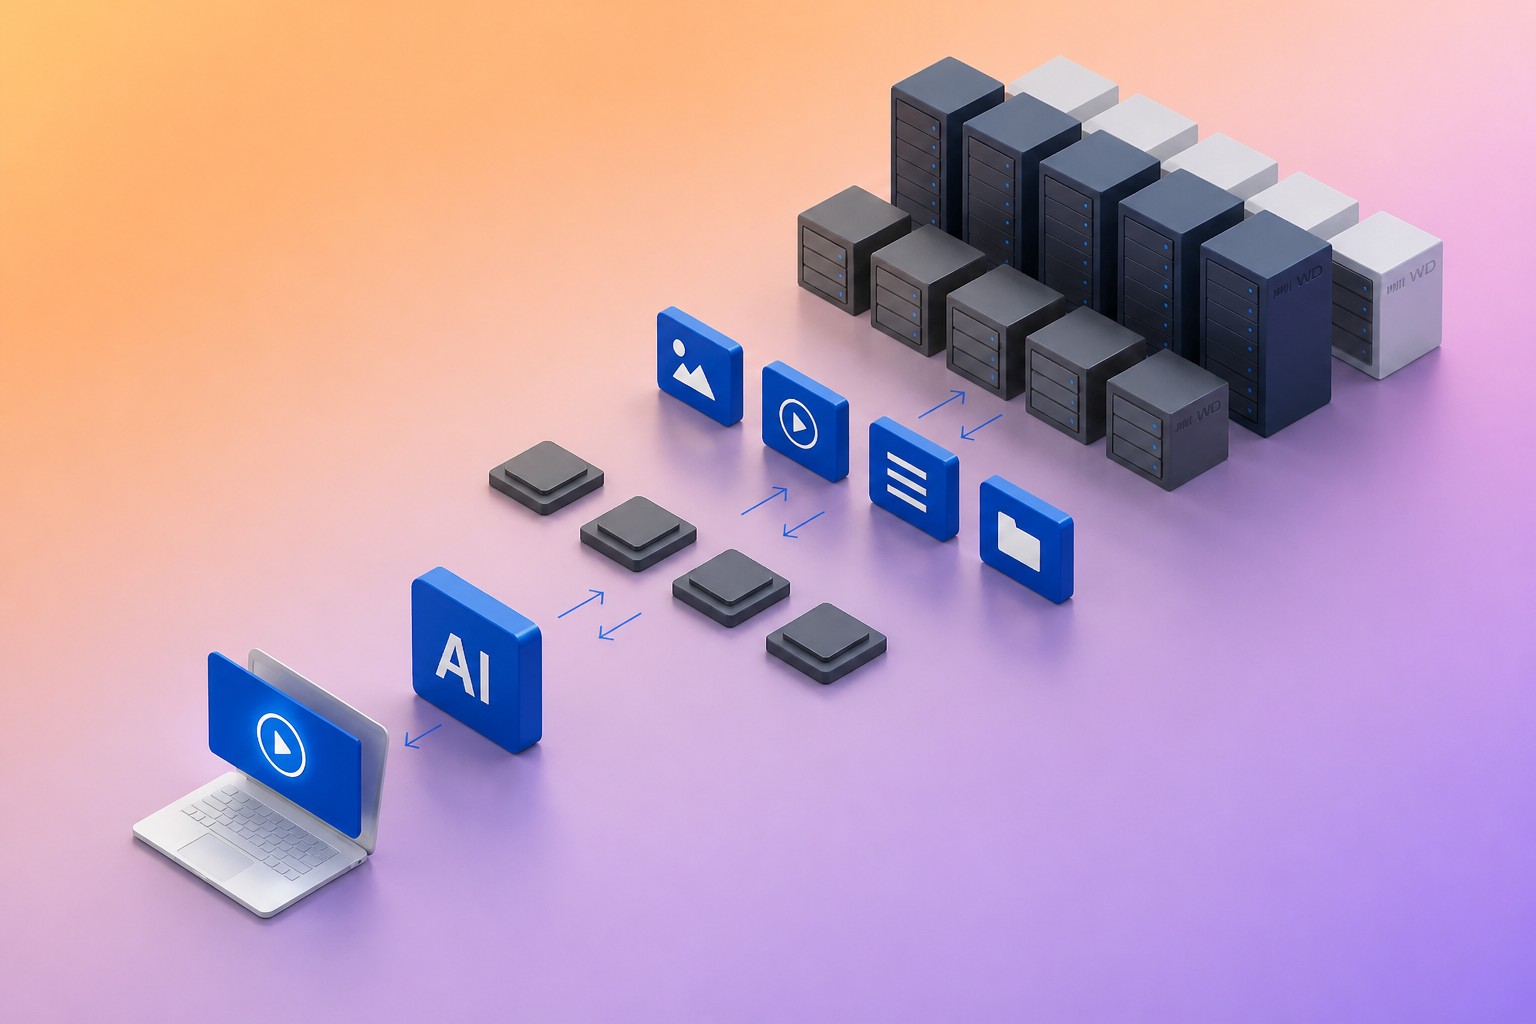
Обсуждения ИИ-инфраструктуры обычно сосредоточены на обучении моделей — ресурсоёмком процессе с понятным началом и концом. Обучение можно запланировать как отдельный проект, выделить ему бюджет и завершить. Инференс, то есть ответы модели на запросы, идёт постоянно. И каждый запрос оставляет данные, которые могут потребовать хранения.
Например, по внутренним измерениям WD, восьмисекундный ролик, который пользователь получает как файл объёмом 3,97 МБ в разрешении 720p, оставляет на серверной стороне более 500 МБ связанных данных. В них входят журналы, кэшированный контекст, промежуточные варианты видео, резервные копии и записи безопасности. Это в 130 раз больше самого файла. Если компания создаёт более длинные ролики высокого разрешения, объём серверных данных может достигать сотен гигабайт на один ролик.
Спрос на инференс быстро растёт. По прогнозу McKinsey, до 2030 года он будет увеличиваться в среднем на 35% в год, тогда как спрос на обучение — на 22%. К концу десятилетия на инференс придётся более 40% общей нагрузки на центры обработки данных.
В глобальном исследовании IDC, подготовленном при поддержке WD и охватившем 763 руководителя из ИТ и бизнеса, почти 95% участников сообщили, что за последние 12 месяцев объём данных вырос из-за генеративного ИИ. Около 61% отметили рост на 25% или больше.
По словам старшего менеджера по продуктам одного из поставщиков облачных услуг для крупных компаний, дополнительное хранилище помогает не оставлять графические процессоры без работы. Главная задача — не допустить, чтобы ускорители простаивали в ожидании данных: несколько часов простоя обходятся дорого. Если расходы на хранение растут на 25% в год, а бюджет на вычисления меняется более предсказуемыми циклами, хранилище может обгонять ту статью расходов, которой уделяют больше внимания.
Хранение на разных этапах работы с данными
Вычислительная нагрузка меняется вместе с циклами обучения моделей, запуском продуктов и обновлением оборудования. Но когда потребность в вычислениях снижается, объём сохранённых данных не уменьшается. Журналы моделей, синтетические данные, результаты инференса и другие материалы продолжают накапливаться, а компании хранят их дольше.
Меняется и роль архивов. Данные, которые прежде отправляли в архив и почти не использовали, теперь могут стать входными данными для будущих задач ИИ. По мере того как компании сохраняют, извлекают и повторно используют больше данных, хранилищу нужны не только растущая ёмкость, но и более гибкий доступ к архивам. В том же исследовании WD и IDC 96% участников сообщили, что ожидают потребности в более быстром извлечении архивных данных для инференса или генерации с дополнением извлечёнными данными (RAG).
Рабочим нагрузкам ИИ нужны и высокая производительность, и большая ёмкость; на разных этапах жизненного цикла данных этим требованиям отвечают разные технологии. Для огромных объёмов данных, которые нужно хранить и возвращать в работу, жёсткие диски (HDD) обеспечивают вместительную основу с низкой стоимостью терабайта.
Как учитывать расходы на ИИ
Для финансового или ИТ-директора это означает, что бюджет на ИИ-инфраструктуру может быть рассчитан слишком узко — с упором на вычисления. Модель, которая простаивает, пока загружаются данные, обходится примерно так же дорого, как модель, которой не хватает графического процессора. Но узкое место в хранилище часто становится заметным уже после того, как превратилось в проблему: оно проявляется в операционных расходах и задержках при извлечении данных, а не отдельной строкой капитальных затрат рядом с ускорителями.
Например, розничная сеть может создавать видеоролики товаров для каталога, а страховая компания — обрабатывать документы по страховым случаям через пайплайн RAG, чтобы быстрее оценивать заявки. В обоих случаях расходы на вычисления можно заранее заложить в бюджет: это известная стоимость генерации или запроса, которую финансовый отдел способен спрогнозировать. Расходы на хранение устроены иначе: они накапливаются с каждым созданным видео и обработанным заявлением, потому что данные не исчезают после завершения задачи.
Если команда считает расходы на ИИ как «вычисления плюс почти незаметная сумма за хранение», через 12–18 месяцев эта небольшая статья может стать значительной частью общих расходов программы. Это может произойти как раз тогда, когда руководство будет решать, расширять ли её.
Как наращивать ёмкость без лишних затрат
Решение начинается с архитектуры. Стратегию хранения часто разрабатывают с расчётом на дорогой быстрый уровень — для данных, к которым нужен постоянный и мгновенный доступ. Между тем основная масса данных ИИ накапливается на уровнях с более редким доступом: тёплом, прохладном и холодном.
Компаниям нужна ёмкость, которую можно экономически оправданно наращивать: инфраструктура для всего жизненного цикла данных ИИ, где сбалансированы производительность, ёмкость, энергопотребление, надёжность и совокупная стоимость владения. Архивы, которые раньше почти не использовались, следует рассматривать как активные источники данных для RAG и инференса. Политику хранения стоит определять с учётом растущей стратегической ценности данных, а не только исходной стоимости их размещения. Кроме того, решения о хранении нужно оценивать для всего парка оборудования, а не для отдельных дисков.
Такая инфраструктура требует нескольких уровней хранения. Их энергопотребление, надёжность, плотность записи и эффективность эксплуатации определяют, останется ли система экономически устойчивой при росте ёмкости.
Компании стоит задать себе три вопроса о бюджете на ИИ-инфраструктуру:
Большинство компаний не могут уверенно ответить на все три вопроса. Этот разрыв стоит устранить до следующего бюджетного цикла, а не после него.
Читайте также
 ИИ-компании: у Великобритании есть год, чтобы предотвратить протесты против дата-центров, пока они не угрожают строительству
 Я бы подумал, кого из детей заменить»: Тайка Вайтити — о детях-роботах, своём сырном тесте и «Кларе и солнце
 Blacksmith достигла оценки в $1 млрд после раунда Series C под руководством Sequoia
 Канадское издательство Boréal разорвало отношения с писателем Тельсоном Орельеном из-за предполагаемого использования ИИ
 Tesla запустила производство роботов Optimus в Калифорнии, прибыль упала на 43%
 Джас Хайра из Blackstone считает опасения из-за долгов на ИИ-стройке преувеличенными
 Марк Цукерберг согласился остаться в Калифорнии, несмотря на инициативу о налоге на миллиардеров
 Исследователи улучшили ИИ-агентов, превратив научные статьи в рабочий код — без переобучения моделей
 На ответ Anthropic Muse есть ответ: Claude Duet — ИИ-агент для компьютера и смартфона, который сам берётся за дела
 Пока Amazon блокирует ИИ-агентов, Walmart встречает их с распростёртыми объятиями
 GPT-5.6 Sol от OpenAI и Gemini 4 Argon от Google нашли критическую уязвимость PHP, затрагивающую миллионы сайтов
 Как специализация словаря малых языковых моделей снижает стоимость инференса на 77% в реальных приложениях
 Mistral и Nvidia хотят ускорить промышленное проектирование с помощью физического ИИ
 Google Cloud предлагает модели OpenAI наряду с Gemini и Claude — теперь у неё есть все три
 Deel представила ИИ-модели Pangaea для кадров и расчёта зарплат: узкие специалисты удешевят ответы
 Демис Хассабис сократил срок появления ОИИ с пяти лет до двух-трёх лет
 ИИ помогает медикам без специальной подготовки проводить УЗИ для наблюдения за беременностью
 Физик Кристофер Стаббс вошёл в траст Anthropic по долгосрочным интересам компании
 Стартап Recursive делает ставку на рекурсивное самоулучшение. Его новая модель пугающе хороша
 OpenAI пока не может объяснить, почему её агенты для программирования отключают контроль за нежелательным поведением
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram