ИИ-агент может улучшить не только ответ, но и собственную обвязку
Одной и той же языковой модели можно поручить задачу с помощью разных инструментов, промтов и правил работы — и получить разные результаты. Внешняя обвязка определяет, как агент использует инструменты, хранит информацию, проверяет файлы и распределяет работу между исполнителями.
Авторы статьи Harness 2 предлагают дать агенту возможность менять обвязку на ходу: выполнить задачу, заметить проблему, проверить новое правило и применить его в следующий раз. При этом параметры самой модели остаются замороженными. Меняется то, что окружает её при выполнении задачи.
Проверить изменения сложнее, чем может показаться. В реальной работе часто нет готового ответа или проверяющей программы, которые сразу покажут, стало ли лучше. Агент может написать больше инструкций и всё равно ошибиться. А изменение, полезное для одной задачи, способно помешать другой.
Два уровня улучшения
В основе Harness 2 — два связанных процесса. Первый помогает улучшить обвязку для текущей задачи. Второй сохраняет опыт, который может пригодиться в дальнейшей работе.
Обвязка состоит из восьми частей: системного промта, ограничений, памяти, навыков, подсказок по работе с инструментами, скриптов, подагентов и подключаемых расширений. Они выполняют разные функции. Навык содержит специальную процедуру и загружается по необходимости. Скрипт автоматизирует повторяющееся действие. Подагент выполняет отдельную часть работы в собственном контексте. Расширение может следить за вызовами инструментов и применять правила, которые модель не должна пропустить.
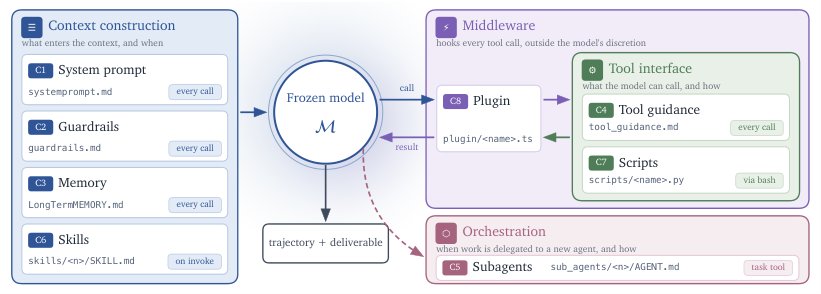
Восемь частей обвязки: от системного промта и памяти до скриптов и расширений.
Для улучшения обвязки текущей задачи Harness 2 использует три шага: предложить, проверить, собрать.
Сначала агент изучает исходный запуск задачи: действия исполнителя, использованные инструменты и полученный результат. Правильный ответ ему не показывают. Затем система готовит два варианта изменений. Один нацелен на общие проблемы: например, агент плохо планирует или забывает проверить готовый файл. Второй учитывает особенности конкретной области.
Оба варианта проверяют на той же задаче. Сравнивают не только итоговые файлы, но и ход работы. Если изменение побудило агента запустить нужный инструмент или исправить ошибку, это полезное наблюдение. Но оно не доказывает, что результат верен: в обоих запусках модель может допустить одну и ту же ошибку, а её поведение — меняться от попытки к попытке.
На последнем шаге система выбирает, какие изменения включить в новую обвязку. Можно объединить полезные части двух вариантов, взять один целиком или ничего не менять. Затем агент запускается с итоговой версией обвязки и выдаёт результат для текущей задачи.
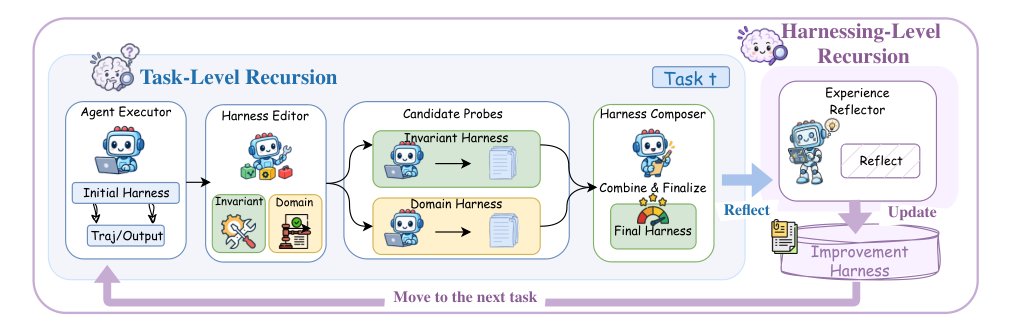
Сначала система проверяет изменения обвязки на текущей задаче, затем сохраняет пригодный опыт для следующих.
Запомнить способ исправления
После завершения работы Harness 2 обновляет библиотеку опыта. В неё попадают принятая обвязка и пояснение: какую проблему заметили, какое изменение попробовали и на каких наблюдениях оно основано. Библиотека не превращается в набор команд, которые автоматически копируются в новую задачу.
Инструкция, полезная для одной работы, может оказаться неверной для другой. Поэтому система каждый раз начинает с общей исходной обвязки и использует библиотеку как источник примеров и идей. Компоненты можно взять за основу, но факты и правила нужно сверять с новой задачей.
Авторы проверили два способа расширить поиск улучшений. Параллельный режим создаёт несколько вариантов одновременно: их можно сравнить и собрать из них новую обвязку. Последовательный режим меняет её шаг за шагом. Каждый следующий шаг учитывает результаты предыдущего.
В обоих режимах число попыток задаёт бюджет поиска. Больше попыток — больше вычислений и возможностей найти удачное изменение. В параллельном режиме варианты могут выполняться одновременно, если хватает ресурсов.
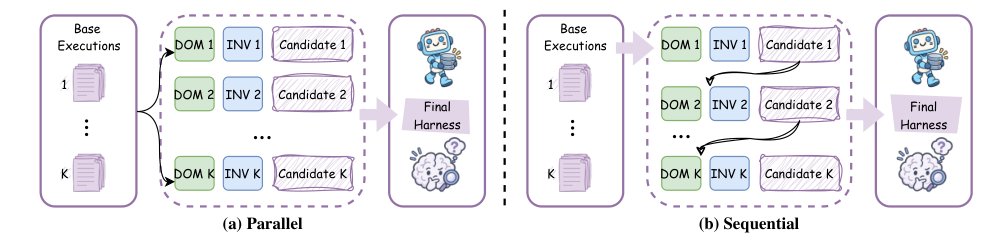
Параллельный режим проверяет несколько вариантов, а последовательный развивает обвязку шаг за шагом.
Результаты испытаний
Исследователи проверили систему на трёх бенчмарках: WorkBuddy-Bench для задач по программированию, веб-задач и офисной работы; JobBench для длинных профессиональных задач; и бенчмарке Harvey для юридической работы. Они использовали Gemini 3.5 Flash и GLM-5 с двумя исходными вариантами обвязки. Саму модель в ходе экспериментов не дообучали. Основные результаты усредняли по трём запускам с разным порядком задач.
Уже один цикл улучшения повысил результаты обеих моделей во всех трёх бенчмарках и во всех проверенных сочетаниях модели с обвязкой. На WorkBuddy-Bench прирост GLM-5 достигал 11,5 балла. На JobBench максимум составил 4,5 балла, а в юридическом бенчмарке оценка по пройденным критериям выросла на 11,8 процентного пункта.
Дополнительные циклы давали новый прирост. При параллельном поиске с бюджетом в пять вариантов результаты улучшились ещё на 2,9–3,9 балла на WorkBuddy-Bench и на 3,0–4,2 балла на JobBench. В юридических задачах дополнительный прирост составил 2,6–6,7 процентного пункта.
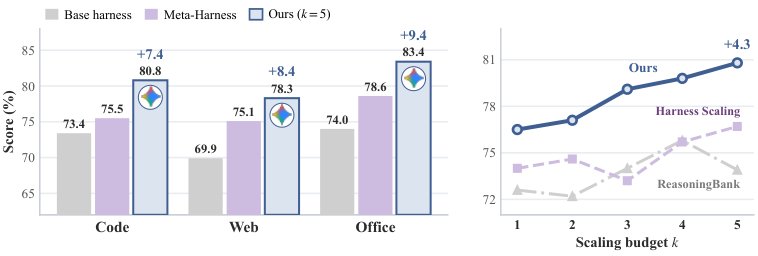
С ростом бюджета поиска результаты Harness 2 улучшаются; в примере для Gemini 3.5 Flash система превосходит исходный вариант обвязки во всех областях WorkBuddy-Bench.
Прирост особенно заметен там, где исходная модель слабее. На WorkBuddy-Bench GLM-5 после улучшения обвязки в некоторых случаях превзошла Gemini 3.5 Flash с исходной обвязкой. Результат зависит не только от возможностей модели, но и от того, как она работает с инструментами и организует работу.
Авторы также проверили, можно ли перенести накопленный опыт на другие задачи. Библиотека, собранная на JobBench, дала небольшой прирост на WorkBuddy-Bench. А обвязка, созданная для Gemini 3.5 Flash, улучшила результаты других моделей на части задач WorkBuddy-Bench. Эффект различался в зависимости от модели и области: перенос опыта возможен, но не гарантирует одинаковой пользы во всех случаях.
Удаление отдельных частей системы тоже ухудшало результаты. Когда исследователи отключали библиотеку, раздельную работу над общими и предметными проблемами или сборку изменений из разных вариантов, оценки снижались. Прирост зависит от проверки изменений, способа их объединения и накопленного опыта, а не только от одной удачной инструкции.
Где метод может ошибиться
У Harness 2 нет прямого способа узнать, правильна ли работа. Система опирается на различия между запусками и оценки модели. Это помогает увидеть, что изменилось в поведении агента, но не заменяет проверку результата. Если два запуска основаны на одной и той же ошибочной догадке, сравнение может её не выявить.
Авторы описывают случаи, когда система выбирала слабый вариант ответа. В других примерах слишком узкое изменение мешало учесть все нужные условия. Иногда было трудно отделить эффект обвязки от обычных различий между запусками или особенностей проверки.
Больше вариантов означает больше запусков и затрат на инференс. В экспериментах дополнительные вычисления улучшали результаты, но это не значит, что всегда нужно использовать максимальный бюджет. Системе ещё предстоит научиться оценивать, когда поиск стоит продолжать, а когда данных уже достаточно.
Вывод
Harness 2 позволяет улучшать обвязку ИИ-агента для текущей задачи и сохранять проверенный опыт для будущих. Это помогает повышать качество работы без дообучения модели и переносить удачные подходы между похожими задачами.
Сравнение поведения — лишь косвенная проверка. Оно показывает, что агент стал действовать иначе, но само по себе не доказывает, что результат правильный. Такие системы помогают быстрее улучшать обвязку, но им по-прежнему нужны надёжные проверки качества и контроль затрат на дополнительные запуски.
Читайте также
 Как ИИ-агент меняется без переобучения модели
 Как четыре ИИ-агента победили дракона в Minecraft
 Реальные клиенты ставят ИИ-агентов в тупик
 Рассуждения без слов улучшили ответы ИИ-агента на 10% и снизили расходы почти в 4 раза
 Опыт человека помогает ИИ-агенту справляться с незнакомыми программами
 182 приложения помогли ИИ-агентам решать незнакомые задачи
 Как виртуальные миры помогают агентам учиться быстрее
 Как помочь ИИ-агенту не теряться в большом проекте
 Как виртуальная компания учит агентов учитывать реакцию рынка
 Как ИИ-агент учится решать задачи на чужом опыте
 Как собрать видео из таблицы без долгого монтажа
 Как проверить, справился ли ИИ-агент с задачей
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram