Модель учится на задачах, которые решила сама
Один и тот же ИИ может провалить задачу в одной обвязке и решить её в другой. Одна система помогает отслеживать шаги, другая позволяет продолжать работу после неудачной проверки, третья оставляет модели больше свободы. Если собрать успешные решения из разных обвязок и просто скормить модели, она может усвоить не сам способ решения, а чужие правила управления.
Авторы статьи предлагают Recursive Self-Rewrite — рекурсивное переписывание опыта. Сначала разные обвязки помогают модели находить решения. Затем она заново выполняет задачи в единой общей обвязке. Для обучения оставляют только проверенные результаты. Так полезные приёмы должны перейти от внешних инструментов к самой модели.
В опытах авторы использовали Qwen-3.8-27B и около трёх тысяч задач в командной строке: от разработки программ до науки и работы с данными. После переписывания число успешных траекторий выросло с 2 001 до 11 094. Дообученная на них модель стала лучше решать несколько тестов, в том числе сложные задачи с длинной последовательностью действий.
Почему одной обвязки мало
Обвязка определяет, как модель взаимодействует с инструментами: что видит, как сохраняет ход работы, когда проверяет результат и что делает после ошибки. Это похоже на разницу между работой без плана и работой с контрольным списком: исполнитель тот же, но организовать действия ему помогают по-разному.
Авторы сравнили три обвязки. Terminus 2 предлагает общий цикл работы с командной строкой. StateM хранит состояние задачи и проверяет переходы между шагами. Recursive Self-Reflect Terminus (RSRT) запускает проверку результата и, если она не пройдена, просит модель продолжить работу.
На первый взгляд, достаточно взять все успешные попытки из этих систем и использовать их для обучения. Но такие попытки могут содержать подсказки и управляющие действия, доступные только внутри исходной обвязки. Если модель привыкнет полагаться на них, при работе без этой поддержки она может начать повторять ходы по кругу или останавливаться раньше времени.
Задача авторов — сохранить полезный опыт, убрав зависимость от конкретной обвязки.
Что такое переписывание опыта
Процесс состоит из трёх ролей. Их выполняет одна и та же базовая модель.
Сначала планировщик изучает успешную попытку и составляет инструкцию — список ключевых шагов, проверок, возможных ошибок и способов исправить их. Инструкция должна описывать ход работы, но не выдавать готовый ответ.
Затем критик проверяет инструкцию. Он отсеивает варианты, которые раскрывают решение или используют сведения, недоступные из условия и среды. Наконец, исполнитель получает прошедшую проверку инструкцию и решает задачу заново — в чистой среде и под управлением общей обвязки Terminus 2.
В обучающую выборку попадает только новая попытка, которая прошла проверку. Саму инструкцию и переписку с критиком удаляют. На этапе применения модель должна справляться уже без них.
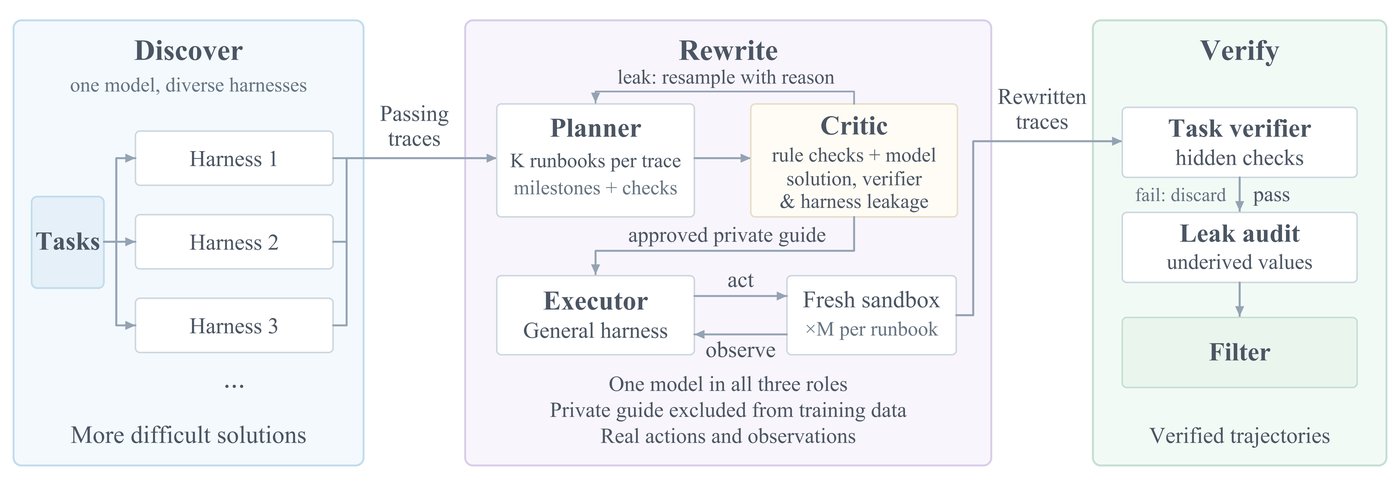
Разные обвязки находят успешные решения, а переписывание превращает их в проверенные примеры для общей обвязки.
Слово «рекурсивное» здесь описывает повторение цикла: модель создаёт несколько инструкций, проверяет их и пробует решить задачу заново. Авторы использовали до четырёх вариантов инструкции и до четырёх новых попыток для каждой успешной исходной траектории. Неудачные попытки тоже приносили пользу: результаты проверки помогали отбирать пригодные примеры для обучения.
Три обвязки находят разные решения
В общей выборке было 2 929 задач. Хотя бы одну из них решила каждая из трёх обвязок; вместе они справились с 759 задачами. Это на 34,3% больше, чем у лучшей отдельной обвязки в собранном наборе.
У каждой системы были и уникальные успехи. Terminus 2 решила 129 задач, которые не решили две другие обвязки. RSRT — 91 такую задачу, StateM — 68. Разнообразие приносило пользу не только за счёт дополнительных попыток: разные способы управления помогали модели справляться с разными задачами.
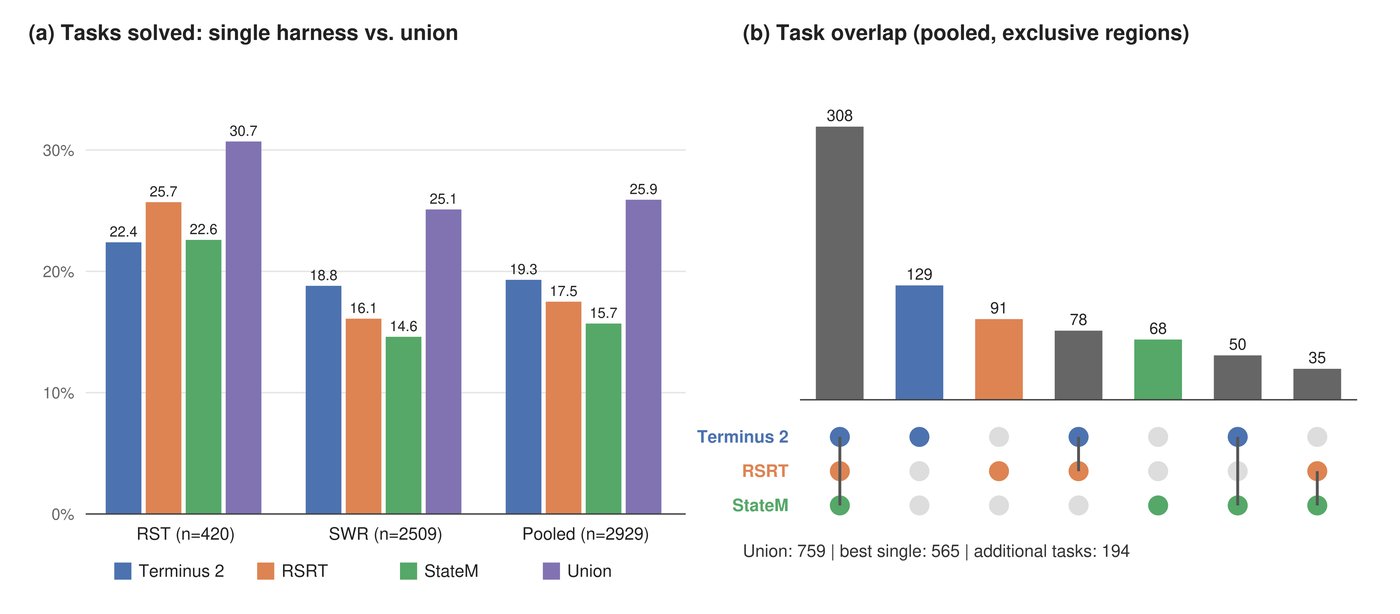
Области задач, решённых каждой обвязкой отдельно и в сочетании с другими.
У каждой обвязки был свой стиль работы. RSRT могла продолжать после неудачной проверки: в 4,5% успешных попыток первая версия ответа не прошла проверку, но модель исправила результат. StateM уделяла заметную часть команд управлению состоянием задачи. Terminus 2 чаще исследовала среду напрямую.
При этом больше шагов не всегда означают больше успехов. В выборке неудачных попыток RSRT работала в среднем 67,1 хода — втрое дольше Terminus 2 и StateM. Дополнительное время давало шанс исправить ошибку, но могло расходоваться и без результата.
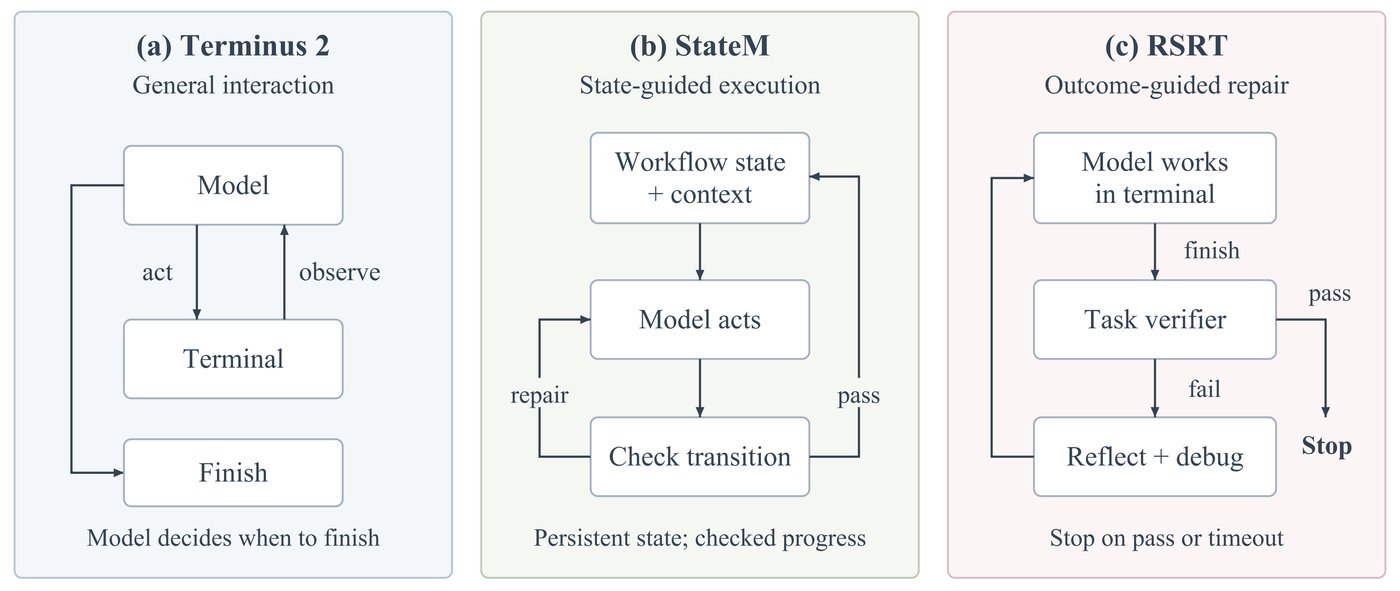
Обвязки поддерживают разные стратегии: общий цикл, явное управление шагами и продолжение после неудачной проверки.
Что дала повторная попытка
Из успешных исходных решений авторы получили 11 094 проверенные новые траектории. Это больше исходных 2 001 успешной попытки в пять с лишним раз. Но дополнительный объём сам по себе не гарантировал улучшения: важным оказалось то, что модель заново решала задачи в общей обвязке, а для обучения отбирали только успешные результаты.
После дообучения на переписанных траекториях модель обошла и базовую версию, и вариант, который учился на исходных попытках напрямую. Показатель pass@3 отражает, удалось ли решить задачу хотя бы в одной из трёх попыток. На Terminal-Bench 2 он вырос с 57% у базовой модели до 74,2%. На Terminal-Bench 4 — с 1,5% до 9,1%. На собственном наборе сложных задач авторов — с 39% до 63%.
На тесте задач по программному обеспечению результат поднялся с 3% до 6%. Прирост скромнее, но модель всё же решила вдвое больше задач из ста. В тесте на длинные последовательности действий выросла оценка прогресса по ходу работы: с 0,21 до 0,29. При этом полностью решить 46 задач этого теста не удалось ни одной из версий.
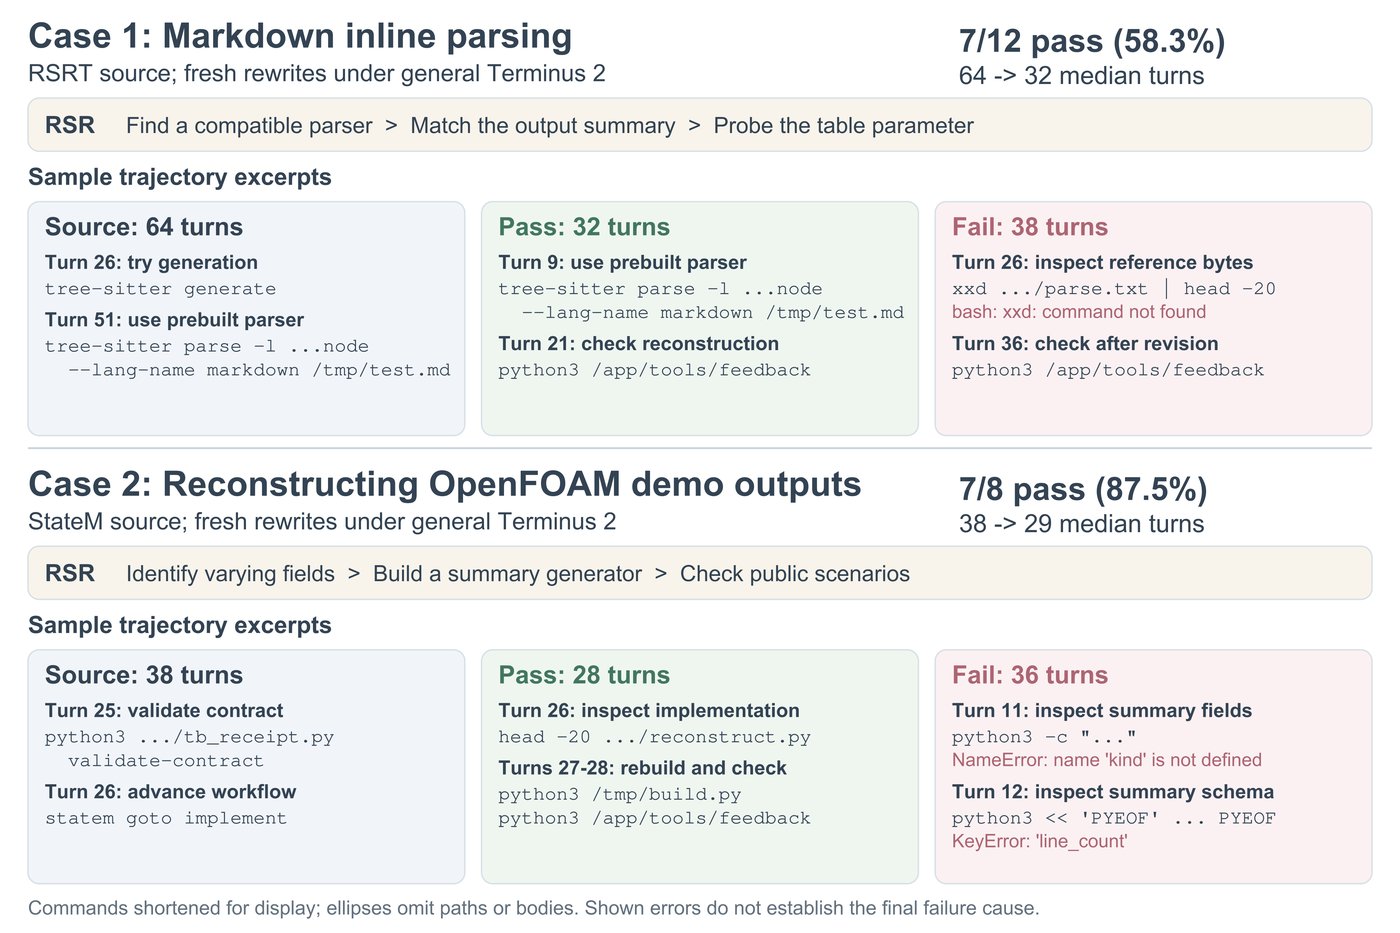
Повторные попытки под одной инструкцией могут быть и успешными, и неуспешными.
Сравнение с прямым обучением показывает, почему переписывание важно. Прямое обучение на исходных траекториях помогло на нескольких тестах, но на Terminal-Bench 2 результат упал с 57% до 53,4%. Авторы заметили в таких попытках повторяющиеся действия без заметного прогресса. Среди траекторий из RSRT были особенно длинные попытки, и модель могла усвоить их тупиковые привычки.
Переписанные траектории тоже не всегда удавались. В примере с разбором разметки Markdown прошли семь из двенадцати повторных попыток. В примере с задачей из OpenFOAM — семь из восьми. Та же инструкция могла привести и к успеху, и к провалу. Поэтому проверка результата остаётся обязательной: аккуратная инструкция не заменяет успешного выполнения.
Вывод
Результаты показывают, что обвязки могут служить не только способом помочь модели во время работы, но и источником учебного опыта. Разные системы находят разные решения, а повторное выполнение задачи помогает отделить переносимые приёмы от особенностей исходной обвязки.
Но результаты относятся к проведённым опытам. Работа посвящена задачам командной строки и одной базовой модели. Часть данных собрана на собственном наборе авторов, а процедура требует много дополнительных попыток: среди почти 12 900 повторных запусков успешными оказались 86%. К тому же успех по автоматической проверке сам по себе не гарантирует, что результат качественный во всех отношениях.
Модель можно обучать не только на ответах, которые она уже дала. Сильные внешние инструменты помогают найти решение; затем их поддержку убирают и просят модель решить задачу заново. Если повторная попытка проходит проверку, опыт становится ближе к тому, что модель должна уметь делать самостоятельно.
Читайте также
 Как собрать видео из таблицы без долгого монтажа
 Как проверить, справился ли ИИ-агент с задачей
 Можно ли автоматически собрать нужных ИИ-агентов по ходу работы
 Как тысяча ИИ-агентов работают вместе без начальника
 Как дать ИИ-агенту больше свободы с меньшим риском
 Как ИИ-агент подбирает прошлый опыт под новую задачу
 ИИ-судья сохраняет 99% точности за меньшие деньги
 Как самоулучшение ИИ-агента улучшает результаты и экономит токены
 Почему ИИ-агентам трудно работать с разными данными
 Как ИИ-агентам экономить контекст и избегать сбоев
 Как ИИ симулирует мысли пользователя
 Как ИИ-агенты восстанавливают приложения по их поведению
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram