Когда ИИ-агент учится на собственных ошибках
ИИ-агент может работать заметно лучше после изменения нескольких промтов, порядка вызова инструментов, памяти и правил управления контекстом. При этом веса самой модели останутся прежними.
Эта внешняя обвязка определяет, прочитает ли агент нужный файл перед правкой, заметит ли ошибку команды, восстановится ли после сбоя и успеет ли завершить длинную задачу. Поэтому автоматическое улучшение обвязки стало отдельным направлением исследований.
Но здесь есть ловушка. Если система много раз проверяет изменения на одном и том же наборе задач, она начинает подстраиваться под этот набор. Результат растёт на знакомых примерах, а на новых задачах исчезает.
Статья RRSI: «Регуляризованное рекурсивное самоулучшение обвязки» предлагает способ удержать такое самоулучшение от заучивания. Идея проста: разрешить менять любые части обвязки, но ограничить то, как система предлагает и принимает изменения.
Обвязка важнее, чем кажется
Авторы рассматривают ИИ-агента как связку из двух частей:
В обвязку входят:
Такая система похожа на программу, которую можно улучшать по результатам выполнения задач. Модель остаётся замороженной, а внешний слой постепенно меняется.
Обычный цикл выглядит так:
1. агент решает задачи из набора для развития;
2. другая модель анализирует ошибки и предлагает изменения;
3. новые версии обвязки запускаются на тех же задачах;
4. вариант с лучшим результатом становится новой версией.
Проблема возникает на шаге 3. Один и тот же набор используется снова и снова. Система получает множество попыток найти случайные закономерности, подсмотреть особенности формулировок и накопить специальные обходные решения.
Так появляется разрыв между результатом на знакомых задачах и переносом на новые.
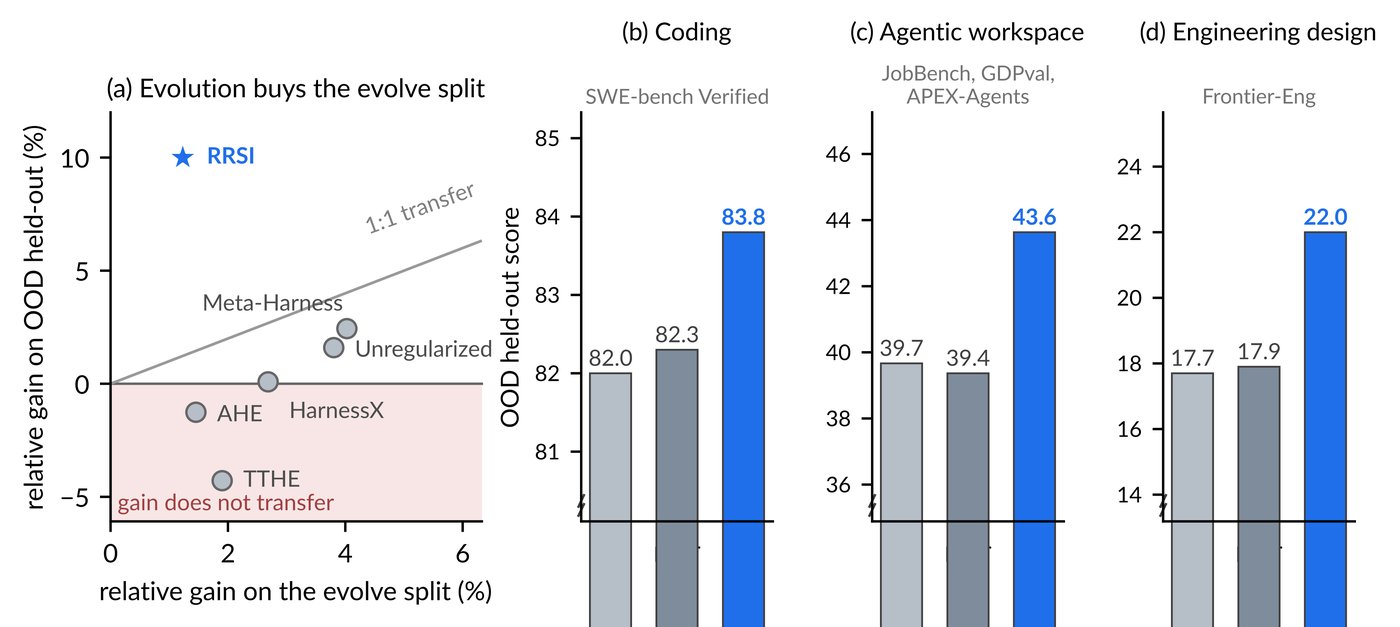
Сравнение обычной эволюции обвязки и RRSI: рост на знакомых задачах не гарантирует улучшения на новых.
На графике из статьи это видно особенно ясно. Обычные методы часто получают заметный прирост на наборе, где проходило развитие, но сохраняют лишь небольшую его часть за пределами этого набора. Некоторые варианты после развития работают даже хуже исходной обвязки.
Что такое RRSI
RRSI расшифровывается как регуляризованное рекурсивное самоулучшение обвязки. Здесь «регуляризация» означает набор ограничений, которые мешают системе запоминать обучающие задачи и бесконтрольно усложняться.
Авторы разделяют механизм на две части:
При этом пространство возможных правок остаётся открытым. Можно менять промты, порядок действий, память, инструменты и управление контекстом. RRSI не запрещает конкретные компоненты. Она ограничивает использование поискового бюджета.
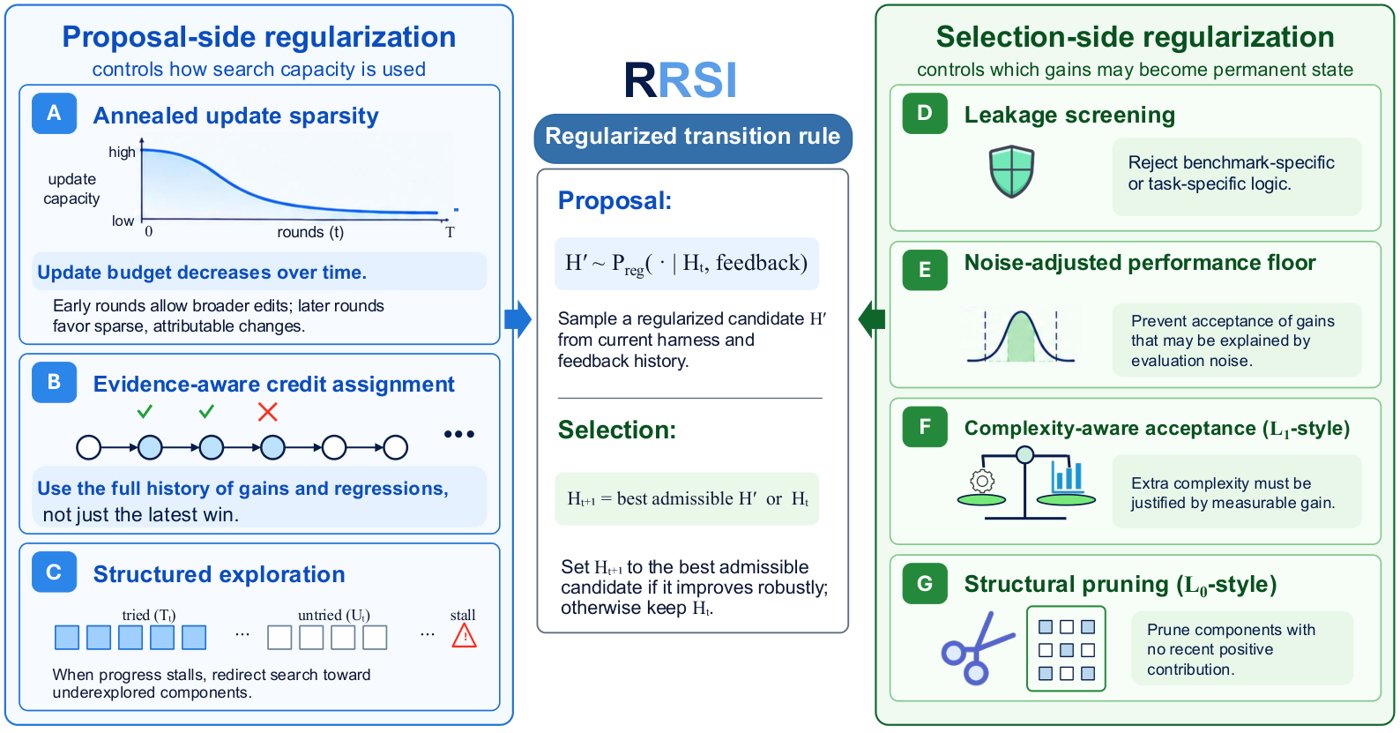
Схема RRSI: ограничения действуют и при предложении изменений, и при их окончательном выборе.
Предложение изменений
В начале поиска система может объединять несколько правок. Это помогает находить новые рабочие механизмы. Затем допустимое число изменений постепенно уменьшается.
В последних раундах кандидат обычно содержит одну небольшую правку. Так проще понять, что именно повлияло на результат.
RRSI также ведёт историю всех попыток. Для каждой правки записываются:
Если определённый подход уже несколько раз провалился, система получает это как отрицательное свидетельство. Она не должна бесконечно переписывать один и тот же промт в надежде на случайный успех.
Есть и механизм исследования. Если несколько раундов подряд не дают прироста выше уровня случайного шума, часть бюджета направляется на ещё не проверенные компоненты. Например, система может перестать менять инструкции и попробовать управление памятью или обработку ошибок инструментов.
Выбор изменений
Даже хороший результат на одном наборе ещё не доказывает, что правка полезна. Поэтому RRSI добавляет несколько фильтров.
Проверка на утечку. Критик отбрасывает изменения, которые прямо зашивают названия задач, конкретные значения, ответы или другие особенности набора для развития. Одновременно удаляется инертный код, который ничего не делает, но увеличивает сложность.
Защита от шума. До начала развития исходная обвязка несколько раз запускается на тех же задачах. Так оценивается естественный разброс результатов. Новая версия не может постепенно ухудшаться, если каждое маленькое ухудшение выглядит как случайное колебание.
Контроль стоимости. Дополнительные токены модели должны быть оправданы приростом качества. Если новая версия стала заметно дороже, но почти не улучшилась, её отклоняют.
Удаление бесполезных компонентов. Если компонент несколько раундов не даёт положительного эффекта, его предлагают удалить. Это важно: обычная эволюция умеет добавлять инструкции и процедуры, но редко получает стимул избавляться от накопившегося багажа.
Как проверяли метод
Авторы провели эксперименты в трёх областях:
Всего использовались восемь бенчмарков. Обвязка развивалась на одном наборе, а затем запускалась без изменений на других.
В задачах по программированию агент работал с терминалом и контейнерами. Результат проверяли скрытые модульные тесты. В профессиональных задачах агент создавал документы, таблицы и другие файлы. В инженерных задачах решения оценивали симуляторы и тестовые стенды.
Последний тип проверки особенно полезен. Там нет судьи на основе языковой модели, который мог бы предпочесть более убедительное описание. Проект либо проходит физические и технические ограничения, либо нет.
В качестве базовой модели использовали Claude Opus 4.8. Дополнительные эксперименты провели с Gemini 3.5 Flash и проверили итоговую обвязку на Gemini 3.1 Flash Lite.
Главные результаты
RRSI не всегда получает лучший результат на наборе, где проходит развитие. В этом и состоит смысл подхода: метод готов пожертвовать частью локального прироста ради переноса.
На задачах, которые не участвовали в развитии, картина изменилась:
Ни один отложенный набор не показал ухудшения.
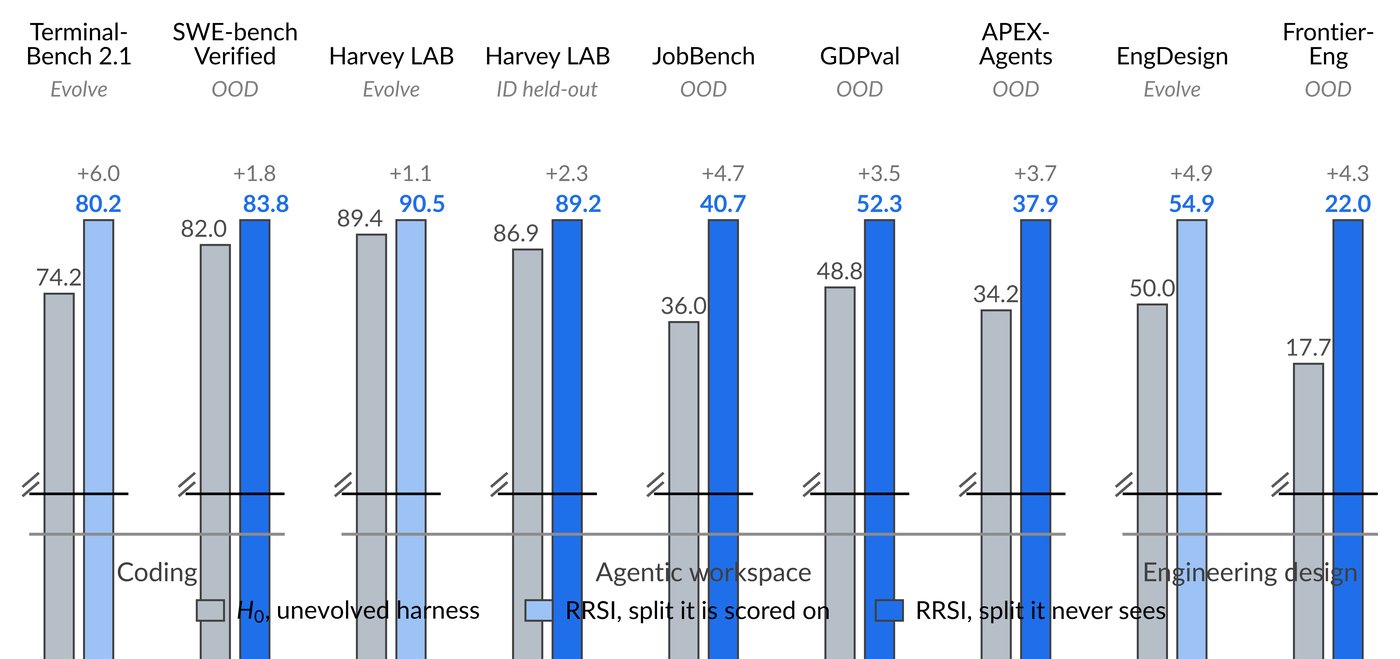
Основные результаты RRSI в программировании, профессиональных задачах и инженерном проектировании.
В профессиональных задачах исходная обвязка получила в среднем 39,7 балла на внешних бенчмарках. Обычная эволюция подняла результат до 40,3. RRSI — до 43,6.
При этом на наборе для развития обычная эволюция достигла 92,8 балла, а RRSI — 90,5. Если смотреть только на одну знакомую выборку, обычный метод кажется лучше. Но на новых задачах он почти возвращается к исходному уровню.
Разбор компонентов
Авторы отдельно отключали группы ограничений.
Когда убирали ограничения при выборе кандидатов, результат на внешних задачах падал с 43,6 до 41,0. Стоимость работы при этом заметно росла.
Когда убирали ограничения при предложении кандидатов, внешний результат снижался до 41,9. Локальный результат почти не менялся. Это показывает, что направление поиска влияет на перенос, даже если оно мало заметно на исходном наборе.
Без обеих групп ограничений система получала 92,8 балла на знакомых задачах, но лишь 40,3 на новых. Средняя стоимость одной попытки достигала 3,80 миллиона токенов против 2,42 миллиона у RRSI.
Меньше вычислений, больше переноса
Обычная эволюция часто увеличивает обвязку. В неё добавляются дополнительные проверки, напоминания, инструкции и шаги рассуждения. Иногда это повышает качество, но вместе с ним растёт стоимость каждого запуска.
RRSI ограничивает такой рост. Итоговая обвязка использует примерно на 30% меньше токенов модели, чем неограниченная эволюция.
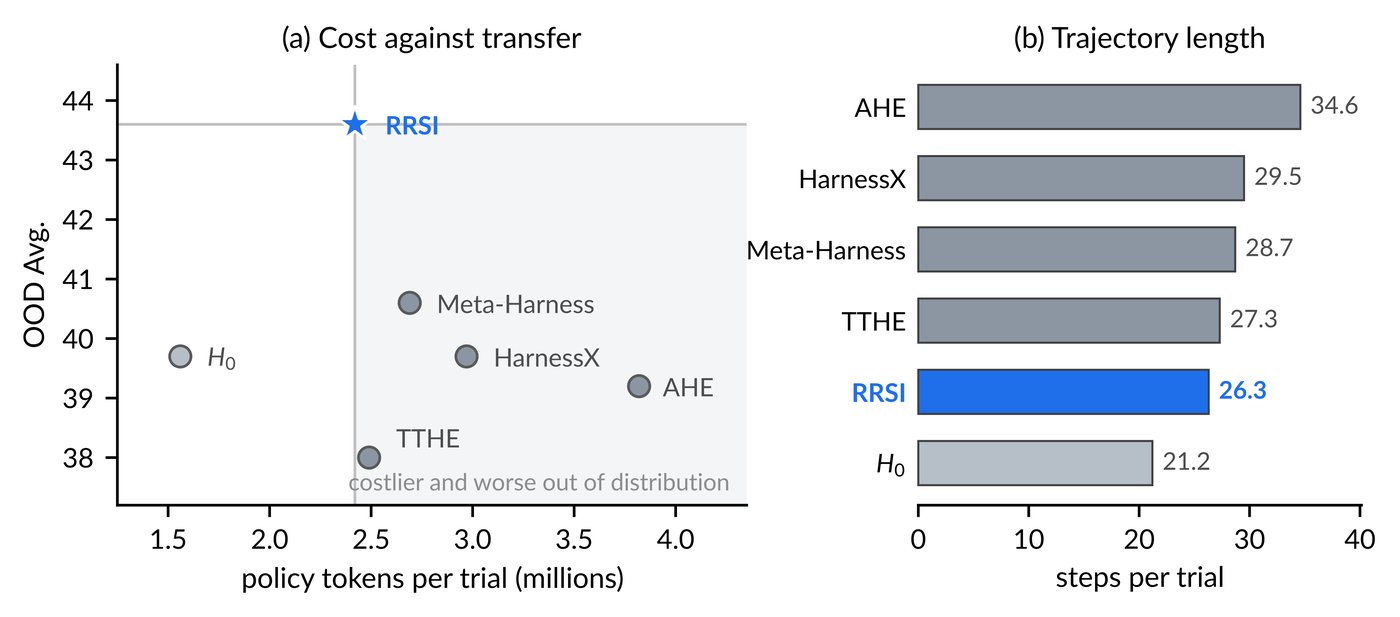
Сравнение стоимости итоговых обвязок и качества на внешних бенчмарках.
Исходная обвязка всё равно остаётся самой дешёвой. Её стоимость составляет около 1,56 миллиона токенов на попытку против 2,42 миллиона у RRSI. Значит, улучшение не бывает бесплатным: агент тратит больше вычислений, но RRSI ограничивает цену этого прироста.
В одном из сравнений другой метод тратил 3,82 миллиона токенов на попытку — на 58% больше RRSI — и при этом показывал на 4,4 пункта меньше на внешних задачах.
Перенос между моделями
Интересный результат касается самой базовой модели. Обвязка, созданная с помощью Gemini 3.5 Flash, улучшала работу и на Gemini 3.1 Flash Lite, которая не участвовала в поиске.
На Terminal-Bench 2.1 результат младшей модели вырос с 11,2 до 14,6 балла. Абсолютный прирост небольшой, но механизм сохранился после смены модели.
Это говорит о том, что RRSI может находить общие процедуры: проверку результата, восстановление после ошибок, более аккуратную работу с инструментами. Такие изменения относятся к поведению агента в целом, а не только к особенностям одной языковой модели.
Что остаётся нерешённым
Метод всё ещё зависит от набора задач для развития. Если он маленький, однообразный или плохо оценивает качество, регуляризация не устранит проблему полностью.
У RRSI есть несколько параметров: размер бюджета правок, ширина окна для удаления компонентов, допустимый рост стоимости и уровень шума. Авторы настраивают их только на наборе для развития, но в других средах эти значения могут потребовать новых проверок.
Исследование также касается только обвязки. Веса модели не меняются. Неясно, как будут вести себя те же ограничения, если одновременно развивается сама модель, память и набор инструментов.
Наконец, эксперименты охватывают относительно короткие циклы. Для длительного самоулучшения на постоянно меняющихся задачах понадобится дополнительная проверка.
Вывод
Автоматическое улучшение обвязки легко превращается в подгонку под знакомый бенчмарк. Высокий результат на задачах развития ещё не означает, что ИИ-агент стал полезнее в реальной работе.
Ограничивать нужно не список разрешённых правок, а способ поиска и закрепления изменений.
Для этого система:
В результате локальный прирост становится скромнее, зато изменения чаще переносятся на новые задачи. Для ИИ-агентов это означает переход от накопления подсказок к более управляемому улучшению программной системы вокруг модели.
Читайте также
 Почему ИИ-агентам трудно работать с разными данными
 Why is it difficult for AI agents to work with different types of data?
 Как ИИ-агентам экономить контекст и избегать сбоев
 How AI Agents Can Save Context and Avoid Failures
 Как ИИ симулирует мысли пользователя
 How AI Simulates a User’s Thoughts
 Coding agents skip looking at the app when the task gets long
Как ИИ-агенты восстанавливают приложения по их поведению
 AI covers six roles in game development, but skills rarely transfer
Как ИИ помогает разрабатывать игры
 LLMs misread motives when the story comes through a biased user
Как проверить, понимает ли ИИ-ассистент мотивы людей
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram