ИИ-агенту нужны рабочие файлы, а не только задания
Представьте задачу для ИИ-агента: изучить несколько отчётов, сопоставить цифры, учесть правила компании и подготовить таблицу с выводами. Для человека это обычная офисная работа. Для модели — испытание на чтение файлов, поиск нужных данных и создание результата, который можно проверить.
Но откуда взять примеры, на которых агент научится такой работе? Синтетические документы часто выглядят ненатурально. А если взять настоящие файлы, возникает другая проблема: как понять, что ответ агента действительно верен?
Авторы предлагают GraphForge — способ создавать обучающие задачи на реальных документах и связывать критерии оценки с источниками. Они дообучили на таких примерах модели Qwen и получили прирост на нескольких бенчмарках рабочих задач. Задача, файлы и проверка результата должны опираться на одни и те же свидетельства.
Почему агентам нужны настоящие рабочие пространства
Современные ИИ-агенты должны не просто отвечать на вопросы. Они читают документы, пользуются инструментами, работают с таблицами и сохраняют готовые материалы в нужном формате. В многошаговой задаче легко ошибиться: перепутать версии данных, пропустить правило или сделать вывод, который не подтверждается источниками.
Для обучения таким действиям нужны примеры с несколькими файлами и понятной проверкой результата. Авторы выделяют два недостатка существующих подходов. В одном случае файлы генерирует модель — это упрощает создание данных, но документы могут быть однообразными и мало похожими на реальные. В другом задачи строятся на настоящих файлах, но для них нет специальных критериев проверки. Тогда трудно отличить качественный ответ от правдоподобно оформленной ошибки.
GraphForge соединяет оба подхода. Файлы берутся из открытых источников, а задание и правила оценки создаются после того, как исследователи собрали рабочее пространство. Проверяющая модель получает ссылки на конкретные источники и знает, где искать подтверждение каждого требования.
Что такое GraphForge
Сначала система выбирает основу задачи из базы профессий и рабочих обязанностей. В итоге авторы оставили 246 профессий из 16 секторов, 891 тип рабочей задачи и 3419 допустимых сочетаний профессии и типа задачи. Такой старт помогает контролировать разнообразие: система заранее задаёт область работы и тип действий, а не поручает модели придумывать задания без ограничений.
Затем поисковый агент собирает файлы для конкретного примера. Это могут быть отчёты, таблицы и другие документы, связанные с одной рабочей ситуацией. У каждого файла есть скрытая роль: основной источник, справочный материал, правдоподобный отвлекающий документ или дополнительный контекст. Агент, который будет решать задачу, этих ролей не видит.
После этого модель строит граф свидетельств. Его узлы — файлы и нужные факты из них, а связи показывают, какие сведения нужно сопоставить или объединить. Например, значение из таблицы может требовать проверки по отчёту, а вывод — учитывать правила из отдельного документа.
Граф превращают в задание и рубрику оценки. У каждого критерия есть привязка к источникам и способ проверки: какие файлы открыть и какую часть результата оценить. Отдельно задаются ошибки, за которые нужно снижать баллы. При этом сам агент видит задание и рабочее пространство, но не видит привязок и скрытых ролей файлов.
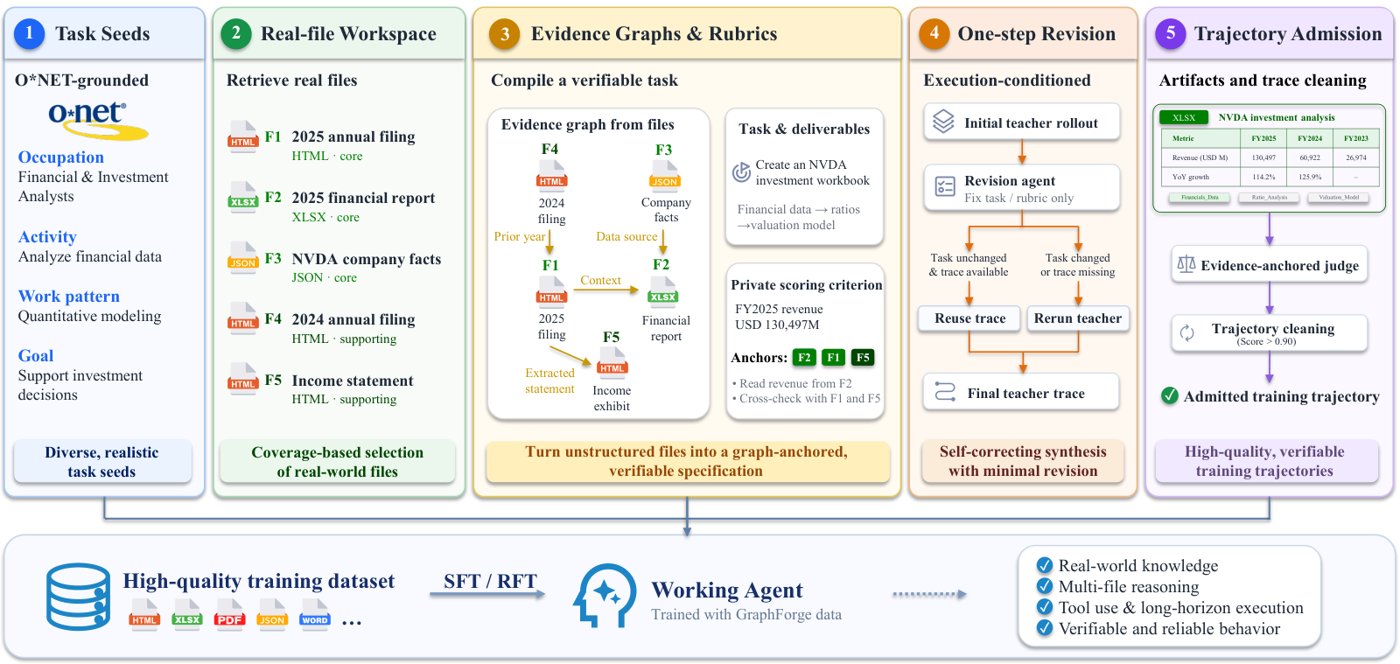
GraphForge собирает файлы, связывает факты в граф и выводит из него задание с проверяемыми критериями.
Автоматически создать задание недостаточно. Сначала сильная модель пробует его выполнить. Затем отдельный агент-проверяющий смотрит, можно ли решить задачу, подтверждаются ли нужные данные источниками и достаточно ли чётко описаны критерии. Если обнаруживается проблема, система исправляет только нужные части задания или рубрики, не переписывая всё заново.
Наконец, результат проходит два вида проверки. Программы проверяют формат файлов, названия, листы и формулы в таблицах. Модель-судья оценивает содержательные критерии, сверяясь с исходными документами. В обучающий набор попадают только примеры с достаточно высокой оценкой и без явных проблем в работе с инструментами.
Что попало в обучающий набор
После отбора авторы получили 2169 траекторий — последовательностей действий агента от начала задачи до готового результата. Их выбрали из 3638 подготовленных задач. Набор охватывает 466 типов рабочих задач, 15 из 16 профессиональных секторов и все 16 типов выполнения работы.
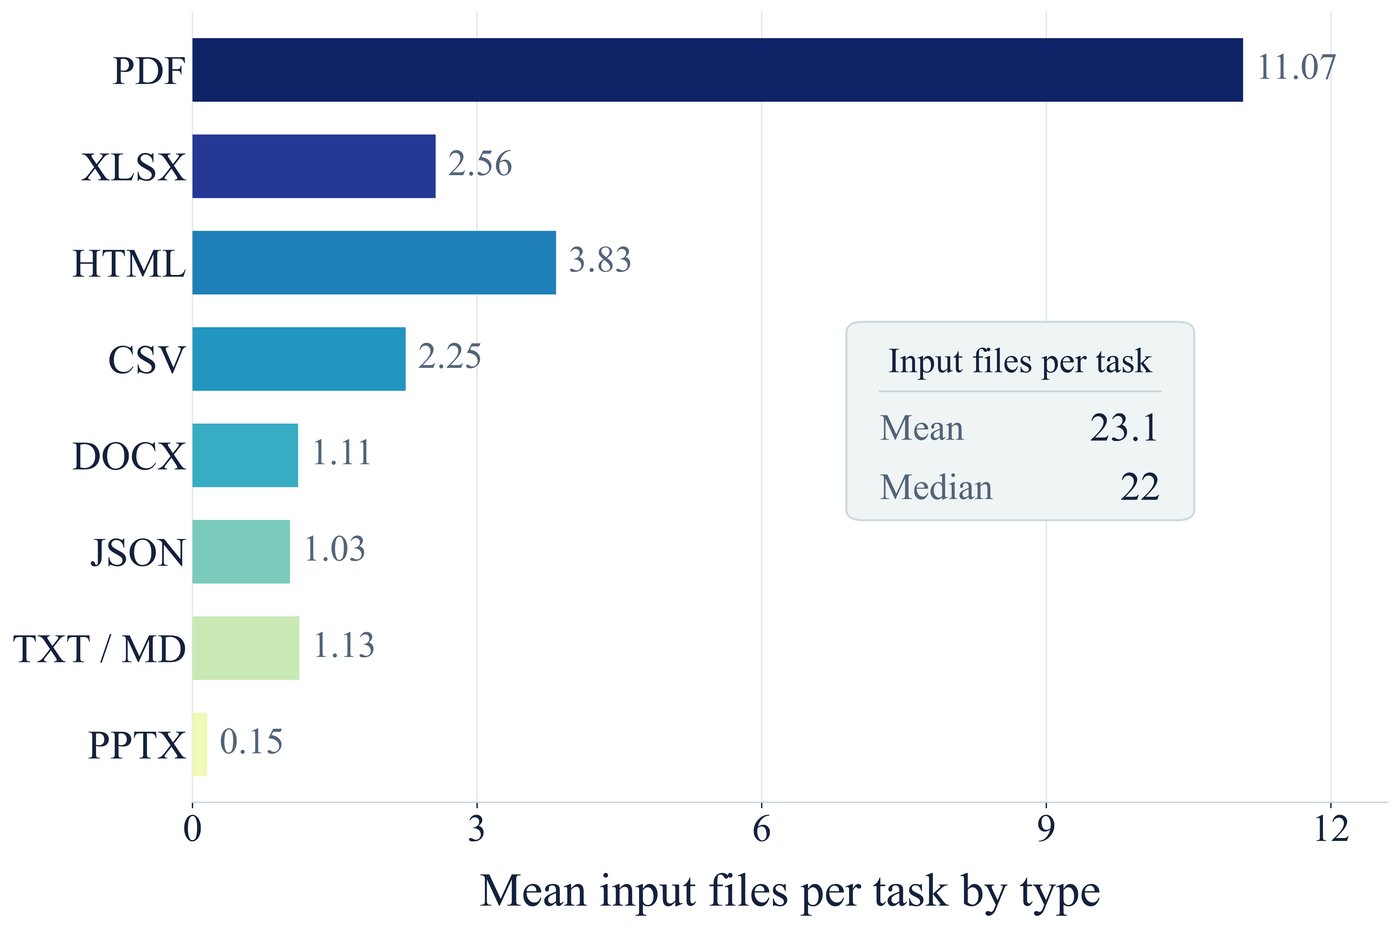
Примеры довольно длинные. В среднем одна траектория содержит 50 шагов помощника и около 162 тысяч токенов. PDF-файл встречается в 96,7% примеров; в большинстве задач нужны и другие форматы. Модель учится извлекать ответ из нескольких документов и работать с разными видами файлов.
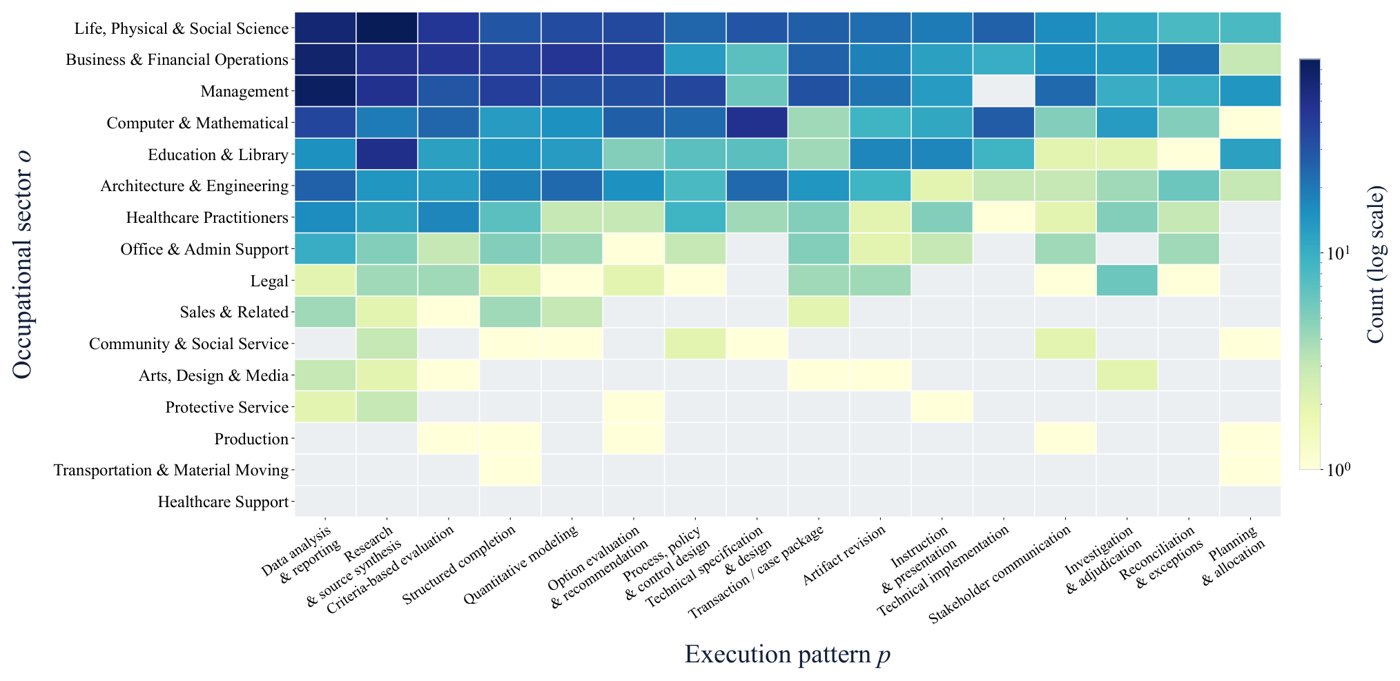
Распределение обучающих задач по профессиональным секторам, типам работы и семействам файлов.
Авторы дообучили две модели Qwen на этих траекториях и проверили их на трёх бенчмарках: GDPVal, Workspace-Bench-Lite и SpreadsheetBench II. Результаты оценивали в разных средах для запуска агентов. Так можно проверить, не сводится ли улучшение к привычке работать с одной конкретной обвязкой.
Оценка модели Qwen3.6-27B на GDPVal выросла на 65,7 пункта по шкале Эло. На Workspace-Bench-Lite результат увеличился на 7,7 пункта, а на SpreadsheetBench II — на 13,7. Вторая модель, Qwen3.6-35B-A3B, тоже улучшилась на всех трёх бенчмарках. Прирост сохранился и при проверке в других средах запуска.
Дообучение на GraphForge улучшило результаты обеих моделей на трёх бенчмарках.
Авторы также проверили, не объясняются ли результаты запоминанием обучающих файлов. Среди 39 201 уникального обучающего файла не нашлось совпадений с файлами GDPVal. Содержательное сходство проверяли и по тексту. Кроме того, улучшение сохранилось на задачах по профессиям, которых не было в обучающей выборке. Это похоже на перенос рабочих навыков, хотя само по себе не доказывает, что модель одинаково хорошо справится с любым новым типом работы.
Может ли рубрика улучшить выбор примеров
После обычного дообучения авторы проверили ещё один подход. Дообученная модель получила 2000 новых запросов и для каждого подготовила до четырёх вариантов ответа. Затем система выбрала лучшие ответы для дополнительного обучения.
Сравнивались три способа выбора. Первый учитывал и рубрику, и привязанные к ней источники. Второй видел текст рубрики, но не конкретные привязки. Третий выбирал случайный вариант из четырёх. Для честного сравнения во всех трёх случаях использовали одинаковые запросы и наборы ответов.
На Workspace-Bench-Lite и SpreadsheetBench II выбор с привязкой к источникам дал наибольший прирост. Случайный выбор оказался слабее. На GDPVal картина менее ясная: не все различия между вариантами можно надёжно отделить от шума. Результаты показывают, что качество отбора имеет значение, но не позволяют уверенно установить преимущество одного судьи над другим.
Есть и ограничение у самой проверки. Если из рабочего пространства удалить целый лист, оценка связанного с ним критерия заметно падает. Но небольшие искажения чисел или строк судья замечает хуже. Такая проверка находит отсутствие важного источника, но пока не всегда надёжно перепроверяет мелкие детали данных.
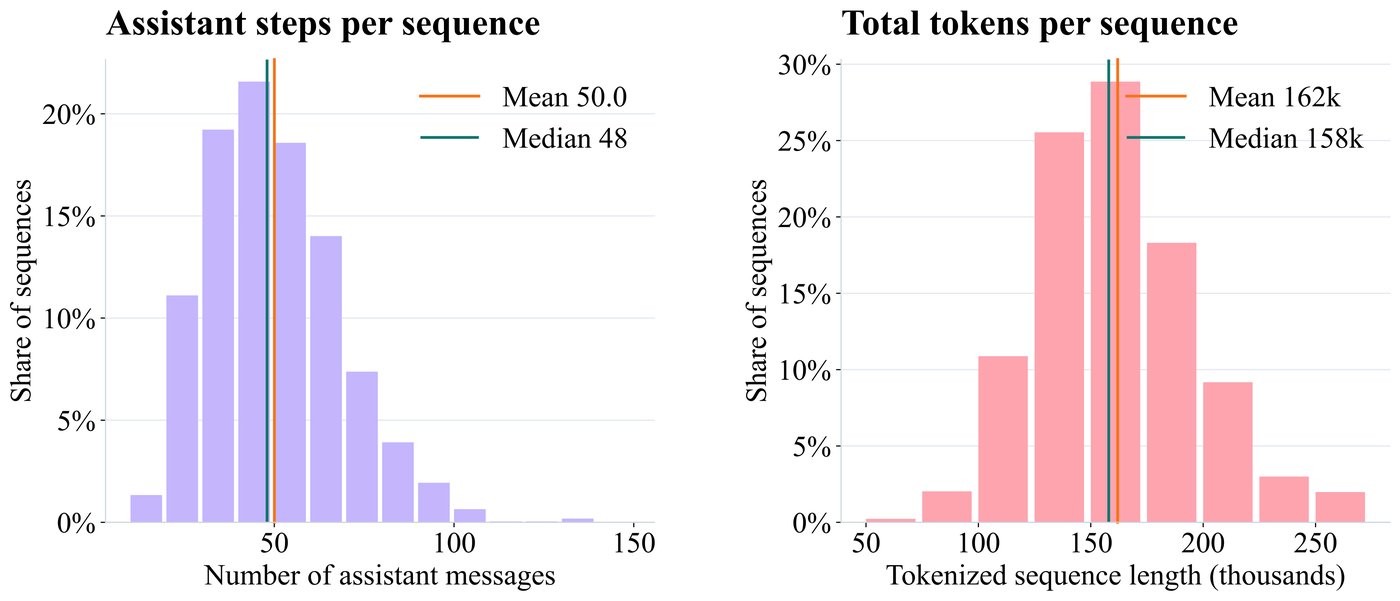
Средняя траектория содержит 50 шагов; почти треть обучающих примеров приближается к пределу в 262 тысячи токенов.
Вывод
GraphForge предлагает обучать ИИ-агентов на задачах, собранных вокруг настоящих файлов, и проверять ответы по тем же источникам. На 2169 примерах модели улучшили результаты на трёх рабочих бенчмарках, а отбор ответов по рубрикам дал дополнительный прирост в части проверок.
Пока неизвестно, как эти результаты изменятся при увеличении набора. Исследование охватывает только две модели одного семейства, а создание задач и оценка в основном опираются на одну и ту же модель. Есть и риск, что автоматический судья пропустит ошибки в числах и деталях. GraphForge показывает способ создавать проверяемые обучающие данные, но вопрос о том, насколько точно такие данные и оценки переносятся на другие модели и виды работы, остаётся открытым.
Читайте также
 Можно ли автоматически собрать нужных ИИ-агентов по ходу работы
 Как тысяча ИИ-агентов работают вместе без начальника
 Как дать ИИ-агенту больше свободы с меньшим риском
 Как ИИ-агент подбирает прошлый опыт под новую задачу
 ИИ-судья сохраняет 99% точности за меньшие деньги
 Как самоулучшение ИИ-агента улучшает результаты и экономит токены
 Почему ИИ-агентам трудно работать с разными данными
 Как ИИ-агентам экономить контекст и избегать сбоев
 Как ИИ симулирует мысли пользователя
 Как ИИ-агенты восстанавливают приложения по их поведению
 Как ИИ помогает разрабатывать игры
 Как проверить, понимает ли ИИ-ассистент мотивы людей
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram