Дешёвый судья для ИИ
Оценивать ответы ИИ дорого. Особенно если проверять нужно не сотни примеров, а миллионы ответов в дата-пайплайне, бенчмарке или системе отбора данных.
Обычно для такой работы берут сильную языковую модель. Она читает вопрос, сравнивает ответы, проверяет факты и выносит вердикт. Проблема в цене и задержке. Чем сложнее модель и длиннее её рассуждение, тем дороже каждый вызов.
Статья Carnegie Mellon предлагает другой подход: сначала использовать дешёвого судью, а сильную модель подключать только там, где первый не уверен. В роли первого судьи выступает JEV — сервис, который возвращает не объяснение, а типизированный вердикт и вероятности по возможным меткам.
На обычных задачах JEV оказался близок к GPT-6. При этом один его вердикт стоил примерно в 277 раз дешевле.
Что такое JEV
Генеративный судья обычно пишет рассуждение, а потом выдаёт итог. JEV работает иначе. Ему задают вопрос, описание меток и входные данные. На выходе он возвращает структурированный ответ:
🟠 выбранную метку;
🟠 вероятности всех возможных меток;
🟠 уверенность, которую можно использовать для маршрутизации.
Например, на задаче сравнения ответов возможны метки «ответ A» и «ответ B». На проверке фактов — «поддержано» и «галлюцинация». На проверке финального ответа — «верно», «неверно» и «нет ответа».
Такой интерфейс удобен для пайплайна. Не нужно разбирать длинное объяснение и пытаться понять, какой именно вывод сделала модель. Система сразу получает значение нужного типа.
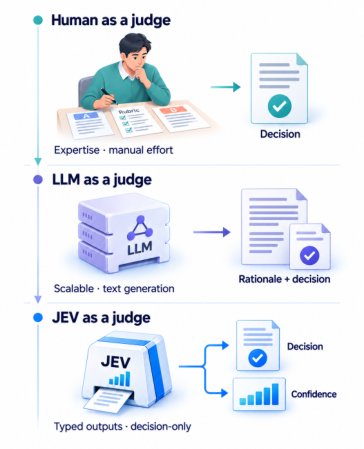
Сравнение ручной оценки, генеративного судьи и судьи с типизированным вердиктом и вероятностями.
Но у подхода есть условие. Вероятность должна помогать отличать правильные решения от ошибок. Если модель уверенно ошибается, маршрутизация не спасёт.
Что проверяли
Исследователи сравнили JEV с шестнадцатью судьями: генеративными моделями, локальными моделями и моделями вознаграждения. В число сравнений вошёл GPT-6, который стал главным ориентиром по качеству.
Проверка охватила несколько типов задач:
🟣 сравнение двух ответов на один вопрос;
🟣 проверка ответа по предоставленным доказательствам;
🟣 оценка финального ответа модели относительно эталона;
🟣 проверка сложных задач на знания, математику, рассуждение и программирование;
🟣 выбор лучшего ответа из четырёх вариантов;
🟣 сравнение ответов, написанных в разных стилях.
Основные данные взяли из RewardBench, JudgeBench и HaluEval. Дополнительно авторы использовали сохранённые ответы из экспериментов с многошаговыми диалогами и отдельные контрольные наборы.
Всего в базовом сравнении было 1312 заданий. Ошибка формата тоже считалась ошибкой. Если модель не вернула допустимую метку, нарушила схему или не ответила после повторных попыток, результат не исправляли вручную.
Для проверки спорных случаев авторы провели слепую оценку человеком. Эксперт не видел метки бенчмарка и не знал, какой судья оказался прав.
Обычные задачи JEV решает дёшево
На RewardBench JEV получил 92,2% против 93,5% у GPT-6. Разница составила 1,3 процентного пункта.
На HaluEval, где ответ нужно сверять с доказательствами, JEV набрал 87,5%, а GPT-6 — 86,7%. Разница оказалась в пользу JEV, но выборка и сами метки содержали спорные случаи.
На наборе из 150 сохранённых ответов JEV достиг 94,0%, GPT-6 — 96,7%.
Иными словами, на задачах обычного сравнения и проверки ответа по готовому контексту JEV держится рядом с гораздо более дорогой моделью.
🟠 RewardBench: 92,2% у JEV против 93,5% у GPT-6.
🟠 HaluEval: 87,5% против 86,7%.
🟠 Проверка финального ответа: 94,0% против 96,7%.
🟠 Стоимость JEV: около 0,044 доллара за тысячу решений.
🟠 Стоимость GPT-6 на том же измерительном наборе: около 12,182 доллара.
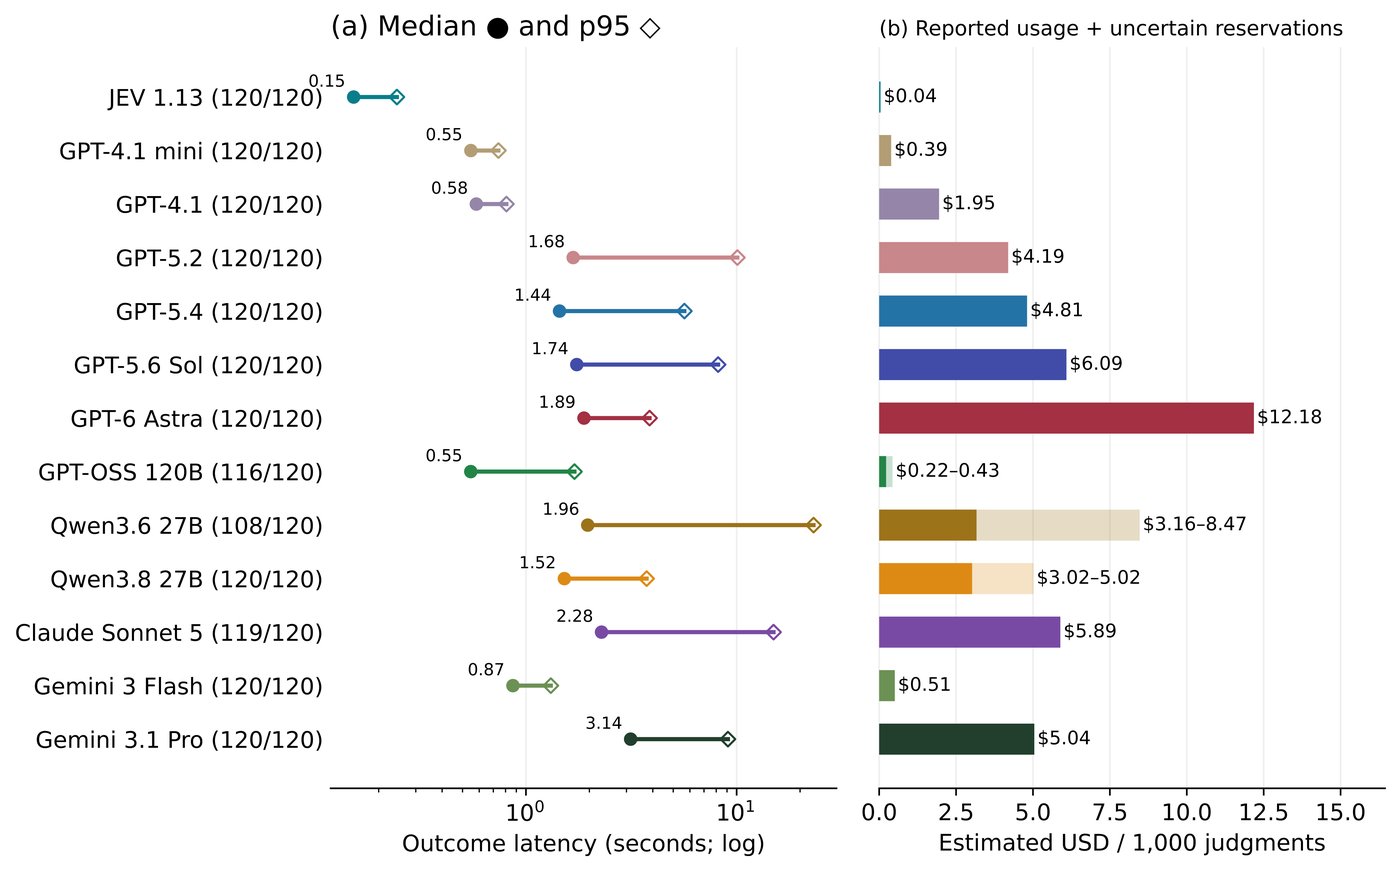
Сравнение задержки и стоимости тысячи решений для размещённых моделей.
Разница в скорости тоже заметна. Медианная задержка JEV составила 0,152 секунды. У GPT-6 — 1,885 секунды. Это измерение включает сеть, сервер провайдера и повторы запросов, поэтому его нельзя считать чистой скоростью инференса. Но для прикладного пайплайна важен именно полный срок получения результата.
На сложных задачах разрыв растёт
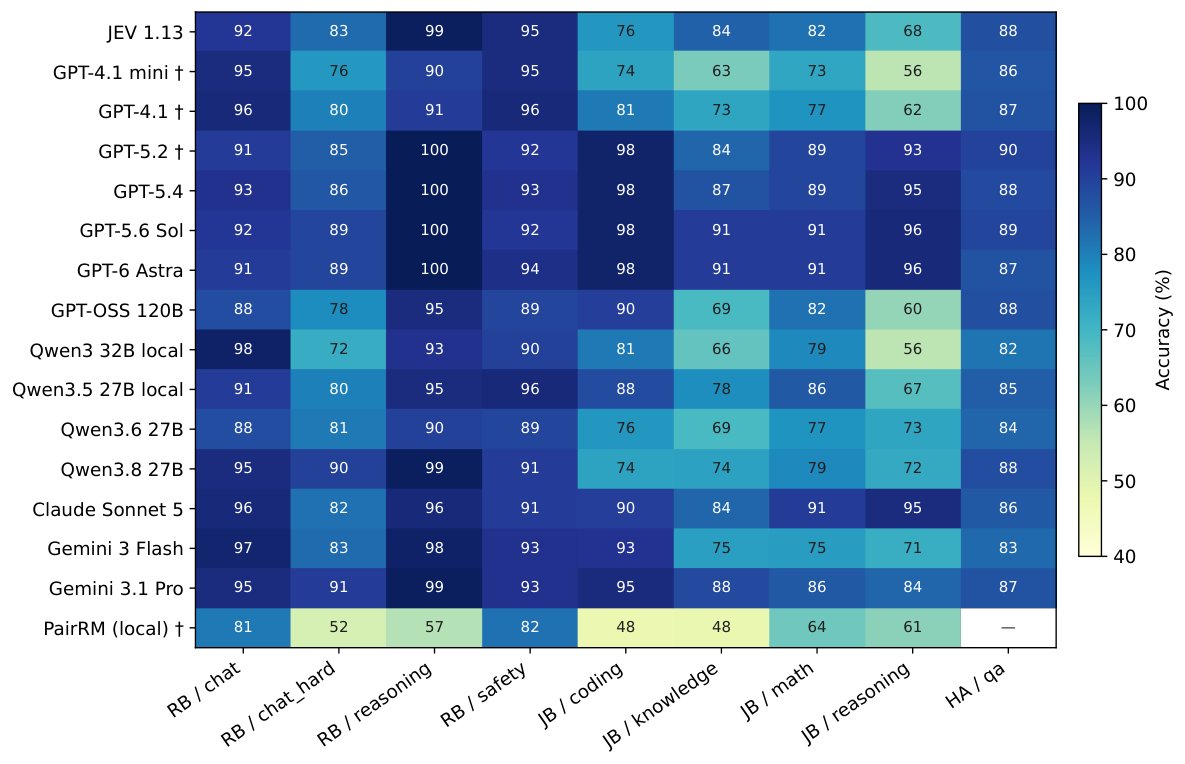
JudgeBench изменил картину. Здесь нужно проверять объективную правильность ответа, включая математику, рассуждение и программирование.
JEV набрал 78,6%. GPT-6 — 93,1%. Разница составила 14,6 процентного пункта.
Особенно заметным разрыв оказался в рассуждении и программировании:
🟣 рассуждение: 68,4% у JEV против 95,9% у GPT-6;
🟣 программирование: 76,2% против 97,6%;
🟣 знания: 84,4% против 90,9%.
Человек, проверивший спорные случаи, в основном согласился с GPT-6. На JudgeBench он выбрал GPT-6 в 57 из 69 случаев, где судьи разошлись. За JEV эксперт высказался только один раз.
Проблема JEV проявляется там, где нужно самостоятельно проверить цепочку вывода. Короткой оценки ответа недостаточно. Судье приходится восстановить решение, найти ошибку в формуле или понять, что убедительно написанный ответ заканчивается неправильным выводом.
Похожая ситуация возникла в RM-Bench. Если правильный ответ написан проще, а ошибочный — подробнее и аккуратнее, JEV начинает чаще выбирать неправильный вариант. При одинаковом стиле его точность составила 84,0%. В сложных стилевых парах — 74,8%. У GPT-6 этот эффект почти исчез: 93,3% и 94,6%.
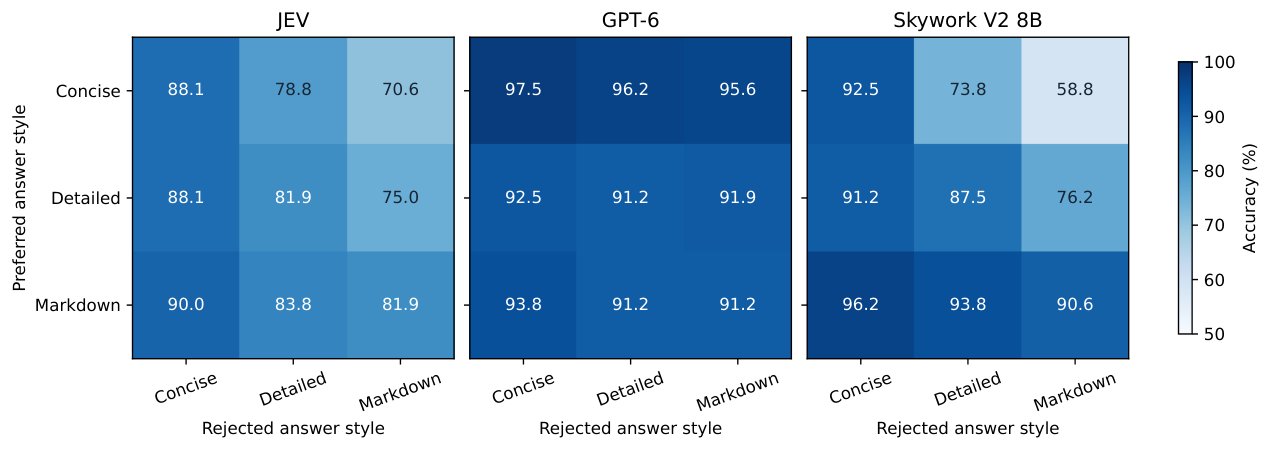
Точность JEV, GPT-6 и модели вознаграждения в задачах выбора и сравнения ответов разных стилей.
Уверенность превращается в маршрутизатор
Практическая идея статьи — не использовать JEV в одиночку.
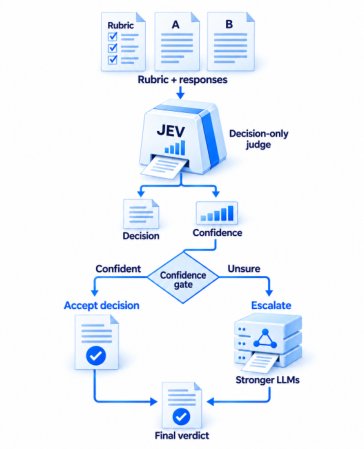
Схема выглядит так:
1. JEV быстро оценивает каждый пример.
2. Если максимальная вероятность высокая, система принимает его вердикт.
3. Если уверенность ниже порога, пример передаётся GPT-6 или другой сильной модели.
4. Итогом становится решение второго судьи.
Это обычный каскад, но его эффективность зависит от того, умеет ли первый судья находить собственные ошибки.
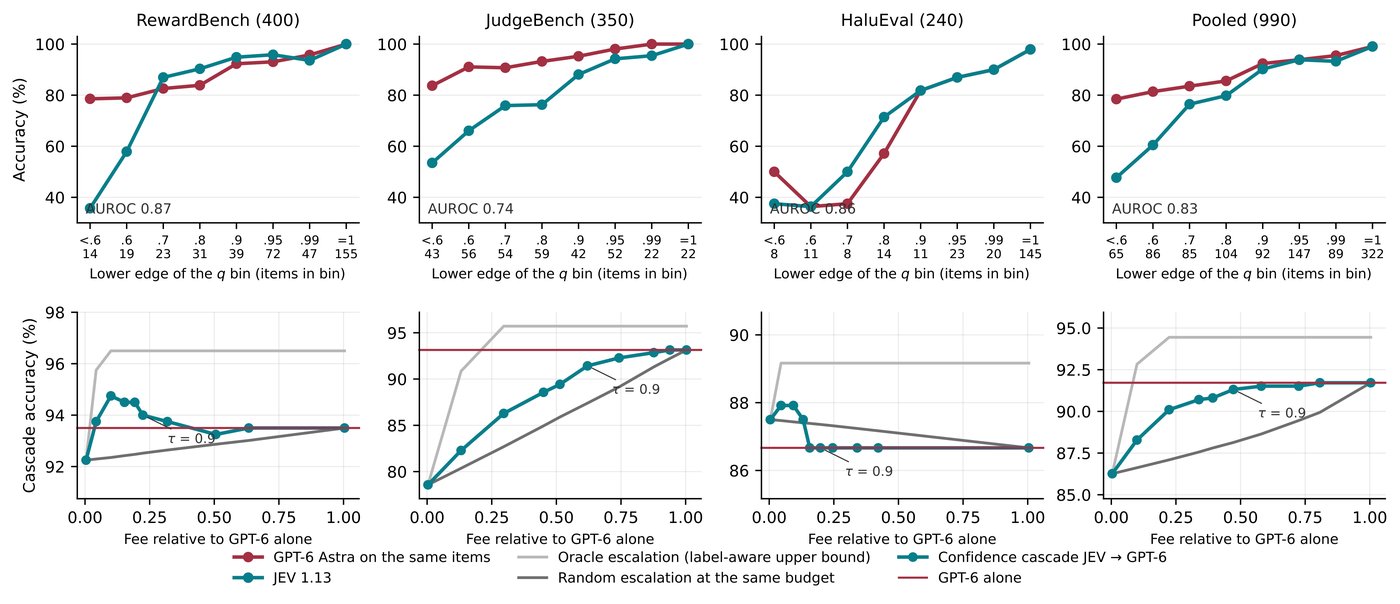
У JEV такая связь есть. На трёх основных наборах точность росла вместе с максимальной вероятностью выбранной метки. Среди решений с вероятностью 0,99 и выше он ошибался редко. Среди решений с вероятностью ниже 0,6 правильными были только 47,7%.
Распределение уверенности JEV для правильных и неправильных решений и кривые надёжности разных судей.
В симуляции каскад с порогом 0,9 передавал сильной модели 34% примеров. Он сохранял 99,6% точности GPT-6, но требовал около 47% его стоимости. На JudgeBench пришлось передавать больше задач — около 61% при том же пороге. Даже там каскад сохранял 98,2% точности и обходился примерно в 62% стоимости GPT-6.
В заранее зафиксированном эксперименте на парных сравнениях JEV принимал 53,7% решений сам. Остальные уходили к GPT-6. Точность составила 92,5% против 93,1% у GPT-6 без каскада. Относительная стоимость — около 57%.
Каскад принимает уверенные решения JEV и передаёт неуверенные случаи более сильной модели.
Уверенность не даёт гарантии
У маршрутизации есть границы.
На сложных стилевых парах JEV иногда уверенно выбирал неправильный ответ. В задачах с проверкой свободного текста без доказательств ситуация оказалась ещё хуже. JEV набрал 52,5% — почти случайный результат. При этом средняя максимальная вероятность была около 0,90.
Получается опасная комбинация: судья почти не понимает задачу, но сообщает высокую уверенность. В таком режиме порог не помогает. Система будет принимать ошибки как надёжные решения.
Авторы также проверили перенос калибровки между наборами. Температура, подобранная на одном типе задач, иногда улучшала вероятности на другом, но могла их ухудшить. Универсального значения не нашлось.
Для практического применения нужны локальные проверки:
🟣 проверять оба порядка кандидатов в парных задачах;
🟣 выбирать порог на отдельной отложенной выборке;
🟣 считать ошибки формата полноценными ошибками;
🟣 отдельно проверять задачи с обманчивым стилем;
🟣 не переносить порог и калибровку на новый тип данных без повторного измерения.
Что это меняет для пайплайнов оценки
JEV не заменяет сильный ИИ-судья. Он сокращает число обращений к нему.
Для массовой проверки предпочтений, ответов по предоставленным источникам и простого отбора финальных решений дешёвый первый проход выглядит разумно. Система может обработать большую часть данных быстро и передать дорогой модели только спорные случаи.
Для математики, программирования, многошагового рассуждения и ответов, которые нужно проверять без внешнего источника, одного JEV недостаточно. Здесь стоит сразу использовать более сильную модель или строить отдельную проверку.
Зависимость ошибок JEV от уверенности и экономия каскада при передаче неуверенных решений GPT-6.
Есть и более общий вывод. Вердикт, правильность и надёжная уверенность — три разные свойства. Модель может корректно соблюдать формат, часто выбирать правильную метку и всё равно плохо понимать, когда она ошибается.
Вывод
JEV подходит как дешёвый первый судья. На обычных задачах он уступает GPT-6 на несколько процентных пунктов, но стоит на порядки меньше и отвечает быстрее.
Каскад «принять уверенное, передать сомнительное» позволяет сохранить около 99% качества GPT-6 примерно за половину его стоимости. Но это работает только в пределах проверенного типа задач.
Если вы строите пайплайн оценки ИИ, разумная схема выглядит так:
🟠 быстрый судья для большинства примеров;
🟠 вероятность как сигнал для маршрутизации;
🟠 сильная модель для сложных и неуверенных случаев;
🟠 отдельная проверка порогов на собственных данных.
Уверенность модели стоит использовать как повод для дополнительной проверки, а не как доказательство правильности.
Читайте также
 Как самоулучшение ИИ-агента улучшает результаты и экономит токены
 Почему ИИ-агентам трудно работать с разными данными
 Как ИИ-агентам экономить контекст и избегать сбоев
 Как ИИ симулирует мысли пользователя
 Как ИИ-агенты восстанавливают приложения по их поведению
 Как ИИ помогает разрабатывать игры
 Как проверить, понимает ли ИИ-ассистент мотивы людей
 Как ИИ-агент управлял интернет-магазином и увеличил капитал в 14 раз
 Последний ИИ, созданный людьми: на пути к рекурсивному самоулучшению
 Как ИИ-агент за несколько дней собрал играбельный шутер
 Как граф превращает ошибки ИИ-агента в подсказки
 А что, если ИИ-агенту проще пересоздать библиотеку, чем чинить её?
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram