Тысяча агентов — лучше, чем один?
Когда задача слишком велика для одного ИИ-агента, привычный выход — запустить несколько и поручить каждому свою часть работы. Но тут возникает новая проблема: кто распределяет задачи, следит за ходом работы и собирает результаты? Обычно этим занимается главный агент. Чем больше его команда, тем труднее ему всех координировать.
Исследователи Microsoft предложили другой подход. В системе Agensh нет главного агента: участники сами выбирают задачи, сообщают друг другу о прогрессе и объединяют готовые изменения. В эксперименте с восстановлением программы pandoc команда из 1024 агентов прошла больше скрытых тестов, чем одиночный агент. Авторы проверили и меньшее число участников: на пяти сложных задачах по программированию переход от одного агента к 128 поднял среднюю долю пройденных тестов примерно на 49%.
Здесь масштабируют не саму языковую модель, а организацию вокруг неё. Число агентов становится отдельным способом улучшить результат, хотя пока неизвестно, насколько хорошо этот подход работает за пределами программирования.
Что заменяет главного агента
В привычной схеме один агент действует как руководитель: делит большую задачу на части, назначает исполнителей и проверяет, что они сделали. Но руководитель сам становится узким местом. Если участников много, ему приходится тратить всё больше усилий на распределение работы и сведение результатов.
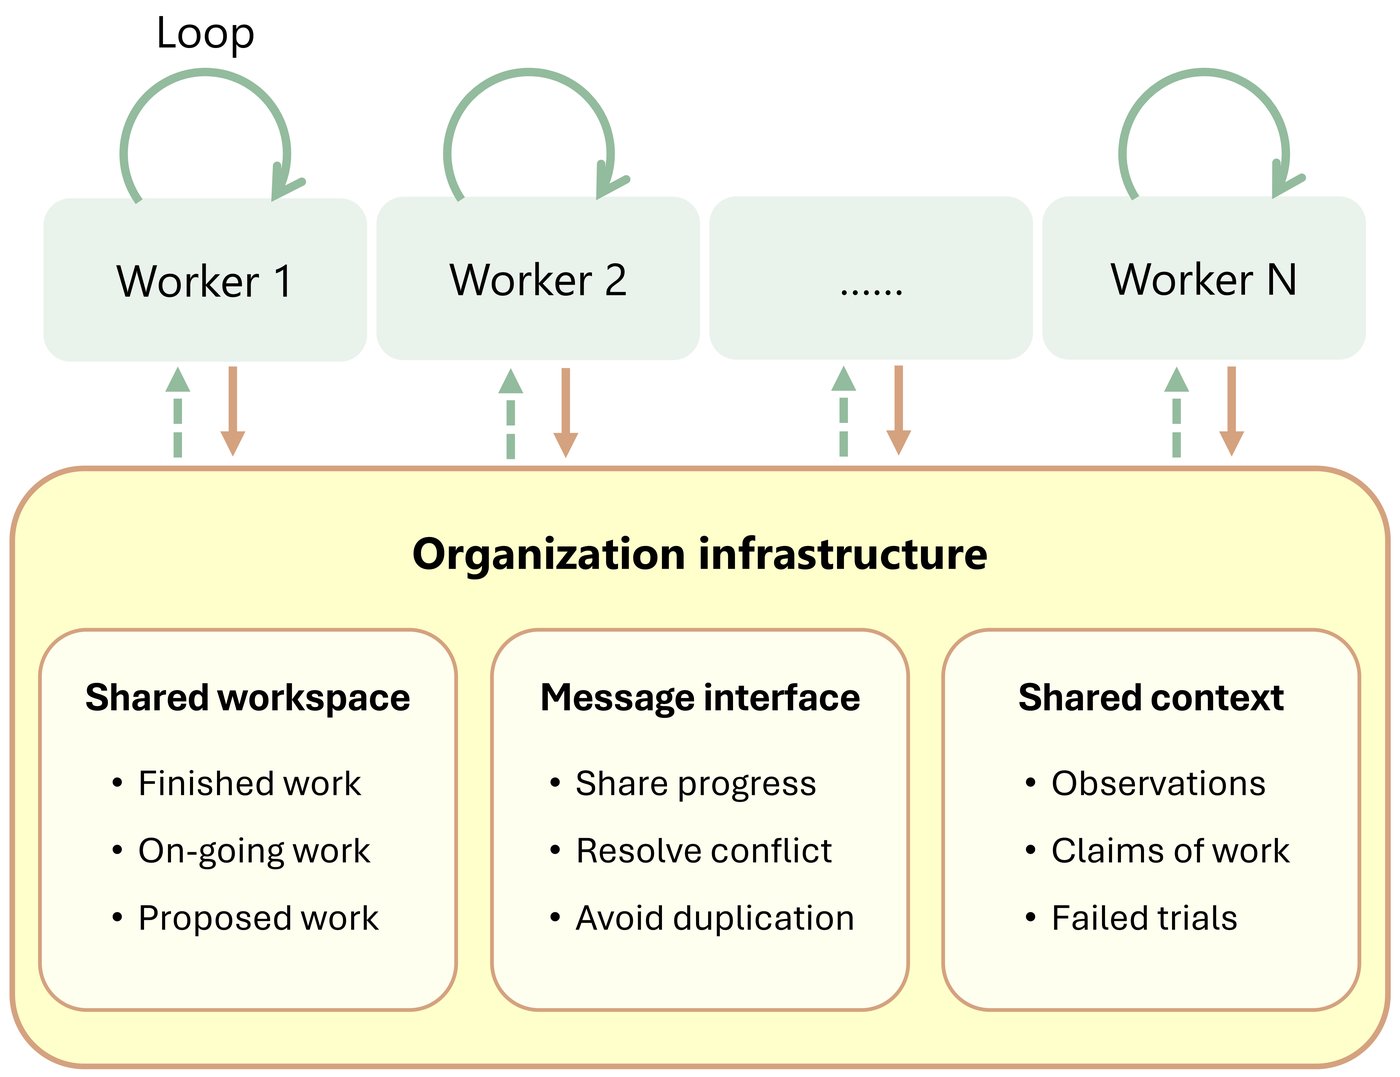
Agensh убирает этот центральный пункт управления. Каждый участник получает одну и ту же общую цель и сам решает, за какую подзадачу взяться. Чтобы такая команда не превратилась в толпу, у неё есть общие инструменты: рабочее пространство, канал сообщений и общие заметки.
Рабочее пространство хранит код и результаты работы. В опытах для этого использовали систему контроля версий: участники трудятся в отдельных ветках, а затем предлагают изменения для включения в общую версию. Канал сообщений нужен, чтобы договориться о пересекающихся задачах или зависимостях между ними. В общих заметках агенты публикуют проверенные факты, неудачные подходы, текущие планы и краткие отчёты о внесённых изменениях.
Это напоминает команду разработчиков, где нет руководителя, который раздаёт каждое поручение. Участники видят общий план и результаты коллег, выбирают свободную работу и согласуют столкновения напрямую.
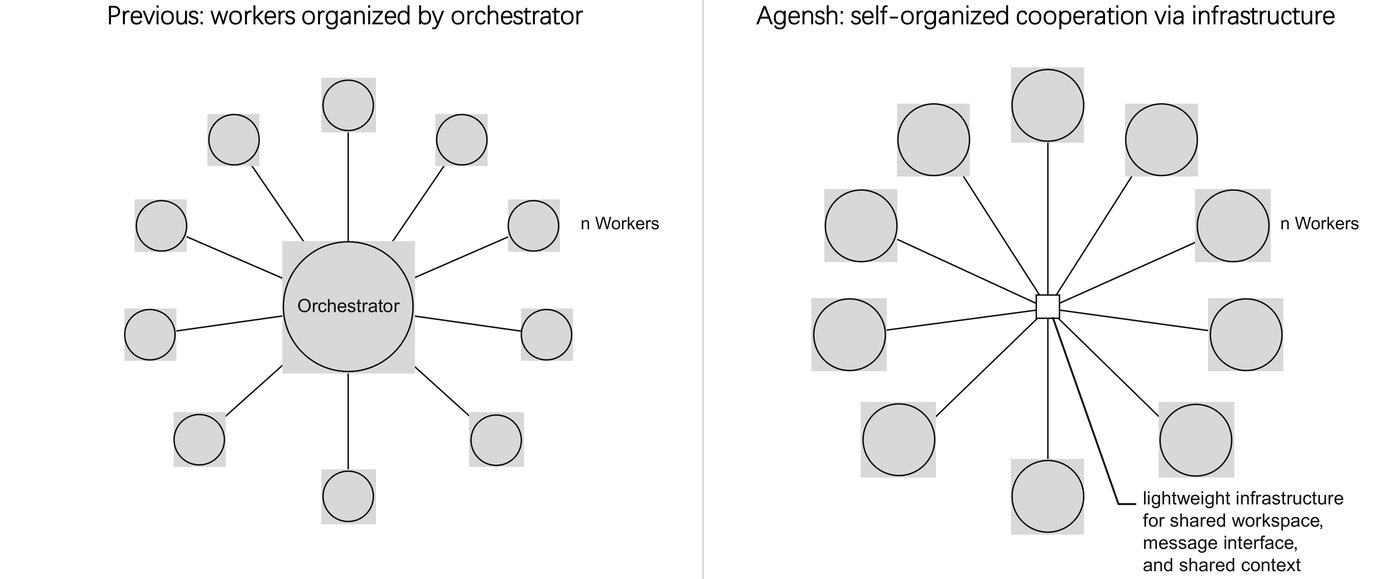
В Agensh участники сами выбирают задачи и делятся прогрессом через общее рабочее пространство, сообщения и заметки.
Как работает цикл сотрудничества
Каждый агент проходит один и тот же цикл, но действует независимо от остальных. Сначала читает общую цель и проверяет, что уже сделано. Затем предлагает себе подзадачу и записывает её в общие заметки. Если выясняется, что такую же работу уже начал кто-то другой, агенты договариваются о разделении или меняют планы.
После этого участник работает с кодом, проверяет результат и объединяет его с общей версией. Если изменения конфликтуют с работой коллег, нужно сначала разрешить конфликт. Закончив, агент снова изучает общий прогресс и выбирает следующую задачу.
Все участники движутся по этому циклу асинхронно: одному не нужно ждать, пока остальные завершат свою работу. Общие заметки помогают не повторять уже проверенные попытки. Если агент выяснил, что решение не работает, он может сообщить об этом команде.
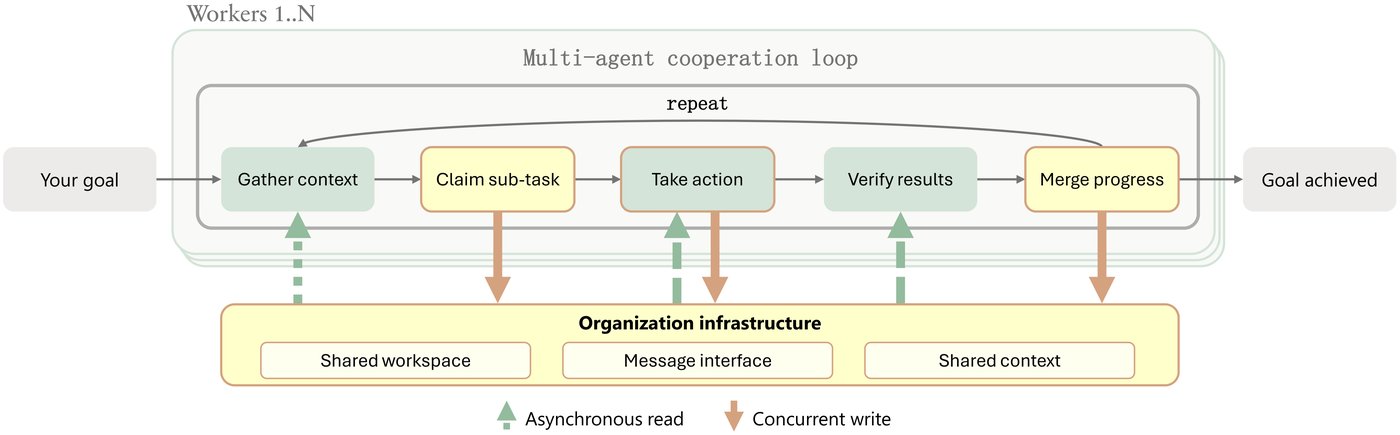
Пять шагов каждого агента: изучить прогресс, выбрать подзадачу, выполнить её, проверить и объединить результат.
В этой схеме есть компромисс. Самостоятельность избавляет от необходимости заранее поручать каждому агенту работу, но не гарантирует, что все выберут полезные задачи. Возможны дублирование усилий, конфликты при объединении кода и ошибки в оценке чужих результатов. Общие инструменты призваны снизить эти риски, но не устраняют их автоматически.
Проверка на больших программных задачах
Agensh проверили на пяти трудных задачах из бенчмарка ProgramBench. В каждой нужно было с нуля восстановить поведение существующей программы, имея доступ к её готовому исполняемому файлу, но без интернета. Среди примеров — FFmpeg, PHP и pandoc. На работу давали шесть часов.
В пяти задачах средняя доля пройденных тестов выросла с 19,31% у одного агента до 20,68% у восьми, 26,52% у 32 и 28,78% у 128. Последняя цифра означает рост на 9,47 процентного пункта, или примерно на 49% относительно исходного результата. Это заметное улучшение, но результат всё равно далёк от полного восстановления программ.
Проверка на pandoc показала похожую картину при ещё большем масштабе. Один агент прошёл 33,89% тестов, 128 — 50,94%, а 1024 — 55,06%. Переход от 128 к 1024 агентам дал 4,12 процентного пункта. Команда продолжила улучшать результат, хотя прибавка оказалась куда скромнее, чем при переходе от одного участника к 128.
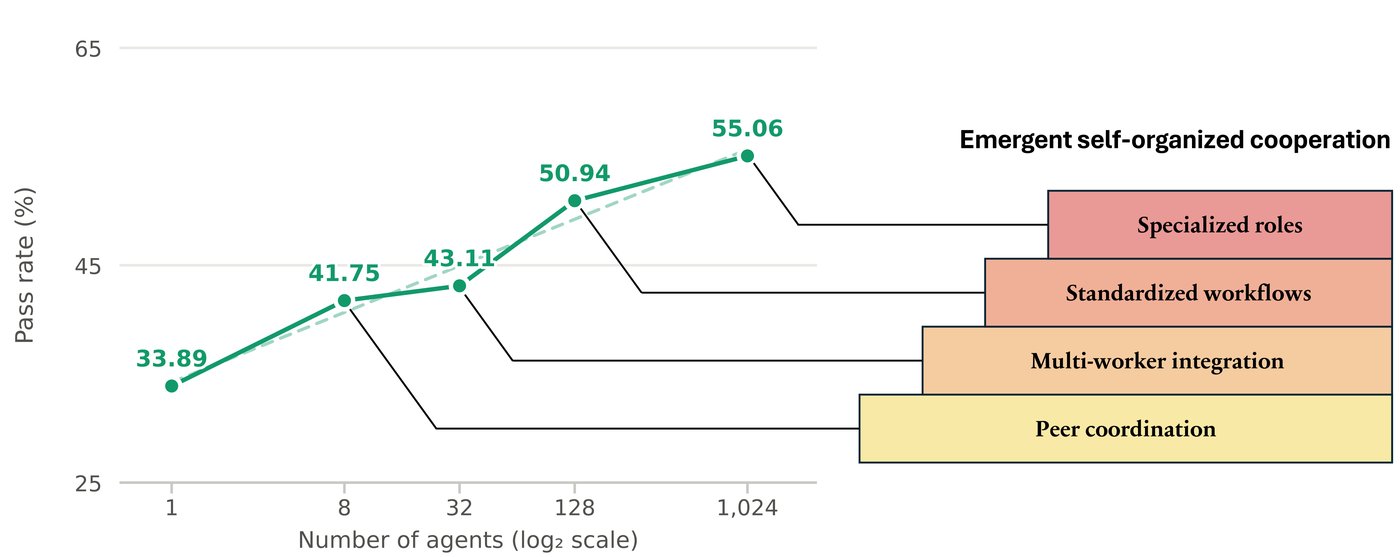
При восстановлении pandoc доля пройденных тестов выросла с 33,89% у одного агента до 55,06% у 1024.
Большее число агентов помогало и быстрее достигать промежуточного результата. Например, на pandoc команда из 128 агентов превысила отметку в 30% тестов через полчаса. Командам из 32 и восьми участников понадобился час и полтора соответственно. Одиночный запуск не перешёл этот порог за первые два часа.
Если команде нужно получить приемлемый результат как можно быстрее, параллельная работа может оказаться полезна даже без гарантии полного решения.
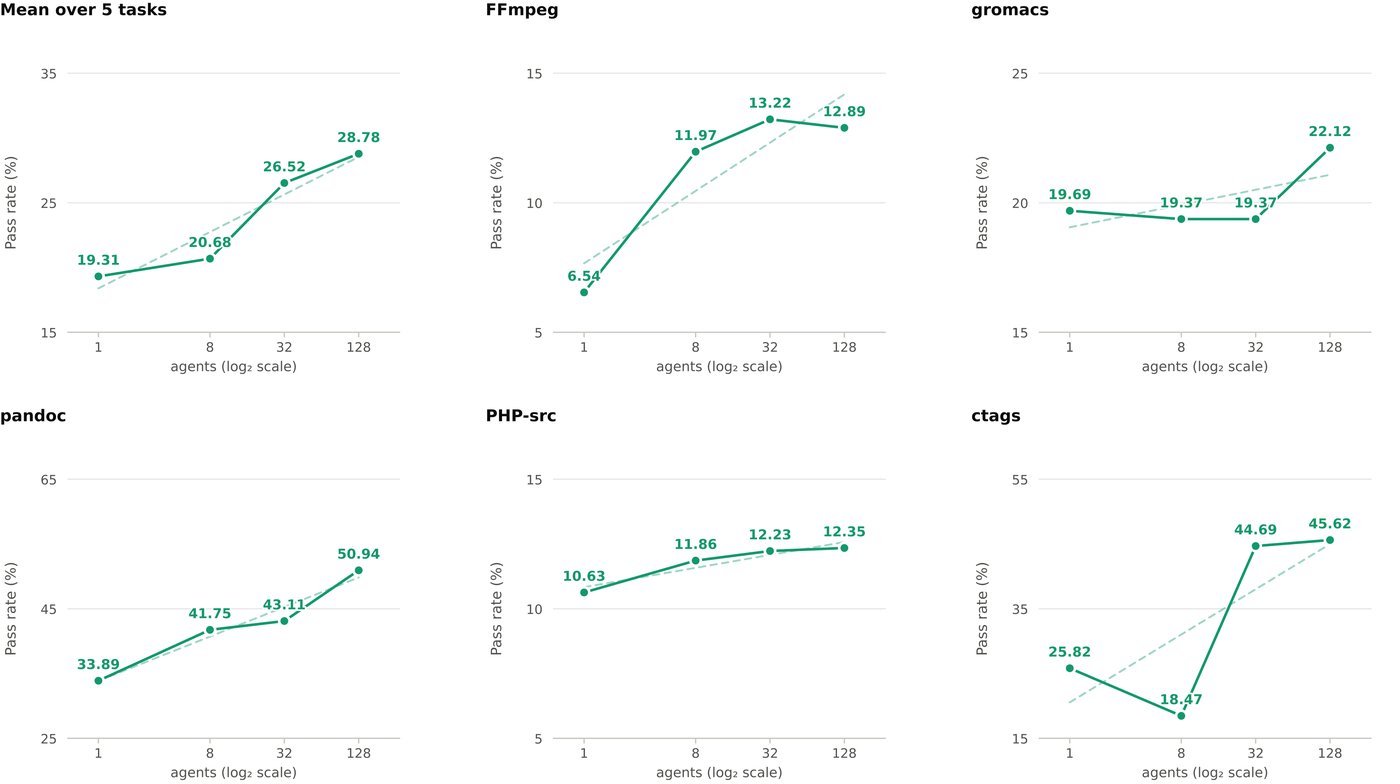
На сложных задачах команды большего размера обычно достигали того же уровня прохождения тестов раньше.
Как команда учится организовываться
Исследователи изучили не только итоговые оценки, но и записи о том, как агенты работали друг с другом. При восьми участниках они договаривались об интерфейсах между частями программы и избегали пересечения задач. При 32 участниках больше внимания уходило на проверку и объединение изменений. Например, один агент мог найти ошибку в работе коллеги, после чего автор исправлял её, а команда повторно проверяла результат.
В команде из 128 агентов участники начали чаще выбирать постоянные роли. Одни проверяли изменения, другие помогали объединять код. Агенты также повторно использовали найденные способы совместной работы. Например, автор сначала обновлял и проверял свою ветку, а затем передавал результат коллеге для проверки и объединения.
В запуске с 1024 агентами несколько участников специализировались на объединении изменений. Агент мог одновременно обратиться к нескольким возможным помощникам, выбрать того, кто ответил первым, и отменить остальные запросы. Если один участник не справлялся с задачей, другой мог продолжить его работу.
С увеличением команды появляются новые способы сотрудничества — от согласования подзадач до распределения ролей.
Авторы связывают эти наблюдения с тем, что участники получали одинаковый промт и не имели заранее заданных ролей. По их трактовке, способы взаимодействия складывались по ходу работы. Речь идёт о наблюдаемом поведении одной системы на задачах по восстановлению программ, а не о доказательстве, что любая большая команда агентов сама собой хорошо организуется.
Что ещё нужно выяснить
Результаты показывают, что большее число агентов может повысить качество и скорость решения сложной задачи. Но такой выигрыш нельзя оценивать только по доле тестов. Тысяча участников требует больше вычислений и создаёт больше сообщений, изменений и возможных конфликтов. В статье основной акцент сделан на результате за отведённое время, а не на стоимости достижения этого результата.
Есть и ограничения в проверке. Масштаб до 1024 участников испытали только на pandoc, а не на всех пяти задачах. Кроме того, эксперимент посвящён программированию и опирается на одну базовую языковую модель и одну обвязку для работы отдельных агентов. Пока нельзя сказать, сохранится ли выигрыш в исследованиях, анализе данных или других задачах, где результат сложнее проверить автоматическими тестами.
Число участников в мультиагентных системах может улучшать результат, если у них есть общий способ делить работу, обмениваться знаниями и объединять проверенные изменения. Следующий вопрос — сколько стоит такой выигрыш и где он сохраняется за пределами программирования. Для команды из 1024 агентов успешное сотрудничество уже само по себе становится частью задачи.
Читайте также
 Как дать ИИ-агенту больше свободы с меньшим риском
 Как ИИ-агент подбирает прошлый опыт под новую задачу
 ИИ-судья сохраняет 99% точности за меньшие деньги
 Как самоулучшение ИИ-агента улучшает результаты и экономит токены
 Почему ИИ-агентам трудно работать с разными данными
 Как ИИ-агентам экономить контекст и избегать сбоев
 Как ИИ симулирует мысли пользователя
 Как ИИ-агенты восстанавливают приложения по их поведению
 Как ИИ помогает разрабатывать игры
 Как проверить, понимает ли ИИ-ассистент мотивы людей
 Как ИИ-агент управлял интернет-магазином и увеличил капитал в 14 раз
 Последний ИИ, созданный людьми: на пути к рекурсивному самоулучшению
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram